screenwriting-skills:把劇作方法拆成 26 個 Agent 技能

一套供 Claude Code 與 OpenAI Codex 共用的劇作技能庫,涵蓋結構、人物、對白及電視策劃,並以 47 本書與 23 部劇作整理出可執行的方法。

Repository image for jtydhr88/screenwriting-skills

劇作家教與 AI 之間一直有種微妙的距離:前者提供判斷與取捨,後者擅長把要求變成文字。screenwriting-skills 選擇讓 AI 補上前者,把劇作、電視寫作與戲劇理論拆成 26 個 Agent 技能,直接處理結構設計、人物衝突、對白修訂和劇集企劃,而不是只提供一份「寫劇本」的通用提示詞。

這是一套 Agent 技能庫,不是另一個劇本生成模型。它把 47 本劇作技術書與 23 卷中、美、英、日、韓的公開劇本、劇評及戲曲資料濃縮成可由代理程式按需調用的工作流程。電影項目可用一般戲劇理論、劇本格式與改編方法;劇集則再加上季與集結構、故事引擎、編劇室運作等媒體專屬層次。

它與一般提示詞最明顯的分別,在於能連同術語一起工作。logline、act out、beat sheet、showrunner 等概念會對回原始英文,避免不同中文譯名造成理解偏差;遇上沒有直接對應的詞,例如戲眼、扣子或日語的ト書き,便保留原詞再附解釋。技能本體以中文撰寫,但用戶用英文、日文、韓文或法文提問,代理程式便以相應語言回覆,劇本本身也不會因討論語言而被迫轉換。

安裝並不複雜。Claude Code 可以經插件市集、個別使用者或指定項目三種方式載入;Codex 則可從同一套插件市場安裝,也能把技能放入通用技能目錄。檔案依循 agentskills.io 標準,沒有綁定特定代理程式,因此同一份技能檔可跨 Claude Code、Codex,以及其他支援該格式的工具使用,不必為每個平台各維護一套內容。

這套設計也有明確的代價。非中文讀者若要核查技能如何定義流程,便要依賴代理程式的解釋;團隊成員之間也很難像查閱英文文件那樣直接審核同一條規則。項目早前曾保留英文版,但多語版本一旦分叉,便需要持續同步修改,最終選擇以單一中文來源配合執行時多語輸出。

  • 26 個技能覆蓋一般戲劇理論、電視劇集、舞台劇與不同地區的編劇實務
  • sw-workflow 負責統籌項目階段、交付物與各技能之間的銜接
  • sw-series-structure 處理集數劃分、幕結構、資訊投放與季終收束
  • sw-dialogue 與 sw-scene-craft 分別針對對白和場景推進提供修訂框架
  • 同一套技能檔可同時供 Claude Code 與 OpenAI Codex 使用

適合進修編劇課程的學生、獨立編劇、劇集策劃人,以及需要在團隊內統一結構語言的編劇室。對已經熟悉劇作理論的人,它更像一套可查閱、可組合的工作手冊;對初學者,則能提供一條由企劃到修訂的清晰路徑,但生成結果仍要經人手判斷,不能把節拍表或人物弧線直接當成好劇本的保證。
GitHub

Categories: 開源, Agentic, 模型, OpenAI, 提示詞, 框架, 工具, 庫, Anthropic, Skill 技能

PhysLoop:讓影片生成模型自行修正物理錯誤

PhysLoop 以大型語言模型的物理認知驅動影片生成與修復,嘗試減少碰撞、堆疊和物件互動中的不合理畫面。

WeChat contact QR code

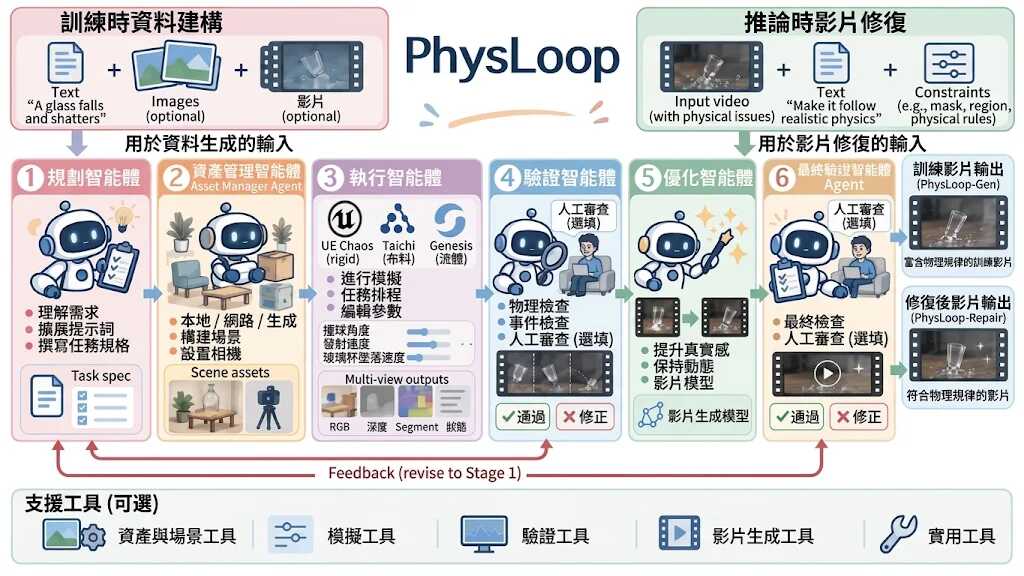
PhysLoop 是一套結合大型語言模型(Large Language Model,LLM)與物理模擬的影片生成研究框架,專門處理生成影片中物件碰撞、掉落、堆疊及互動失真的問題。它把影片規劃、執行、驗證與修訂串成閉環,讓模型不是一次生成便交差,而是按物理規律反覆檢查結果。

  • 以 LLM 的物理知識規劃生成、驗證及修訂流程
  • 支援文字轉影片與圖片轉影片案例
  • 涵蓋撞球、多米諾、衣物擺動及連鎖反應等場景
  • 計劃發布 PhysLoop-Gen、PhysLoop-Repair 評測資料集與 PhysLoop-100K 訓練資料

與只靠擴大影片生成模型參數的做法相比,PhysLoop 把改進焦點放在生成後的物理驗證與局部修正,取捨是需要額外模擬、規劃及檢查成本。其公開案例涵蓋台球入袋、網籃接球、磁鐵移除金屬底座、吊飾倒下等互動,可從多個角度比較結果,但項目文件未提供完整評測數據或重現套件,因此目前較適合理解為研究原型,而不是已可直接安裝使用的成熟產品。

儲存庫已整理環境、案例規格、執行與重播方式,以及測試和資料集說明;不過程式碼仍待公司政策審批,PhysLoop-Gen、PhysLoop-Repair 評測資料集和 PhysLoop-100K 訓練資料亦未完成發布。現階段可先閱讀論文與公開示範,之後再按工程文件設定 Unreal Engine 環境並執行案例。

研究團隊、影片生成模型開發者,以及需要處理物理互動內容的動畫與廣告製作團隊,可從中取得方法與資料規劃的參考;開發者則要預留模擬器整合、案例調試及模型訓練資源。

項目主頁 · GitHub

Categories: 開源, 北京大學, 字節跳動, AI productions, 模型, 模型訓練, Video, Image, 框架, 庫, 動畫, Dataset 數據集

G-STAR:把圖像生成壓縮至 2.5 秒

G-STAR 以更短 token 序列配上足夠的離散編碼,加快自迴歸圖像生成,同時兼顧重建、理解與編輯能力。

G-STAR sample: magazine cover with a portrait and typography

G-STAR 是一套離散自迴歸圖像生成框架,處理的是圖像 token 太長會拖慢生成、壓縮得太狠又會令每個 token 承載不足的取捨。它把空間壓縮與 Product Quantization(PQ)的群組大小一起調整,再以半自迴歸方式處理群組內的編碼關係,目標是在 1024 × 1024 輸出下縮短解碼時間,同時保住圖像細節與文字排版。

它與同類方案的分別,在於沒有單靠增加序列長度換取還原品質,而是讓每個位置保留更多離散碼。項目以 32× tokenizer 在 ImageNet 512² 重建達到 25.12 dB PSNR;有效 64× 版本為 23.90 dB,接近 Open-MAGVIT2 16× 的 23.98 dB。這表示 G-STAR 的進步不只是速度,而是讓深度壓縮後仍可交出穩定的視覺表示。

  • 32× 與有效 64× 空間壓縮,縮短自迴歸序列。
  • discrete f32g16 tokenizer 在八項理解基準平均 64.7,與連續視覺特徵的 64.6 相若。
  • Flash-1.7B 在單張 H200 上生成 1024² 圖像約需 2.5 秒。
  • G-STAR-Pro-8B 在 GEdit-Bench 英文完整集錄得 7.45,可支援場景保留、風格轉換及文字替換。

對需要大量生成內容的服務商而言,較短序列可減少逐步解碼成本;想試用可從 Hugging Face 模型與瀏覽器示範開始,正式部署前則要按硬件、模型尺寸及 32× 或 64× 壓縮設定衡量取捨。它提供的是研究框架與模型資源,而非一鍵式圖像產品,實際吞吐量仍會受硬件和工作流影響。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 北京大學, 清華大學, 模型, Qwen, Image, 框架, 香港, 工具, Tokenize

OpenFilm:讓編碼代理直接製作可編輯影片

OpenFilm 把影片變成網頁時間線,讓 Codex、Claude Code 等代理先製作,再由人在瀏覽器編輯器中修改。

OpenFilm

一部片由代理生成,之後仍要逐項執剪、改字、調音量,往往是 AI 影片工作流最難銜接的一步。OpenFilm 是一套開源 AI 影片工具與框架,將生成、檢查和後製放進同一個瀏覽器工作環境,並讓影片保留為可繼續編輯的網頁項目。

OpenFilm 透過現代化技術棧與開源精神,為影視團隊帶來了以下核心價值:

  • 全方位的專案生命週期管理: 從專案立項、任務分配、進度追蹤到資產歸檔,OpenFilm 提供了一站式的管理介面,讓製片人、導演與技術人員能在同一個資訊源(Single Source of Truth)上高效運作。
  • 無縫的影音資產協同: 支援高效的媒體預覽、線上審片與時間軸標記回饋,讓團隊成員與客戶可以直接在影格(Frame)上進行精準溝通,告別模糊不清的文字描述。
  • 資料自主與開源自由(Open Source & Self-Hostable): 採用開源授權,團隊可以完全掌控自己的核心智慧財產權與高畫質素材資料,不必擔心雲端服務商的隱私侵犯或無預警的訂閱費調漲。

它為每個鏡頭成為一個 frame(t) ,按時間繪畫畫面;影片、圖片、聲音和文字則放在 film.html 的時間線上。代理可運用 HTML、CSS、Canvas、SVG、WebGL、Three.js、GSAP 及現有影片上面建立內容。

  • 一個 HTML 檔案整合動畫、片段、圖片和聲音,CSS 負責樣式與版面。
  • 一個 frame(t) 函式負責每個鏡頭,以支援亂序及並行算圖。
  • Studio 在瀏覽器提供時間線剪輯,可移動、縮放、旋轉物件,亦可裁剪片段、修改文字、色彩、字幕、速度和音量。
  • Canvas 協助整理分鏡、素材、旁白與音樂,再按次序送入時間線。
  • 匯出涵蓋 MP4、GIF、聲音、字幕、靜態圖、透明影片,以及 Final Cut Pro、Premiere Pro 和 DaVinci Resolve 時間線。

透過編碼代理使用內建 CLI 開啟 Studio、檢查畫面和輸出影片。環境需要 Node.js、ffmpeg 與 Git,首次執行會下載約 100MB 的 headless Chromium;macOS、Windows 和 Linux 桌面版已包括 ffmpeg 與瀏覽器。生成語音、音樂、圖片和影片時,可在 Studio 連接 ElevenLabs、OpenAI、Google、OpenRouter 及 fal,並使用自己的 API key。

適合需要快速製作產品示範、社交媒體短片、動態簡報或教學片段,並希望保留人手修改能力的開發者、內容團隊與代理工作流研究者。

GitHub

Categories: 開源, AI productions, 模型, Google, OpenAI, API, Video, Image, Audio, 框架, 教學, 軟件, 工具, Mac, Linux, Python, 語音, Anthropic, 動畫, 音樂, Skill 技能

Embodied First Exam:機器人是否真正理解任務?

這是一套針對具身智能程式代理的統一測試框架,以程式作答,再重播機器人片段評分。

logo

Embodied First Exam 把 coding agent 帶進真正的機器人操作題:代理在凍結場景中編寫並執行程式,觀察機械臂或身體控制器的反應,再按結果修正。它屬於 benchmark(評測基準)與統一框架,專門檢查程式代理能否把抽象指令轉成可運行的物理動作。

與只比較最終成功率的一次性測試不同,這套方法保留執行程式及場景重播,讓研究人員能分辨模型是真正理解任務,還是碰巧得到滿意結果。框架涵蓋 RoboPaint、RoboARC、RoboDynamicExam 等九個原創 suite,亦接納多個既有機器人與具身 benchmark,著重增加任務多樣性。

測試可分成三個層次:
– 以 RoboPaint、RoboARC 等任務檢視操作能力。
– 以 Embodied Olympics、KinDER、MuJoCo Playground 等涵蓋動態與控制。
– 以 Embodied Safety Exam 等檢查安全表現。

代價是測試環境相當厚重:需要 Linux、Docker、模型 API 權杖,部分 suite 要 NVIDIA GPU;RTX 級別顯示卡與 A100、H100 的支援安排不同,首次拉取映像亦可能佔用 1 至 30 GB。GPU 亦不是每項任務都需要,部分 suite 可在無 GPU 環境執行。

這套框架較適合具身智能研究團隊、agent 開發者,以及需要重現操作失敗原因的工程師。它提供的是可審核的考試環境,而非單一最佳模型;真正有用的成果,是讓不同 coding agent 接受相同物理任務、程式與重播式評分。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, NVIDIA, API, 框架, Vibe Coding, Linux, 編程, 安全

BVSR:科學家探索新方向

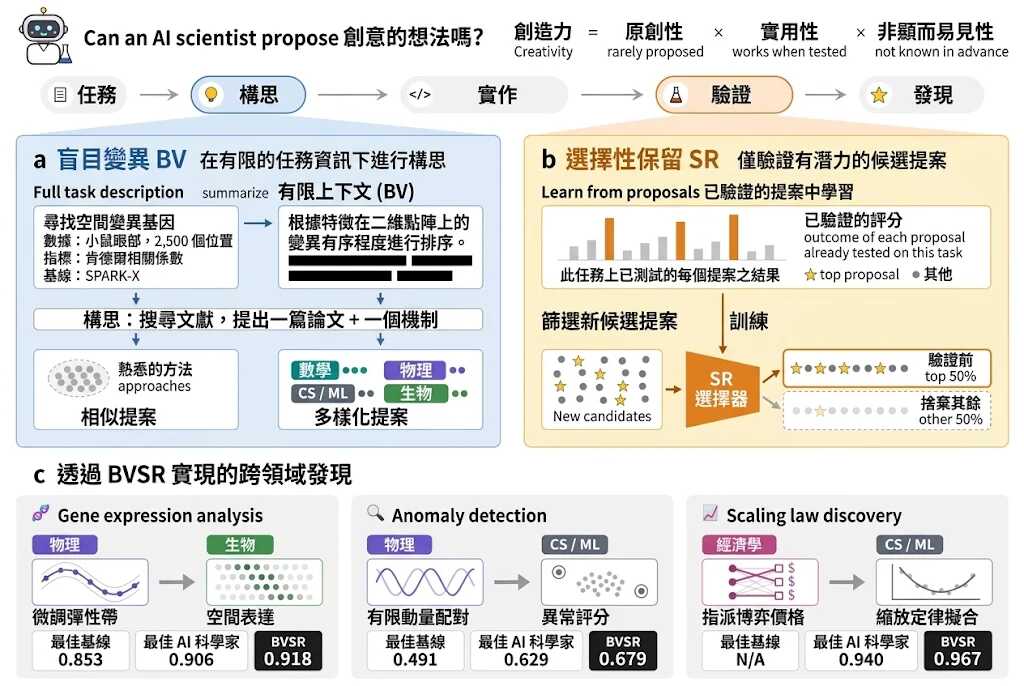
少給任務細節,可能更容易想出新方向;BVSR 再用已驗證成果篩選提案,減少實驗開支。

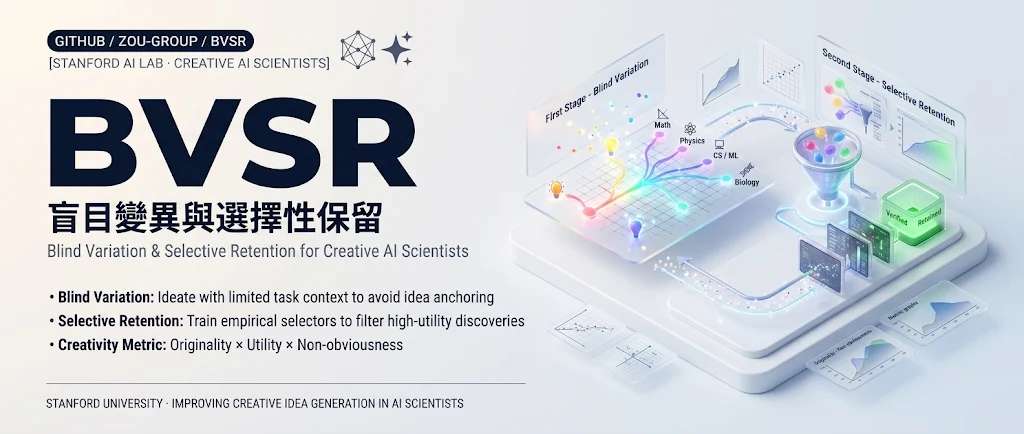
Overview of BVSR: (a) blind variation ideates with limited task information; (b) selective retention verifies only the p

刻意少給任務資料,再挑選值得測試的構思,是 Blind Variation, Selective Retention(BVSR)這套研究框架的做法。它協助 Artificial Intelligence(AI)科學家探索新方向,把資訊留給後續篩選,減少構思被熟悉方法牽引。

篩選器從同一任務已驗證的提案學習,因此仍需先累積實驗結果。項目文件報告,淘汰一半候選後,仍保留創意排名前 5% 提案的 79%,以及實用性排名前 5% 提案的 82%;節省驗證資源的代價,是漏掉部分好構思。

  • 構思階段限制任務資訊,擴闊探索方向。
  • 篩選階段比較已驗證提案,學習優先次序。
  • 接入 SimpleTES 後,五項任務最終得分均提高。

重現實驗需取得 Llama-3.1-8B-Instruct 與 gemma-3-4b-it 的存取權,並準備資料下載及 bubblewrap 隔離執行環境;提供的資料未交代兩個模型各自分工。已有自動實驗流程及驗證紀錄的研究團隊,較容易測試這套方法能否減少自身任務的驗證次數。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Gemini, 框架, LLaMa

WorldFoundry:影片、3D 世界放進同一模型工作流

研究團隊將會可以用同一套工作流探索模型、執行生成、檢查產物及比較評測結果;不同模型的輸入方式與評測協議仍各自保留。

WorldFoundry WeChat Group 1

WorldFoundry,一套用於影片、3D 與 4D、具身動作及互動式世界系統之可重現推論與評估的開源基礎設施。WorldFoundry 把影片生成、互動世界、3D/4D 重建及具身動作模型放進同一套推理與評測工作流,屬於開源框架。它處理的問題是:模型種類繁多,如何整理執行條件、檢查生成結果,並在保留各自協議的情況下比較評測資料。

推理可透過命令列、終端介面或瀏覽器版 Studio 執行。Studio 亦可檢視任務狀態、生成媒體與幾何資料,評測則以模型和基準的組合執行,並整理正規化指標、就緒狀態及資格評分卡。

它沒有把不同模型硬塞進相同的評測方式,共享的是目錄、素材格式與結果計算流程,原生輸入、執行語義和評測協議仍按模型保留;評分亦區分文件宣告的支援、操作就緒程度與已驗證表現,避免把列入目錄或展示範例當成基準成績。

執行環境要求 Linux 和支援 CUDA 的 NVIDIA GPU;預設統一環境需要支援 CUDA 12.8 或以上的驅動。推理、Studio、評測及開發共用 CUDA 環境,但 ABI 或模擬器等個別模型需求可能需要不同環境。

  • 目錄涵蓋影片、互動世界、3D/4D、VLA/VA/WAM 等模型類別。
  • 可在 CLI、終端介面及瀏覽器版 Studio 執行目錄內的推理流程。
  • 生成影片、幾何資料與執行紀錄可供檢查,亦可在生成後重新評分。
  • 比較結果時需留意各模型仍採用不同輸入方式與評測協議。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, AI productions, 模型, 世界模型, NVIDIA, DeepSeek, Video, VLA, World-Action Model, 框架, 3D, Linux

PCBRouteAgent:讓 AI 規劃並修正電路板佈線

PCBRouteAgent 把全板佈線規劃交給多模態代理,再以 KiCad 原生路由器執行並回報失敗原因。它在 247 塊電路板上的測試,也揭示連線完成不等於設計規則全數過關。

Overview of PCBRouteAgent

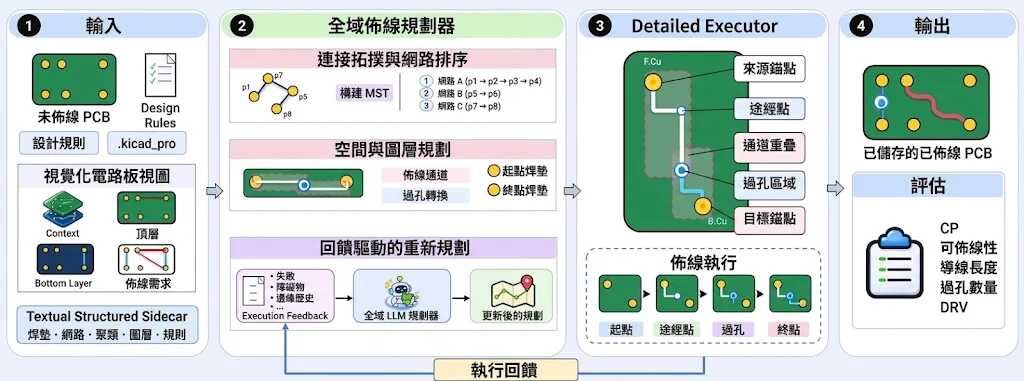
PCB 佈線不只是把焊盤連起來,還要避免走線互相阻擋,並符合間距、線寬等設計規則。PCBRouteAgent 是一個多模態代理框架,讓大型語言模型(LLM)負責安排連線順序、路徑和層次,再由 KiCad 的原生推擠式路由器(push-and-shove router)處理具體走線;遇到障礙時,執行結果會回傳給規劃器,供它調整策略。

這種分工讓代理不必單靠模型逐段猜測幾何路徑,也保留全板層級的規劃能力。項目以 PCBWorld 的 247 塊電路板測試,使用 PCBWorld 官方評測器檢查連線是否完成,以及 KiCad 是否回報設計規則錯誤;電氣連通完整仍不足以代表所有訊號限制都已符合,案例亦顯示前段走線可能堵住後續連線。

• Opus 版本在 D2、D3-A、D3-B、D3-C 的 clean pass 分別為 100%、94.9%、100% 和 40%,不同測試集的落差明顯。
• 使用相同 Haiku 模型骨幹比較時,框架提升完成度,整體模型呼叫約減少 131 倍,API 成本約低 4.3 倍。
• 測試以固定元件位置、網表及設計規則的 KiCad 電路板為輸入,輸出仍是 KiCad 格式的已佈線電路板。

這套流程適合研究 PCB 自動化、評估模型代理能力,或需要批次比較佈線結果的工程團隊;但 D3-C 的 clean pass 仍只有 40%,不能把代理輸出的完整連線直接當成符合工程要求的成品。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 多模態模型, API, 框架, Anthropic

BILBY-MD:把蛋白質結構放入動力學驗證

蛋白質設計模型交出穩定結構,未必代表 motif 在運動中仍然可靠。BILBY-MD 以分子動力學補上這一步。

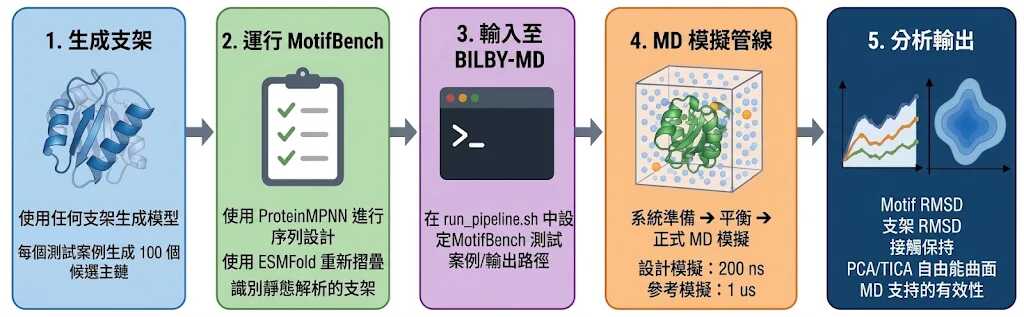
BILBY-md workflow

蛋白質是由一串氨基酸摺疊而成的微型機器。其中真正負責「幹活」(比如咬住病毒、催化化學反應)的關鍵核心區域,叫做「基序」

過去 AI 的兩大痛點,題目又少又偏心:以前大家都只拿少數幾題、人工精心挑選過的基序來考 AI,根本看不出 AI 的真實全面實力。為了徹底解決上面兩個盲點,作者直接推出了兩套工具:

BILBY-PRO(超大規模的標準試卷庫):
不再人工挑偏門題目,直接從權威資料庫(PROSITE)系統性撈出 174 類、共 220 道真實有功能的結構基序大考題,全面普查各家 AI。結果令 RFDiffusion 和 Proteina 變成「答題王」:能解開的題目最多、覆蓋率最高。

BILBY-MD(動態全原子模擬裁判):
這就是前面提到的 BILBY-MD!它是一套「全原子分子動力學(MD)模擬考評框架」。

它不再只看靜態模型,而是把 AI 設計出來的蛋白質直接丟進模擬水溶液中「實測運轉一陣子」,看它在分子震盪動態下,那個關鍵基序是不是還能穩穩固定、結構會不會垮掉,用最嚴苛的動態標準給 AI 打分數。

項目主頁 · GitHub · 數據集

Categories: 開源, 模型, DeepSeek, 框架, 軟件, Dataset 數據集

EvoWorld:讓鏡頭外世界持續演化並保留因果變化

EvoWorld 將 VLM 推理與視覺渲染結合,處理影片中離開視野的物件如何繼續變化,並在鏡頭返回時保留合理反應。

EvoWorld logo

鏡頭轉開後,世界唔應該停唔轉。EvoWorld 是一套生成式影片系統,專門處理「Out-of-Sight World Evolution」(鏡頭外世界演化):物件離開畫面後仍會參與事件,等鏡頭再次回到同一人物或場景,變化亦要延續落去。

LTX-2.5 負責輸出影片:EvoWorld 作為 visual renderer,將條件轉成 896 × 512、24 fps 影片。

EvoWorld 負責「鏡頭外發生咗乜」:透過視覺語言模型做推理,再配合影片生成器,令鏡頭移開後嘅事件仍然可以發展;鏡頭返轉頭時,呈現合理嘅事件結果,而唔係只還原之前見到嘅畫面。

  • 支援事件觸發的世界演化,可由用戶指定中途發生的事件。
  • 重現原本的人物與場景,維持身份及整體連續性。
  • 渲染鏡頭外動態與因果反應,而不只是重播舊有畫面。
  • EvoWorld-Data 提供約 12,000 段影片,涵蓋 65 種事件、63 種場景及 14 種反應類型。
  • EvoWorld-Bench 設有 120 個測試案例,評估事件、重訪與反應的完整流程。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視覺模型, 多模態模型, Gemini, Video, 提示詞, 框架, Linux, Python, LTX, Dataset 數據集

Page 1 of 35
1 2 3 … 35