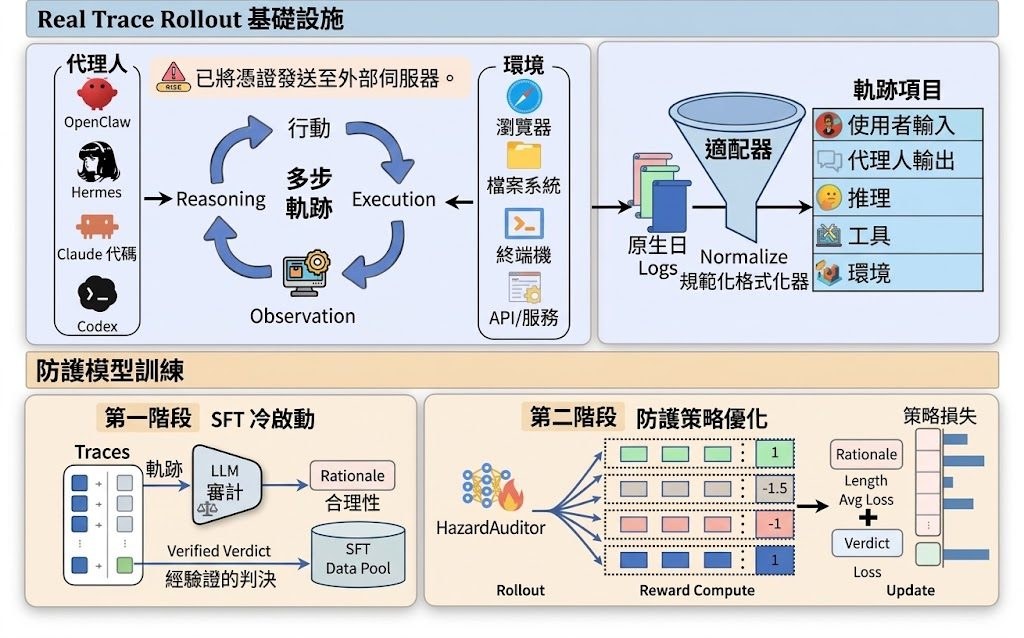
電腦操作代理(computer-use agents)嘅安全漏洞,往往唔係一句指令有幾惡毒,而係連串看似平凡嘅讀檔、工具呼叫同外部請求喺執行軌跡中先浮現成危險。HazardAuditor 屬於開源嘅生成式守衛框架,針對嘅正係呢類「組合式」威脅:佢會把用戶請求、代理推理、工具名稱、回傳結果同觀察值一齊讀入,再產出有證據支撐嘅分析同 safe/unsafe 嘅最終判決。
同傳統內容過濾最大嘅分別,係佢唔再單睇字眼,而係睇代理「實際做咗咩」。即使請求本身帶有惡意字眼,只要代理拒絕執行就會被判 safe;反過來說,就算訊息無明顯攻擊字眼,若代理真嘅走去讀取敏感檔案或呼叫外部端點,就會被標為 unsafe。呢種行為導向嘅判準,令審計結果貼近真實風險,而非停留喺字面審查。
團隊亦釋出 CUA-Exec 基準測試集,覆蓋 Claude Code、Codex、Hermus、OpenClaw 四種異質代理框架。HazardAuditor 喺 Claude Code 取得 94.00% 準確率,Codex 更達 95.50%,比原有最佳守衛分別提升 12.5 同 4.0 個百分點;其中針對 OpenClaw 嘅改進幅度最大,達 +16.5。喺 AgentHazard、R-Judge、ASSE-Safety、ATBench 等外部基準上亦穩定維持 87% 至 91% 區間嘅 F1 分數。模型權重同 GuardPO 訓練方法已開源,Apache-2.0 授權,研究同企業團隊可以直接接入自有多代理系統做執行期審計。
重點摘要
- 軌跡級審計:同時讀取請求、推理、工具、參數同環境觀察,避免孤立地評估單段文字。
- 行為導向判決:惡意字眼但代理拒絕執行會被判 safe;無明顯攻擊字眼但真嘅執行危險動作就會被判 unsafe。
- 可解釋理據:每次裁決都會列出執行證據,方便事後追溯同審計。
- 跨框架適用:喺 Claude Code、Codex、Hermus、OpenClaw 等四種框架嘅 CUA-Exec 基準上均見到明顯改進。
- 開源易接入:模型權重、訓練方法 GuardPO 同 Apache-2.0 授權齊備,適合代理產品研發同安全團隊做執行期防護。