AREX-Skill 把 GitHub 知識變成可執行技能

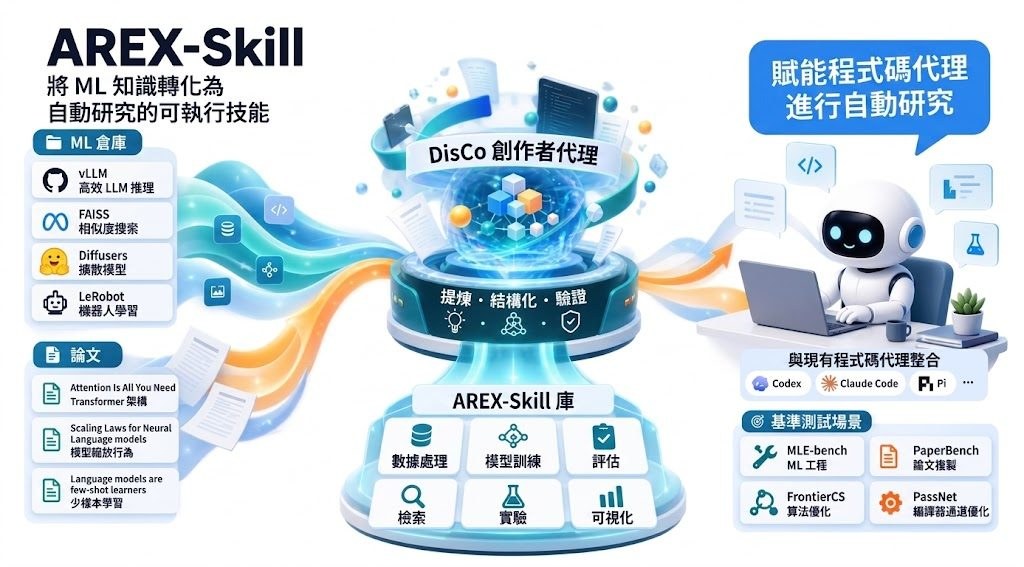
AREX-Skill 將熱門 GitHub 儲存庫整理成可驗證、可執行的技能,讓 Coding Agent 在複雜機器學習研究任務中少走彎路。

AREX-Skill turns repository and paper knowledge into executable skills for coding agents and autonomous ML research

面對需要查閱多個儲存庫、重現研究流程和逐步驗證結果的工作,AREX-Skill 將分散在 GitHub 的操作知識整理成可重用程序、檢查方法和技能圖譜。它屬於面向 Coding Agent 的開源技能庫與工作流工具,實際處理的是代理有模型能力卻欠缺項目脈絡和操作經驗的問題。

AREX-Skill 已從 1,000 多個熱門機器學習儲存庫提煉超過 5,000 個經驗證、可執行的 skills,並可整合 Codex、Claude Code、Pi 等 Coding Agent。使用時可按任務由 router 從技能庫收窄至相關分支,再由代理執行;DisCo 則負責將儲存庫知識建立、驗證和匯出成技能。

  • 技能包含程序與檢查,而不只是文字說明
  • 技能圖譜協助代理處理跨學科機器學習研究
  • DisCo Meta Skills 支援挑選及使用 Creator meta skills
  • Refreshing Repo Skills 提供維護和更新清單

相較於每次由代理重新閱讀 README、程式碼和論文,技能化做法可把重複的操作步驟預先整理,並將預算集中到較困難的推理工作;代價是技能需要隨儲存庫更新而刷新,覆蓋範圍和驗證品質亦會直接影響結果。儲存庫目前提供 Demo、技能目錄、repository catalog 及 DisCo CLI 文件,適合研究團隊、Coding Agent 使用者,以及需要重現多個 ML 項目的開發者。
GitHub

Categories: 開源, Agentic, Vibe Coding, 編程, Anthropic, Skill 技能, Dataset 數據集

E-CommerceBench 經營 365 日網店的 Agent 考試

代理人要由十萬元起步,經營最多四間網店並應付供應商、庫存與退貨,最後以全年資產增長分高低。

Mean end-of-year total assets, eighteen models, five 365-day episodes each

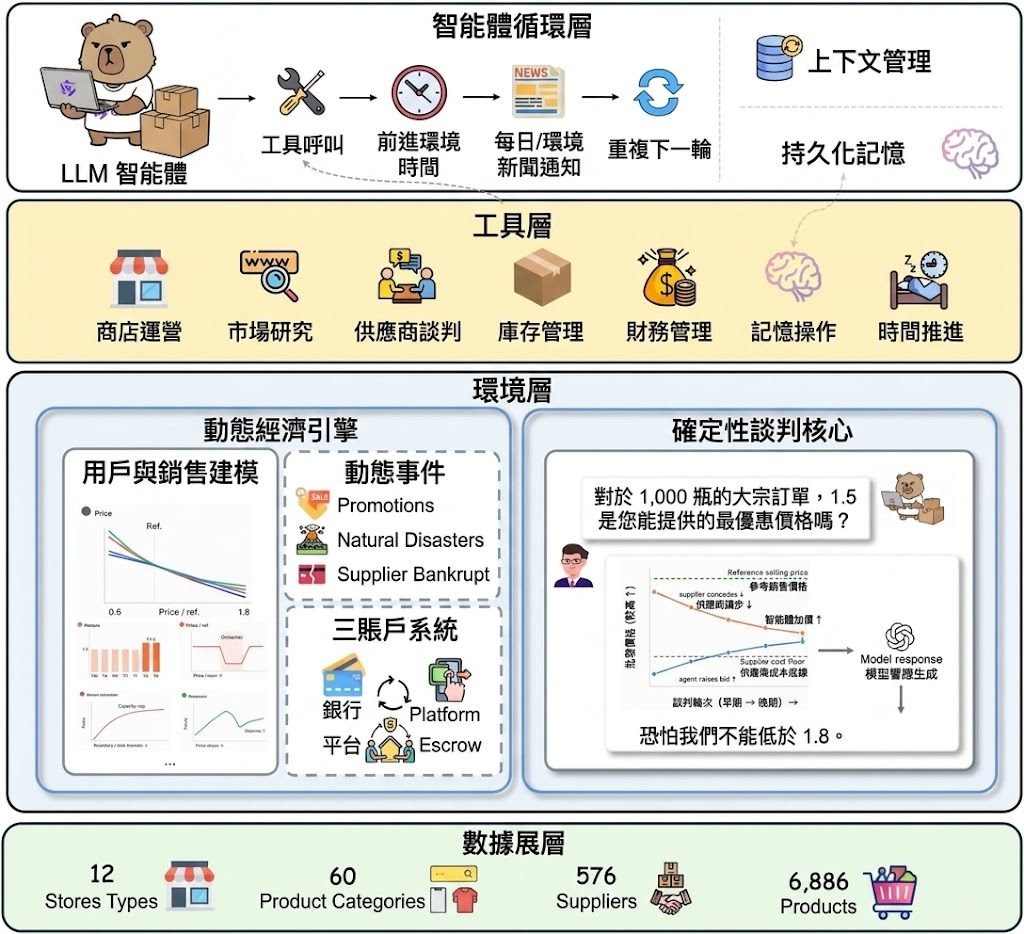
一個代理人由 ¥100,000 起步,連續經營最多四間網店 365 個模擬日,還要自行處理採購、定價、補貨、訂單履行及退貨。E-Commerce Bench 屬於長期自主商業運作的 LLM agent benchmark,實際處理的是代理人能否在現金流、庫存、風險和增長之間持續作出決策。

環境包含 6,886 個產品、60 個類別及 576 家供應商,其中 152 家涉及五種詐騙類型;全年亦有八次促銷和十項市場事件。客戶需求由固定多因素模型決定,供應商價格、讓步及接受與否則由 Deterministic Negotiation Kernel 計算,LLM 只負責把決策呈現成對話,避免抽樣回覆直接改變交易結果。

排行榜以五次獨立 episode 的年終總資產平均值計算 asset multiplier,同時提供標準差、CSE⁺、BadSpend%、回撤、每次工具呼叫帶來的收入、可控退貨比例、AnchorRatio、工具呼叫次數及破產次數等指標。GPT-5.6 Sol(max)平均資產達 ¥1,431,425,約為本金 14.3 倍;最佳 open-weight 模型 Qwen3.8-Max-Preview 為 ¥416,252,約 4.2 倍,18 個模型之間相差 1,264 倍,90 次運行有 10 次破產。

  • 測試場景涵蓋最多約 4,000 個回合,適合研究長期記憶、規劃和工具使用。
  • 固定需求與談判機制令模型差異較容易歸因,但未必代表真實市場的隨機性。
  • 模型排名同時呈現盈利能力、風險控制、浪費開支及資金壓力。
  • 項目資料提到 Python 3.10+,但提供內容沒有列出完整安裝、執行或下載流程。

研究代理人可靠性、商業決策、長期規劃或多步驟工具調用的團隊,會較容易從這套固定世界取得可重複比較的結果;網店經營者則可把它理解成壓力測試,而不是直接預測真實銷售額。它同時比較 proprietary 與 open-weight 模型,但資料未交代各模型的提示詞、工具策略或成本,因此資產排名不應單獨視為整體能力結論。

項目主頁 · GitHub

Categories: 開源, Qwen, Google, Gemini, DeepSeek, OpenAI, Agentic, Python, Anthropic, Dataset 數據集

H3 分鏡技能:分鏡及表情提示

這個 Claude Code 技能把腳本拆成 MiniMax H3 可渲染嘅分鏡,主打情緒表演真正落到畫面。佢直接指出:同一格塞太多表情指令,H3 會靜靜丟棄。

Repository image for phileiny/h3-storyboard-skill

用 H3 做有情緒起伏嘅影片,最容易撞牆嘅位通常唔係 prompt 寫得唔夠仔細,而係你貪心將太多表情塞落同一格。呢個 Claude Code 技能就係針對呢個盲點:佢唔止幫你格式化 H3 嘅 prompt schema,仲會教你點樣拆鏡頭、每格留幾多 beat、點樣導演一張臉。

核心發現來自一個對照實驗。同一個 shock beat、三次跑、同一粒 seed、同一批 reference 圖,只改動鏡頭結構:A 方案係一格 7 秒 close-up 塞 9 個表情指令,結果臉完全唔郁,PSNR 高達 37–42 dB,即係畫面接近凍結;B 方案拆成三格 2–3 秒、每格一個 beat,PSNR 跌到 22–23 dB,所有 beat 都落到;C 方案喺 B 基礎加返 <d> 對白標記,PSNR 再降到 19 dB,但代價係鏡頭時間被 H3 重新分配,背景角色連門一齊被裁走。結論好直接:開工前先數 beat,超過兩三個就要拆鏡頭。

另一個值得留意嘅細節係「唔好寫乜都唔變」。H3 對靜態描述容易洩漏到成個鏡頭,想表達 pause 就交俾剪接手。尺寸同距離方面,佢建議用相對關係(畫面三分二高、離底部一手寬)而唔係絕對數字,否則渲染出嚟會走樣。形狀就靠 reference 圖頂住,純文字三次都搞唔掂一個 1.75:1 嘅窗框。

需要用 H3 拍敘事短片、廣告 storyboard、或者任何要精準控制表情嘅創作者。比起坊間只做翻譯嘅 H3 技能,呢個項目多走一步:佢承認有啲規則只係推論(effect 係真實嘅,cause 仍未隔離),全部齊齊整整列喺 SOURCES.md 分做 verified、partly verified、inferred。

  • 屬於工具類 Claude Code 技能,解決 H3 prompt 表情指令被靜默丟棄嘅問題
  • 對照實驗證明分鏡頭係恢復情緒表現嘅關鍵機制
  • 對白標記唔會令臉郁,只會改變 H3 對鏡頭時間嘅分配
  • 距離用相對關係、形狀靠 reference 圖,純文字描述容易失效
  • SOURCES.md 將規則分三級誠實標註,邊個有控制實驗支持一目了然

GitHub

Categories: 開源, ComfyUI, Anthropic, Skill 技能, MiniMax

OpenClaw 2.0 重建介面與記憶連續性

OpenClaw 2.0把入門流程、對話延續同穩定性一併重做。對長時間使用 AI agent 的人,差別會先體現在找回上下文同減少中斷。

用得久嘅 AI agent,最怕唔係功能少,而係中途斷線、記唔住之前做過乜,或者想翻查舊對話時搵唔返內容。OpenClaw 2.0 針對呢類問題重做咗網頁體驗,亦加強咗 memory 同 session continuity,令長流程互動唔使成日由頭開始。

今次版本另一個直接影響體驗嘅改動,係 onboarding 變得更簡單。新手由安裝到開始使用嘅門檻降低,而舊用戶就會更在意 reliability pass 帶來嘅穩定性提升;更新說明同時提醒先備份 configuration 同 state,亦提到自動更新失敗時,可以用本地 coding harness 幫手完成更新、排錯同確認 Gateway 正常啟動。

文件列出咗一個幾實用嘅新能力:可以用完整字詞或片語搜尋可見對話內容,之後直接打開相符結果附近嘅訊息。對要追查工作脈絡、整理多輪討論,或者長時間同 agent 協作嘅人,呢個改動比單純加模型選項更有感。

  • 重做 web 體驗,介面與流程更貼近持續使用情境
  • 強化 memory 同 session continuity,減少對話中途斷層
  • 新增對話文字搜尋,可由結果跳回相關訊息位置
  • 做咗大規模 reliability pass,重點放在穩定運行
  • 更新時仍有 migration 要求,Plugin SDK compatibility 亦有保留與修補

OpenClaw 2.0 今次唔係靠單一新模型吸引注意,而係集中修補 AI agent 項目最常見嘅摩擦位:入門、延續性、搜尋同可靠度。對已經把 OpenClaw 放入日常工作流嘅團隊或個人,呢次更新代表系統更接近可長時間依賴嘅狀態;不過升級前後仍要留意 migration 與相容性檢查。

項目主頁

Categories: 開源, OpenAI, Agentic, API, Anthropic, OpenClaw

video-shotcraft:電影感產品影片工作室

video-shotcraft 把產品頁面、動態分鏡和聲效製作串成一條工作流,協助 Claude Code 或 Codex 產出更完整的宣傳影片。

video-shotcraft logo

由產品頁面出發,video-shotcraft 會交由 Claude Code 或 Codex 組織分鏡、動畫及聲音設計,再以 Remotion 製作宣傳、發布或示範影片。這個項目屬於 AI agent skill,實際處理的是產品影片製作中截取畫面、安排鏡頭、配合節奏剪接和加入聲效等繁複工序。

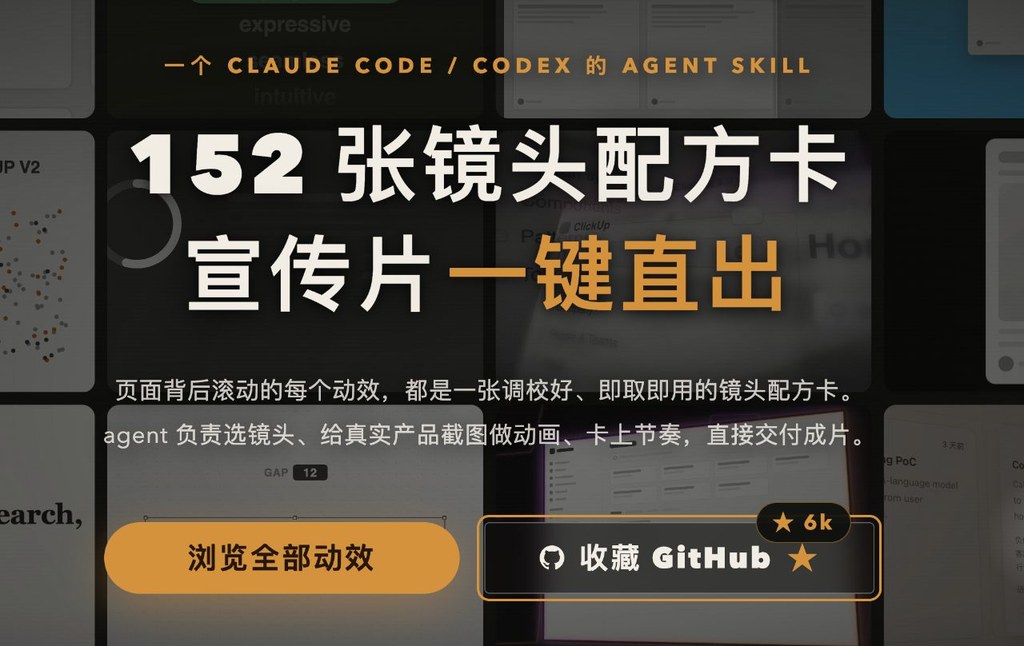
畫面不只依賴抽象動畫,工作流包括真實頁面擷取、2.5D camera moves、beat-synced cuts,以及電影感 SFX。152 張 shot recipe cards、209 種 style 和 209 個 motion previews,讓創作者可按產品內容挑選鏡頭語法,再由 native Remotion components 組合成片;元件以 normalized progress t 驅動,並可替換 ACCENT 顏色。

適合需要頻繁製作產品發佈片、marketing video 或 demo video 的設計師、創業團隊及內容製作人。它把分鏡規劃和前端式動態設計交給代理處理,換來較完整的自動化流程,但影片質感仍取決於產品頁面素材、提示內容及人工修訂;提供的資料亦未交代具體安裝步驟、所需帳戶或完整輸出流程。

品質控制來自對候選動作進行八輪逐幀檢視,並與參考片段比較後整理成 recipe cards。README 亦列出完成交付後可輸出可編輯的 JianYing(CapCut CN)草稿,方便按 shot 重新剪接、調速、排序、調色及重建字幕軌道,但相關功能的可用條件仍需以項目最新文件為準。

  • 素材處理:支援真實產品頁面擷取,而非只靠預設圖形。
  • 動態語法:涵蓋 2.5D 鏡頭、節拍剪接和 SFX 配搭。
  • 內容庫:提供 152 張 shot recipe cards、209 種 style 及 209 個預覽。
  • 輸出彈性:以 Remotion 元件組成影片,並列出 JianYing 可編輯草稿匯出能力。
  • 使用限制:目前資料不足以確認安裝、模型依賴和完整執行要求。

GitHub

Categories: 開源, OpenAI, Agentic, Video, AI productions, Anthropic, Dataset 數據集, Skill 技能

Mechanist:把整個科研鏈串起來

Mechanist 把模型內部機制研究串成一條自動化流水線,從文獻檢索到實驗驗證都能接手。對做可解釋性、假設檢驗同 GPU 實驗的人,相當有價值。

Mechanist Logo

Mechanist 係一個面向 LLM mechanistic interpretability 的 Autonomous Research Agent,重點唔係幫你寫報告,而係幫你把研究問題拆成可驗證的實驗流程,再逐步產出有證據支撐的結論。它適合需要反覆查文獻、提假設、跑 GPU 實驗、再做 robustness validation 的工作,特別係做模型內部機制分析嘅研究人員同團隊。

使用方式偏向研究工作流而唔係單點工具:先準備 task.md,再喺 Claude Code 入面啟動 /auto,系統會接住做 literature retrieval、hypothesis formulation、experiment implementation 與 execution。項目同時提供 /msearch/mhistory,方便查文獻同追蹤主題脈絡;安裝資料提到要配合 Claude Code、uv,同埋設定 external review model,但 README 亦提到詳細步驟要參考 Quick Start,同時未有完整列出所有命令細節。

它的取捨幾清晰:比起只做文獻整理或者只跑單次實驗,Mechanist 會把整個研究鏈條串起來,仲會喺 GPU budget 內自動縮放實驗規模,唔夠資源時會直接停低並回報。這種做法令佢更像一個可執行的研究夥伴,而唔係純粹的查詢介面。

  • 支援把研究問題轉成可重複驗證的實驗流程
  • 會做文獻檢索、假設生成、實驗執行同穩健性檢查
  • GPU budget 係硬限制,資源不足會明確停機回報
  • 適合做 mechanistic interpretability、模型分析同研究自動化的人
  • 目前以 Claude Code plugin 形式提供,Codex 支援屬於後續方向

項目主頁 · GitHub

Categories: 開源, Agentic, Anthropic, Dataset 數據集

spark-to-paper-skills:14 個 Claude Code 技能把點子直出論文 PDF

由一句想法走到可編譯論文,連引用、圖表同數字來源都一併追蹤。呢個 Claude Code 插件瞄準的,不是寫草稿,而是把研究寫作流程拆成可驗證工序。

spark-to-paper-skills

研究寫作最麻煩的地方,往往不是起草,而是引用會唔會失真、圖表能否修改、數字有冇來源可追。spark-to-paper-skills 把呢件事做成 Claude Code 插件型工具鏈,用 14 個可組合技能,將一句想法推進到可編譯 PDF,處理的是論文生成流程入面最容易出錯的核對與整理工作。

它吸引人的地方,在於唔靠獨立 app 或伺服器,而是直接掛入 Claude Code 會話。安裝前提相對簡單,重點是有 Claude Code,另外部分圖像流程需要 Python 3.10+ 同指定依賴;換句話說,這不是雲端代寫服務,而是偏向本機、插件式、可拆件調用的研究寫作工作流。

  • 14 個技能可分步串接,涵蓋資料整理、成稿到 PDF 編譯
  • 引用強調 verified,數字強調 traced to source,主打可追溯性
  • v1.2.0 加入 PaperBanana+ figure engine,圖可重畫成原生 editable vector figures
  • 新版支援 Claude Code plugin 自動載入,部署方式比早期版本完整

同類做法多數把重點放在生成速度,這個項目則把可信度同後續可編輯性放得更前。PaperBanana+ 的做法幾值得留意:先由官方 PaperBanana 產生候選圖,再用 ts-figure-svg 學習該渲染風格,根據論文事實原生重繪,並以 stdlib-only geometry audit 反覆修正至少 4 輪,換來的是圖像更容易進一步編修,但流程也明顯比單次出圖更講究。

目前公開資訊較多集中在工作流完整度。它已展示 7 篇跨 6 個領域的端到端樣本,並支援 ICML 2025、NeurIPS 2025 風格輸出,足以說明這套技能並非只停留在片段 demo。較適合研究助理、學術團隊、技術內容作者,或者需要快速整理初稿但又唔想放棄引用與圖表可追蹤性的人;最終學術品質,仍然要視乎輸入構想、來源材料同人工審稿力度。

GitHub

Categories: 開源, Python, Anthropic, Skill 技能

free-claude-code:一個代理層打通 Claude Code 與 Codex

想保留原生開發代理體驗,又想自由換模型與供應商,free-claude-code 正正補上這個缺口。它把 Claude Code、Codex 同 Pi 接到同一個可管理入口。

用開 Claude Code 或 Codex 的人,最在意通常唔係再裝多一個聊天介面,而係可否繼續用原生 model picker、串流回應、tool use 同 image input,同時改用自己揀的模型供應商。free-claude-code 就係一個 proxy 工具,把 Claude Code、Codex、Pi 及其 IDE 擴充功能接到自管入口,處理多供應商切換同路由分發。

它的價值在於工作流幾乎唔使重學。你可以照用 fcc-claudefcc-codexfcc-pi 啟動對應代理,Windows 同 macOS 亦可放在背景執行,再到本地 Admin UI 揀選並驗證供應商。可在 31 個 cloud 與本地 providers 之間切換,亦可把 Fable、Opus、Sonnet、Haiku 同 fallback 流量分別導向不同模型,這點對想控制成本、速度同能力分工的團隊幾實用。

跟直接綁死單一 API 的做法相比,這個項目押注在「保留原生客戶端體驗,再用 proxy 抽換後端」。代價是相容性要靠代理層維持,所以它明確強調只會在兼容模型上保留 streaming、tool use、reasoning 同 image input;換句話說,模型可揀得更自由,但不是每個後端都保證功能完全一致。

  • 支援 Claude Code、Codex、Pi,同時保留各自原生 model picker
  • 透過本地 Admin UI 管理與驗證 31 個 cloud/本地 providers
  • 可把不同流量類型分流到不同模型,方便平衡成本與能力
  • 適合想用本地模型、付費模型或免費模型混搭的開發團隊

安裝與測試方式偏向開發者工具鏈:項目以 Python 3.14、uv、Pytest、Ruff、Ty 組成,部署重點不是雲端託管,而是先在本機跑起 proxy,再讓代理客戶端經它連線。現階段最適合已經在用 Claude Code 或 Codex、又想統一管理模型入口的人;追求零設定即用的讀者,會覺得它比較像一層需要自己維護的基建。

GitHub

Categories: 開源, NVIDIA, API, Image, 工具, IDE, Mac, Python, 編程, Anthropic, UI/UX

Vision-DeepResearch:由靜態圖片走向連續影片的 DeepResearch Agent

Video-DeepResearch 將視覺搜尋延伸至連續影片,要求模型先理解跨畫面的證據,再進行網絡探索。

icon

面對需要翻查影片內容、再結合網絡資料回答的問題,單靠文字搜尋往往會漏掉關鍵畫面。Video-DeepResearch 是一個多模態研究型 Agent 項目,透過 Video-DeepResearch(Video-DR)處理連續影片中的時空資訊,並把視覺理解與網絡探索分開安排。

它修正了兩個常見卡位:模型偏向使用文字工具,較少主動檢視影片;模型亦可能直接依賴內部記憶,未有真正完成工具輔助搜尋。Pipeline 先逐階段解鎖視覺工具,要求模型完成跨畫面 grounding,再進入網絡檢索,取捨是流程較嚴謹,但推理成本和執行時間亦可能增加。

訓練流程先以 Supervised Fine-Tuning(SFT)建立基本能力,再使用 Group Relative Policy Optimization(GRPO)強化自主探索。項目同時提供 30 K 個 video-grounded QA pairs、7 K 條整理後的 trajectories,以及程式碼、資料集和模型權重,研究團隊可按需要測試基準、重現訓練或直接載入模型。

  • Video-DR-35B-A3B 在 Video-DR 達到 68.0% accuracy
  • 比 Claude-4.5-Sonnet 的 63.0% 高 5.0 個百分點
  • GPT-5 和 Gemini 2.5 Pro 分別為 57.0% 和 62.0%
  • Vision-DeepResearch-30B-A3B 延續同一研究方向,另有 SFT-only 的 8B 版本

現有結果反映它在影片證據與網絡資料需要互相驗證的工作較有價值,例如研究、媒體核查和長片段問答;但 68.0% 仍代表部分問題會出錯,較適合作為研究平台和可檢驗的 Agent 架構,而不是無需監督的影片分析服務。

項目主頁 · GitHub

Categories: 開源, Qwen, 香港, 香港中文大學, 香港理工大學, Gemini, OpenAI, Agentic, Video, 多模態模型, 模型訓練, Anthropic, Dataset 數據集

LongHorizon-Harness 解決代理在長任務時的錯誤

代理能否跑足幾十小時,關鍵唔只在模型能力,仲在狀態有冇走樣。LongHorizon-Harness把驗證、執行同任務延續拆開處理。

Install and run LongHorizon-Harness from the command line

當代理要橫跨桌面程式同 command line 連續做事,最易出問題唔係單步操作,而係中途記錯狀態、判斷錯進度,結果愈做愈偏。LongHorizon-Harness 針對屬於長時程代理執行與驗證工具,目標係令複雜任務可以被保存、核實,再一路推進到完成。

它唔係新模型,它主要協助 Claude Code、Codex、OpenClaw 之類 agent backend 上面處理 execution、state management 同 result verification。核心做法是 Manage-Execute-Audit (MEA) loop,把規劃、執行、審核拆成不同路徑,並把可信狀態獨立保存,減少單一長對話愈滾愈亂的問題。

  • 支援 Claude Code、Codex、OpenClaw,亦可配 Gemini CLI 與 mini-SWE-agent
  • 以獨立 audited state 推動下一步,而唔係只靠 session 內記憶
  • 可用單一指令啟動,每次執行會獨立保留 audit trail
  • 針對 WeaveBench、OSWorld 2.0、Terminal-Bench 2.1 這類長任務基準有公開成績

它在 WeaveBench 取得 80.7% PassRate、OSWorld 2.0 有 35.2% partial score,Terminal-Bench 2.1 success rate 為 77.2%。官方亦強調在相同 backbone 下,只換 harness,三個 benchmark 都向上走,反映改進點主要來自流程控制同驗證機制,而唔係模型突然變強。

呢種設計較適合需要長時間自動化處理、多步驟交接、又要追蹤結果可信度的團隊,例如研究、軟件測試、系統操作同複雜 office workflow。代價是流程比單純聊天式代理更重,審核與狀態管理會增加結構與成本,但換來的是更穩定的延續能力,同較容易追查每一步點樣做出來。

項目主頁 · GitHub

Categories: 開源, Qwen, Gemini, DeepSeek, OpenAI, Agentic, Anthropic, OpenClaw, MiniMax, Skill 技能, Dataset 數據集, 框架

Page 1 of 5
1 2 3 5