NPCBench:檢測模型能否串連鼻咽癌診療全程

模型答對單題,不代表能為同一位病人作出前後一致的診療判斷。NPCBench 把鼻咽癌知識、影像、治療決策與病程追蹤放進同一套評測。

NPCBench overview

答對鼻咽癌知識題,未必代表模型能制定合適方案,或隨病情變化修正判斷。NPCBench 是一套醫療 AI 評測基準,涵蓋指引知識、影像判讀、臨床決策及專科諮詢,嘗試檢驗模型能否把這些能力連接到病人的診療流程中。

不少醫療基準把能力拆成知識問答、單張影像判讀或靜態病例題,逐題計分;這種方式較難看出模型能否整合多模態證據,或在病程改變時更新決策。NPCBench 改以近似專科培訓測試,並加入縱向病例與 CarePath 評估,要求同一病人的病理、MRI T 分期及各項照護決策全部正確,才算聯合成功。
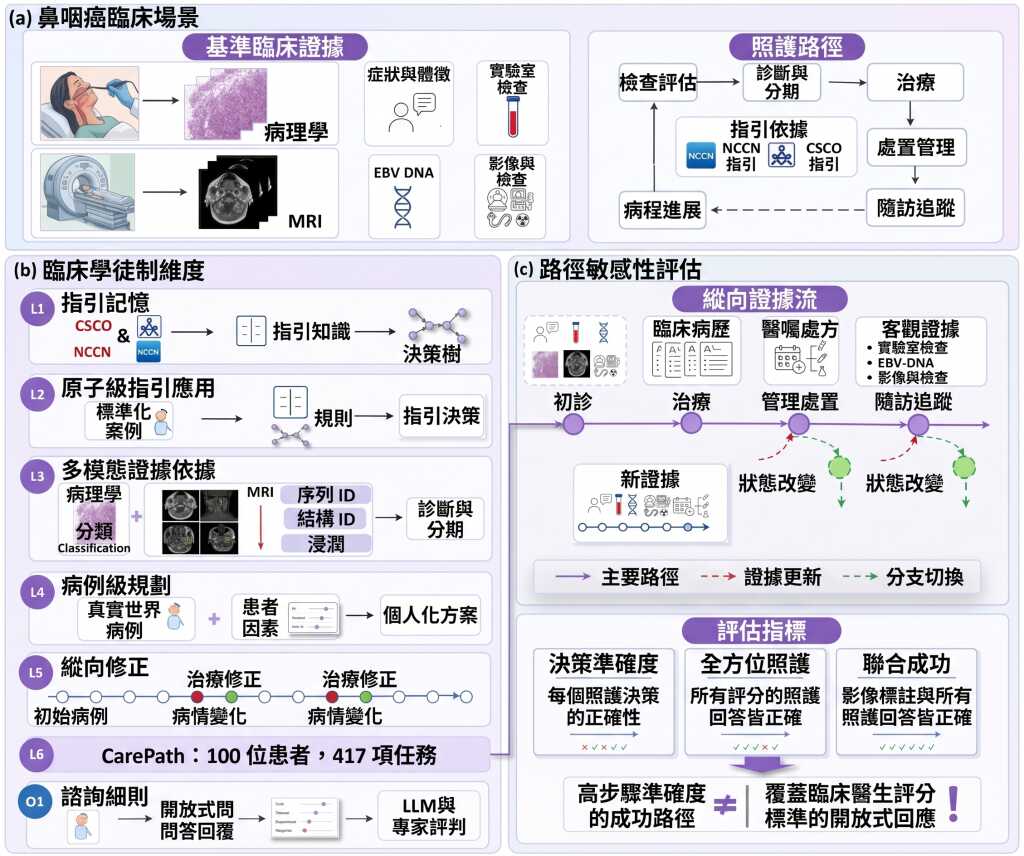
資料集包含 4,777 項分階段及諮詢題目,另有 100 名病人的 CarePath 病例,共 417 項診斷與照護評分任務。項目亦提供 MRI 延伸評測指南、醫師一致性校準,以及可用已發布預測結果重現主要結果表的 CPU 指令;研究比較了 30 個模型,並以配對控制檢視證據依據、病程中的判斷修正及諮詢評分。

結果反映單項能力與完整診療流程之間存在落差:在 21 個多模態模型中,嚴格 CarePath 聯合成功率最高為 23%。這令 NPCBench 適合研究醫療模型評測、腫瘤照護工作流程及多模態臨床推理的團隊;但它聚焦鼻咽癌,分數不能直接推廣至其他疾病或真實臨床成效。

  • 評測範圍由指引知識延伸至影像、決策、病程追蹤及專科諮詢。
  • CarePath 以病人為單位,要求多項診斷與照護答案同時正確。
  • 研究比較 30 個模型,並納入配對控制與醫師一致性校準。
  • 嚴格 CarePath 評估中,多模態模型最高成功率為 23%。

使用者可按任務下載相應題目,為每題提交模型答案,再以提供的評分工具輸出分數;Python 3.10 或更新版本即可執行。多選題需要提交完整選項集合,L1、L2、L4 等任務有各自的題目檔與評分命令,MRI 延伸測試則另有資料處理及推理設定指南。
GitHub · Paper

Categories: 開源, 香港理工大學, 多模態模型, Image, 香港, 工具, Medical醫學, 中國, Dataset 數據集

SAE Interprets MoE:拆解混合專家的分工

只看 MoE 專家被路由多少次,未必能知道它真正為模型輸出帶來甚麼。這項研究把專家貢獻連到可解讀特徵,分析 Qwen3-30B-A3B 的專長如何細分。

Repository image for ByteDance-Seed/SAE-interprets-MoE

要了解 MoE 模型裏每個專家實際負責甚麼,單計它被選中的次數並不足夠:路由頻率不等於它對輸出的貢獻。SAE Interprets MoE 提供重現研究實驗的程式碼與數據,透過稀疏自編碼器(Sparse Autoencoder,SAE)分析 Qwen3-30B-A3B 第 4、30、46 層的專家分工。

研究利用 SAE 編碼器的仿射特性,把每個特徵的啟動值精確拆分到 MoE 層中被啟動的專家,再按語料彙總貢獻比例,建立專家與特徵之間的「主導圖」。這與按預設領域標籤統計路由不同,分析焦點是專家真正推動了哪些特徵;研究結果指出,多數特徵主要由一至兩個專家主導。

第 30 層的分析顯示,專家可在較大的領域內形成細分分工,例如 Java 與前端網頁、幾何與算術。研究亦比較專家貢獻的集中程度、主導特徵重疊,以及各專家的領域標籤;這些結果描述的是特定模型與層,不宜直接推廣到所有 MoE 模型。

重現流程從計算專家對 SAE 特徵的貢獻統計開始,再執行排名、主導圖、詞雲與領域分析等實驗。項目提供每項實驗的執行腳本及已整理的解釋、標籤和判斷資料;模型權重可從 Hugging Face 下載,也可指定本地檔案。計算需求不低:Qwen3-30B-A3B 的 bf16 權重約需 61 GB,單層 fp32 SAE 編碼器另需約 8 GB,同時追蹤三層則需要兩張 80 GB GPU。

  • 分析範圍為 Qwen3-30B-A3B 的第 4、30、46 層。
  • 以特徵貢獻而非單看路由頻率判斷專家分工。
  • 提供可重現實驗的程式碼、SAE 權重連結及整理後的研究資料。
  • LLM 領域分析需要 OpenAI 相容 API;完整追蹤流程亦需要高記憶體 GPU。

這套方法適合研究 MoE 可解讀性、專家專長與特徵分工的團隊,也方便重現的分析。它提供的是針對特定模型的研究工具與證據,不是可直接替任意模型標註專家的通用服務;解讀結果仍取決於 SAE 特徵與自動解釋流程。

項目主頁 · GitHub · 模型

Categories: 開源, 字節跳動, 模型, Qwen, OpenAI, API, 工具

DSH Go:Android 手機執行或遙控 DeepSeek Harness

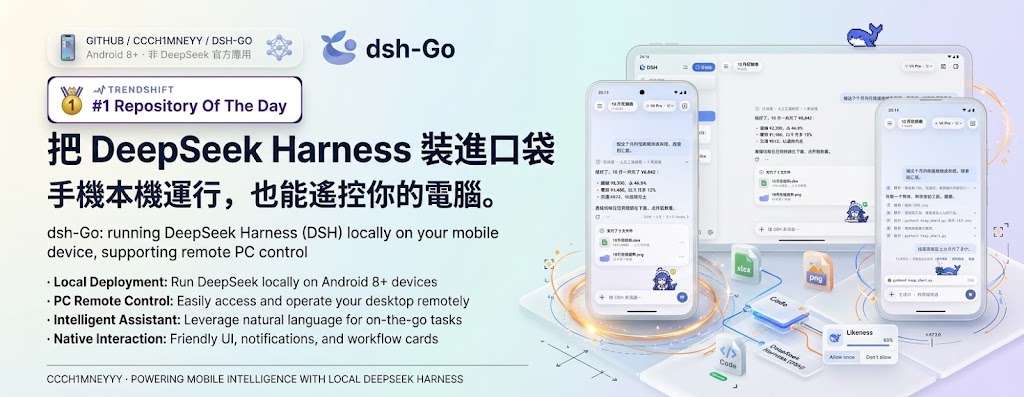
DeepSeek Harness 的 Android 客戶端 DSH Go,讓你在手機安裝執行環境,或透過 SSH 遙控電腦和伺服器上的 DSH,並在手機處理對話與工具審批。

DSH Go:把 DeepSeek Harness 装进口袋

想在外出時繼續使用 DeepSeek Harness,或直接讓 Android 手機執行它,DSH Go 提供兩種做法:在 App 內安裝 Ubuntu、Node.js 和 DSH 執行環境,或連接電腦及伺服器上的 DSH。這款 Android 客戶端支援 Android 8 或以上,無需 Root,也不必另裝 Termux。

遠端連線可使用 SSH,亦可使用 DSHarness Remote。聊天介面支援切換模型、傳送圖片、語音輸入,以及處理工具審批和提問;需要不同操作方式時,也可切換至網頁模式。這令手機不只是查看對話的介面,亦能接續處理 DSH 的工作流程。

DSH Go 亦支援適配專用 SDK 的原生工具卡、表單和面板,項目提供 SDK、教學和示例,方便開發者製作手機介面。開啟權限後,本機引擎可以讀取屏幕、點按和輸入;這類操作涉及裝置控制,使用者應留意授權範圍,並可隨時停止操作。

  • 可在 Android 手機本機執行 DSH,或連線至遠端電腦及伺服器。
  • 支援圖片、語音輸入、模型切換、工具審批和網頁模式。
  • 原生工具卡、表單及面板可透過項目提供的 SDK 開發。

這個項目適合已使用 DSH、需要以手機接續工作的人,以及希望為 DSH 工具製作原生手機介面的開發者。

GitHub

Categories: 開源, 模型, DeepSeek, Image, 教學, 工具, Linux, 編程, 語音

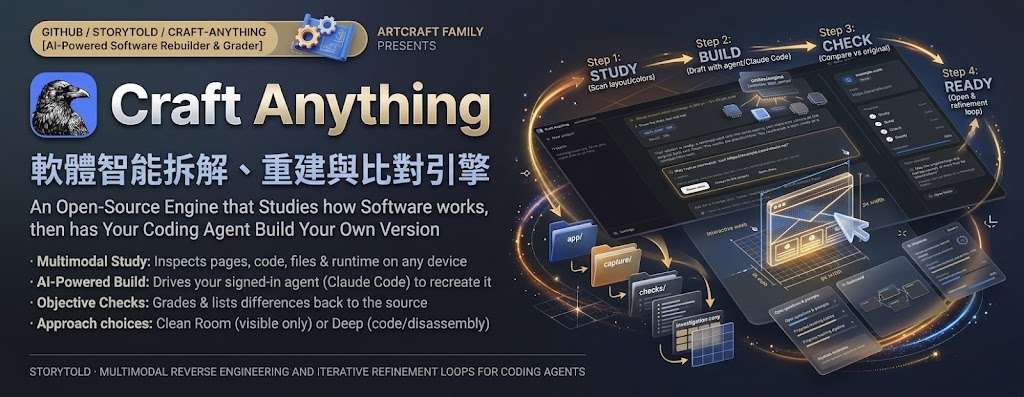
Craft Anything:讓 AI 複製網站、應用程式與遊戲

描述想做的網站、應用程式或遊戲,Craft Anything 會檢查參考作品,再讓 AI 編碼代理建立新項目並比對結果。它預設不讀取原作程式碼或檔案,並提供逐項檢查與人工核准。

ArtCraft

想參照一個網站或遊戲製作自己的版本,難處往往不只是寫程式,還要反覆檢查外觀和功能是否接近。Craft Anything 是以 Rust 編寫的開源 AI 建置工具:它用檢查工具觀察目標,再交由編碼代理建立新項目、比對成果並逐步修正。

預設的 Clean room 模式不讀取原作的程式碼、檔案或頁面內容;使用者指定目標並描述需求後,系統透過檢查工具了解原作,再生成獨立的新項目。網站項目會逐項列出檢查結果和相似程度,計劃介面則顯示尚未完成的步驟;超出規則的操作會先要求使用者核准。這讓製作過程有明確的檢查點,但相似度不等於功能完全一致,仍需人工確認成果。

進階模式可查看完整工作台,包括工具、函式、字串與 pseudo-C;Deep 模式則會讀取目標程式的程式碼和檔案,適用於私人用途。兩種模式在可檢查資訊和資料界線上不同,使用者需要按目標來源及用途選擇,不能把 Clean room 的限制套用到 Deep 模式。

項目目前處於 early alpha,支援 macOS、Windows、Linux、FreeBSD 和 Web。文件沒有提供可供比較的效能測試或一致性分數,因此現階段較適合用來探索 AI 輔助複製介面與功能的工作流程,而非直接當成成熟的自動重建工具。

  • 可指定網站、應用程式或遊戲作參考,並以文字描述想建立的版本。
  • AI 編碼代理建立新項目後,系統會比對結果並協助修正。
  • Clean room 預設不讀取原作程式碼、檔案或頁面內容;Deep 模式會讀取程式碼和檔案。
  • 檢查結果、計劃進度及操作核准流程,讓使用者能追蹤建置狀態。
  • Rust 開源項目仍屬 early alpha,文件未列出效能基準。

GitHub

Categories: 開源, 工具, Mac, Linux, 編程

Terminal Mac:讓 AI Agent 操作虛擬 macOS 電腦

代理可在獨立的 macOS 桌面操作應用程式,不必移動實體 Mac 的滑鼠或改動剪貼簿。terminal-mac 把虛擬機畫面帶到終端機,並提供 MCP 工具供代理控制。

Repository image for govijr/terminal-mac

讓電腦操作代理在另一個 macOS 桌面開啟應用程式、輸入文字和檢查畫面,同時保留實體 Mac 的滑鼠與剪貼簿不受代理操作影響。terminal-mac 是為 Computer-use agents(CUAs)提供獨立 macOS 虛擬機的工具,透過終端機檢視畫面及下達操作。

它使用 Apple Virtualization 執行真正的 macOS guest,guest 有自己的應用程式、檔案、帳戶和權限,不會沿用主機已登入的工作階段。代理透過 MCP 工具截圖、點擊、拖曳、捲動、輸入文字及按鍵,並可依照「觀察、操作、確認」的流程檢查結果。

首次啟動會從 Apple 下載並快取相容的還原映像,也可使用既有的 .ipsw;之後會重用已建立的虛擬機。項目面向 Apple silicon、macOS 14 或更新版本,預設虛擬磁碟邏輯容量為 64 GiB,主機亦須預留還原映像和虛擬機所需的資源。Ghostty、Kitty 或 iTerm2 可顯示終端機內嵌畫面,其他終端機則可改用原生虛擬機視窗及代理命令列工具。

主機輸入與螢幕 API 不會用來執行代理操作;guest 內的 helper 會檢查硬件型號是否以 VirtualMac 開頭,避免操作意外落到主機。這項檢查不是硬件認證,也不能防範已遭入侵的主機。項目仍屬早期候選版本,乾淨 Mac 上的 guest 驗收尚未完成,發行版本亦未經 Apple 公證;tmux passthrough 和自動分割終端機目前不支援。

  • 適合需要隔離代理操作與個人桌面、帳戶及剪貼簿的測試工作。
  • Claude Code 可透過 MCP server 和 skill 接入代理工作流程。
  • 首次建立虛擬機需要網絡下載 macOS,或自行提供相容的還原映像。
  • 虛擬機會佔用主機 CPU、記憶體和儲存空間,預設磁碟邏輯容量為 64 GiB。

GitHub

Categories: 開源, Agentic, MCP, API, 工具, Mac, Anthropic, 蘋果, Skill 技能

Route Anything:按輸入選模型,兼顧品質與成本

面對文字、影像、影片、語音和機械人任務,Route Anything 研究路由器如何按輸入挑選候選模型或策略,並在品質容許範圍內減少成本。

Repository image for InfRec-Cardinal/route-anything

處理不同類型任務時,系統未必要每次都交給同一個模型或機械人策略。Route Anything 是一套研究實驗程式碼,探討路由器如何按輸入選擇候選方案,並在品質下降有限的前提下控制成本,涵蓋語言模型、影像、影片、語音生成器及機械人策略。

選擇與固定候選方案:在 24 個基準、19,814 個測試輸入上,理想路由得分為 87.98,固定方案為 82.60;但這個差距代表潛在上限,不等於訓練出的路由器已能達成同等收益。實際訓練的能力樹路由器在 16 個基準上只高 0.3 分,影片生成則高 2.1 分。

成本實驗顯示,四個測試環境平均效率提升 8.82 倍,品質損失低於 0.5 分;程式碼任務提升 25.5 倍,文字問答提升 7.1 倍。機械人測試中,結果路由器提升 1.1 分並減少 24% 策略執行時間;以勝出標籤預測結果的成功率為 42.8%,結果回歸則為 71.55%,反映訓練目標會左右路由效果。

  • 路由依據是路由器可觀察的輸入資訊,並按預期價值扣除成本選擇候選方案。
  • 參考策略與品質容忍度用來設定成本價格,適合比較省成本幅度與品質底線。
  • 程式碼提供路由實作、離線重播及品質底線認證工具,可按實驗指南重現部分測試。

研究團隊或需要在多種模型、生成器與機械人策略間分配任務的工程團隊,可用這套工具檢驗路由是否值得加入工作流程。限制是全模態實驗所用的軌跡矩陣並未公開,因此相關結果未必能完整重現;公開的程式碼與文字測試資料目前只支援部分實驗。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 模型訓練, Video, Image, 工具, 語音

ComfyUI-ShotWorkspace:把分鏡素材整理與影片提示詞寫作納入 ComfyUI

準備角色、道具和場景參考圖,再整理分鏡描述、撰寫 MiniMax H3 影片提示詞,並接上原有的 ComfyUI 生成流程。模型、取樣與解碼仍由接收工作流程負責。

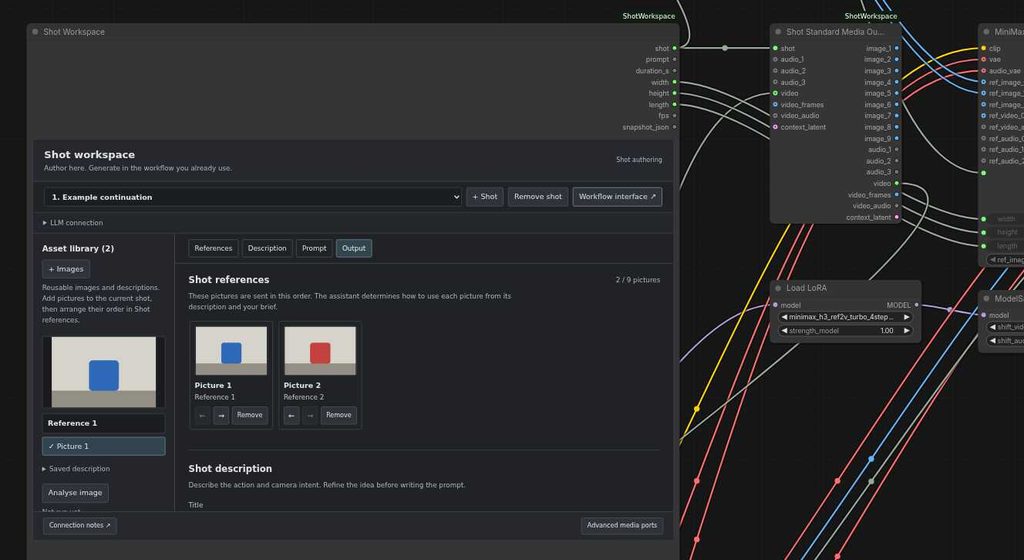
Shot Workspace inside the ComfyUI canvas

整理分鏡時,參考圖、描述和生成提示詞往往分散在不同步驟;ComfyUI-ShotWorkspace 把這些創作工作同時放進 ComfyUI,讓創作者準備素材、修訂鏡頭描述,再撰寫 H3 影片提示詞。這是個實驗階段的 Custom Node,負責生成前的寫作及整理,不取代影片生成工作流程。

創作者可分別上載角色、道具和場景圖片,使用影像分析產生可編輯描述,再挑選當前鏡頭的參考圖並按次序送往接收工作流程。文字生成和圖片分析透過 API 連接 LLM 伺服器呼叫;影片模型權重、取樣及解碼則由原有工作流程處理,兩者需要分開安裝和測試。

每次佇列只處理一個鏡頭,項目不負責編排完整影片序列。前一鏡頭的輸出不會自動成為下一鏡頭的輸入,使用者須自行選擇前置鏡頭;工作流程之間傳遞的 LATENT 格式亦必須相容。音訊、影片和 LATENT 接口可傳遞媒體,但不會自動把這些內容加入大型語言模型提示詞。

  • 需要 ComfyUI、Python 3.10 或以上版本,以及符合要求的 aiohttp 和 Pillow,依賴項須安裝到執行 ComfyUI 的 Python 環境。
  • 項目不附帶模型權重;LLM 伺服器、接收工作流程所需節點及 H3 權重都要另行準備。
  • H3 輸入影格按 24 fps 的 17k+5 網格安排;取樣時長在上下文裁切前設定,交付影片可能短於指定時長。
  • 工作流程會保存創作資料、檔名和伺服器網址;圖片本身留在 ComfyUI 的輸入目錄,分享前宜檢查保存內容。

這套工具較適合已經使用 ComfyUI、希望把分鏡準備和提示詞撰寫納入既有流程的創作者或小型製作團隊。它減少素材與文字在工作流程間來回整理的需要,但不提供完整序列編排,也不能單靠 LLM 連線測試確認影片生成正常。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, Video, Image, Audio, 提示詞, 工具, Content Creator, MiniMax

TaoMate-FVSR:用音訊與稀疏參考修復人臉影片

小臉在影片中容易失去細節,換上新配音時口形也可能對不上。TaoMate-FVSR 把音訊、參考畫面與生成歷史一併用於人臉修復,亦支援視覺配音。

favicon

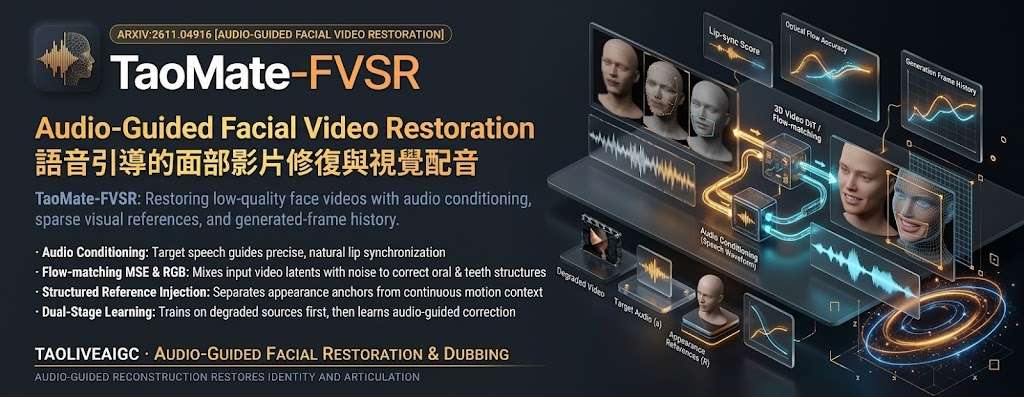
影片中的人臉太小或細節模糊,單純放大未必能還原自然的面貌;換上新語音後,嘴形亦要配合音訊。TaoMate-FVSR 是一套人臉影片修復推理工具,利用音訊、稀疏的視覺參考和生成畫面歷史重建臉部,支援保留原聲修復,以及配合替換語音進行視覺配音。

它把臉部細節與口部動作放在同一個重建流程處理,並以來源影片保留場景結構,再由高質素參考提供外觀線索、目標音訊引導嘴部動態。相比先做超解像、再交給另一個配音模型的分段流程,這種聯合處理方式有機會減少修復結果與口形之間的不一致。

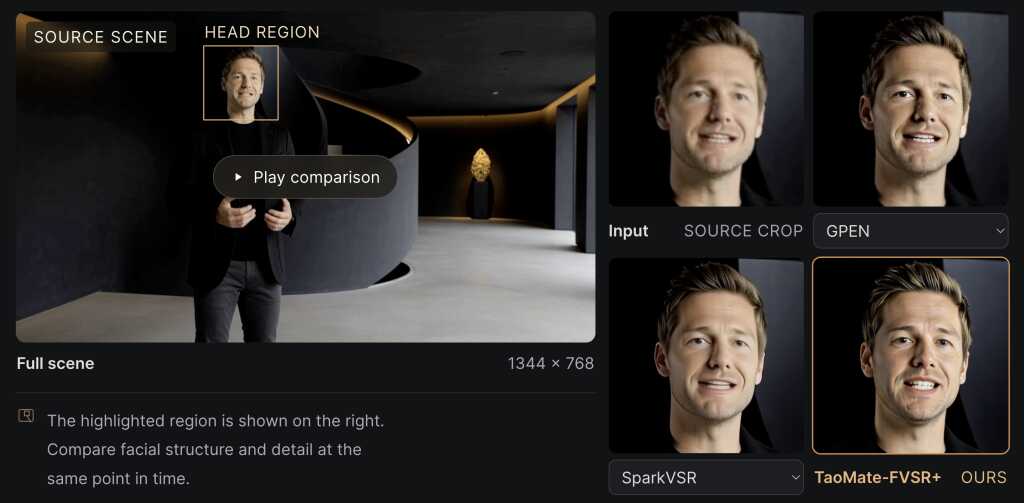
畫面可用 GPEN 處理首幀作參考,也可以提供自行編輯的首幀或完成的參考圖。推理流程會先以 DWPose 裁切人臉,再做修復、色彩與遮罩融合,最後貼回原影片;模型可按 1× 或 2× 尺寸運算,合成前會縮回 512×512,因此輸出場景維持原有尺寸。全場景比較也有助檢查修復臉部與原本畫面是否協調,但身體和背景不會一併提升解像度。

  • 支援原始音訊修復及替換語音配音。
  • 可用 GPEN、外部編輯首幀或完成的參考圖提供外觀線索。
  • 1× 與 2× 推理分別使用 512×512 與 1024×1024 處理尺寸。
  • 執行需要支援 BF16 的 NVIDIA CUDA GPU,以及 CUDA 版本相容的 PyTorch 2.6 或更新版本和 torchvision 0.21 或更新版本。

這套工具較適合需要修復 AI 生成影片人臉、製作配音版本,或比較局部臉部細節與完整場景效果的創作者及研究團隊。參考畫面質素和場景合成效果都會影響最後成果,正式製作前宜用自己的素材測試。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, NVIDIA, Video, Audio, 工具, Content Creator, 線上服務, 語音

Rapid-MLX:加快 Apple Silicon 的本地編程代理

想讓 Codex、OpenCode、Claude Code 等編程代理使用本地模型,又不想犧牲回應速度與工具呼叫能力?Rapid-MLX 提供兼容 OpenAI 和 Anthropic API 的推理服務器,專為 Apple Silicon 設計。

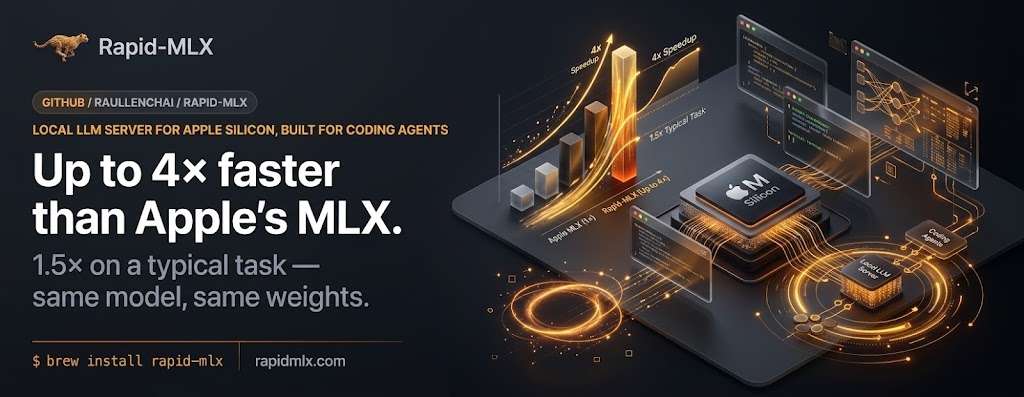
Rapid-MLX. Local LLM server for Apple Silicon, built for coding agents. Up to 4× faster than Apple

在 Mac 上用本地模型操作 Codex、Claude Code 或 OpenCode,回應速度和代理能否可靠呼叫工具都會影響工作流程。Rapid-MLX 是建基於 MLX、面向 Apple Silicon 的開源大型語言模型(LLM)推理服務器,讓多款編程代理透過兼容 OpenAI 與 Anthropic 的介面連接本地模型。

它與直接使用 Apple 的 MLX(mlx-lm)相比,主打更快的生成速度和編程代理所需的工具呼叫能力;同一模型、同一組權重下,項目報告最高可達 4 倍解碼速度,典型任務約快 1.5 倍。比較結果會受模型、任務和硬件影響,不能視為所有情況都能達到的速度提升。

測試資料包括 Mac mini M4 Pro 上的 Qwen3.5-9B 4-bit,以及 Mac Studio M5 Max(36 GB)上的多款 Qwen 模型。Rapid-MLX 的 Qwen3.5-9B 解碼速度為每秒 115.5 個 token,oMLX 為 77.9,LM Studio 為 81.0;但測試只記錄單次執行,並使用各服務器的預設模式,因此數字適合參考,不宜直接當作全面排名。

安裝後選用支援的編程代理,再以 rapid-mlx launch 啟動即可;同一指令可重複使用,移除 Rapid 的私人設定檔也不會改動 Codex 原有設定。首次回覆可能較慢,因為模型需要下載或載入,也可能要處理代理的開場提示詞。項目要求使用 M 系列 Mac,目前沒有 Windows 或 Linux 桌面版本。

  • 支援 Codex、Claude Code、OpenCode、Pi、Hermes、Crush 和 Goose。
  • 提供兼容 OpenAI 與 Anthropic 的 API,並著重可靠的工具呼叫。
  • 可按模型和任務查看速度比較,項目亦提供測試方法與原始數據。
  • 首次回覆可能受模型下載、載入及提示詞處理時間影響。
  • 僅支援 Apple Silicon;不適合需要 Windows 或 Linux 桌面版本的團隊。

需要在 Mac 上運行本地模型、又希望保留編程代理工作流程的開發者,可以用 Rapid-MLX 測試常用模型與任務,再決定速度提升是否足以配合硬件需求。模型仍須在本機下載和載入,選擇時應一併考慮記憶體容量及首次啟動等待時間。

GitHub

Categories: 開源, 模型, Qwen, 提示詞, 工具, Mac, 編程, 蘋果

Lemo-Opuscar:讓 coding agent 用 66 種程式影像風格拍片

想把故事變成風格鮮明的短片,可以從 66 種程式製作的影片風格選擇,再交由 coding agent 協助導演。

OPUSCAR 98 — 98 Years of Best Picture

想把文字故事變成短片,又希望畫面不只停留在一般生成影像的風格,Lemo-Opuscar 提供 66 種可直接選用的程式影像風格,並支援自行修改或從空白開始創作。它是一套以程式碼製作影片的風格工具箱,讓 coding agent 按所選風格處理故事呈現;每種風格亦附有短片示例,方便先看效果再決定方向。

畫面由 canvas 和 WebGL 網頁逐格繪製,音樂採用免費取樣音源製作原創配樂,旁白則使用文字轉語音。這種做法把視覺風格、配樂和旁白組合成一條影片製作流程,適合想快速嘗試不同美術呈現的創作者,也可用於資料敘事、紀錄片及短片概念驗證。

使用者可以先到線上風格展示頁瀏覽範例,再挑選風格、提供故事,或修改既有風格及自行建立新風格。

風格針對 Claude Opus 5.5 調校,作者提醒其他模型未必能重現相同效果;這是選用工具時需要納入考慮的限制。項目亦展示每部作品配合相應風格呈現,說明這套方法可用於較長篇幅的主題作品。

  • 提供 66 種可用影片風格,並可修改或自行創作。
  • 以 canvas、WebGL 逐格繪製畫面,並結合配樂與文字轉語音旁白。
  • 可先瀏覽線上展示頁和短片範例,再決定風格與故事方向。
  • 風格主要針對 Claude Opus 5.5 調校,其他模型的重現效果未有保證。

GitHub

Categories: 開源, 文字轉語音, Agentic, AI productions, 模型, Video, Image, Vibe Coding, 工具, Content Creator, 編程, 語音, Anthropic, 音樂

Page 1 of 35
1 2 3 … 35