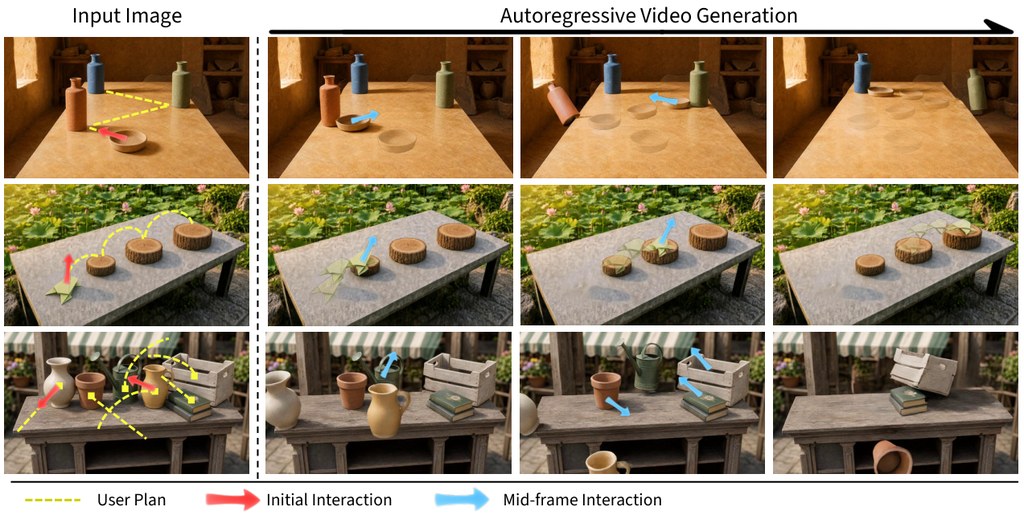
PhysStream:邊播邊拉物件,讓 AI 影片生成更貼近物理直覺

PhysStream 是一個物理導向的影片生成模型,用戶可以在生成過程中隨時拖動物件來改變它的運動方向,做到真正的中途互動控制。

Og image

以往想用 AI 生成一段符合物理規律的影片,往往需要在生成前就設定好整個控制排程,而且很多方法只懂在像素層面指定物件位置,未必真正理解「力」與「速度」這類物理量。PhysStream 的切入點正正落在這個空隙:它是一個自回歸的物理導向圖生影片模型,支援中途互動,容許用戶在生成過程中隨時拉動物件,改變它的運動方向。

核心做法分兩個階段。先用一個雙向模型做微調,加入速度增量(velocity increment)這類稀疏信號作控制條件,讓模型學到背後的動力學;再訓練一個因果自回歸模型,引入結構化場景記憶,記錄位置圖與物件追蹤圖,使每一幀生成都能參考歷史畫面的一致狀態。同時解決了「中途介入」與「物理一致性」兩個難題。

PhysStream 把運動分佈距離(FVMD)降低 33%、軌跡誤差降低 12%,而且在真實場景的人類評測中,超過 85% 的對比都獲得偏好。在多物件桌面剛體場景裡,這種邊生成邊控制的能力是目前其他方法做不到的。對做特效、動畫預覽或物理模擬預演的團隊來說,這種「拉到邊做」的互動模式會比較貼近日常工作流。

重點摘要:

  • 中途拖動控制:生成過程中可隨時改變物件運動方向,毋須事先設定控制排程
  • 物理導向信號:採用速度增量而非像素位置,讓模型學習真正的動力學
  • 結構化場景記憶:以位置圖與物件追蹤圖維持長影片一致性
  • 兩階段訓練:先雙向微調學控制條件,再因果自回歸強化物理一致性
  • 評測表現:FVMD 降 33%、軌跡誤差降 12%,人類評測偏好率逾 85%
項目主頁

Categories: AI productions, 視頻模型, 模型訓練, Video, World-Action Model, Robotic, 動畫

KaiNinja 將 3D 生成推到部件級 – 直接拆零件

一張圖就能生成分件可拆的 3D 模型,毋須人手標註或語義分割。KaiNinja 用兩個 O-Voxel 體素保留部件接觸面,把原生 3D 生成器延伸到部件級。

KaiNinja teaser

以往想做一張椅子、可以分開拆件再重新組裝的 3D 模型,往往要事先畫遮罩或跑一套語義分割網絡,既費時又限制後續編輯彈性。KaiNinja 由 Alaya Lab 團隊提出,目標是把 TRELLIS.2 這類原生 3D 生成器直接延伸成「部件級」輸出,毋須遮罩或分割網絡就能從單張圖生成可拆分的部件網格。

模型輸出兩個 O-Voxel 體素,各自解碼後透過連通區分量化成獨立部件,同時保留部件之間的接觸面,避免拆件後出現破洞或懸空。換言之,它在現有 3D 生成流程中替代或補強的,就是那一步手動標註與分割。

對遊戲美術、3D 資產設計、以及需要快速做可編輯原型的團隊來說,這類即拆即改的部件輸出明顯降低後製成本。雖然目前只釋出技術報告與項目頁面,推斷碼與預訓練權重尚未開源,但官方展示的下游材質替換與手繪動畫片段,已能看出部件分離對後續工序的實質幫助。

官方在 986 個物件的評測中,以匈牙利配對方式同時報告整體與部件級指標,在 CD、F1、mIoU 七個項目上均領先 X-Part、OmniPart、PartPacker、AutoPartGen 等同類方法,亦勝過用同一語料微調過的 TRELLIS.2。Fail 率(即整體 CD 大於 0.1 的比例)亦由 5.4% 降至 0.7%,代表部件拆分並沒有犧牲整體幾何質素。

重點摘要

  • 輸入單張圖片即可輸出部件級 3D 網格,免遮罩免分割網絡
  • 以兩個 O-Voxel 體素保留部件接觸面,避免拆件破洞
  • 在 986 件評測中,部件與整體指標同步領先 OmniPart、PartPacker、AutoPartGen
  • Fail 率由 TRELLIS.2 的 5.4% 降至 0.7%,整體幾何質素未受部件任務拖累
  • 目前僅有技術報告與項目頁面,源碼與權重標示為 Coming soon

項目主頁 · GitHub

Categories: 開源, 騰訊, AI productions, 模型, Image, 3D, 動畫

BVB 用 影片內容令 AI 自動轉為 Blender 3D 場景

BVB 拋開選擇題,要求 AI 代理直接用 Blender 重建 288 段真實室內影片,從程式碼品質判斷它到底有冇真正理解畫面內容。

BVB logo

現時大多數影片理解 benchmark 都係問 AI 「張圖入面有幾多張椅」,但 BVB(Blender-VideoBench)行另一條路:畀 AI 睇一段室內影片,然後叫佢自己寫 Blender 腳本,把場景、鏡頭動線逐個 primitive 砌返出嚟。如果代理人交到一個可以重新開啟、可以渲染嘅 .blend 檔,代表佢真係睇明條片。

每個代理會都被困喺同一個 Blender 4.2 Docker 沙盒入面,淨係可以用 bashframes,仲有共享成本上限。禁止使用任何外部素材庫,幾何體全部由代理自己用基本操作砌出嚟。呢種「同條件競技」設計解決咗以往影片 benchmark 靠選擇題容易被 prompt hack 或者背答案嘅問題。

數據方面,BVB 用咗 ARKitScenes、ScanNet、ScanNet++ 嘅 288 段室內影片,配合 5,130 條時空題目,並涵蓋 10 個模型家族、共 51 個配置。評分用兩條軸:Dual VQA 睇重建場景保留幾多影片入面嘅時空事實;Latent Similarity 就用凍結影片 embedding 對比重建結果同原片嘅感知距離,再以平方根均值合成綜合分數。

對做空間智能、機器人感知或者影片理解研究嘅團隊嚟講,呢個 benchmark 提供咗一個更貼近「代理人真係要喺軟件入面操作世界」嘅測試場景。視頻生成、動畫製作或者世界模型團隊亦可以直接借用 Mini-BVB harness 喺自己 pipeline 度做壓力測試。

團隊結果顯示,最強配置喺 Latent Similarity 做到 88.6,但 Dual VQA 仲有明顯差距,代表現時頂級模型仲未做到「理解」同「重建」兩條線同步推進。呢個落差本身就係 BVB 想凸顯嘅訊號:識答題未必等於識建模。

重點摘要

  • 288 段真實室內影片,全部來自 ARKitScenes、ScanNet、ScanNet++ 嘅 held-out split。
  • 51 個代理配置橫跨 10 個模型家族,統一跑喺 Mini-BVB 沙盒同成本上限下。
  • 禁止使用外部素材庫,逼代理人由 Blender primitives 自己砌幾何。
  • 評分用 Dual VQA 加 Latent Similarity 兩條軸,避免單一指標偏廢。
  • 目標係可執行、可重新渲染嘅 .blend 檔案,而唔係文字描述或者單張圖。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, Embedding, 視覺模型, 多模態模型, 世界模型, Qwen, OpenAI, Gemini, Video, 軟件, , Anthropic, 動畫, Dataset 數據集

ComfyUI-DLSS5-Enhancer:強化影片材質細節

呢個 ComfyUI 節點包直接調用原生 D3D12 渲染管線,把遊戲級嘅 DLSS 5 Neural Rendering 套到影片幀上面,重建皮膚、頭髮同布料嘅材質反應,而不只是銳化。

Repository image for Blueforcer/ComfyUI-DLSS5-Enhancer

一般後製銳化或 AI upscale 工具處理嘅多數係邊緣同紋理,皮膚嘅次表面散射、頭髮嘅光線穿透呢類材質反應好難靠濾鏡模擬。Blueforcer/ComfyUI-DLSS5-Enhancer 選擇咗另一條路:將 ComfyUI 內部嘅 RGBA8 幀傳去一個原生 D3D12 worker,由 ReShade 載體配合 RenoDX DLSS 5 add-on 觸發 NGX feature 18,重建完再送返 ComfyUI,仲支援 1.5x 到 3x 升頻。影片本身冇 motion vectors,佢哋用 OpenCV DIS 做稠密光流逐幀估算,並喺場景切換時自動重置 history,等渲染器唔會將錯誤嘅時序資料傳入去。

呢個項目嘅類型係工具 / 節點包,定位好明確:畀 ComfyUI 用戶喺影像同影片工作流直接用 DLSS 5 嘅神經渲染器。佢唔係一個自帶模型嘅外掛,神經組件係 NVIDIA、ReShade、RenoDX 嘅原生 binary,呢個 repo 只負責實作 client side 嘅二進制協議,包括 session 建立、解像度協商、幀序、取消同診斷。

NVIDIA DLSS 5 In ComfyUI Changes EVERYTHING! Full Setup Guide

硬件要求 NVIDIA RTX 50 系列原生支援,透過社區 runtime 可以喺 RTX 40 同 30 上面跑,RTX 20 或更早直接拒絕。ComfyUI 需要 V3 node API(comfy_api.latest),Python 依賴 numpy、av 同 OpenCV,ComfyUI portable 通常已經內建。

幾個重要限制:nr intensity 鎖死喺 1.0,1.0、1.5、2.0 嘅輸出 bit identical;skin structure strength 必須開啟 automatic mask 先有效,閂咗之後所有皮膚參數都唔再產生變化;nr preset 喺任何數值下都係 bit identical。只有 local structure strength 同 local tone strength 係全程範圍真正可調。預設、J、K 幾個 dlss model preset 嘅源幀 detail energy 大約喺 0.56x 左右,呢個唔係銳化工具想要嘅走向,反映嘅係材質重建比邊緣強化重要嘅設計取向。

適合已經用 ComfyUI 做影片後製、CG 合成、AI 動畫修復或者數字人相關工作嘅團隊同個人創作,尤其係想處理 skin、hair、fabric 呢類容易被傳統濾鏡抹平嘅材質細節嘅場景。留意到嘅限制係 GPU 受限於 NVIDIA,而且沒有 Python API,調用方式只能透過 ComfyUI 節點流程。

GitHub

Categories: 開源, ComfyUI, AI productions, 數字人, NVIDIA, API, Video, Image, 工具, 3D, Python, 動畫

jarvis-voice-butler:識睇住嘢同你傾偈 + 開瀏覽器幫你查資料

用講嘢就可以叫 AI 幫你上網、搜尋、填表,仲配上一把英式管家口吻。這個項目把 LiveKit Agents、Google Gemini Live 同 Playwright 串成一套聲控代理人。

Repository image for ruxakK/jarvis-voice-butler

聲控助手最麻煩嘅地方,往往係講完一句佢就要重新聽成段指令,又或者根本無法直接代你落手做嘢。Jarvis 直接針對呢個卡位,把 LiveKit Agents 框架、Google Gemini 3.1 Flash Live 即時語音模型,同 Playwright 操控嘅 Chromium 瀏覽器三樣嘢扣埋一齊。你可以理解成一個識講英式冷笑話嘅 AI 管家:你開口叫佢搜尋資料、撳掣、打字、捲頁、讀網頁內容,佢都會即時用「Enceladus」把聲回應你,過程仲支援自適應打斷同搶先生成。

對比起一般只能對答嘅語音 bot,呢個項目最大嘅突破係將語音輸入直接打通到瀏覽器操作層。佢內建十一個工具,包括開網址、搜尋、讀取同檢查頁面、撳掣、打字、捲動、撳掣鍵同截圖,仲有一個 confirm_browser_action 安全閘,去處理會造成實際後果嘅動作,例如提交表單或者刪除資料。視訊鏡頭輸入亦支援,等 AI 可以「睇到」你。

How to build a JARVIS AI Voice Agent for FREE | Full Livekit Tutorial (2026)

如果你想由頭砌起,作者用 uv 管理 Python 依賴,前端就用 Next.js 加 React,而家嘅程式庫亦用 Python 寫評估測試,覆蓋代理行為、瀏覽器操作同 prompt 表現。前端介面跟住會播一段自訂粒子動畫,連 Flutter 手機客戶端都一齊包埋,等你可以用手機當遙控。

呢類項目最適合做內部自動化研究助理,或者需要示範 Computer-use agents(CUAs)點樣融入聲音介面嘅團隊。值得留意嘅限制係實作仍處於早期階段,prompt 同安全策略都係寫死嘅版本,如果你想用佢處理高風險任務,仍然要自行加多一層審批同監察。

GitHub

Categories: 開源, Agentic, Google, Gemini, Audio, 框架, 工具, Python, , 語音, 動畫

anything2explainer:把任何主題變成科普影片

它不是 CLI,而是一套交給 AI 編碼 agent 用的方法包:從研究、旁白、字幕到分鏡,都用 Remotion 寫成 React 元件,產出可逐幀追溯的解說影片。

Repository image for Vincentwei1021/anything2explainer

當你丟一個主題或一篇文件給它,系統會先做資料蒐集並標註來源,再寫旁白、生成 TTS 語音,並把時間軸對齊到逐個鏡頭。接著多個建構 agent 平行運作,每個負責一個 Remotion(React + TypeScript)元件,QC agent 再依書面標準審查每一幀。輸出是 1280×720 H.264 MP4,配上字幕、章節卡與進度條,全程沒有現成影片或生成式影像模型的痕跡。

這套流程對創作者的最大意義在於可追溯。每個鏡頭都有自己的原始碼、QC 報告與研究文件,螢幕上出現的年份、數字、英文術語都要對得到來源 URL;live-action B-roll 也強制記錄在 MANIFEST 裡,附上 sha256、來源與授權。這種「紙本文書鏈」對需要審核的場景——例如企業內訓教材或品牌內容——比多數 AI 影片工具更有交代。

在同類做法裡,它明顯偏向工程化交付而非即興 demo。Remotion 元件庫、燈光與樣式規格、多 agent 協作協議都以可複用資產形式提供,並用一段完整的參考影片作為品質基準。對會寫程式、需要大量長版講解影片但又受版權與準確性束縛的團隊——例如 SaaS 團隊做產品教學、研究單位做技術普及——會比較感受到它的價值。

限制同樣明顯:不是 CLI,必須搭配 Claude Code 或 Codex 這類 agent 環境;TTS 要自備並處理對齊;中英文以外語言未提及支援;整個流程壁鐘 1 到 3 小時,瓶頸在並行建構鏡頭的數量與長度。授權採 PolyForm Noncommercial,商用前要先看清楚。

重點摘要

  • 全程程式碼繪製:用 Remotion 寫 React 元件產出每一幀,沒有生成式影片模型或現成素材。
  • 可審核的紙本文書鏈:研究文件、旁白、分鏡、鏡頭原始碼、QC 報告全部保留。
  • 多 agent 平行建構:研究、旁白、語音、分鏡後,由多個 agent 同時寫鏡頭元件,QC agent 再逐幀複查。
  • 多語言旁白:支援中文與英文,TTS 需自備並做強制對齊。
  • 非商業授權:採用 PolyForm Noncommercial,商用情境需自行評估。

GitHub

Categories: 開源, 文字轉語音, Agentic, AI productions, OpenAI, Video, Image, 工具, Content Creator, , 語音, Anthropic, 動畫, Skill 技能

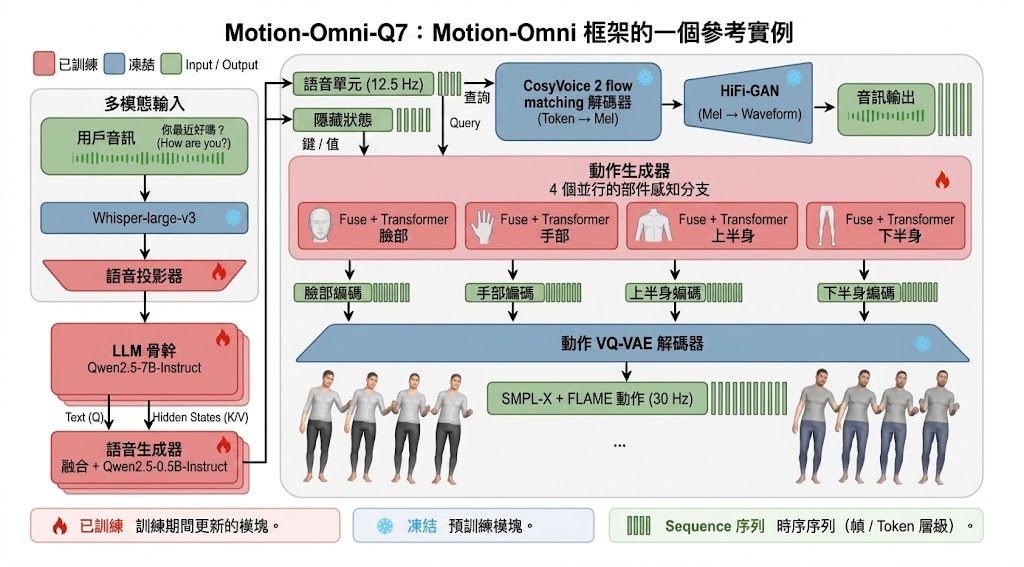
Motion-Omni:「講嘢」同「做嘢」視為同一件事,直接生成全身動作

Motion-Omni 把語音和全身動作綁在同一個模型,講一句話就能即時生成對應嘅身體動作、表情同手势,適合需要邊講邊做嘅虛擬角色。

Motion-Omni framework

試過睇虛擬角色傾偈,個口形郁但身體硬晒,或者要逐段人手配動作?Motion-Omni 想解決嘅就係呢種「聲有、體無」嘅唔自然感。佢係一個端到端嘅多模態模型,輸入一段語音,輸出唔只有語音本身,仲有頭部、表情、手势以至全身姿態,全部喺同一個框架一齊生成,避免傳統做法分開處理再硬砌嘅斷裂感。

Motion-Omni 用咗一個統一嘅 tokenizer 把語音、文本同動作 token 化,配合 LoRA(Low-Rank Adaptation)adapter 等輕量微調技術,令模型可以同時學語音同肢體表達。生成嘅動作涵蓋手部、軀幹、面部表情,適合需要即時互動嘅場景,例如 AI 助手、虛擬客服、遊戲 NPC、語音驅動嘅動畫原型。

傳統動畫要先錄關鍵動作、再做 lip-sync 後製,而坊間部分開源方案往往只能控制頭部或者手部其中一樣。Motion-Omni 嘅做法係將「講嘢」同「做嘢」視為同一件事,所以動作會跟語氣、節奏同步變化,唔使額外人手調整。佢同時支援文字輸入,等開發者可以更直接控制角色行為。

對做 AI 角色、互動內容、語音動畫嘅團隊嚟講,呢種端到端做法可以慳唔少配動作同後製嘅工序,尤其適合需要快速原型嘅項目。讀者可以透過官方頁面睇影片 demo,評估生成動作嘅自然度同延遲表現,再判斷適唔適合自己嘅工作流。

重點摘要

  • Motion-Omni 係一個端到端多模態模型,同時輸出語音、表情同全身動作
  • 用統一 tokenizer 加 LoRA adapter 處理語音、文本同動作 token
  • 覆蓋頭部、手部、軀幹同面部表情,適合即時互動角色
  • 傳統做法分開配音同配動作,呢個模型將兩者合併生成
  • 適用於 AI 助手、虛擬客服、遊戲 NPC、語音動畫原型等場景

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 北京大學, AI productions, 模型, 多模態模型, Video, 框架, 語音, 動畫

MiniMax H3 迎來 19 款 LoRA,影片生成速度與風格同步擴展

MiniMax H3 的 LoRA 生態逐步成形,從加速推理到角色動作與畫面風格,為 ComfyUI 工作流提供更多選擇。

AVvXsEjfkOvyf5h2H5Z vYu8kIES0pGOidPGIbqyszhocYoXkK67 2yzenUgugZ9qtXe3Hzn5kB0K6Sdy36A78G4DPO1 veLpRRoPuSivw3r4Vdw zSOSgs1

想用MiniMax H3製作影片時,速度、動作表現和視覺風格往往難以同時兼顧。這項整理聚合19款MiniMax H3 LoRA(Low-Rank Adaptation)模型及變體,讓使用者按工作流需要調整生成方式,而不只依賴基礎模型。

加速類模型以Alibaba的MiniMax-H3 Acc LoRAs為例,透過Parallel Decoding Distillation(PDD)支援FL2VA與Ref2VA工作流,目標是在較少推理步數下維持影像質素。MiniMax H3 Turbo Sparse Linear Attention LoRA則採用Sparse Linear Attention(SLA),以85%注意力稀疏比例提升效率,在NVIDIA RTX 5090上約可達2.5倍推理速度。

其他變體針對不同創作需求,包括1930年代手繪動畫質感、Z-Image風格帶來的紋理和較自然的粗獷感,以及更適合本地執行的4-bit版本。模型需要配合MiniMax H3基礎模型與ComfyUI工作流,LoRA檔案則放入ComfyUI/models/loras資料夾。

• 以少量步數加快影片生成
• 支援FL2VA及Ref2VA工作流
• 涵蓋動畫、寫實、動作和鏡頭風格
• 提供VRAM較友善的4-bit選項
• 速度提升仍需按硬件與畫質要求取捨

適合已使用ComfyUI,並希望細緻控制生成速度、角色移動、鏡頭行為或整體美術方向的創作者。不同LoRA針對的任務差異很大,選擇時應以工作流兼容性和輸出要求為先。

項目主頁

Categories: 開源, ComfyUI, NVIDIA, Video, Image, 教學, 動畫, MiniMax

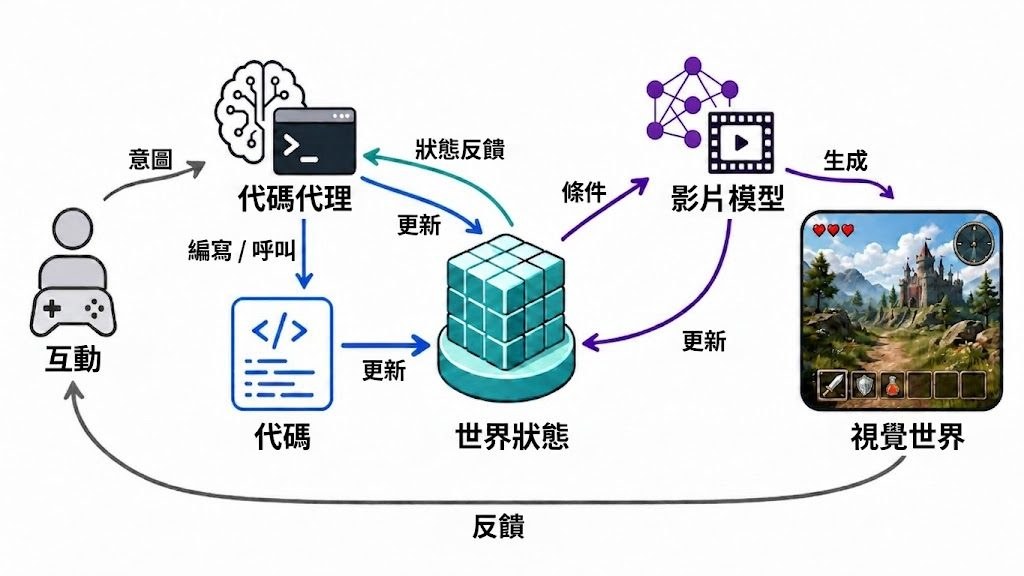
Code World Model:以 coding agent 當大腦,video model 演畫面,世界不再失憶

Code World Model 讓 coding agent 負責推演世界狀態,再由 video model 將結果呈現成影像,支援更持續的互動場景。

Pipeline of the proposed Code World Model

當影片模型只能呈現事件結果,卻難以記住規則、因果和長期後果,互動世界就容易變得不連貫。Code World Model 以 coding agent 作為「世界大腦」,透過可執行程式碼更新及控制世界狀態,再交由 video model 將狀態轉化為視覺觀察。

這種分工把世界演化和畫面生成拆開處理。coding agent 會根據事件推理後果、規劃變化並編寫程式;video model 則負責利用生成先驗呈現場景,讓同一個世界狀態可以延伸出不同視覺體驗。

項目展示了長時間生成及定期轉換風格的場景,包括海底港口、魔法學院、糖果運河和雲上海港等內容;展示中亦使用 RGB Proxy,並以約每60秒一次的節奏改變風格。這類架構適合研究開放式世界模擬、互動敘事,以及需要持續狀態和因果後果的視覺體驗。

• coding agent 負責規則、事件與世界狀態
• video model 負責將狀態實現為影像觀察
• 可支援較長時間的世界演化與持續後果
• 透過分離邏輯和畫面,減少只從影像學習動態的限制

目前資料集中於框架概念、展示場景及研究論述,因此不能視為已確認可自由下載的模型。使用者亦需要留意,視覺效果和世界狀態的一致程度仍會取決於 coding agent 的推理、規劃及編程能力,以及 video model 的生成能力。

項目主頁 · Paper

Categories: 開源, Agentic, 視頻模型, 世界模型, 模型訓練, Video, 框架, Vibe Coding, 編程, AGI, 動畫, MiniMax

Wan-Animate-2 把角色動畫推向即時互動

同一張角色圖,已經可以跟住驅動影片做出更穩定動作,連鏡頭角度都可另外控制。Wan-Animate-2想解決的,不只是畫面靚唔靚,仲包括直播同數字人能否即時用。

Og image

一張角色圖片配合一段驅動影片,便可以生成動作自然、表情細緻的角色動畫,這正是 Wan-Animate-2 想處理的核心場景。它屬於角色動畫生成框架,重點不只放在畫質,還試圖解決身份容易走樣、動作細節流失,以及難以支援即時互動這幾個長期卡位。

跟不少依賴中間動作表示的方法不同,Wan-Animate-2 直接把 driving video 餵入重新設計的 Diffusion Transformer,避開 motion extractor 帶來的誤差與 identity drift。這種端到端做法的好處,是角色外觀保持得更穩,細微表情、複雜肢體動作,甚至角色與場景之間較合理的互動,都更容易保留下來。

它另一個值得留意的能力,是加入 text-driven viewpoint control,令輸出鏡頭角度可以跟驅動影片分開控制。對數字人、直播主持、虛擬角色演出這類互動工作流來說,這代表同一段驅動內容不一定要綁死原本視角,使用時更容易配合不同畫面需求。

  • 直接使用 driving video,而不是先抽取中間動作表示
  • 主打更穩定的 identity preservation 與 motion fidelity
  • 支援 text-driven viewpoint control,可分離鏡頭視角與驅動動作
  • 推出 Wan-Animate-2-Lite,目標是把推理延遲壓到即時門檻
  • 預告公開 Wan-Animate-2-Base 權重,方便社群延伸研究

為了走向即時應用,團隊亦提出 Wan-Animate-2-Lite,並用三階段訓練流程去降低 inference latency,包括 teacher forcing pretraining、error buffer mechanism,以及 Self-Forcing distillation 配合 chunk-wise backpropagation。現有結果與使用者研究顯示,它在多種角色和動作模式下都有不錯的高保真表現;不過目前公開資訊仍以研究展示為主,部署成本、硬件需求與長時間串流穩定性,仍要等更多公開細節驗證。

項目主頁

Categories: 阿里巴巴, 視覺模型, Video, Image, 動畫

Page 1 of 2
1 2