AutoGUIWorld:跨平台 GUI Agent 訓練場景及模型

以圖像生成模擬 GUI 狀態轉換,降低建立跨平台對真實軟件環境的依賴。

GUI Agent 要學懂跨平台操作,往往受限於收集資料時能夠安裝和重設的軟件環境。AutoGUIWorld 會生成 Windows、macOS、Ubuntu、Chrome、Android 或 iOS 的 GUI 場景,再由模型規劃點擊、開啟、切換等動作,透過圖像編輯生成每一步的畫面。它屬於面向 Computer-use agents 的資料生成框架,在毋須逐一啟動真實應用程式的情況下,建立有畫面、有動作、有座標標註的訓練軌跡。

AutoGUIWorld 把語意規劃和畫面轉換分開。Meta Planner 先按場景建立任務及動作序列,Voyager 讀取最新的乾淨截圖,描述下一個視覺狀態,再交由獨立的模型 adapter 處理文字、視覺和圖像生成或編輯;grounding backend 則負責找出指向目標的位置。每條軌跡會保留 obs_k.png、帶有目標框的 act_k.png,以及記錄任務、計劃、動作、畫面對應、grounding boxes 和 provenance 的 meta.json,方便日後檢查和重用。

  • 覆蓋 Windows 11、macOS、Ubuntu 24.04、Chrome、Android 和 iOS 場景
  • 技術報告使用的 AutoGUIWorld 訓練集包含 79,266 個 grounded and filtered examples
  • 支援 LocateAnything-3B、MAI-UI 或視覺語言 backend 進行 pointing grounding
  • 固定 random seed 可重現結構化場景,但模型輸出的文字和像素仍可能改變
  • 生成資料不會在真實桌面執行動作,也不會自行驗證任務是否完成

雖然 AutoGUIWorld 以視覺生成換取更快的場景擴展和較低的環境管理成本。代價是生成畫面未必等同真實軟件狀態,圖像模型也可能產生不合理的介面轉換,因此項目提供 scene validity、action alignment 和 transition fidelity 等品質檢查,但不能把這些檢查視為真實執行結果。

目前公開結果集中在資料生成和模型訓練流程。用家可隨時以軌跡微調 Qwen3.5-35B-A3B ,建立合成訓練資料。對只需要真實操作成功率、而且不能接受模擬畫面偏差的工作流程,仍應把真實環境測試放在資料生成之後。
GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, Image, 框架, 軟件, Mac, Linux, Win, Dataset 數據集, UI/UX

Physis-Lang 讓影片模型理解物理因果

影片畫面看似合理,動態卻可能違反物理規律。Physis-Lang 以可演化的物理語言,改善影片資料整理、訓練與生成。

Physis

當影片模型能生成融化中的牛油,卻未必理解升溫、重力與形變之間的關係,Physis-Lang 便嘗試補上這個落差。這個由 NVIDIA、MIT 與 University of Oxford 研究團隊提出的 Video World Model 研究項目,把物理因果、相互作用、支配原理與結果寫進共享語言表示,協助模型生成更合理的世界演化過程。

Physis-Lang 不只描述畫面發生了甚麼,還要求字幕交代事情為何發生。例如牛油融化的描述會進一步指出升高的溫度提供熱力,熱力促成融化,而重力令牛油向下塌成淺層液體。物理概念會經由 Physics-aware critic 找出遺漏或缺乏視覺證據的說法,再由 agent 修訂共同的 captioning guidelines,captioner 本身則維持不變。

整套方法連接資料整理、模型訓練與推理:模型失敗會轉化成物理領域查詢,再透過 language-guided retrieval 找出能補足缺口、而且視覺內容多樣的影片;演化後的語言會重新製作訓練字幕,並擴展 inference prompts,同時加入針對場景的 negative descriptions,減少不合理動態。

  • PhysCapBench 收錄 246 段經審核的物理影片及 3,794 個人工驗證 assertions
  • 評估字幕對物理細節的 precision、recall 與 F1
  • Physis-Lang · Cosmos3-Super 在 Physics-IQ 公開排行榜列第一,平均分數為 48.2 ± 1.4
  • Physis-Lang · Cosmos3-Nano 列第二,平均分數為 43.3 ± 1.5

這項研究適合關注 Video World Models、物理推理和影片生成可靠性的讀者。排行榜結果顯示,加入可演化的物理語言後,Cosmos3 系列模型在相關評測中取得進展,但分數只反映指定基準,並不代表所有影片場景都能避免物理錯誤。

項目主頁

Categories: Agentic, 世界模型, 模型訓練, NVIDIA, Video, 框架

RSIGame:生成遊戲及自行測試與進化

RSIGame 讓 AI 由遊戲構想開始反覆遊玩、找錯和改寫程式,直到品質提升飽和,再保留最佳版本。

RSIGame

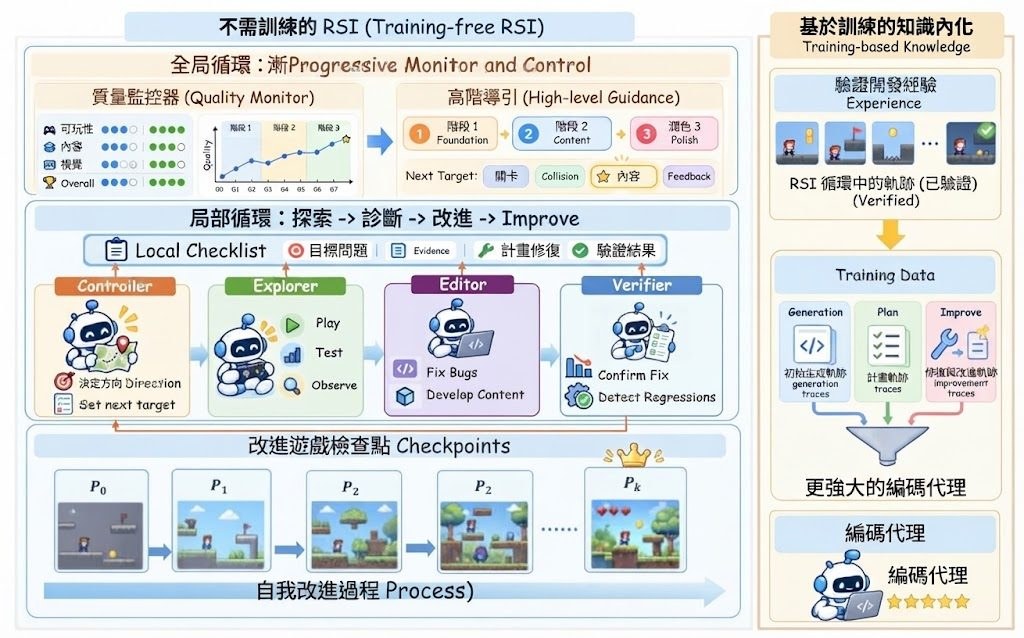
由一句高層遊戲構想開始,系統會自行產生可玩的版本,透過 AI agents 反覆遊玩、檢查問題,再改寫遊戲程式。RSIGame 屬於 autonomous agentic game development framework,實際處理的是生成遊戲難以持續修正、容易只迎合少量測試案例的問題。

RSIGame 把流程分成 local loop 和 global loop:前者執行 explore-diagnose-improve,廣泛探索遊戲、整理問題優先次序,再按證據修改;後者追蹤整體品質、保存最佳 checkpoint,並在長時間開發中識別停滯或回退。測試指引亦會逐步累積,令後續檢查不只依賴原本的提示。

透過 Hugging Face Space 輸入基本遊戲概念或設計方向,查看 agents 如何自動遊玩及產生較高評分版本。GitHub 項目要求 Python >=3.11,並以每次提交執行的測試檢查憑證外洩和內部 import 解析;自行研究或部署時,仍要留意所需模型、遊戲引擎及執行環境未在提供資料中完整列明。

在 140 個 GameCraft-Bench 任務、兩個遊戲引擎及五個生成器的相同開發預算下,RSIGame 持續提升遊戲品質。經驗內化後,Qwen3.8-27B 在 Godot 取得 61.38、在 Phaser 取得 58.53,超過 GPT-5.5 一次生成的分數,同時把 Qwen 的生成 token 減少 11 倍;結果仍屬基準測試,不能直接等同於所有遊戲類型的穩定表現。

  • 由高層構想生成遊戲,再自行遊玩、診斷和修正
  • local loop 負責局部問題,global loop 負責品質與版本選擇
  • 支援 Godot 和 Phaser 等遊戲引擎評估
  • 透過訓練內化成功的開發經驗,減少後續生成成本

RSIGame 適合研究 agentic coding、遊戲生成及長流程自我改進的團隊,也適合作為檢驗 AI 是否能處理多輪程式修正的研究框架。它的代價是流程需要較多執行時間、模型及遊戲環境配合,評分提升亦受測試任務和開發預算影響。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型訓練, Qwen, 框架, Python, 編程

EngiWorld 把工程代理接入真實軟件工作流

EngiWorld 不只測試代理人能否操作介面,更檢查它能否交付合乎工程規範的成果。

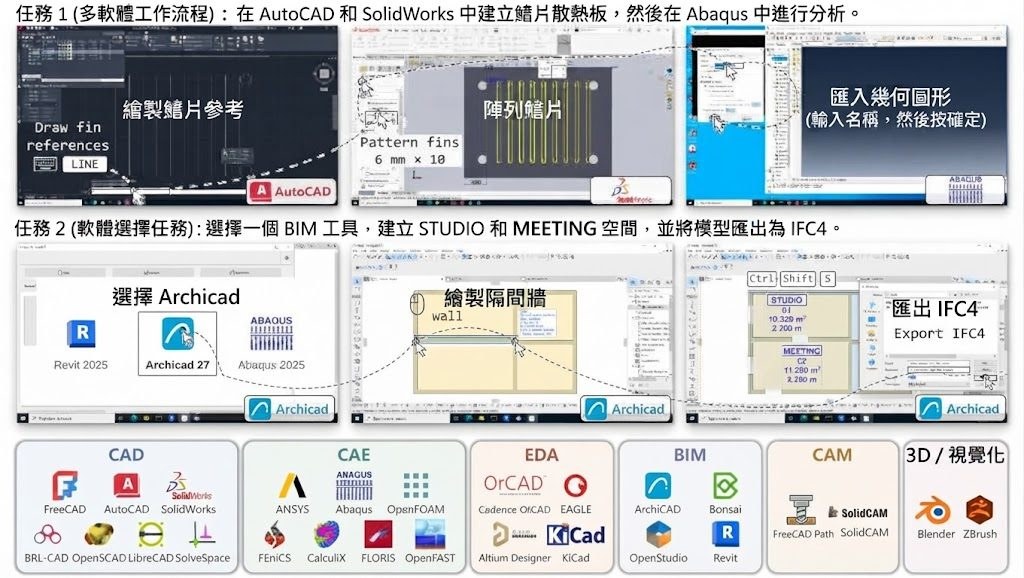
EngiWorld task examples and engineering software coverage

代理人要在 CAD、CAE、CAM、BIM、EDA 和 3D 視覺化軟件中完成工作,難點不只是點擊按鈕,而是要維持幾何、物理條件及跨軟件流程的正確性。EngiWorld 屬於工程代理人評測基準,實際處理的是「能否由指令一路產出可驗證工程成果」這個問題。

項目收錄 1,301 個專家編寫任務,涵蓋 26 個軟件平台、6 個工程領域及 6 類任務,支援 GUI 和 CLI。評測會檢查最終及中間工程文件的幾何有效性、物理可行性和規則符合度,數值設計任務亦會按規格達成程度連續計分,而非只分成功或失敗。

  • 提供完整任務、驗證器及 GUI/CLI 評測執行環境
  • 主實驗採用 300 個任務,清單位於 task/splits/main-300.txt
  • 本地環境以 Linux、Docker 及虛擬機器執行,預設每個環境使用 4 個 CPU 和 16 GB RAM
  • 七個前沿模型中,最高 EngiScore 只有 44.3;多軟件嘗試成功率為 3.6%

同類 Computer-use agents 評測多集中於一般桌面操作,EngiWorld 把判斷標準推到可交付的工程 artifact,因此更能揭示模型在長流程、跨軟件依賴及專業規範上的不足。代價是執行門檻較高:需要 x86_64 Linux、Python 3.10、Docker Engine 和環境映像,沒有 /dev/kvm 時亦可運行,但軟件模擬會較慢。

研究團隊、工程軟件開發商,以及想比較 GUI agent、CLI agent 或多模態模型能力的團隊,都可以用它重現測試並保存評測結果。它目前更適合作為嚴格的研究及模型比較工具,而非即插即用的生產自動化方案;最高分數與多軟件成功率反映,代理人距離穩定完成專業工程流程仍有明顯距離。

項目主頁 · GitHub

Categories: 開源, 北京大學, 清華大學, Agentic, 模型, 多模態模型, 軟件, 工具, 3D, Python, Dataset 數據集

HybridCUA 讓 Agent 懂得何時用命令列

浙江大學、北京大學與清華大學團隊,讓 Computer-use agents 在 GUI 操作與 CLI 指令之間作出選擇,減少冗長點擊流程及連鎖錯誤。

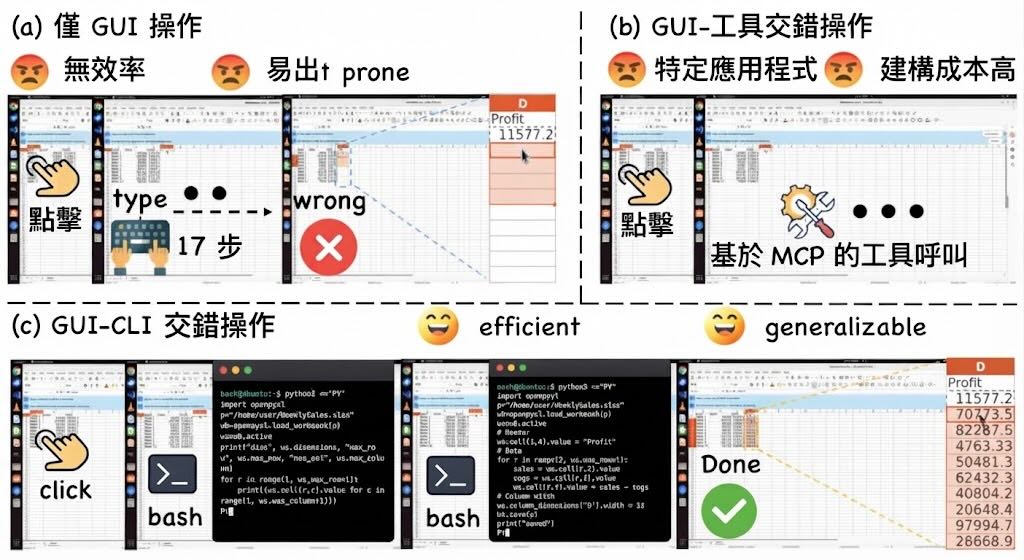
浙江大學、北京大學與清華大學的研究團隊,將 CUA (Computer-use agents) 從單靠滑鼠鍵盤操作,帶到 GUI 與 command line interface(CLI)協作的工作方式。HybridCUA 屬於訓練框架及模型項目,處理的是代理知道可以用 shell 之後,仍未能判斷何時使用、如何使用的問題。

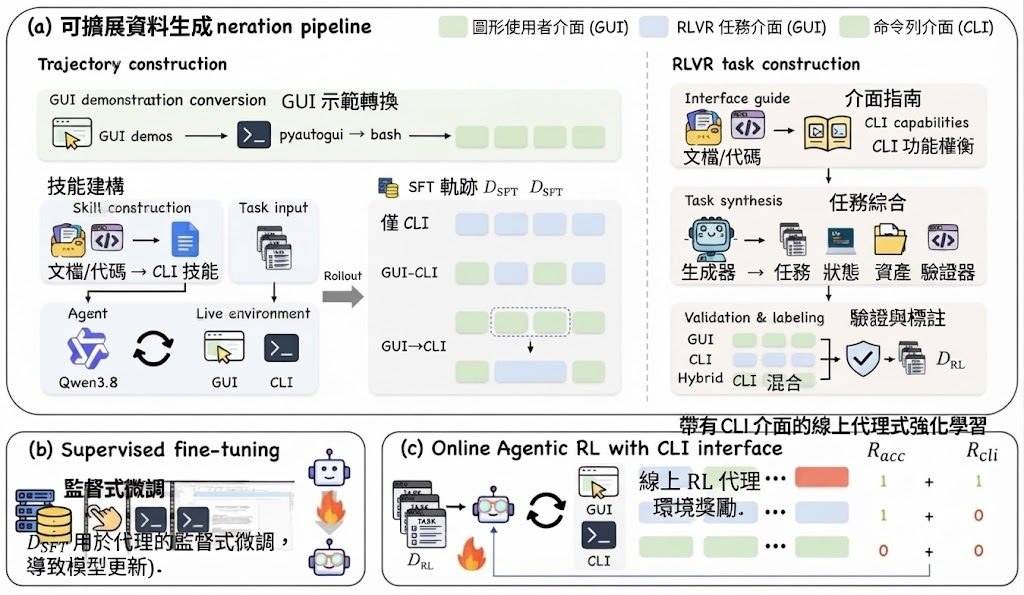
連串的 GUI 操作可以由一條命令取代,但 CLI 暴露給未受訓練的代理,反而令 OSWorld 準確率下降 2.5 至 11.5 個百分點。HybridCUA-8K 收集 GUI only、CLI only,以及交錯使用兩者的軌跡,再配合 supervised fine-tuning 和 CLI-aware rewards,訓練 HybridCUA-9B 選擇較合適的操作方式。

HybridCUA pipeline: (a) scalable generation of GUI-only, CLI-only and interleaved trajectories plus annotated RLVR tasks

• HybridCUA-9B 在 OSWorld 達到 53.6%,較基礎模型高 14.8 個百分點
• 平均每項任務使用 14.0 步,並可轉移至 OSWorld-MCP 及 Windows
• HybridCUA-8K 包含 5K 條混合軌跡及 3K 個已驗證 RLVR 任務
• CLI reward 分為 trajectory level 與 step level,分別鼓勵成功完成及減少失敗指令成本

儲存庫以 env_infra、online-rl 和 site 分開環境平台、GRPO 訓練流程及項目網站;前兩者透過 HTTP 的 /v1/sessions 協作,訓練器毋須自行啟動 VM 或容器。README 提供安裝腳本及 GPU、nvcc、Ray 等環境要求,但模型仍標示為 coming soon,因此目前較適合研究 Computer-use agents、GUI automation 或跨平台代理訓練的團隊閱讀資料集與訓練架構。

結果在 WindowsAgentArena 提升 4.0 個百分點,OSWorld-MCP 達 47.1%,Windows 達 36.0%,顯示 GUI 加 CLI 的方法具備一定跨平台能力;不過項目仍依賴複雜的分散式訓練環境,未提供即時可下載模型,距離一般使用者直接安裝仍有距離。

項目主頁 · GitHub · 模型

Categories: 開源, 北京大學, 清華大學, Agentic, MCP, 模型訓練, 庫, Dataset 數據集

OpenAI dots:讓 AI 代理持續推進複雜工作

OpenAI 將 dots 設計成可持續工作的 AI 代理,協助處理跨應用程式的任務,同時保留人員審批權。

Og image

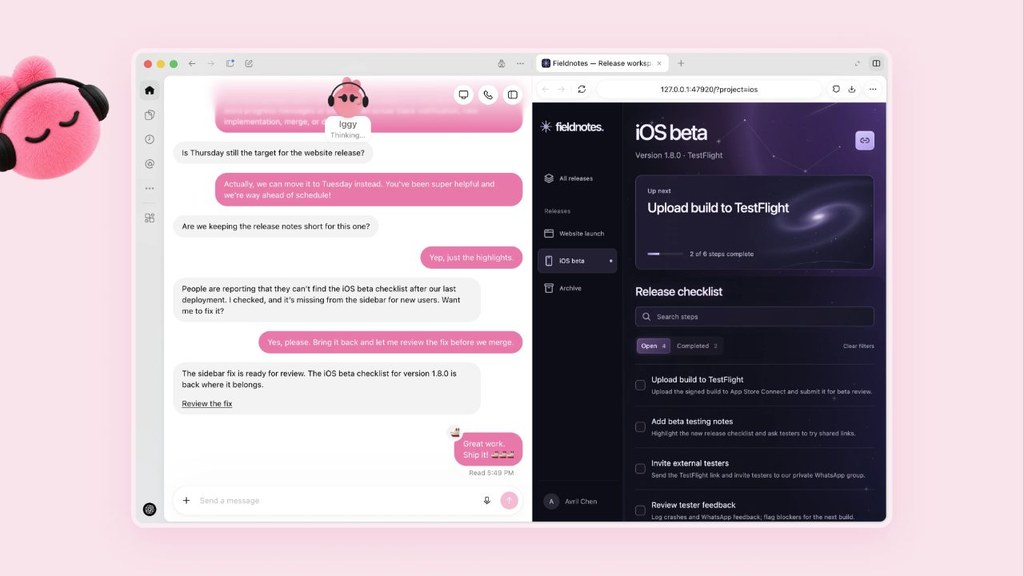
OpenAI 把 dots 交由 GPT‑6 Astra 驅動,定位成能長時間代辦工作的 AI 代理,處理項目跟進、應用程式操作和日常行政等容易中斷的工作。它擁有獨立雲端電腦,可按目標持續工作,亦會透過使用者回饋逐步掌握偏好與工作標準。

Dots 可經由插件連接超過 4,000 個應用程式,並在 ChatGPT、Slack 或 Teams 內使用。使用者可以直接提問、提供意見,或透過語音通話討論工作;在需要發送郵件、建立文件或執行其他操作時,系統會配合權限設定及審批流程,讓人員保留控制權。

OpenAI 分享的場景包括調查 Slack 中的程式錯誤、把新設計轉成可運作的應用程式,以及協助團隊追蹤規劃週期。早期測試者的 dot 亦曾發現漏開發票,準備文件後待使用者批准才寄出,反映它處理的是持續跟進而非單次問答。

目前 dots 正逐步向 Pro、Business Premium 和 Enterprise 計劃推出,完整的安裝步驟、收費細節及市場名單未有在提供的資料中交代。可先留意以下能力與限制:

  • 以 GPT‑6 Astra 為核心,配備獨立雲端電腦
  • 透過插件連接超過 4,000 個應用程式
  • 支援 ChatGPT、Slack、Teams 及語音互動
  • 可根據回饋學習偏好,持續推進工作
  • 權限、操作檢視和審批機制仍由人員掌控

項目主頁

Categories: Agentic, OpenAI, 語音

LEGO-Anything:由單張圖片生成可編輯 3D 世界

由一張圖片開始,coding agent 會逐步寫程式、渲染和修正,產出可查詢及編輯的 Blender 3D 場景。

Og image

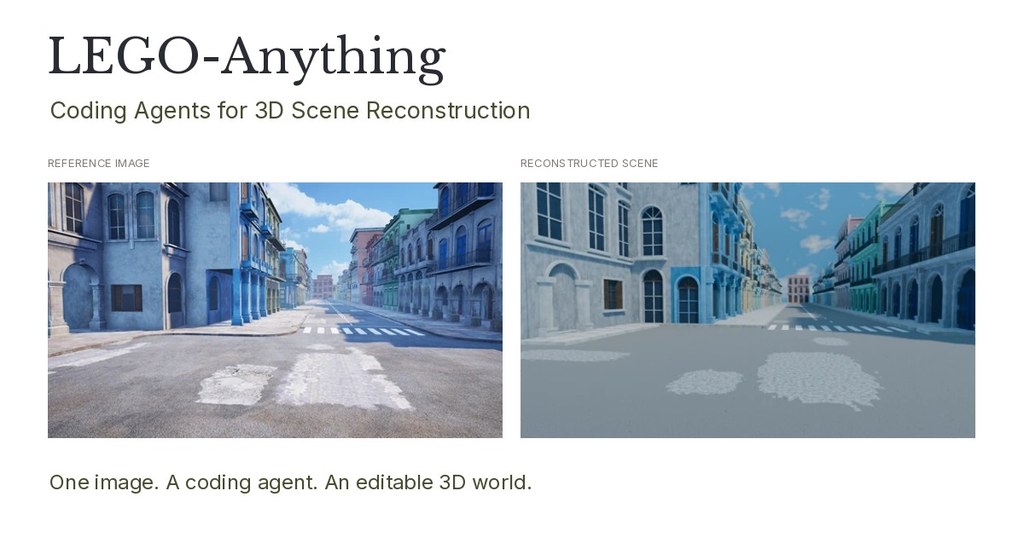
由一張 RGB 圖片開始,coding agent 會自行規劃、執行 Blender 程式、渲染結果,再按視覺檢查持續修正,將參考畫面轉成可編輯、可查詢及可匯出的 3D 世界。LEGO-Anything 同時涵蓋 agentic scene reconstruction 的框架、評測基準 LEGO-Bench,以及協助分析建構過程的 LEGO-Plugin。

項目處理的核心問題,是如何讓模型不只生成一張相似圖片,而是建立具備幾何結構、鏡頭和物件狀態的可執行場景。Agent Workspace 管理產物,Action Space 提供操作,Blender Code Structure 保存可修改的場景狀態,Scene Construction Workflow 則把參考解讀、程式生成、渲染和驗證串連起來。

LEGO-Bench 收錄來自104個場景的208張圖片,涵蓋8個環境、17個主題及443項資產,並以 Indoor、Outdoor 和 Easy 至 Hard 的物件集合測試不同難度。評分同時考慮 Blender 場景是否有效、可見表面幾何重建,以及重新渲染後的色彩吻合度;無效提交或未能完成評估的案例會取得零分。

目前公開結果顯示,GPT-6-astra 在室內及戶外分別取得53.4%及39.6%的 Overall 分數,高於其他參與比較的 coding agents;戶外場景在各難度層級都較難處理,而場景有效率仍未代表幾何和視覺細節已經高度吻合。對需要可修改 Blender 資產、可重現場景或研究 Computer-use agents 3D 操作能力的工作流,這套框架提供了較完整的測試方式。

  • 由單張圖片生成可執行的 Blender 場景
  • 透過寫程式、渲染和驗證逐步修正結果
  • 同時評估場景有效性、幾何重建和外觀吻合度
  • LEGO-Bench 涵蓋室內、戶外及多級物件難度
  • 戶外場景和高視覺保真度仍是主要限制

項目主頁

Categories: 開源, Agentic, Image, 框架, Vibe Coding, 3D, 編程, Dataset 數據集

OmniTaskonomy:令圖片生成圖片更準確

OmniTaskonomy 以配對實驗檢驗 I2I 訓練能否改善 I2T 理解,並找出最有效的訓練次序與任務轉移關係。

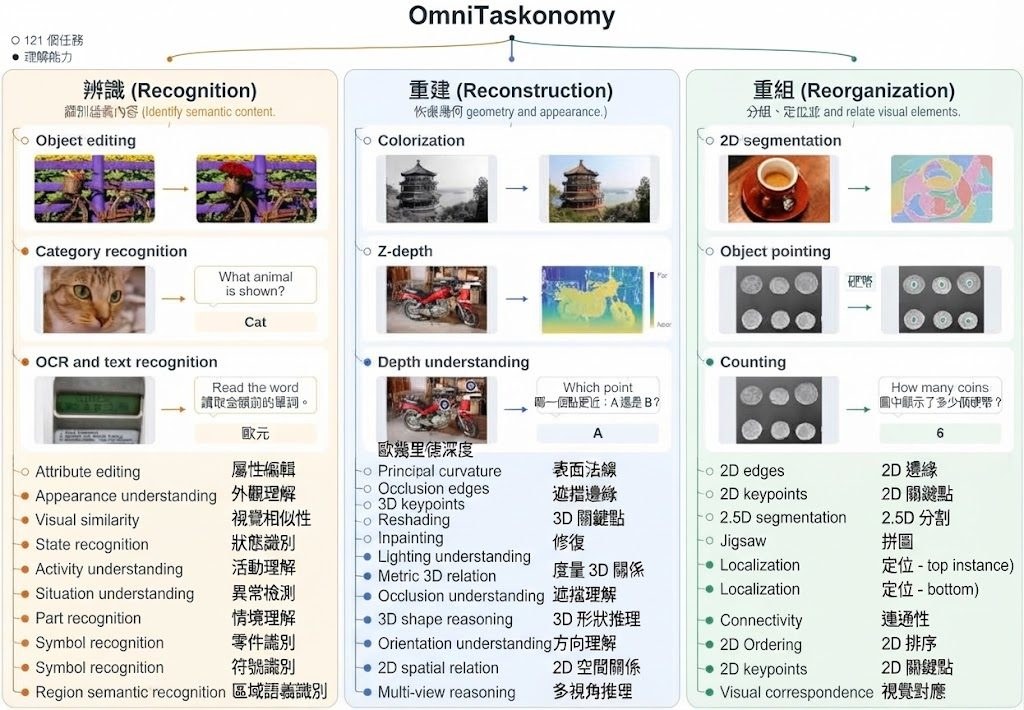
I2I reconstructs the Jigsaw image, a dot moves from Visual Generation to Visual Understanding while changing color, and

同一個多模態模型既要生成圖片,又要讀懂圖片,兩種能力未必會自然互相提升。OmniTaskonomy 是一個研究型 benchmark 與資料集項目,透過 Image-to-Image(I2I)和 Image-to-Text(I2T)配對任務,測試視覺生成訓練何時能改善視覺理解。

項目沒有把生成與理解混成單一分數,而是比較六種訓練流程,包括只做 I2T、先做 I2I 再做 I2T(I2I → I2T),以及從一開始混合兩種目標。結果顯示,先以 I2I 更新與理解能力共用的權重,再進行 I2T 微調,通常比同步訓練或凍結共用權重更穩定;I2I 資料增加時,I2I → I2T 和 I2I → Mixed 的收益亦持續上升。

從 GitHub 儲存庫了解實驗流程,並配合 Hugging Face 上的 OmniTaskonomy 資料集重現配對任務。項目適合研究多模態模型訓練、視覺能力轉移及 curriculum learning 的團隊,但並非即裝即用的影像工具,重現結果仍要配合模型、訓練資源和原有設定。

幾個結果有助判斷它的研究價值:
– 定位與物件指向對 counting 的增益最大。
– 深度及 surface-normal prediction 可改善 metric 3D relation。
– 各種理解能力的 mean alignment 與 mean transfer 相關係數為 r = 0.795。
– 133 個 source–target pair 的相關係數降至 r = 0.529,反映任務之間的轉移並不一致。

Gradient alignment 主要集中在早期 pre-attention normalization layers,並與下游 transfer 呈正向關係。這讓 OmniTaskonomy 不只回答「生成能否幫助理解」,亦提供一套分析哪些生成任務值得加入訓練、哪些能力不應直接互相推論的方法。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, Image, 工具, 庫, Dataset 數據集

OmniEcho:讓智能體真正「聽聲辨位」的全方位音視覺模型

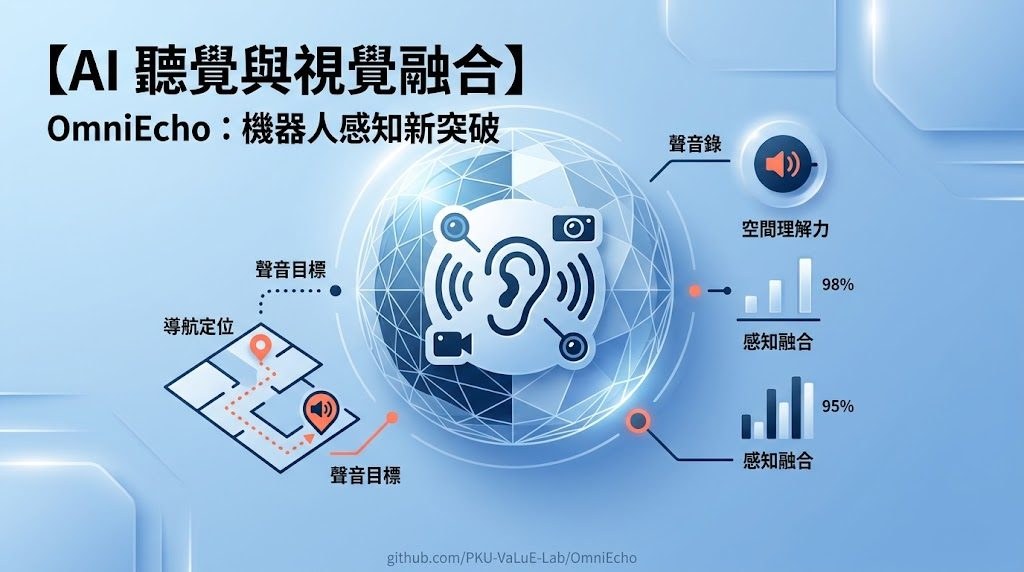
聲音從哪個方向來、距離多遠,是人類憑本能就能判斷的事,對機器人卻是一道難題。OmniEcho 把一階 Ambisonics 空間音訊、視覺與語言整合到同一個智能體,專門研究這類空間感知與聲源導航。

Repository image for PKU-VaLuE-Lab/OmniEcho

OmniEcho 是一個面向 embodied agent 的音視覺空間感知項目,由北京大學 PKU-VaLuE-Lab 開源。它要解決的問題很直觀:當一個智能體同時聽到聲音、看到畫面,它能否判斷聲源在哪個方向、距離多遠,並進一步循聲走去?這件事對人類毫不費力,但要讓 AI 真正做到,過去並不容易。

項目同時提供三樣東西:統一基準 OmniEchoBench、可控的空間音訊渲染管線,以及基於 Qwen3-Omni 改進的 OmniEcho 模型。後者最關鍵的設計,是在 Qwen3-Omni 既有語意音訊通路之外,加掛一個專門處理 FOA(一階 Ambisonics)空間資訊的編碼器,讓模型同時理解「聽到什麼」和「聲音從哪來」。

基準涵蓋六類任務,合共 197 個真實音視覺場景、2,972 條 QA 與 900 條導航樣本,全部由人工核對標註。OmniEcho 在空間音視覺感知上達到 state-of-the-art,而循聲導航的表現已經逼近傳統「靠文字指示」的視覺語言導航。不過細粒度的方位判定與距離估計,仍被作者列為尚未解決的難題。

對做機器人導航、音視覺融合研究,或需要智能體在真實場景中聽聲定位的團隊,這套項目提供了一個可以直接拿來跑評測、訓練、再挑戰的起點。原文並未附上完整的安裝或下載流程,相關代碼與模型權重目前標示為即將釋出。

重點摘要

  • 空間音訊加視覺語言:以 FOA 為輸入,與視覺、語言一起餵進 omni-modal agent。
  • 雙編碼器設計:在 Qwen3-Omni 之上新增 FOA 空間編碼器,保留原有語意音訊能力。
  • 真實世界基準 OmniEchoBench:六類任務、近 3,000 條 QA 與 900 條導航樣本,人工核對。
  • 循聲導航貼近文字導航:在 Nav 任務上接近傳統 VLN 水平,但方位與距離仍偏弱。
  • 代碼與權重待發佈: 標示 Coming Soon,暫無公開安裝步驟。

GitHub

Categories: 開源, 北京大學, Agentic, 模型, 視覺模型, 模型訓練, Qwen, VLA, Audio

Taste-Bench :避免把時間和計算資源花在錯路上

AI Agent 要做的選擇,當下往往看似合理,代價卻可能在很久之後才浮現。Taste-Bench 把這類決策分岔整理成測試,檢查模型能否及早選對方向。

Taste-Bench

AI Agent 做長任務時,選錯方向可能要到多個步驟之後才看得出代價。Taste-Bench 是一套評測資料集,讓模型閱讀任務背景、分岔前的操作紀錄,以及兩個候選下一步,再判斷哪個選擇較好;它測試的不是單步答題,而是能否避免把時間和計算資源花在錯路上。

資料集有 502 題,從軟件工程與機器學習研究任務的操作軌跡中整理而成,沒有逐題由專家標註。題目分為兩類:不同嘗試在同一位置分岔,最後結果提供判斷依據;或同一次執行中,Agent 遇到失敗後放棄原路並恢復。研究團隊從 4,657 個候選分岔中剔除過於簡單或無法判定的題目,並以後續結果標示較佳方向。

測試時可從 Hugging Face 取得資料集,按題目提供的紀錄比較模型選擇;程式碼庫亦提供 Python 3.11 以上的快速開始方式。評分要求模型在兩種選項排列順序下都答對,減低單靠固定選位置取得高分的可能。較貼近方向判斷能力,但題目仍集中於 SWE-bench、SWE-bench Pro,以及 METR 的 MALT 研究軌跡,未必涵蓋所有長任務場景。

14 個前沿模型中,最高平均正確率為 59.7%,仍有約四成題目判斷錯誤;當關鍵證據要到更後段才出現,準確率會由 62.3% 降至 21.0%,增加推理預算亦未能改善結果。研究亦報告,透過事後答案蒸餾訓練的 Qwen3.6-27B,在未見任務上的正確率由 30.0% 升至 47.9%;用它提供建議後,SWE-bench Pro 成功率由 14.6% 升至 33.7%。這些結果顯示評測不只用來比較模型,也提供了改善 Agent 決策的訓練方向。

  • 評測核心:在結果尚未揭曉時,從兩個下一步中選出較佳方向。
  • 題目來源:軟件工程與機器學習研究任務的真實操作軌跡。
  • 主要限制:目前 502 題的領域與任務來源有限,不能代表所有 Agent 工作。
  • 適合對象:研究長任務 Agent、比較模型決策能力,或訓練工具使用策略的團隊。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型訓練, Qwen, 工具, Python, Dataset 數據集

Page 1 of 35
1 2 3 … 35