KBMR 視覺問答檢索帶向實體語義

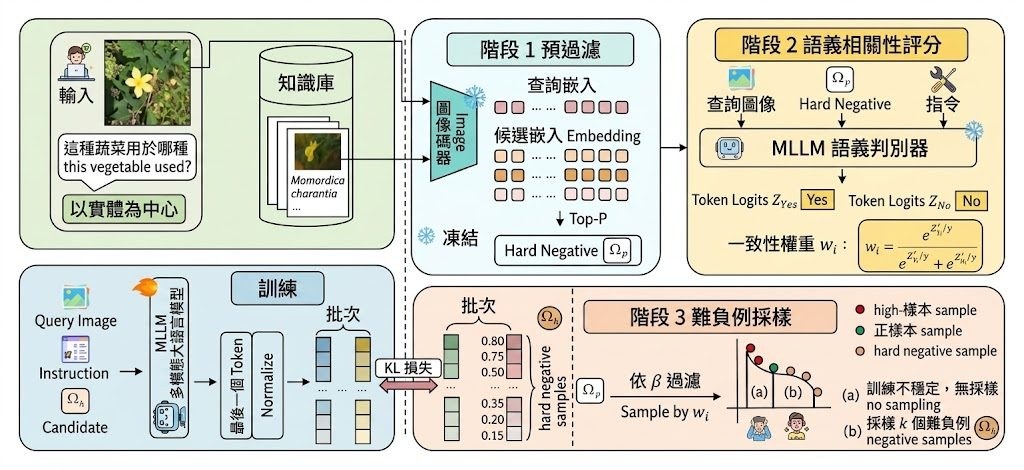
KBMR 針對 KB-VQA 容易搵錯相似圖片的問題,以 MLLM 將檢索焦點由外觀匹配轉向實體語義。

KBMR method overview

面對人物、地點或物件,KB-VQA 若只按圖片外觀搜尋,容易因視角、年代和風格變化搵錯資料。KBMR 屬於面向 Knowledge-Based Visual Question Answering(KB-VQA)的多模態模型檢索器,實際處理的是「畫面相似但實體不同」的證據搜尋問題。

KBMR 先由 EVA-CLIP-8B 篩選候選,再以 MLLM-based Semantic Discriminator 為查詢與候選產生連續的 entity-consistency weights。Qwen2-VL-7B 以這些語義訊號訓練 embedding retriever,並透過 symmetric KL distillation,令 cosine similarity 得出的 retriever posterior 與 discriminator weights 形成的 semantic prior 對齊。

重點整理為:
– 由 surface-level visual matching 改為 entity-aligned semantic retrieval。
– 連續權重可支援較可靠的 hard-negative mining 和 soft supervision。
– 替換原有 first-stage retriever,毋須改動下游 reasoning 或 reranking。
– 不同 KB-VQA pipeline 的端到端答案準確率最高提升 9.4 個百分點。

這種取捨適合已有 KB-VQA、外部知識庫和後續推理流程的研究團隊,因為 KBMR 主打 plug-and-play 替換檢索器,而不是重新設計整條系統。KBMR 列出 Python 3.10+、EVA-CLIP-8B 及 Qwen2-VL-7B 等準備項目,亦包括訓練和評估章節;目前已提供完整安裝指令、模型取得方式及獨立推理流程。
GitHub

Categories: 開源, Qwen, Embedding, Python, 多模態模型, 視覺模型

E-CommerceBench 經營 365 日網店的 Agent 考試

代理人要由十萬元起步,經營最多四間網店並應付供應商、庫存與退貨,最後以全年資產增長分高低。

Mean end-of-year total assets, eighteen models, five 365-day episodes each

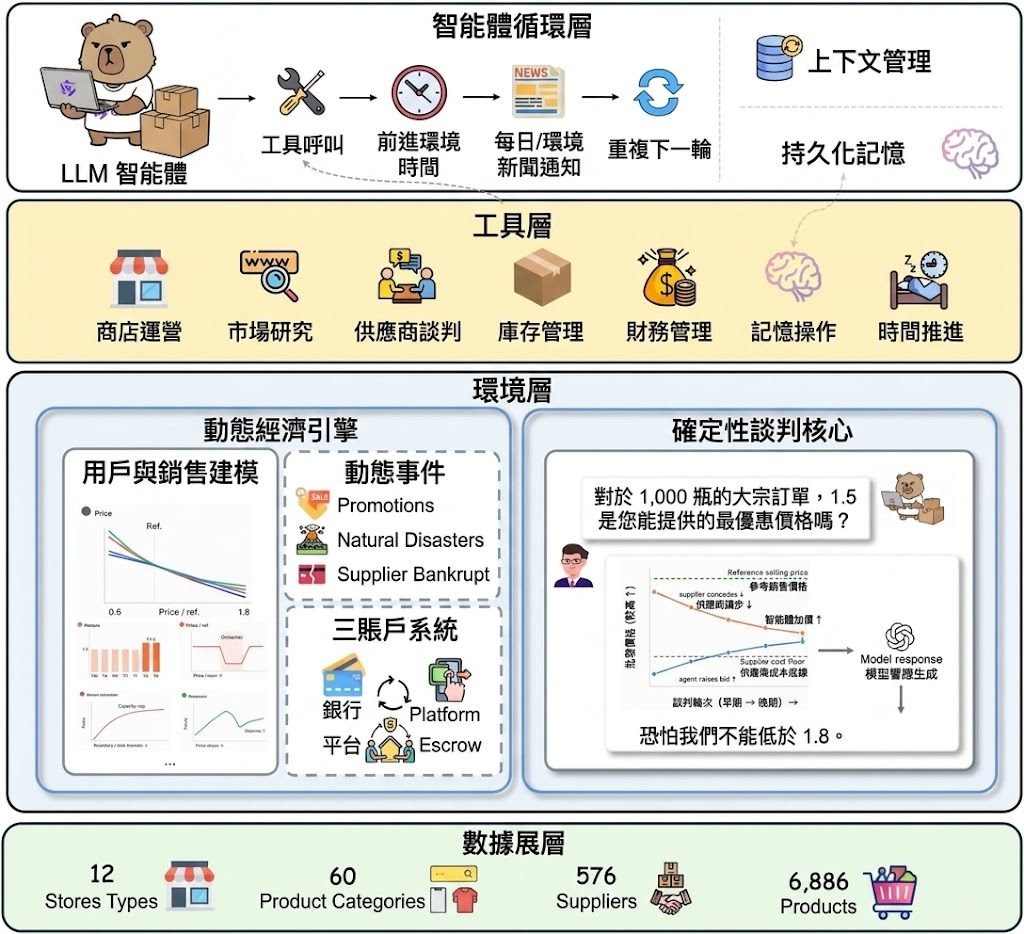
一個代理人由 ¥100,000 起步,連續經營最多四間網店 365 個模擬日,還要自行處理採購、定價、補貨、訂單履行及退貨。E-Commerce Bench 屬於長期自主商業運作的 LLM agent benchmark,實際處理的是代理人能否在現金流、庫存、風險和增長之間持續作出決策。

環境包含 6,886 個產品、60 個類別及 576 家供應商,其中 152 家涉及五種詐騙類型;全年亦有八次促銷和十項市場事件。客戶需求由固定多因素模型決定,供應商價格、讓步及接受與否則由 Deterministic Negotiation Kernel 計算,LLM 只負責把決策呈現成對話,避免抽樣回覆直接改變交易結果。

排行榜以五次獨立 episode 的年終總資產平均值計算 asset multiplier,同時提供標準差、CSE⁺、BadSpend%、回撤、每次工具呼叫帶來的收入、可控退貨比例、AnchorRatio、工具呼叫次數及破產次數等指標。GPT-5.6 Sol(max)平均資產達 ¥1,431,425,約為本金 14.3 倍;最佳 open-weight 模型 Qwen3.8-Max-Preview 為 ¥416,252,約 4.2 倍,18 個模型之間相差 1,264 倍,90 次運行有 10 次破產。

  • 測試場景涵蓋最多約 4,000 個回合,適合研究長期記憶、規劃和工具使用。
  • 固定需求與談判機制令模型差異較容易歸因,但未必代表真實市場的隨機性。
  • 模型排名同時呈現盈利能力、風險控制、浪費開支及資金壓力。
  • 項目資料提到 Python 3.10+,但提供內容沒有列出完整安裝、執行或下載流程。

研究代理人可靠性、商業決策、長期規劃或多步驟工具調用的團隊,會較容易從這套固定世界取得可重複比較的結果;網店經營者則可把它理解成壓力測試,而不是直接預測真實銷售額。它同時比較 proprietary 與 open-weight 模型,但資料未交代各模型的提示詞、工具策略或成本,因此資產排名不應單獨視為整體能力結論。

項目主頁 · GitHub

Categories: 開源, Qwen, Google, Gemini, DeepSeek, OpenAI, Agentic, Python, Anthropic, Dataset 數據集

H3-World 讓鍵盤控制生成影片世界

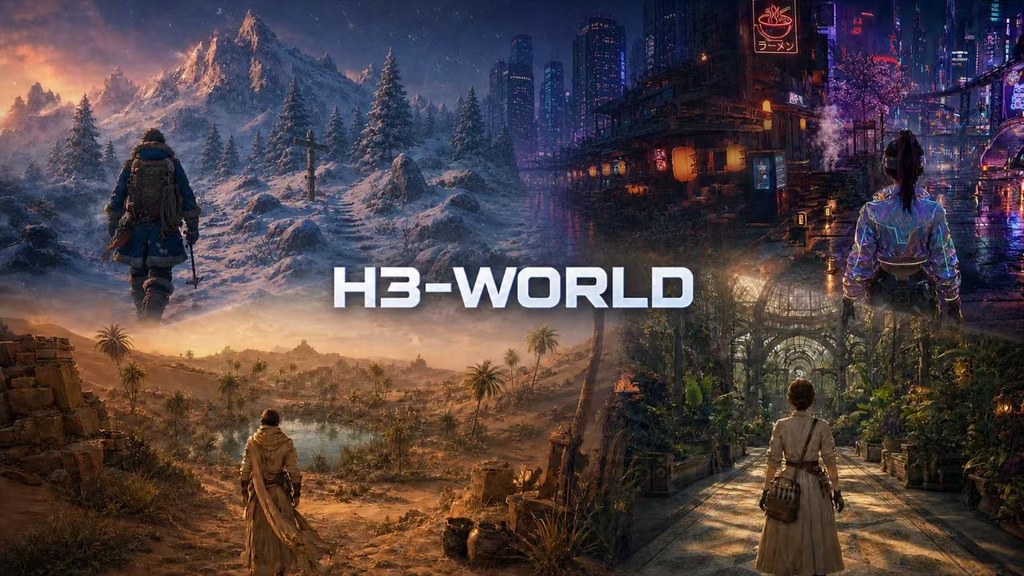
H3-World把鍵盤輸入轉成可控制的未來畫面,展示互動式世界模型由理解指令走向操控環境。

Repository image for Danzer1xxxxChan/H3-World

按下 W、A、S、D 控制角色,或以 I、J、K、L 操控鏡頭,H3-World 便會由初始畫面生成相應的動作影片。這個項目屬於互動式世界模型,實際處理的是角色與鏡頭動作如何連貫地影響後續畫面,適合遊戲代理、視覺模擬及 Computer-use agents(CUAs)相關研究。

H3-World 建基於 MiniMax-H3,將每個鍵盤狀態轉換成對應未來 video latent 的語言指令,再透過 directed attention routing 把指令綁定到相應的 latent 區間。模型以 8,000 段 ABot-World-Explorer-500h gameplay clips 訓練,只學習 65.6M 個 Low-Rank Adaptation(LoRA)參數,約佔 33B backbone 的 0.199%,在保留大型模型能力與控制專用訓練成本之間取得折衷。

目前資料提供的重點包括:
– 角色控制使用 W、A、S、D;鏡頭控制使用 I、J、K、L,F 代表快速鏡頭移動。
– H3-World LoRA 是 MiniMax-H3 的 delta,不能直接套入未修改的 MiniMax-H3 pipeline。
– 推理需要約 135 GB 的 MiniMax-H3 base weights,以及 H3-World 的 directed-attention patch。
– 公開資料沒有列出明確的畫質、延遲或成功率比較,因此未能判斷它在不同世界模型之間的性能差距。

儲存庫提供 Python 3.10、CUDA 12.8、PyTorch 2.10.0 和指定版本 DiffSynth-Studio 的配置要求;模型權重及 LoRA checkpoint 則分別放在 Hugging Face 指定位置,訓練另需 ABot-World-Explorer-500h。研究團隊、遊戲代理開發者及需要可控影片生成的視覺模擬項目較容易受益,但硬件容量、專用 patch 和模型授權條款都是採用前必須核對的條件。

項目主頁 · GitHub · 模型

Categories: 開源, NVIDIA, Agentic, Video, AI productions, Python, 多模態模型, 模型訓練, 視頻模型, MiniMax

ReFlowSET 影像翻譯模型,衛星影像新標準

ReFlowSET瞄準 SAR 影像難讀這個老問題,唔再沿用 latent diffusion model 的天花板。它用高保真 latent 空間配合 flow matching,換來更快取樣同更穩定畫質。

Repository image for KAIST-VICLab/ReFlowSET

落雨、夜晚甚至雲層遮擋時,Synthetic Aperture Radar(SAR)仍然影到地表,但訊號雜訊同幾何外觀都令判讀門檻偏高。ReFlowSET 屬於影像翻譯模型項目,處理的是 SAR-to-EO image translation:把 SAR 影像轉成較接近光學 Earth Observation(EO)影像的表達,方便人看,也方便接到後續視覺流程。

它沒有沿用常見的 latent diffusion model 微調路線,而是保留凍結的 FLUX.2 autoencoder,改用從零開始訓練的 conditional flow-matching transformer。這個選擇直接避開舊方法受限於原有 autoencoder 重建上限的問題,同時把生成放進較高保真的 latent space 內處理;代價是主體模型仍然相當大,DiT 達 509M 參數,訓練門檻不算低。

訓練時,模型會根據 SAR latent 去預測由隨機噪聲走向 EO latent 的線性 flow velocity,並加入 representation alignment,將中途特徵對齊到凍結的 DINOv3 ViT-L/16 teacher。呢個 teacher 同 REPA projector 只在訓練期間使用,推理時會移除,所以正式生成流程比訓練結構簡潔,亦解釋到它點樣兼顧語義對齊同推理效率。

項目在 QXS-SAROPT 與 SAR2Opt 上,團隊把十五種早前方法放到同一 protocol 同 evaluator 之下重訓比較,ReFlowSET 取得兩個資料集最佳 DISTS,並在 SAR2Opt 拿到最佳 FID 與 LPIPS。它亦提供四步取樣設定,速度約比五十步版本快 11 倍,較適合想測試 SAR 轉光學可視化、遙感分析前處理,或研究生成品質與延遲取捨的團隊。

  • 以 frozen FLUX.2 autoencoder 加 conditional flow-matching transformer 重建 SAR-to-EO 流程
  • 用 DINOv3 ViT-L/16 做 representation alignment,但 teacher 不會帶入推理
  • 在 QXS-SAROPT 與 SAR2Opt 拿到最佳 DISTS,SAR2Opt 亦有最佳 FID 與 LPIPS
  • 四步取樣版本大幅縮短生成時間,適合做速度與畫質折衷測試
  • 已公開 PyTorch 實作、論文預印本與預訓練模型,較適合研究型團隊直接驗證

項目主頁 · GitHub · 模型

Categories: 開源, Image, Python, 模型, Dataset 數據集

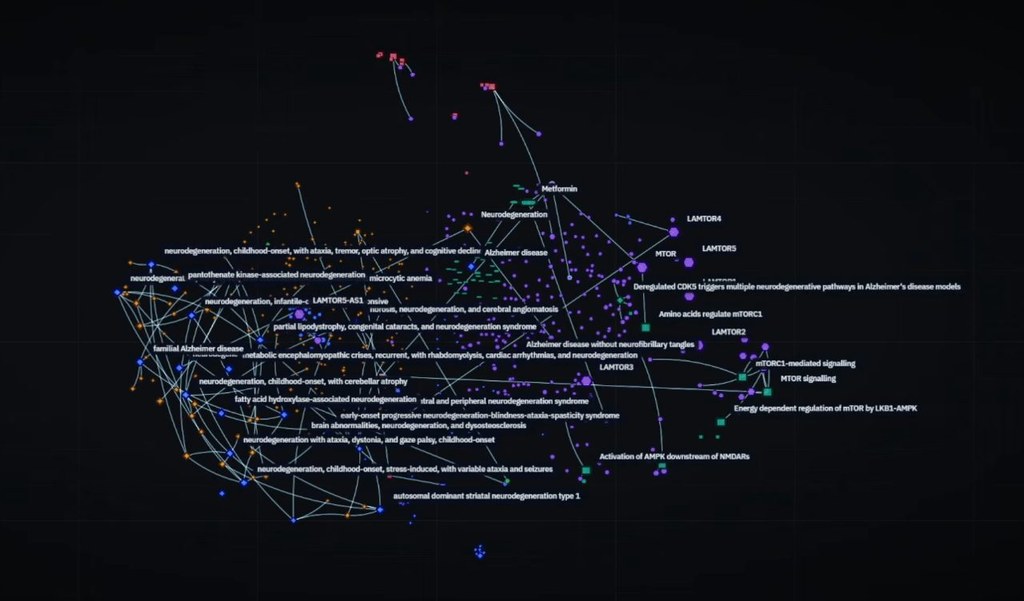
Semantica 用圖譜為 AI 決策加上可追溯證據

Semantica 把分散企業資料整理成 Context Graph 和知識圖譜,再為 AI 決策保留可審計的來龍去脈。對需要解釋原因、追查來源的團隊,這比單靠向量索引更實用。

Semantica

Semantica 是一個開源 Python 庫,做的是把企業資料整理成可查詢的 Context Graph 與 knowledge graph(KG),再把推理、決策與來源脈絡一併留下。它特別適合需要回答「AI 為何這樣判斷」的場景,因為每一步都能追到資料來源與處理過程。

它的做法不是只做檢索,而是先從零散資料抽取實體、關係和衝突資訊,再處理去重、譜系與本體管理,讓圖譜可直接承接 GraphRAG、因果推理和決策分析。官方也提到可自架,並支援 RDF 與 LPG,方便接入既有資料平台。

Semantica Platform Tour | Knowledge Graphs, Reasoning & Decision Intelligence

對 Databricks、Snowflake,或者受監管行業的資料與平台團隊,比把資料送去第三方 SaaS 更貼近實際要求。它不只服務 AI/ML platform teams,也照顧合規、風險和審計需求,因為 provenance 和 lineage 不是事後補寫,而是系統的一部分。

目前文件強調的是可解釋、可追溯與可自託管,並沒有把自己包裝成單純的模型套件。若團隊已經有 LangGraph、CrewAI 或 LlamaIndex,Semantica 比較像補上「上下文治理」與「決策證據」那一層,而不是取代原本的 LLM 流程。

  • 把碎片化資料轉成可查詢的 Context Graph 和 KG
  • 保留決策來源、譜系與審計軌跡
  • 支援 GraphRAG、因果推理與本體管理
  • 可自架,避免資料先送出企業邊界
  • 適合合規、風險與 AI 平台團隊

項目主頁 · GitHub

Categories: 開源, Agentic, KnowledgeGraph, LangGraph, Python,

Breeze TTS 2:低延遲語音生成再推一級

Breeze TTS 2 把即時語音互動、聲線設計同語氣控制放埋一齊,主打低延遲同高可塑性。它較適合要做配音、語音代理或互動內容嘅團隊。

BreezeBlue

Breeze TTS 2 係一個文字轉語音(text-to-speech, TTS)模型,重點唔止係把文字讀出,而係處理即時互動入面最難平衡嘅兩件事:聲音要自然,回應又要夠快。佢支援 Voice Clone、Voice Design 同 Voice Direction,代表可以由參考錄音複製聲線,亦可以純靠自然語言描述去設計新聲線,再按指令調整語氣、節奏同表達。

對內容製作、語音代理、遊戲角色配音同多語言產品來講,呢種做法比單純 TTS 更有彈性。文本內仲可以插入 Vocal Events,例如笑聲、咳嗽、清嗓子呢類表情提示,令生成聲音更接近真人演繹,而唔係只係平鋪直敘讀稿。

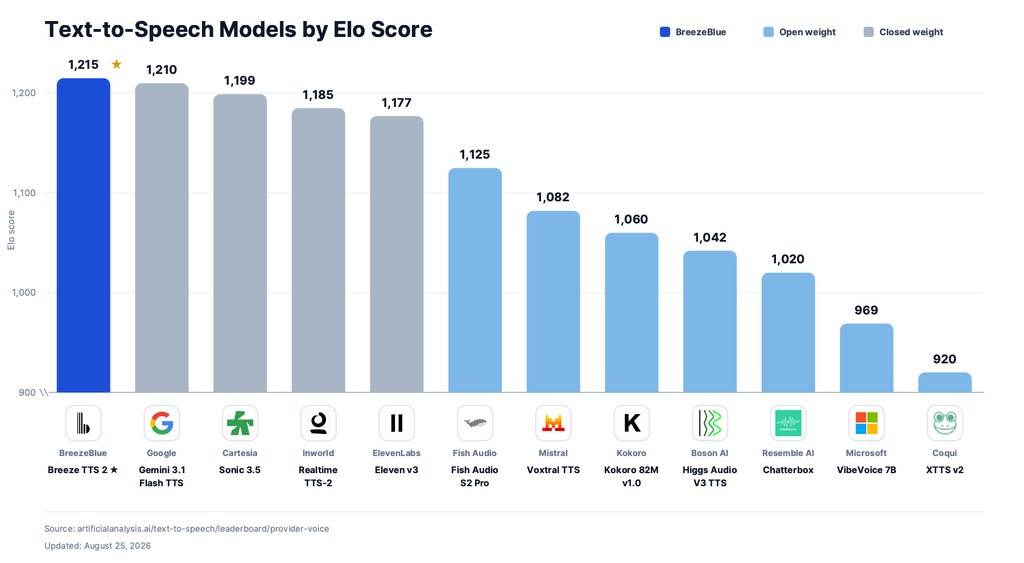
項目資料顯示,佢喺 Artificial Analysis TTS leaderboard 排名第一嘅 open-weight 模型,亦聲稱喺部分測試中超越商業系統。低延遲係另一個賣點:warming 後喺 NVIDIA H100 可做到少於 40 ms 的 time to first audio,RTF 約 0.32,適合即時對話場景。

不過,repo 同時寫明模型權重、衍生模型同 self-hosted outputs 只限研究同非商業用途,呢點對想直接落地嘅團隊影響好大。代碼層面提供 PyTorch inference code,但原始資料未交代完整安裝流程或部署細節,較合理嘅理解方式係先把佢視為一個面向研究與產品原型驗證的高性能 TTS 模型。

  • 支援參考錄音複製聲線,亦支援純文字描述設計新聲線
  • 可以用指令調整語氣、情緒、語速同演繹方式
  • 低延遲串流適合即時語音互動同 voice agent
  • 在 open-weight TTS 基準中聲稱領先,但授權限制較嚴
  • 適合配音、互動內容、多語言語音產品同研究團隊

項目主頁 · GitHub · 模型

Categories: 開源, NVIDIA, 文字轉語音, Agentic, Audio, Clone, Python, 模型, 語音, Dataset 數據集

Ox Alpha 百萬 Token 上下文免費試用

Z.ai 最新模型 Ox Alpha 提供 1M-token context window,讓大型程式碼庫、圖像與影片可在同一個推理流程中處理。

Og image

面對大型程式碼庫、長篇規格文件或連續多步工作,Ox Alpha reasoning model(推理模型)可把最多 1M-token context window 的內容放在同一個脈絡中處理,減少反覆切分資料或遺失前文。它亦支援文字、圖像和影片輸入,適合除錯、重構及分析截圖或介面流程。

Ox Alpha 會先規劃和自我檢查,再產生答案,並以 visible thinking 展示推理過程。模型同時提供原生 tool calling、tool_choice,以及配合 response_format 的結構化 JSON 輸出,方便用於長時間運行的 agentic 工作流程。

網站列出的獨立測試涵蓋 10 項真實編程任務,Ox Alpha 完成 8 項,得分 80%;同一比較中,Fable 為 65%,GLM-5 為 62%,GPT-5 和 Grok 4 均為 52%。樣本只有 10 項任務,結果較適合作為參考,未足以代表所有編程場景。

• 1M-token context window,最高 131K tokens 輸出
• 支援文字、圖像和影片三種輸入
• 適合大型程式碼庫的 debugging 和 refactoring
• 原生 tool calling 與結構化輸出
• 免費試用、毋須登入,網站表示不會把聊天儲存在伺服器

項目主頁

Categories: Agentic, Video, Image, 軟件, Python, 免費試用, 多模態模型, 模型, 編程, UI/UX

VoiceMem 讓語音 AI 記住你的情緒與偏好

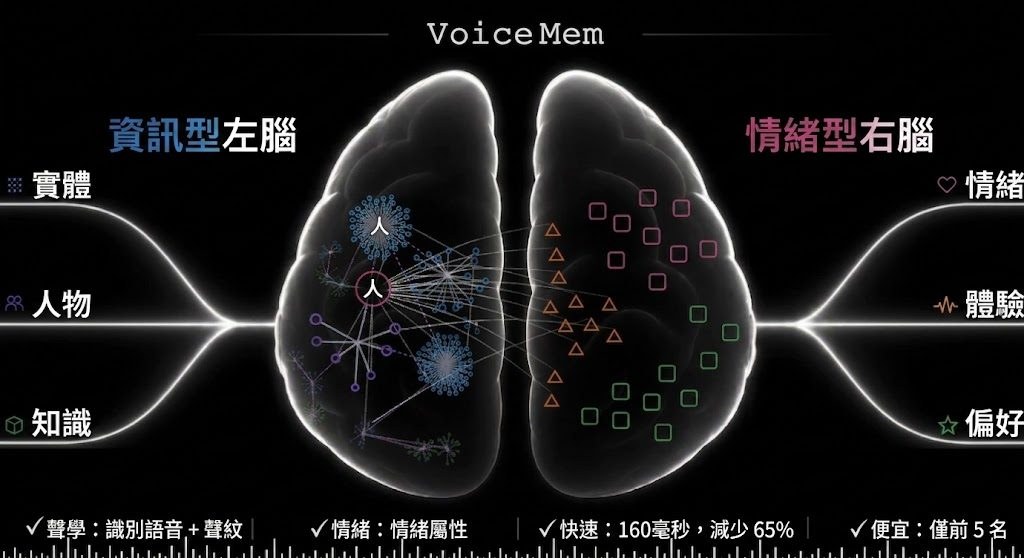
VoiceMem 以流式雙腦架構處理事實記憶、情緒與人格,讓語音智能體在對話中更懂使用者,同時控制延遲與成本。

VoiceMem Logo

語音智能體要記住「我是素食者、對堅果過敏」,並不只是保存轉錄文字,還要分辨人物、情緒、偏好與性格。VoiceMem 屬於語音 AI 記憶引擎及可整合的庫,處理音訊輸入、記憶抽取、檢索和回應前的上下文注入,讓長期個人化對話不必每次重新建立背景。

它採用 VoiceMem Dual-Brain Streaming Architecture(流式雙腦架構):左腦以 schema 與 entity 組織事實記憶,右腦獨立管理情緒、偏好和人格,亦維護跨 entity 的關聯。音訊仍在輸入期間,系統已經分段、轉錄、抽取資料並寫入記憶圖;查詢時先路由及排序,只把 Top-K 記憶放入上下文,減少語音回應需要處理的內容。

  • 左腦在 Top-3 限制下維持 Mem0 的滿載性能
  • 右腦加入長短期情緒歸因及交叉節點
  • 透過壓縮資訊、分層儲存和流式查詢降低等待時間
  • 單輪查詢約需 300 token,架構及底層記憶引擎可替換

VoiceMem 內置 ASR(Automatic Speech Recognition)、聲紋、場景、情緒感知及本地 embedding 元件,亦提供離線記憶引擎和 streaming interface。倉庫資訊包含 Python 庫、互動式網頁 demo、VoiceMem_Default_Models_Env 模型環境,以及可選的 Qwen 回應模型;但完整硬件要求、服務依賴和模型授權仍需按連結內容逐項確認,不能單靠 README 推斷。

ChatMem-400K 以記憶世界構建、SLM 驗證的 online on-policy distillation 和人工修訂三階段製作,配合 VoiceMem Model Families 的 Qwen3 6 35B A3B Qlora 模型系列。這令項目較適合需要長期語音陪伴、個人助理、客服或具情緒連續性的 voice agent 團隊;對只需短對話轉錄的工作流,雙腦記憶層會增加整合和維護成本。

項目主頁 · GitHub · 模型

Categories: 開源, Qwen, 香港中文大學, Agentic, Embedding, Python, 多模態模型, , 語音, 清華大學

AutoSaddler 重新整理 LLM Agent Harness

AutoSaddler 會從執行失敗紀錄入手,幫 LLM agent 自動調整提示詞、工具同中介層。它唔只修一條路徑,仲會檢查改動能否推廣到其他情境。

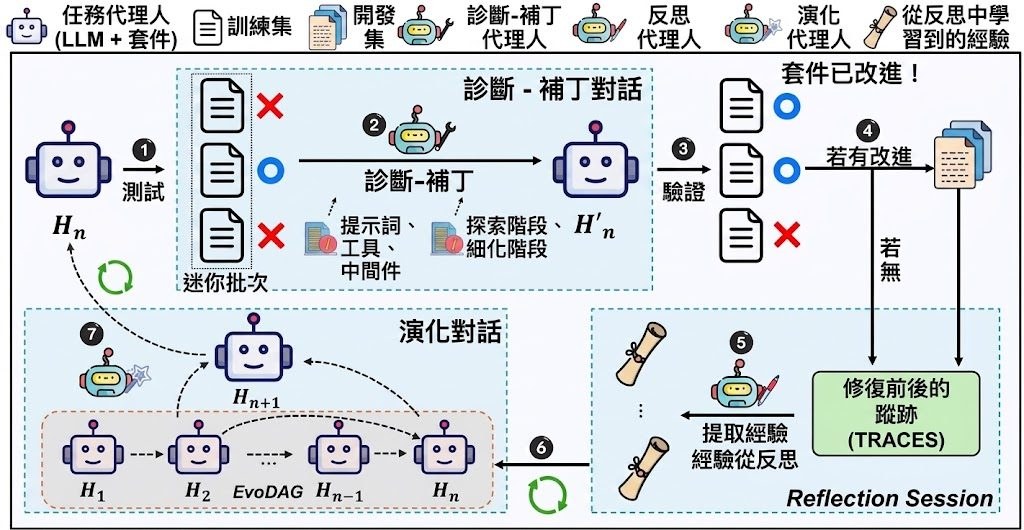
AutoSaddler Overall Framework

Microsoft 研究團隊聯同 POSTECH、KAIST 及南方科技大學開發 AutoSaddler,針對長流程 AI Agent 容易因小錯誤累積而失敗的問題,建立自動優化 harness 的方法。

AutoSaddler 係一個用嚟自動優化 LLM agent harness 嘅開源項目,處理嘅係長流程任務入面,agent 因為提示詞、工具或控制邏輯有少少偏差,就一路累積錯誤而失敗呢個問題。佢唔係單靠反覆改 prompt,而係將 harness 當成程式去診斷同修補。

佢會分析執行 trace,找出失敗根源,再按既定補丁分類去改 prompts、tools、middleware 同 agent-loop logic。資料夾同 佢用 durable、plugin-based 方式記錄狀態,適合要反覆試驗、回復同追蹤修改歷程嘅工作流。

同類方法通常只改少量提示詞,AutoSaddler 就將搜索範圍擴大到整個 harness,仲會用 validation 去挑選較能泛化嘅更新。初步結果顯示,佢喺 GAIA2、SWE-Bench Pro 同 Terminal-Bench 2.0 都帶來約 9 到 10 個百分點嘅 Pass@1 提升。

對做 agent 系統、評測框架或者自動化工作流嘅團隊特別有用,因為佢處理唔係單一模型輸出,而係整套執行環境點樣更穩定。項目要求 Python 3.12-3.14、uv 同 Git,官方建議用 uv run 去執行 Python 指令,代表佢偏向可重現同可追蹤嘅研究與工程整合。

  • 以 failure trace 診斷問題,唔係淨係做表面反思
  • 改動範圍包括 prompt、工具、middleware 同 agent loop
  • 會驗證更新喺其他情境可唔可以保持效果
  • 初步 benchmark 結果顯示有明顯提升
  • 適合要持續調整 LLM agent harness 嘅團隊

項目主頁 · GitHub

Categories: 開源, 微軟, Agentic, 工具, Python, 框架, Dataset 數據集

AutoResearch:AI 研究由構思變成可審查證據

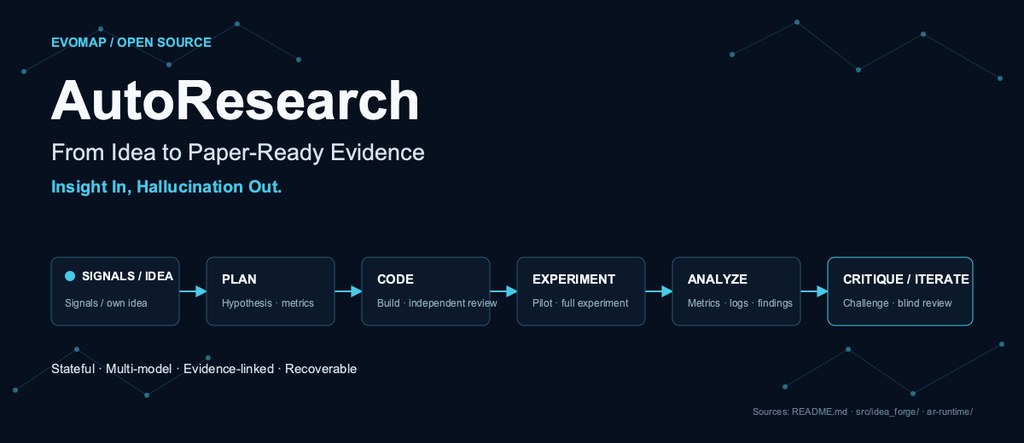
由研究方向發掘、實驗執行到獨立評估,AutoResearch 將一連串研究工作串成可追蹤流程。

AutoResearch workflow from a research idea to reviewable evidence

研究者只需提供一個想法,或者讓系統從近期論文、開發者社群及開源趨勢尋找方向,便可把研究構思推進至實驗計劃、程式碼、結果分析和獨立評估。AutoResearch 屬於開源的 AI and machine learning agent workflow,處理的是研究流程分散、難以重現,以及結果未有足夠證據支撐的問題。

流程不止於叫模型產生一份研究計劃。它會整理、去重和篩選網上訊號,再結合 knowledge base/ 內由使用者維護的研究經驗、限制和常見失敗模式,產生候選方向,經過 cross-review 後制定實驗計劃。已有研究想法的團隊亦可以略過發掘階段,直接執行指定項目。

研究計劃、程式碼、run logs、metrics、失敗原因、critic reports 和 blind reviews 都會寫入磁碟,流程亦具備 stateful、recoverable 特性,方便研究者檢查中途結果、接手工作或停止執行。這比一次過要求模型寫完整論文更適合需要反覆試驗的研究項目,但成果質素仍取決於模型、API、資料來源和實驗環境,不能把自動產出的證據視為已完成同行審查。

  • 從近期論文、社群討論及開源趨勢收集研究訊號
  • 以本地 knowledge base/ 補充領域經驗和限制條件
  • 支援由 idea generation.py 啟動構思、篩選及結果更新
  • 透過 config/providers.local.json 配置 endpoint、model alias 和角色模型
  • Python 3.10+,並要求把含 API URLs、keys 和 proxies 的 .env 留在本機

對個人研究者、小型 AI 團隊及需要大量驗證想法的實驗室,AutoResearch 可減少整理資料、安排實驗和記錄結果的重複工作。它更像一個可接管的研究協作流程,而不是單一模型;要測試完整能力,應先準備本地知識庫和模型供應商設定,再由一個小型研究方向開始,檢查生成計劃、執行記錄及獨立評估是否足以支持後續寫作。

GitHub

Categories: 開源, Agentic, API, Python, 框架

Page 1 of 12
1 2 3 12