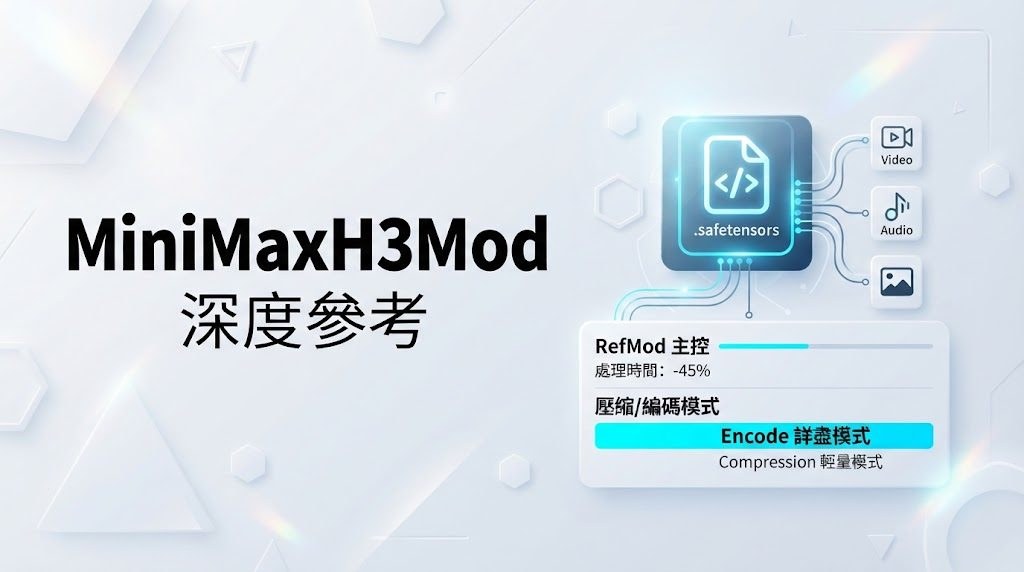
ComfyUI-MiniMaxH3Mod:可重用參考模組

你可以把它理解成 MiniMax H3 的參考素材管理層,把圖像、影片和聲音整理成可重用的 RefMod。

ko-fi

想在 ComfyUI 的 MiniMax H3 工作流中重用同一組人物、場景或聲音參考,不必每次重新編碼原素材。ComfyUI-MiniMaxH3Mod 是一個開源 custom node 項目,處理 RefMod 的建立、儲存、載入、組合及套用,讓圖像、影片和音訊參考可以保存成 .safetensors,再交給 Apply H3 RefMod 使用。它不會訓練 H3 權重,也不是 LoRA 或監督式概念學習工具,而是接入 H3 原生 reference-token 路徑的儲存與選擇層。

使用時需要將項目放入 custom_nodes 後重新啟動,並把標準 H3 video VAE、audio VAE 及原生 CONDITIONING 接到相應節點。項目已提供 Create H3 RefMod、Create H3 RefMod Master、Load H3 RefMods、Apply H3 RefMod 等節點;Master 可以一次處理視覺和音訊,save=False 則可只產生記憶體中的 bundle,不寫入檔案。ComfyUI Manager 可處理 safetensors、numpy 和 Pillow 等 Python 依賴,影片資料夾載入則可按需要加入 opencv-python 或 imageio。

  • 支援圖像、影片、音訊 RefMod,並可在同一個 .safetensors bundle 儲存視覺與聲音。
  • encode 保留較多細節但消耗更多 reference tokens;training 先壓縮 latent,降低 token 成本,亦可能損失細節和動態。
  • Collect H3 RefMod Masks 可處理不同尺寸的 MASK,並按對應參考素材保留尺寸;上游裁走的像素則無法恢復。
  • Full Reference video sampling 會先決定因果 frame 數,避免 16 等限制直接截掉影片尾段。
  • Loader 和 Axis 採用按需增加的參考槽位,並可分開選擇 All、Visual 或 Audio。

它和單純把素材放在工作流內的做法不同,RefMod 會把編碼結果保存下來,之後重用時可避免重複處理來源檔案。壓縮模式適合控制 token 和生成成本,完整 encode 則較適合作為身份或細節比較的基線;兩者都不能保證只轉移指定屬性,身份、服裝、背景和構圖仍可能互相混合。項目支援最多八個參考槽位、子資料夾、外置磁碟及 extra_model_paths.yaml 登記的 RefMod 根目錄,Library 和 Config 亦能搜尋及檢視已保存內容。

可調整的 max_tokens、frame limit、視覺 budget policy 和 Refinement Steps,令項目較適合需要反覆測試參考組合的創作者、ComfyUI 工作流作者,以及要管理大量人物或場景素材的團隊。truncate 會削減畫面內容以符合 token 預算,error 則在超出預算時停止保存;這些選擇直接影響細節保留和工作流是否繼續。項目目前沒有提供可與原生完整 reference workflow 對齊的正式基準測試,Windows 是原先測試環境,Apple Silicon 只覆蓋部分預處理和 H3 VAE 檢查。

音訊支援仍是最大限制。項目可以保存及混合視覺、音訊參考,亦曾成功處理音樂參考,但目前測試未能完成 speaker-identity transfer,因此不能當作已驗證的 voice cloning 解決方案;它亦不會自動修正影音同步。API 和 node schema 仍在演變,節點名稱及輸入欄位可能隨版本調整,適合接受工作流需要維護、並願意自行測試參考強度與 token 取捨的使用者。
GitHub

Categories: 開源, ComfyUI, AI productions, 模型訓練, API, Video, Image, 影像處理, Audio, 工具, Content Creator, Clone, 庫, 語音, 音樂, 蘋果, MiniMax, LoRA

OmniTaskonomy:令圖片生成圖片更準確

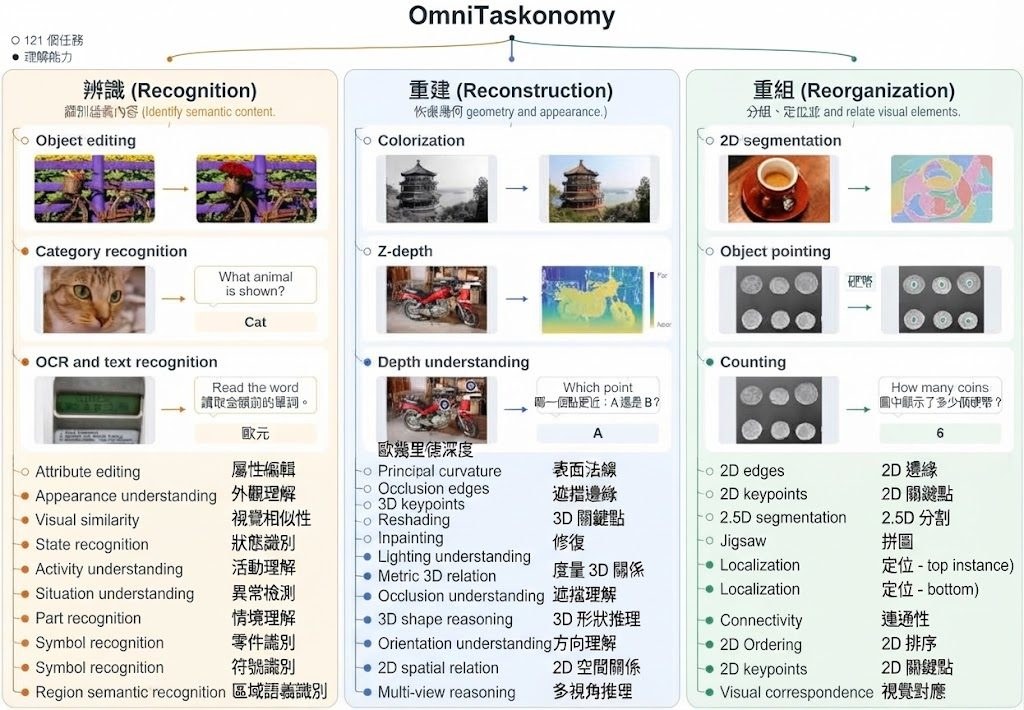
OmniTaskonomy 以配對實驗檢驗 I2I 訓練能否改善 I2T 理解,並找出最有效的訓練次序與任務轉移關係。

I2I reconstructs the Jigsaw image, a dot moves from Visual Generation to Visual Understanding while changing color, and

同一個多模態模型既要生成圖片,又要讀懂圖片,兩種能力未必會自然互相提升。OmniTaskonomy 是一個研究型 benchmark 與資料集項目,透過 Image-to-Image(I2I)和 Image-to-Text(I2T)配對任務,測試視覺生成訓練何時能改善視覺理解。

項目沒有把生成與理解混成單一分數,而是比較六種訓練流程,包括只做 I2T、先做 I2I 再做 I2T(I2I → I2T),以及從一開始混合兩種目標。結果顯示,先以 I2I 更新與理解能力共用的權重,再進行 I2T 微調,通常比同步訓練或凍結共用權重更穩定;I2I 資料增加時,I2I → I2T 和 I2I → Mixed 的收益亦持續上升。

從 GitHub 儲存庫了解實驗流程,並配合 Hugging Face 上的 OmniTaskonomy 資料集重現配對任務。項目適合研究多模態模型訓練、視覺能力轉移及 curriculum learning 的團隊,但並非即裝即用的影像工具,重現結果仍要配合模型、訓練資源和原有設定。

幾個結果有助判斷它的研究價值:
– 定位與物件指向對 counting 的增益最大。
– 深度及 surface-normal prediction 可改善 metric 3D relation。
– 各種理解能力的 mean alignment 與 mean transfer 相關係數為 r = 0.795。
– 133 個 source–target pair 的相關係數降至 r = 0.529,反映任務之間的轉移並不一致。

Gradient alignment 主要集中在早期 pre-attention normalization layers,並與下游 transfer 呈正向關係。這讓 OmniTaskonomy 不只回答「生成能否幫助理解」,亦提供一套分析哪些生成任務值得加入訓練、哪些能力不應直接互相推論的方法。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, Image, 工具, 庫, Dataset 數據集

WorldPlay2 即時控制互動世界模型

WorldPlay2嘗試令世界模型在多樣場景中持續演化,同時保留即時反應與細緻控制,代價是系統仍未準備好供外部重現。

Repository image for WorldPlay2/WorldPlay2

想令場景隨鏡頭、角色動作和語意事件持續發展,世界模型往往要在即時反應、控制彈性與長時段一致性之間取捨。WorldPlay2 屬於互動世界模型,處理的正是這個矛盾:它可以跨越不同場景與角色生成連貫內容,並回應多種控制訊號。

模型把控制拆成兩層:一層是與影格對齊的連續動作,例如相機俯仰;另一層是結構化語意控制,分開處理場景外觀、角色身份和動態語意事件。這樣做比只依賴單一動作介面更容易表達複合指令,但亦令控制學習和資料整理更複雜。

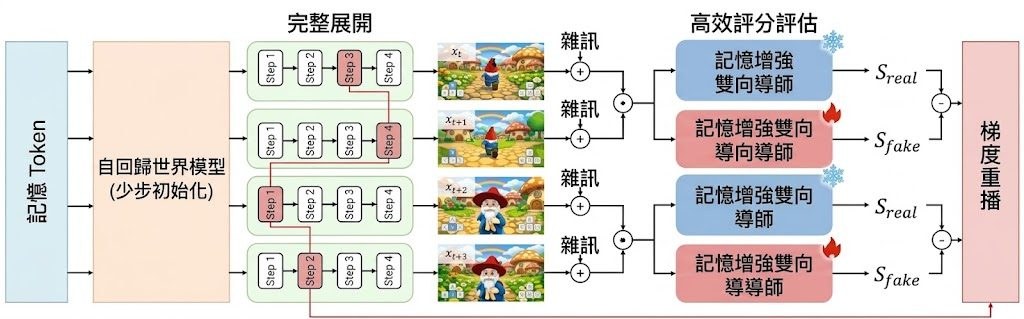
長時段生成由壓縮記憶和 Stable Forcing 支撐。歷史影格會被壓成緊湊的 memory tokens,供自回歸 student 與雙向 teacher 共用,蒸餾時改以分片、受記憶條件約束的分數評估,避免每次都處理整段 rollout;Stable Forcing 則先以少步策略初始化 student,再透過完整 rollout replay 維持長序列品質。

  • 可跨多樣場景與角色保持較長時間的一致性
  • 同時支援影格對齊動作與結構化語意控制
  • 以壓縮記憶降低長時段蒸餾開銷
  • 實驗聲稱整體表現優於既有方法,但未提供可核對的詳細指標

研究者、互動遊戲原型團隊和需要可控視頻生成的開發者較容易從中受益,尤其適合研究鏡頭控制、角色持續性及長期世界演化。儲存庫仍在整理程式碼與權重,README 沒有提供安裝、下載或測試流程,現階段較適合先觀看展示影片和研究方法;正式重現仍要等待相關檔案公開。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, Video, 庫

LightMIS 以輕量化架構推進醫學影像分割

LightMIS以精簡多尺度編碼器取代傳統逐階解碼器,嘗試在減少模型參數與運算量的同時,維持醫學影像分割表現。

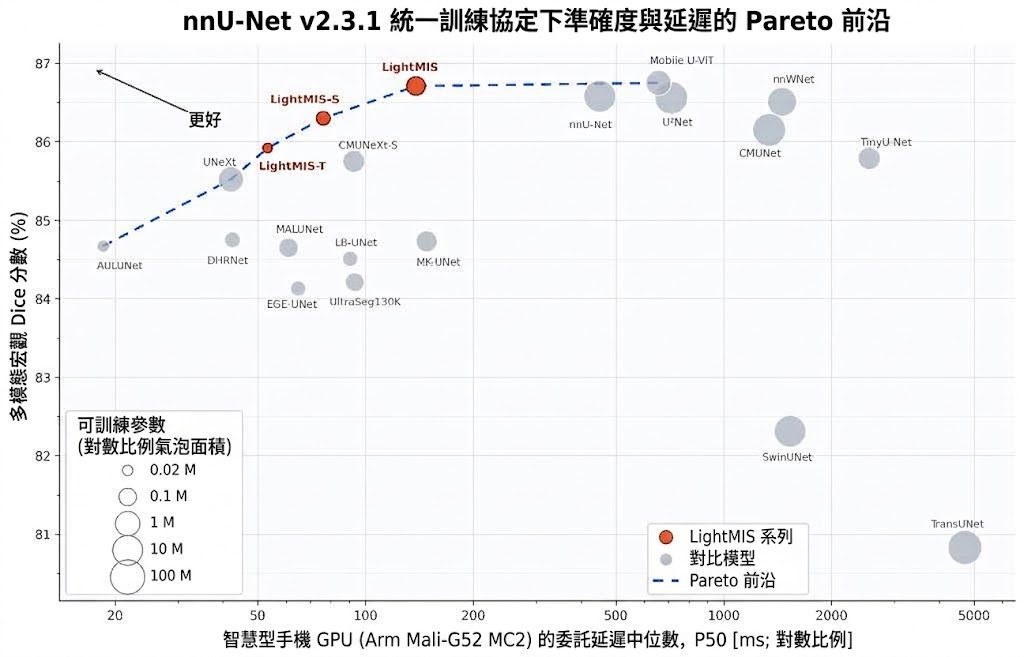
LightMIS accuracy–latency Pareto front

在手機 GPU 上執行醫學影像分割,模型大小與處理速度都會影響部署選擇。LightMIS 是一款面向 2D 二元醫學影像分割的輕量模型,透過精簡多尺度編碼器和聚合式輸出頭,減少傳統逐階解碼器帶來的重複上採樣及特徵融合運算。

模型在每個空間尺度使用 Adaptive Fusion Cascade(AFC)處理特徵;其中的 Progressive Receptive Fusion(PRF)會暫時擴展通道,配合不同深度卷積感受野及分支間逐步傳遞資訊,補足窄通道特徵的表達能力。編碼器各層輸出再由 Scale-Aligned Projection(SAP)對齊至相同解析度與通道寬度,融合後交由最後一個 AFC refinement,毋須沿用逐層上採樣的解碼結構。

在 nnU-Net v2.3.1 的共同測試流程下,研究以六個資料集、五個影像領域及五折交叉驗證評估模型。LightMIS 的區域重疊指標與明顯更大的 Mobile U-ViT、nnWNet 和 nnU-Net 接近,邊界距離結果亦具競爭力;參數量少 90.58% 至 99.61%,GFLOPs 少 82.54% 至 96.14%。

在配備 Arm Mali-G52 MC2 GPU 的手機上,各版本都達到 100% GPU 算子覆蓋率;LightMIS-T 的委派中位延遲為 53.31 毫秒,LightMIS 為 138.31 毫秒。這些結果適合參考於需要控制模型體積、運算量或手機端推理的研究與開發工作,但不代表所有裝置和醫療場景都會有相同速度或準確度。

要重現測試,需配置 nnU-Net v2.3.1,將 DRIVE、Kvasir-SEG、DSB18、BUSI、ISIC-2017 或 ISIC-2018 等資料集轉成 nnU-Net 格式,再執行 2D 規劃、預處理及五折訓練。儲存庫提供資料轉換腳本和訓練器檔案;文章草稿所據內容未包含完整命令及硬件部署流程,不能據此推斷安裝後即可直接在手機執行。

  • 適用任務: 2D 二元醫學影像分割。
  • 核心做法: AFC 與 PRF強化多尺度特徵,SAP 對齊並聚合編碼器輸出。
  • 主要取捨: 減少參數量與 GFLOPs,並省去傳統逐階解碼器。
  • 評估範圍: 六個資料集、五個影像領域,採用五折交叉驗證。
  • 部署參考: 手機 Arm Mali-G52 MC2 上各版本達到完整 GPU 算子覆蓋,但延遲因版本而異。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, Image, Medical醫學, 庫

tactile:讓電子皮膚學懂接觸位置的拓撲感知模型

Tactile-JEPA 把分散式觸覺感測器的連接關係納入預訓練,令同一套表徵可支援力量、姿態及動作判斷。

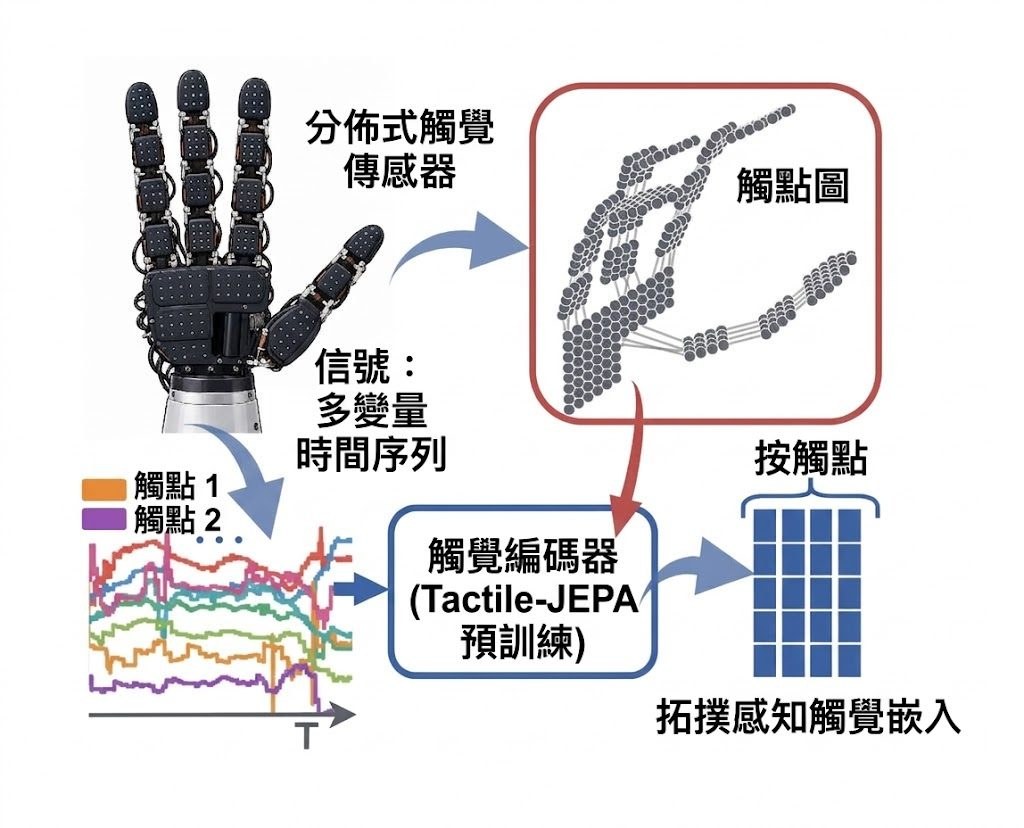
Tactile-JEPA maps distributed tactile signals to topology-aware per-taxel embeddings using the taxel graph during pretra

電子皮膚面對的難題,不只是讀取感測數值,而是要理解哪些 taxel 彼此相鄰、接觸訊號如何在感測表面分布。Tactile-JEPA 屬於觸覺表徵學習模型,透過感測器拓撲預測被遮蔽的 taxel embedding,將原本分散的時間序列轉成可供下游任務重用的表示。

它沒有把感測面硬套成規則影像網格,而是沿着 sensor connectivity graph 抽取局部及全局遮罩;預設組合包含兩個 local masks 和兩個 global masks,兼顧局部接觸細節與整個表面的狀態。模型由 context encoder、exponential-moving-average (EMA) target encoder 和 predictor 組成,predictor 預測隱藏 embedding,再以 mean squared error 對齊 target encoder 輸出;預訓練完成後,凍結的 target encoder 可配合 task-specific heads 使用,而下游編碼不再需要圖結構。

項目涵蓋 Xela magnetic hand skins、piezoresistive tactile socks,以及雙手 DECO-50 等不同感測器形態,支援 force estimation、in-hand 及 full-body pose estimation、object/action classification 和 visuo-tactile policy learning。首頁報告指,模型相對各任務最強基線,in-hand orientation error 減少 20.8%,force estimation error 減少 6.3%,但預訓練模型及論文連結仍標示為 TBD,結果重現程度要視乎後續資源是否補齊。

測試需要 Linux、Conda 及具 CUDA-compatible driver 的 NVIDIA GPU,並由儲存庫建立環境、以 editable package 方式安裝。三個資料集合共涉及數百個 taxels,下載及整理成本不低,較適合研究觸覺感知、機械人操作或 visuo-tactile learning 的團隊;只需要單一感測器分類器的工作,未必能抵銷圖結構整理及 GPU 預訓練成本。

  • 以拓撲遮罩取代影像式規則遮罩,貼近不規則電子皮膚的實際排列。
  • Local 與 global targets 同時捕捉接觸細節及整體感測狀態。
  • 預訓練 encoder 可服務力量、姿態、物件及動作等多種下游任務。
  • 圖結構只參與預訓練,之後的編碼流程較容易接入不同任務。

項目主頁 · GitHub · 模型

Categories: 開源, Embedding, 模型, 模型訓練, Robotic, 庫, Dataset 數據集

morphometric:人手示範跨越機械手形態,直接訓練視覺操控策略

同一段人手操作示範,能否教會不同機械手抓握物件?Morphometric Imitation 嘗試保留接觸動作,再把示範轉成可在真實機械手執行的策略。

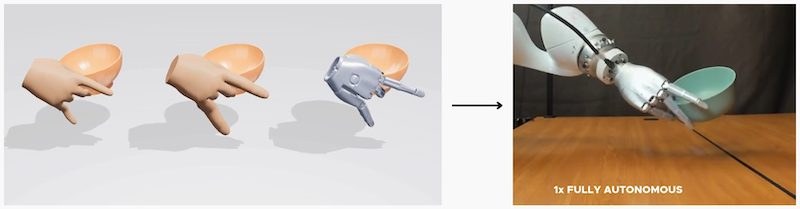
mmi teaser

讓不同機械手學習同一段人手抓握示範,難處不只是手指形狀不同,還要確保動作符合物理條件。Morphometric Imitation 是一套三階段機械人模仿學習框架,把重建的人手與物件互動(hand-object interactions,HOIs)轉成視覺運動控制策略,目標是毋須在真實環境再訓練便能執行。

框架先以形態優化(morphometric optimization,MMO)調整人手動作,盡量保留手指與物件的接觸位置;再用殘差強化學習(residual reinforcement learning,RL),結合示範中的物件姿態及接觸資訊,修正機械手未必做得到的動作。最後,系統把修正後的示範轉成依靠視覺輸入操作的策略,而非直接照搬人手軌跡。

Morphometric Imitation

在三款機械手、十種互動的測試中,MMO 的接觸 F1 分數在每款手上,都比五種比較方法中表現最好的一種至少高 8 個百分點;後續動態動作轉換的成功率最多提高 35 個百分點。不過,這些結果不能直接推算到其他機械手或未測試的物件。

  • 適合研究如何把人手示範轉移至多指機械手的團隊。
  • 核心取捨是增加動作修正步驟,換取可執行性及接觸保真度。
  • 物件姿態與接觸資訊各自有助於殘差 RL;消融測試顯示兩者作用互補。
  • 儲存庫目前表示程式碼稍後公開,未提供安裝或重現測試步驟。

項目網站提供影片和研究資料,可先用來了解示範涵蓋的物件與機械手動作。程式碼尚未釋出,現時無法按儲存庫自行部署或核對訓練流程。

項目主頁 · GitHub

Categories: 開源, 模型訓練, Robotic, 框架, 庫, 深度學習

Qwen-Image 2.1 四步生成加速,但複雜編輯仍未完善

Viggle 將 Qwen-Image 2.1 蒸餾至四步生成,換來速度提升,同時保留編輯能力上的取捨。

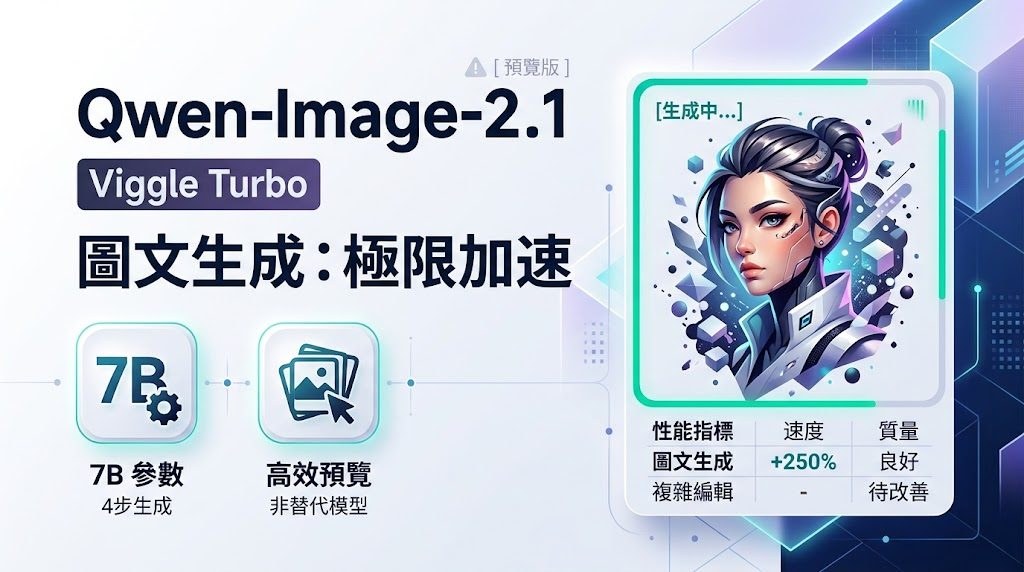
Og image

面對需要較快出圖、又要按文字指示修改圖片的場景,Qwen-Image-2.1-viggle-turbo 把原始 Qwen/Qwen-Image-2.1 由 40 次 Transformer passes 壓縮至 4 次,支援 text-to-image 及 image-to-image 編輯,亦可配合 1 至 3 張參考圖。模型屬於基於 Qwen/Qwen-Image-2.1 的 adapter 項目,由 Viggle 使用 Distribution Matching Distillation(DMD)訓練,並取消 classifier-free guidance。

項目提供兩個學生模型,取捨集中在下載體積與編輯精準度:

  • transformer/:完整微調的 bf16 Transformer,約 14.2 GB,會取代基礎 Transformer;頁面目前推薦這個版本,質性比較中編輯更忠實。
  • Qwen-Image-2.1-viggle-turbo-4step-lora-r64.safetensors:rank 64、約 340 MB 的 LoRA adapter,載入基礎 Transformer 後運行,下載較快但效果稍弱。
  • peft/:同一 LoRA 的 PEFT key format、F32 權重;LoRA 不會合併入 Transformer,運行時載入可避免 bf16 合併造成的損失。
  • text encoder、VAE 及 processor 沒有隨項目重新發布,會從基礎模型儲存庫載入。

完整微調版本的 DMD objective 加入 low-frequency teacher anchor,兩個版本都是各自訓練流程的 step-400 EMA checkpoint。Text-to-image 在四步下已具可用性,但 v0.1 仍是 preview;多參考圖合成、換臉、保留身份,以及同時包含多項限制的指令,明顯不及原本 40 步的 base model,因此不能視為完整替代品。

因為 QwenImage21Pipeline 尚未納入已發布的 diffusers;同時要安裝 peft、PyTorch、Transformers、Accelerate、Safetensors 及 Pillow。提供內容沒有 GGUF 檔案、GGUF 檔案大小、量化級別、mmproj、上下文長度、Ollama、LM Studio 或 llama.cpp 支援資料,亦沒有 MTP draft speculation 或正式 benchmark 數字;硬件需求只能按完整 Transformer 約 14.2 GB bf16 權重另行規劃。

模型

Categories: Qwen, Image, 影像模型, 影像處理, txt2img, Python, 庫, Dataset 數據集, LoRA

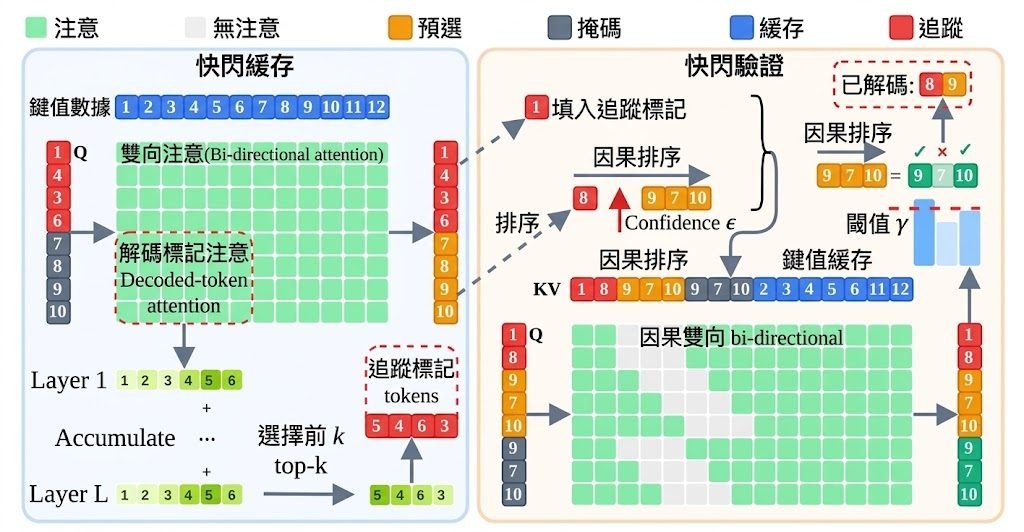
Flash-dLLM 讓擴散式語言模型解碼更快、更省記憶體

Flash-dLLM 把 KV-cache 管理和並行解碼放在同一套推理框架處理,減少擴散式語言模型反覆搬移資料造成的速度損失。

Flash-dLLM overview: Flash-Cache selectively refreshes tracked tokens, while Flash-Verify checks draft predictions using

擴散式語言模型每輪去噪都可能同時產生多個 token,但反覆更新 KV-cache 會令 GPU 花大量時間讀寫資料。Flash-dLLM 屬於免訓練推理加速框架,針對這個記憶體瓶頸提升解碼速度,亦保留可調校的準確度與吞吐量取捨。

Flash-Cache 以融合式 Triton kernel 一次處理 QKV projection、rotary positional embedding(RoPE)及 cache writes,並透過 block-scheduled attention 支援批次內不同查詢長度。它只刷新新解碼 token 及按 attention importance 選出的少量關鍵位置,避免每輪重算全部內容。

Flash-Verify 再利用同一個 diffusion model 同時擔任 drafter 和 verifier,毋須額外模型或訓練;draft token 與 [MASK] token 會透過兩種視圖驗證,符合信心門檻的預測可一併接受。

• LLaDA-1.5 測得 148–211 tokens/s
• 比無 caching 的 greedy decoding 快 22.3 至 148.2 倍
• GSM8K 和 HumanEval 比 Elastic-Cache 快 5.1 倍及 11.0 倍
• GPU 記憶體約比 Fast-dLLM 少 48%,可擴展至 batch size 32

這個項目適合研究 diffusion LLM 推理、GPU kernel 或高吞吐量服務的團隊。使用前需按儲存庫提供的環境及模型設定進行安裝和 evaluation;結果會受 GPU、批次大小、信心門檻及模型支援程度影響,數字未必能直接套用到其他 dLLM。

項目主頁 · GitHub

Categories: 開源, Embedding, 模型訓練, 框架, 庫

Grounded-Action-Model:讓機械人先理解物件位置,再決定如何動作

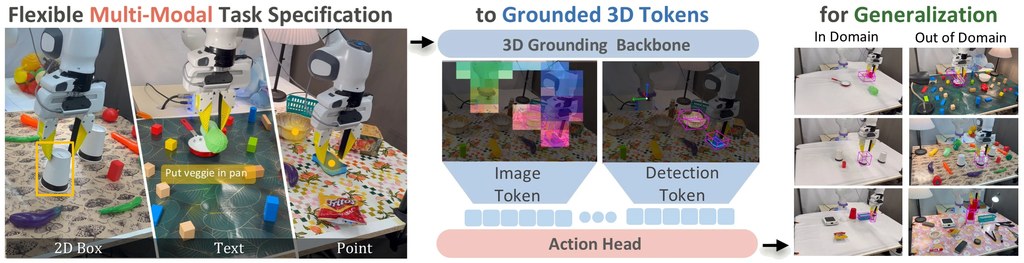
Grounded Action Model 把語言、點和框選提示轉成同一套 3D 物件表示,提升機械臂面對場景變化時的穩定性。

A language instruction, a 2D point or a 2D box is resolved by a pretrained 3D grounding model into image tokens and dete

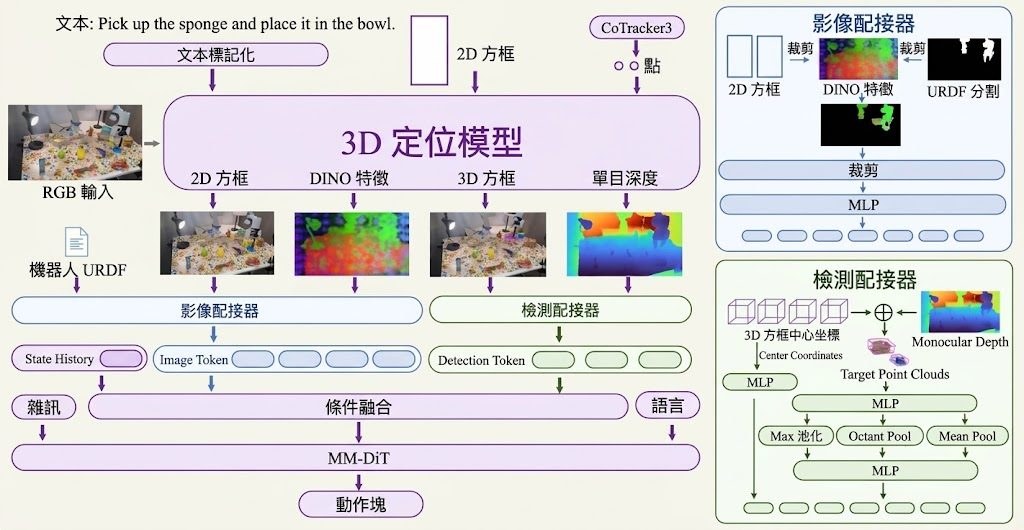
面對物件被移位、場景重新排列,機械臂未必只需要更長的指令,而是要準確知道目標在哪裏。Grounded Action Model(GAM)屬於機械人基礎模型,透過 3D grounding 將語言、2D 點或 2D 框選轉成同一套以物件為中心的觀察,再預測連續動作。

GAM 使用凍結的 promptable 3D detector,提取目標物件的視覺特徵和 metric geometry,並與機械人狀態歷史交給 multi-stream transformer,輸出 action chunks。相較於由 Vision-Language-Action Models(VLAs)或 World-Action Models(WAMs)從示範中隱性學習位置關係,GAM 把 3D 位置直接放進控制流程,也可由高層 planner 透過不同提示方式控制,支援較長流程和需要記憶的操作。

A language instruction, a 2D point or a 2D box is resolved by a pretrained 3D grounding model into image tokens and dete

目前可參考的結果包括:
– RoboTwin 2.0 的 50 項任務平均成功率為 55.3%,場景隨機化時為 47.6%。
– LIBERO-PRO 的 16 種擾動設定平均成功率為 61%,目標重新放置時改善較明顯。
– 雙臂 YAM 面對視覺變化仍成功 17/20 次;Franka 配合 Molmo2 planner,長流程任務的 OOD step completion 為 49.8%。

Grounded-Action-Model 適合研究機械人操作、視覺變化和高低層控制協作的團隊,但目前 GitHub 仍只有論文與項目頁面,training and inference code、pretrained checkpoints 及 real-robot setup 尚待公開,因此暫時不能按儲存庫直接安裝或重現結果。數據主要來自指定基準和兩款機械人,能否延伸到其他硬件與未見過的操作,仍要等待程式碼及更多測試。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, 微軟, VLA, World-Action Model, Robotic, 3D, 庫

CrossView Warp : H3 LoRA 影片新視角

輸入原片與鏡頭偏移,就能生成同一場景的新視點;代價是需要 ComfyUI、深度變形及額外工作流程配合。

Og image

想從影片另一個鏡頭角度觀看同一場景,這個 LoRA 可直接處理方位角(azimuth)及仰角(elevation)偏移。它基於 MiniMaxAI/MiniMax-H3 微調,屬於 Ref2VA 影片生成用途,並非獨立的完整模型。

模型會同時讀取兩段影片:經過 CrossView Warp 的深度變形片段負責提供場景幾何,原始片段則保留人物身份與外觀。深度資訊由 MoGe Inference 產生,再交給 ComfyUI-CrossViewWarp 節點處理;生成結果對未被原片覆蓋的區域仍需要提示詞引導,因此新視角越大,畫面補全的不確定性亦可能增加。

使用流程集中於 ComfyUI:安裝 CrossViewWarp node,先取得 MoGe 幾何資料,再把 warp 與 source 調整至相同尺寸;載入 MiniMax-H3_Ref2VA-LoRA-CrossView-Warp_v1_3500.safetensors 到 ref2va checkpoint,並以 MiniMax H3 Add Guide 和 MiniMax H3 Reference To Video 串接,frame_idx 設為 0。LoRA strength 建議由 0.8 開始,頁面建議範圍為 0.8 至 1.0,觸發詞是 crossview。

  • 已確認的基礎模型:MiniMaxAI/MiniMax-H3
  • 主要檔案:MiniMax-H3_Ref2VA-LoRA-CrossView-Warp_v1_3500.safetensors
  • 頁面未列出 GGUF 檔案、量化級別、mmproj、檔案大小或量化建議,因此不能推斷 Q4_K_M 等本地推理配置
  • 頁面只明確提供 ComfyUI 工作流程,未確認 llama.cpp、Ollama、LM Studio、MTP draft speculation 或效能基準支援

它把 CrossView-Warp 概念移植到 MiniMax-H3,核心價值在於以幾何變形和原片外觀互補,協助影片生成模型維持場景連貫性。頁面提供多個 compare_* 影片作為 warp、原片與結果的並排示例;授權則標示為 minimax-h3-community-license。

模型

Categories: 開源, ComfyUI, AI productions, Video, 提示詞, 庫, MiniMax

Page 9 of 17
1 … 7 8 9 10 11 … 17