jarvis-voice-butler:識睇住嘢同你傾偈 + 開瀏覽器幫你查資料

用講嘢就可以叫 AI 幫你上網、搜尋、填表,仲配上一把英式管家口吻。這個項目把 LiveKit Agents、Google Gemini Live 同 Playwright 串成一套聲控代理人。

Repository image for ruxakK/jarvis-voice-butler

聲控助手最麻煩嘅地方,往往係講完一句佢就要重新聽成段指令,又或者根本無法直接代你落手做嘢。Jarvis 直接針對呢個卡位,把 LiveKit Agents 框架、Google Gemini 3.1 Flash Live 即時語音模型,同 Playwright 操控嘅 Chromium 瀏覽器三樣嘢扣埋一齊。你可以理解成一個識講英式冷笑話嘅 AI 管家:你開口叫佢搜尋資料、撳掣、打字、捲頁、讀網頁內容,佢都會即時用「Enceladus」把聲回應你,過程仲支援自適應打斷同搶先生成。

對比起一般只能對答嘅語音 bot,呢個項目最大嘅突破係將語音輸入直接打通到瀏覽器操作層。佢內建十一個工具,包括開網址、搜尋、讀取同檢查頁面、撳掣、打字、捲動、撳掣鍵同截圖,仲有一個 confirm_browser_action 安全閘,去處理會造成實際後果嘅動作,例如提交表單或者刪除資料。視訊鏡頭輸入亦支援,等 AI 可以「睇到」你。

How to build a JARVIS AI Voice Agent for FREE | Full Livekit Tutorial (2026)

如果你想由頭砌起,作者用 uv 管理 Python 依賴,前端就用 Next.js 加 React,而家嘅程式庫亦用 Python 寫評估測試,覆蓋代理行為、瀏覽器操作同 prompt 表現。前端介面跟住會播一段自訂粒子動畫,連 Flutter 手機客戶端都一齊包埋,等你可以用手機當遙控。

呢類項目最適合做內部自動化研究助理,或者需要示範 Computer-use agents(CUAs)點樣融入聲音介面嘅團隊。值得留意嘅限制係實作仍處於早期階段,prompt 同安全策略都係寫死嘅版本,如果你想用佢處理高風險任務,仍然要自行加多一層審批同監察。
GitHub

Categories: 開源, Agentic, Google, Gemini, Audio, 框架, 工具, Python, 庫, 語音, 動畫

qisi-video-remix:喂一段參考片給 Agent 它直接交出改編劇本與分段提示詞

一個專給 AI Agent 用的視頻改編技能:丟一段參考視頻,它就吐回新故事、完整劇本、分鏡表和能直接複製貼去生視頻的分段提示詞。

Repository image for wyuzhi/qisi-video-remix

要做一條短片,常常卡在「找參考、拆敘事、寫分鏡、再翻譯成生成器看得懂的提示詞」這幾步之間。qisi-video-remix 把這條鏈條整進一個 Agent skill:你貼一段參考視頻(或者故事梗概、截圖、逐字稿),它先把原片的敘事手法抽出來,再以此為基礎寫出新故事,並按鏡頭兼容性和時長上限拆段,最後給出每段可獨立複製的生成提示詞。它不依賴特定後端或拼裝服務,所有結果先在對話中展開,能寫檔的環境下再另外存成 creative-plan.md。

重點摘要:
– 屬於視頻策劃向的 Agent skill,不帶模型或生成器,需由宿主 Agent 處理視頻讀取與生成。
– 默認做創意改編,要落實到人物選擇、事件發展或解決方式的變化,不止換名字。
– 分段先看場景、造型與動作複雜度,再看時長;15/30 秒是單段上限,不是固定段長。
– 提示詞各段獨立展開外貌、場景、動作和對白,可直接貼到所選視頻生成工具。
– 倉庫附一份 30 秒、6 鏡、2 段的完整示例,展示交付結構。

Codex 用戶只要把倉庫克隆到 ~/.codex/skills/qisi-video-remix/ 即可載入;其他支持 SKILL.md 的 Agent 按各自技能目錄安裝。它不替你選單段上限,未確認時會先詢問;遇到無法定論的聲音、身份或轉折會標明,不補造證據。對做豎屏短劇、廣告分鏡、或者想用 AI 視頻模型快速試腳本的個人和小團隊來說,這套指令能省下不少從分鏡到提示詞的人肉翻譯工作。

GitHub

Categories: 開源, Agentic, 模型, Video, Audio, 提示詞, 工具, 庫, Skill 技能

Marigold V2:把擴散 Transformer 改成一步深度估計模型

只要一張普通 RGB 相片,就即時輸出高質素深度圖,連毛髮和髮絲等幼節都保留到。Marigold V2 把預訓練擴散 Transformer 改造為單步密集預測模型的開源項目,一張消費級 GPU 一星期內就能完成微調。

Project website

過去做單目深度估計,要麼靠傳統監督學習,要麼用擴散模型疊好多步去噪,兩者都唔易兼顧細節同效率。華為 Bayer Lab 開源 Marigold V2 走第三條路:直接把預訓練嘅擴散 Transformer(DiT)當成單步密集預測器,重新微調之後輸出深度、透視深度、法線、反照率等多種密集模態,毋須反覆去噪。對從業人員嚟講,呢個改動意味住一張普通 RGB 相可以即時變成帶細節嘅深度圖,毋須等幾秒去疊步驟,毛髮邊緣同髮絲呢類幼節都保留得到,貼近 SOTA 水準。

模型家族同訓練成本:每個 checkpoint 包含一組 rank-128 LoRA 適配器,配合 4-bit 量化嘅 DiT 主體,個別任務仲會附帶微調過嘅 VAE 解碼器。底層凍結嘅基礎模型會另外下載。整個微調流程用單張消費級 GPU 少於一星期就完成到,對個人開發者同細型實驗室都係可觸及嘅範圍。

程式碼結構清晰,方便二次開發:倉庫用 manifest graph 加 transform list 嘅方式定義數據集,網絡組件同損失函數都係讀寫 batch dict 嘅有序步驟,數據集定義、網絡圖、損失圖、優化排程四個層次分得幾開。對想擴展到新任務嘅人嚟講,只要跟住呢個結構加步驟就得,唔使由零砌起。

對比傳統多步擴散深度估計,Marigold V2 犧牲咗迭代式去噪嘅靈活性,但換嚟一步推理嘅速度同細節還原度;對比純監督方法,佢借用咗擴散模型對紋理同邊界嘅先天理解力,再加 LoRA 保持輕量。同一批權重仲可以用喺 metric depth completion 等下游任務,一個模型覆蓋多個密集預測場景。

**適合做 AR/VR、3D 重建、影像合成嘅中小團隊,或者想低成本試驗新密集預測任務嘅研究者,都會覺得呢個 setup 幾啱手。HuggingFace 上有對應嘅 demo 空間可以直接試,權重同訓練推理碼都已開源。

項目主頁 · GitHub · 模型

Categories: 開源, 華為, 模型, 模型訓練, Qwen, Image, 3D, 庫, Dataset 數據集

OpenWAM-α 把世界模型與動作模型拆開重組

來自XPolicyLab等團隊的開源研究棧OpenWAM,把世界–動作模型(World-Action Models)拆解成可替換模組,並以約6,400小時第一人稱與機器人資料訓練出OpenWAM-α,在八個模擬基準與真機實驗均取得頂尖表現。

OpenWAM

如果你是做機器人策略或世界模型研究,大概都有過這種經驗:想換一個視覺編碼器、想試不同動作頭的耦合方式,結果整個訓練流程都要重寫,因為生成骨幹、視覺表示、架構、推論步驟和訓練資料全綁在一起。OpenWAM正是針對這種「綁死」的痛點而來。它是一個開源研究棧,把世界–動作模型(World-Action Models,簡稱WAMs)的設計空間拆成可組合模組,並用統一介面串接訓練、推論、部署與評估。

這個項目分成三層。OpenWAM-Infra提供模組化基礎設施,讓研究者可以像堆積木一樣替換模型、表示、訓練與評估設定;OpenWAM-Study則透過控制變量實驗,回答三個核心問題:應該從什麼預訓練骨幹繼承知識、世界學習與動作學習如何耦合、以及兩者如何隨規模擴展。基於這些結論,作者訓練出OpenWAM-α,一個以約6,400小時(5.185億幀)第一人稱人類與機器人資料預訓練的開放模型,並在涵蓋單臂、雙臂到靈巧手的八個模擬基準,以及真機實驗中維持頂尖水準。

架構由Hydra配置檔驅動,預設採用wan22 ti2v 5B作為影片骨幹,並搭配獨立的動作頭(如ActionDiT或共享動作骨幹),視覺編碼器則可在VAE、DINOv3、V-JEPA 2.1之間切換。基準測試覆蓋RoboTwin、LIBERO、LIBERO-plus、RoboCasa365、RoboCasa GR1、VLABench等主流環境,研究者可以直接用提供的評估客戶端跑對比。

  • 定位:開源研究棧,專門解決世界–動作模型設計選擇難以分離比較的問題
  • 核心貢獻:把生成骨幹、動作頭、視覺表示等模組化,並用控制實驗歸納出三條設計原則
  • 預訓練模型:OpenWAM-α基於約6,400小時第一人稱與機器人資料訓練,在八個模擬基準及真機均表現頂尖
  • 適用對象:機器人策略學習、世界模型研究團隊,以及需要可重現基準對比環境的從業者
  • 配套資源:模型已上傳Hugging Face,並提供完整的訓練、推論、部署腳本

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港大學, 模型, 世界模型, 模型訓練, Video, World-Action Model, 庫, Dataset 數據集

anything2explainer:把任何主題變成科普影片

它不是 CLI,而是一套交給 AI 編碼 agent 用的方法包:從研究、旁白、字幕到分鏡,都用 Remotion 寫成 React 元件,產出可逐幀追溯的解說影片。

Repository image for Vincentwei1021/anything2explainer

當你丟一個主題或一篇文件給它,系統會先做資料蒐集並標註來源,再寫旁白、生成 TTS 語音,並把時間軸對齊到逐個鏡頭。接著多個建構 agent 平行運作,每個負責一個 Remotion(React + TypeScript)元件,QC agent 再依書面標準審查每一幀。輸出是 1280×720 H.264 MP4,配上字幕、章節卡與進度條,全程沒有現成影片或生成式影像模型的痕跡。

這套流程對創作者的最大意義在於可追溯。每個鏡頭都有自己的原始碼、QC 報告與研究文件,螢幕上出現的年份、數字、英文術語都要對得到來源 URL;live-action B-roll 也強制記錄在 MANIFEST 裡,附上 sha256、來源與授權。這種「紙本文書鏈」對需要審核的場景——例如企業內訓教材或品牌內容——比多數 AI 影片工具更有交代。

在同類做法裡,它明顯偏向工程化交付而非即興 demo。Remotion 元件庫、燈光與樣式規格、多 agent 協作協議都以可複用資產形式提供,並用一段完整的參考影片作為品質基準。對會寫程式、需要大量長版講解影片但又受版權與準確性束縛的團隊——例如 SaaS 團隊做產品教學、研究單位做技術普及——會比較感受到它的價值。

限制同樣明顯:不是 CLI,必須搭配 Claude Code 或 Codex 這類 agent 環境;TTS 要自備並處理對齊;中英文以外語言未提及支援;整個流程壁鐘 1 到 3 小時,瓶頸在並行建構鏡頭的數量與長度。授權採 PolyForm Noncommercial,商用前要先看清楚。

重點摘要

  • 全程程式碼繪製:用 Remotion 寫 React 元件產出每一幀,沒有生成式影片模型或現成素材。
  • 可審核的紙本文書鏈:研究文件、旁白、分鏡、鏡頭原始碼、QC 報告全部保留。
  • 多 agent 平行建構:研究、旁白、語音、分鏡後,由多個 agent 同時寫鏡頭元件,QC agent 再逐幀複查。
  • 多語言旁白:支援中文與英文,TTS 需自備並做強制對齊。
  • 非商業授權:採用 PolyForm Noncommercial,商用情境需自行評估。

GitHub

Categories: 開源, 文字轉語音, Agentic, AI productions, OpenAI, Video, Image, 工具, Content Creator, 庫, 語音, Anthropic, 動畫, Skill 技能

MovieGrid 把長片拆成方格生成,解決多鏡頭一致性

來自 UC Santa Cruz 等院校的 MovieGrid 框架,把長片拆成空間方格同步生成,目標是同時兼顧鏡頭內連續動作與跨鏡頭視覺一致性。

Repository image for jwmao1/moviegrid

MovieGrid 針對的痛點很直接:現有影片生成模型傾向犧牲多鏡頭敘事完整性來換取單鏡頭內的動作連貫,而傳統把整段故事沿時間軸壓縮的做法,更會加深這個偏差。

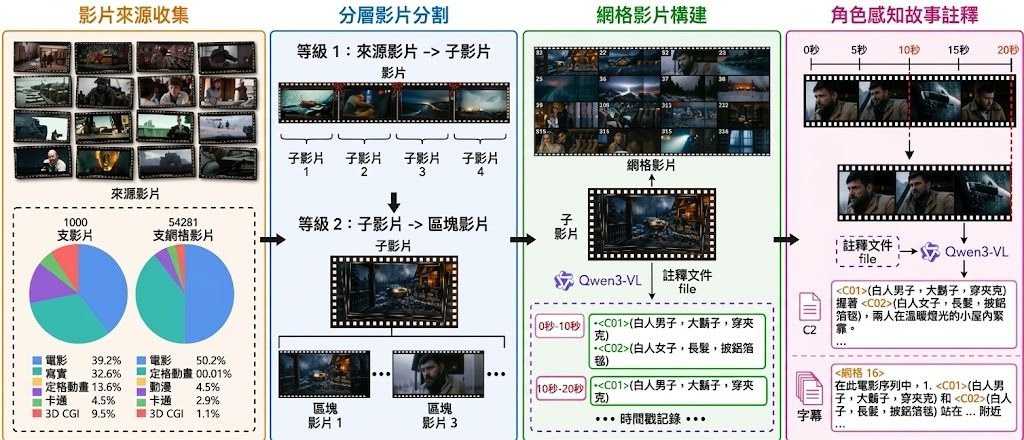
核心做法是把一段長影片切成分佈於空間方格上的短片段,每格只負責少量鏡頭與較短的時間跨度,從而降低單格需要建模的轉場數量;同時所有格子會被聯合生成,並透過 Grid Embedding、角色感知的 Story Prompt 以及 Grid Boundary Loss 來維持格與格之間的銜接。訓練時採用的 Noise-Free Random-Grid Training,會隨機保留部分格子作為乾淨視覺上下文,引導其餘格子的去噪過程。

項目以 Wan2.2-TI2V-5B 作為基座模型,並配搭自家構建的 MGLV 資料集——從 1,000 段長片萃取出 54K 條方格影片,每條都附有角色級故事標註。在等量 token 預算下,MovieGrid 在 1,616 幀長片裡可生成比 Temporal Packing 基線多 6.05 倍的鏡頭,並在自建基準上取得 0.9131 的鏡頭內一致性與 0.5914 的跨鏡頭一致性,分別優於 HoloCine 與 StoryMem。

目前已開源 16 格與 64 格的訓練與推理配置,以及對應的 MovieGrid-16、MovieGrid-64 LoRA 權重;環境需以 Python 3.10 搭配官方 Wan2.2 倉庫安裝。對需要批量產出多鏡頭短片、廣告分鏡或敘事預覽的團隊,這套框架提供了比單時間軸方案更可擴展的路徑,但生成品質仍受基座模型與資料規模所限,未來計劃加入 first frame 與 storyboard 條件控制。

重點摘要:
– 核心方法:將長片切成空間方格短片段並聯合生成,減輕每格時間跨度負擔。
– 關鍵機制:Grid Embedding、角色感知 Story Prompt、Grid Boundary Loss 與 Noise-Free Random-Grid Training。
– 基座與資料:基於 Wan2.2-TI2V-5B,配搭自建 MGLV 資料集共 54K 條方格影片。
– 開源狀態:已釋出 16 格與 64 格的推理配置、訓練代碼,以及對應 LoRA 權重。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, Embedding, 模型, 模型訓練, Video, 框架, Python, 庫, Dataset 數據集

Perplexity 開源 Lily:Mac 本地推理專用提速引擎

Perplexity 推出針對 Apple Silicon 與 Qwen3.6-35B-A3B 的本地推論引擎 Lily,繞過 PyTorch 與 MLX,以 Rust 和自訂 Metal kernels 改善預填充及解碼效率。

Repository image for perplexityai/pplx-garden

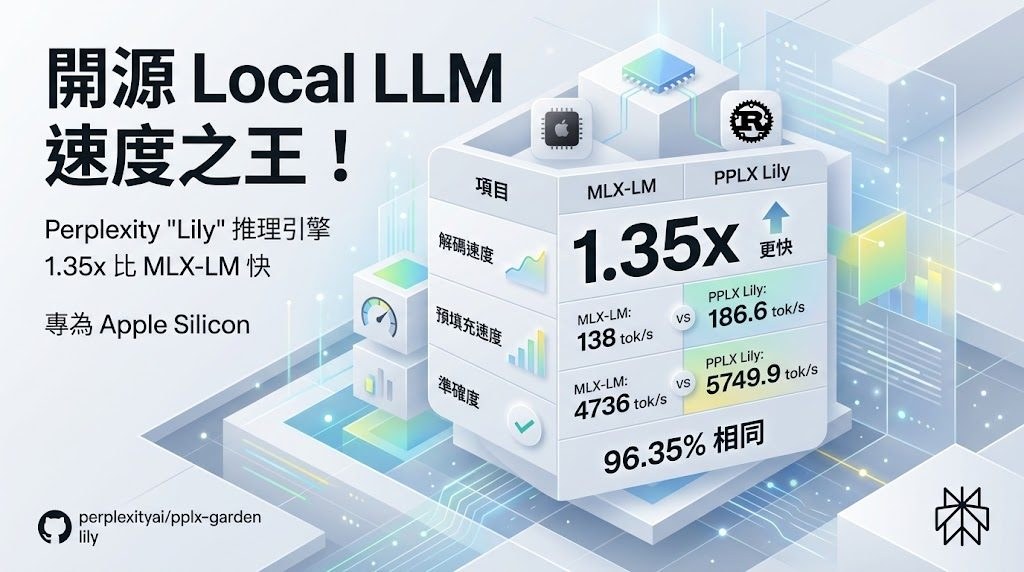
當大型模型開始負責處理 Mac 上的私人檔案與應用程式,本地推論速度就不再只是開發者實驗的指標。Perplexity 開源嘅 pplx-garden 入面,Lily 以工具項目形式處理 Apple Silicon 上 Qwen3.6-35B-A3B 的推論,目標係令提示詞處理及文字生成更快,並透過 OpenAI-compatible HTTP API 串接聊天流程。

Lily 唔似 MLX-LM 般追求支援多款模型,而係集中服務 Qwen3.6-35B-A3B:Rust runtime 負責載入 checkpoint、管理 session state 同生成迴圈,自訂 Metal kernels 就處理模型特定運算。呢種單一進程、模型與 runtime 共同協調嘅做法,減少通用 kernel 帶來嘅額外調度,亦避開 PyTorch 和 MLX execution path。

pplx-garden 不只是 Mac 本地推論工具。fabric-lib 提供 RDMA TransferEngine,同時涵蓋 P2P MoE dispatch 與 combine kernel;pplx-unigram 則係針對 Unigram tokenizer 嘅 CPU encoder。相關內容亦包括 trillion-parameter model 喺 AWS EFA 上嘅部署,以及 RL post-training 權重轉移、分離式 prefill 和 decode 等系統研究,顯示儲存庫涵蓋由裝置端推論到分散式 LLM infrastructure 嘅多個瓶頸。

適合需要喺 Mac 處理敏感資料、又希望保留本地生成能力嘅開發者及研究團隊;需要 RDMA、MoE 溝通或 tokenizer 優化嘅系統工程人員亦可參考相關元件。現有資料集中講述 Lily 分別量度 prefill throughput 同 decode throughput。

重點摘要:
– Lily 專為 Apple Silicon 與 Qwen3.6-35B-A3B 設計,支援 OpenAI-compatible HTTP API。
– 以 Rust runtime 配合自訂 Metal kernels,分開處理 prefill 同 decode。
– 不經 PyTorch 或 MLX execution path,代價係模型及硬件支援範圍較專門。
– fabric-lib 同 p2p-all-to-all 面向 RDMA、MoE dispatch 與 combine 等分散式推論問題。
– 效能應按裝置、上下文及生成負載實測,不能只依賴官方定位作比較。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, Qwen, OpenAI, API, 提示詞, 工具, Mac, Python, 庫, 蘋果, Dataset 數據集

MiniMax H3 Director Studio:Windows 本地模型做 AI 影片前期製作

Director Studio 是一個本地優先的前期製作工作空間,串接 Ollama 規劃鏡頭、ComfyUI 生成畫面,再交由 MiniMax H3 出片,特別適合想完全控制創作流程的獨立創作者。

Repository image for ai2764/Director-Studio

想在本地完成 AI 影片從構思到成片的整條前期流程,而不依賴雲端訂閱?Director Studio 正是針對這個需求的工作空間類工具。它把鏡頭規劃、可重用的視覺與語音資產管理、以及 MiniMax H3 Ref2AV 提示詞撰寫,整合在同一個介面內,最後透過 ComfyUI 與 MCP 協議生成圖像與影片。

與一般 ComfyUI 前端不同,它把「規劃 Agent」綁定在本地 Ollama 上運行,並與 ComfyUI 共享 VRAM,避免兩者搶顯存。用戶可以選擇全本地流程,亦能把 H3 影片交給官方 MiniMax API 處理,兼顧靈活與效能。內建的 typed asset library、演員與場景工作流、可編輯的 Picture/Audio 參考、以及六段式 H3 提示詞結構,讓鏡頭設計不再是憑感覺亂試。

Qwen3.8 27B Directs H3 | Director Studio Is Now Open Source

對於獨立創作者、小型製作團隊,或需要反覆迭代鏡頭分鏡的人,這套工作流省下了在不同工具間切換的成本。Windows 用戶只要安裝 Ollama、ComfyUI Desktop 與 Python 3.10+,再解壓官方 zip 即可透過 DirectorStudio.exe 啟動,所有資料儲存在執行檔旁的 data 目錄,方便升級前備份。

採用 FastAPI 後端配合 Vite + React 前端,規劃 LLM 透過 Ollama 執行,生成層則透過 ComfyUI MCP 串接。架構與擴展點已在 docs/ARCHITECTURE.md 說明,適合想自行修改管線的進階用戶。

需要注意,VRAM 是這套系統的瓶頸:Ollama 與 ComfyUI 需共享顯存,若要同時運行大型本地模型與高解像度影片工作流,硬體門檻不低。對於偏好全雲端、或無獨立顯卡的用戶,這套方案未必比 SaaS 工具方便。

GitHub

Categories: 開源, ComfyUI, Agentic, AI productions, MCP, 模型, 多模態模型, API, Video, Image, Audio, 工具, Content Creator, Ollama, Python, 庫, MiniMax

Dr. Claw 把 AI 研究流程收進一個可審核工作台

一款開源 AI 研究助理,把文獻回顧、實驗、寫作整合在同一介面,讓人類決策與 AI 執行之間留下可追蹤的紀錄。

Dr. Claw

跑過 AI 研究的團隊都遇過同樣的痛:Claude Code、Gemini CLI 等命令行編碼代理(coding agents)能讀寫檔案、撐住長對話,但文獻回顧、構思、實驗、寫論文、投期刊這些步驟散落在聊天工具、IDE、終端機、寫作軟件之間,中間決策也難以回頭追溯。Dr. Claw(GitHub: OpenLAIR/dr-claw)針對的正正是這個碎片化問題——它不是另起爐灶造一個新代理,而是把現有命令行編碼代理(Claude Code、Gemini CLI、Codex,以及透過 OpenRouter 接入的數百個模型)包進一個可控、可審核、人在回路(human-in-the-loop)的工作流。

項目覆蓋 survey → ideation → experiments → paper writing → slides & promotion 整條研究生命週期,與只懂執行程式碼的 CLI 代理相比,差異在於「全流程編排層」。底層靠三個關鍵設計撐起這層:持久化狀態物件(persistent state objects)、可重用技能庫(reusable skill library),以及多執行器協調(multi-executor coordination),把計劃、執行、寫作綁成一條可恢復的循環。論文亦明確指出,比起只共享同一後端執行器的裸 CLI 代理,Dr. Claw 在研究完整性上得分更高,同時保留可審計、可回溯的過程痕跡。

對獨立研究者、AI 實驗室團隊、需要把研究流程制度化的單位而言,這套架構的價值在於把人類決策(目標、約束、驗收)與 AI 執行清楚分開,並透過 checkpoint 反饋(Verify / Revise / Retry / Handoff)保留介入點。它支援本地部署(自家機器、自家 GPU、自家資料),亦提供桌面版(.dmg / .exe)或 npx dr-claw 零安裝啟動,甚至能在終端機直接 dr-claw chat 跑 agentic 對話。

項目已被 EMNLP 2026 System Demonstrations track 收錄(arXiv: 2609.00365),並採用 AGPL-3.0 搭配上游 GPL-3.0 元件授權,免費、無訂閱。需要留意的是,它自定位為 Anthropic Claude Science 的開源、模型中立替代方案,主打全生命週期而非單純計算分析。

GitHub · Paper

Categories: 開源, Agentic, 模型, OpenAI, Gemini, 軟件, 工具, IDE, 庫, 編程, Anthropic, Skill 技能

Hojo-ASR-Multi-V1:廣東話語音識別引擎

基於 Qwen3-4B-Instruct-2507 微調而成的多語言語音辨識模型,覆蓋歐亞九種語言,嘈雜環境與口語修正都有對應訓練。

Og image

如果你聽過一段嘈雜環境裡帶口音嘅外語對話,想即時轉成文字,Hojo-ASR-Multi-V1 就係針對呢類場景設計嘅。它並非由零訓練嘅語音模型,而係喺 Qwen/Qwen3-4B-Instruct-2507 之上做微調,把語音編碼器接駁到大語言模型嘅解碼端,形成 Encoder-Adapter-LLM 嘅典型結構,再加入多幀聲學融合模組去保留細粒度嘅聲音特徵。訓練過程分階段進行並結合強化學習,所以喺噪音、非標準發音、講錯即改口呢類真實情境下都唔會輕易崩潰。

多語言覆蓋係佢最突出嘅賣點。官方公布支援德、法、西、葡、意、日、阿拉伯、韓、俄等九種主要語言,並加入咗普通話、英語、廣東話同四川話等方言支援。從公開評測結果睇,佢喺多個 CoVoST、MLS 同 FLEURS 基準上都錄得相當低嘅 WER,例如意大利 FLEURS 2.30、法語 MLS 2.95、德語 CoVoST 3.85,整體表現平穩。

喺使用層面,開發者可以透過 PyPI 上嘅 hojo-asr 套件快速部署,亦支援 Hugging Face Transformers 後端。HOJO_ASR.load_model 介面可以直接接收 wav 檔案路徑、scp 清單或原始音訊 bytes,配合 CUDA 設備做批次推論。授權用 Apache-2.0,並提供商業整合支援,方便團隊接入產品線。

由於佢建基於 Qwen3-4B 體量,運行門檻比傳統大型 ASR 親民得多,但仍然需要 GPU 推論以維持批次速度。

重點摘要:

  • 基礎模型:以 Qwen/Qwen3-4B-Instruct-2507 為骨幹,採用 Encoder-Adapter-LLM 架構
  • 語言覆蓋:歐亞九國主要語言,加普通話、英語、廣東話、四川話
  • 訓練方式:多階段模組化訓練結合強化學習,針對噪音同口語修正優化
  • 評測表現:CoVoST、MLS、FLEURS 多語言 WER 普遍處於 2–5 區間
  • 部署方式:pip install hojo-asr 後用 HOJO_ASR.load_model 載入,支援檔案路徑、scp 或 bytes 輸入

需要留意嘅係,頁面並未提供 GGUF 量化檔案或本地推論引擎資訊,目前主要以 transformers 後端配合 GPU 運行;如果你想喺純 CPU 或邊緣裝置上使用,就要留意後續會唔會補上量化版本。

項目主頁

Categories: 開源, 模型, Qwen, Audio, 庫, 語音, Dataset 數據集, 廣東話

Page 11 of 17
1 … 9 10 11 12 13 … 17