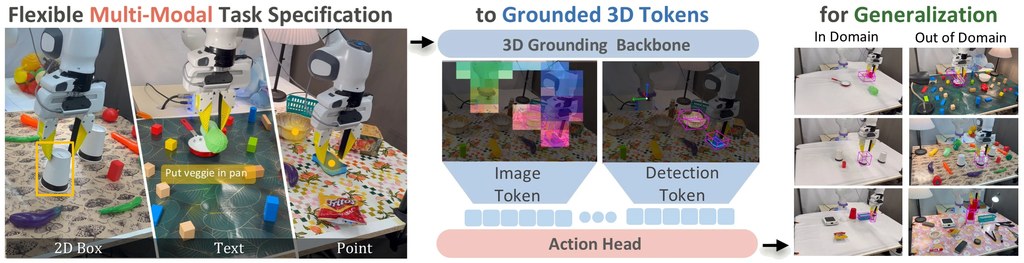
面對物件被移位、場景重新排列,機械臂未必只需要更長的指令,而是要準確知道目標在哪裏。Grounded Action Model(GAM)屬於機械人基礎模型,透過 3D grounding 將語言、2D 點或 2D 框選轉成同一套以物件為中心的觀察,再預測連續動作。
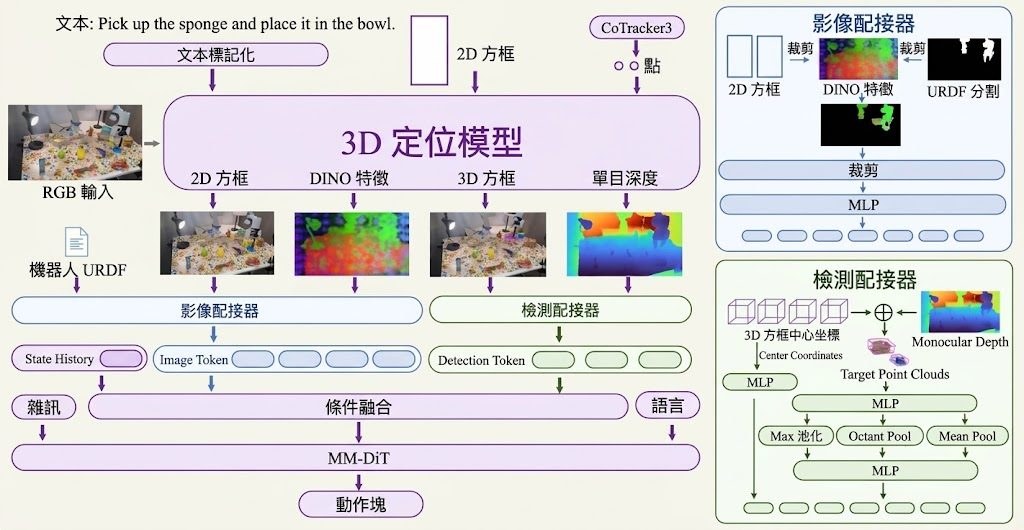
GAM 使用凍結的 promptable 3D detector,提取目標物件的視覺特徵和 metric geometry,並與機械人狀態歷史交給 multi-stream transformer,輸出 action chunks。相較於由 Vision-Language-Action Models(VLAs)或 World-Action Models(WAMs)從示範中隱性學習位置關係,GAM 把 3D 位置直接放進控制流程,也可由高層 planner 透過不同提示方式控制,支援較長流程和需要記憶的操作。
目前可參考的結果包括:
– RoboTwin 2.0 的 50 項任務平均成功率為 55.3%,場景隨機化時為 47.6%。
– LIBERO-PRO 的 16 種擾動設定平均成功率為 61%,目標重新放置時改善較明顯。
– 雙臂 YAM 面對視覺變化仍成功 17/20 次;Franka 配合 Molmo2 planner,長流程任務的 OOD step completion 為 49.8%。
Grounded-Action-Model 適合研究機械人操作、視覺變化和高低層控制協作的團隊,但目前 GitHub 仍只有論文與項目頁面,training and inference code、pretrained checkpoints 及 real-robot setup 尚待公開,因此暫時不能按儲存庫直接安裝或重現結果。數據主要來自指定基準和兩款機械人,能否延伸到其他硬件與未見過的操作,仍要等待程式碼及更多測試。