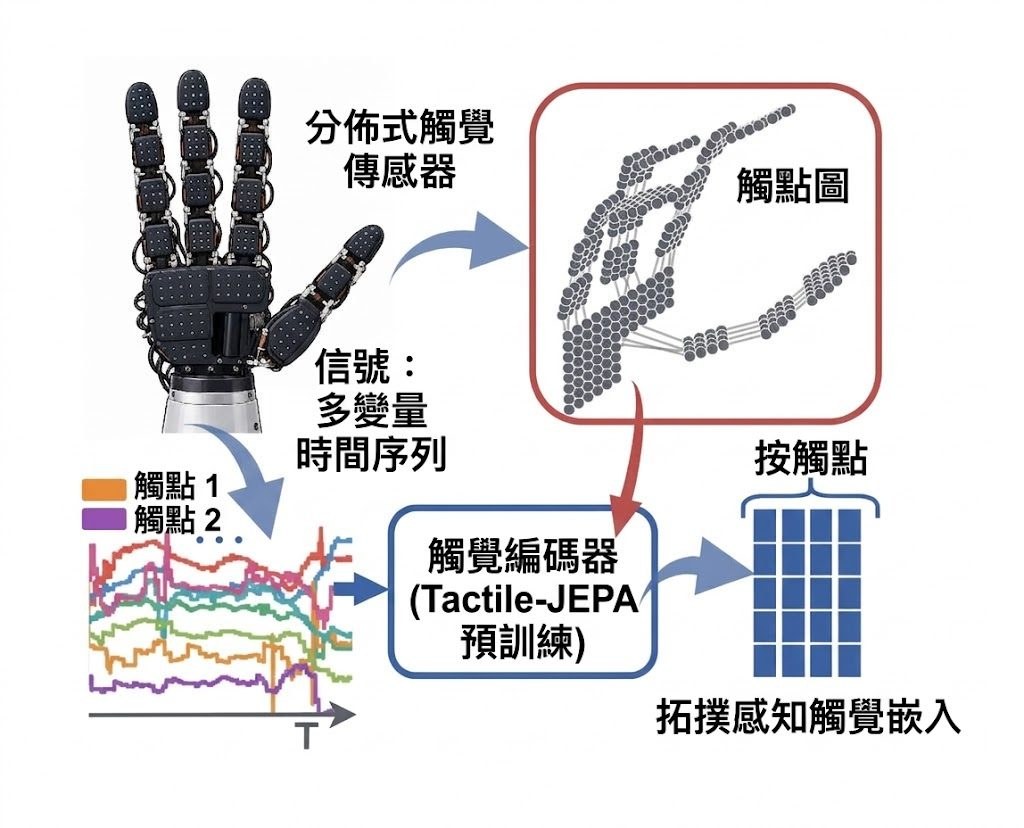
電子皮膚面對的難題,不只是讀取感測數值,而是要理解哪些 taxel 彼此相鄰、接觸訊號如何在感測表面分布。Tactile-JEPA 屬於觸覺表徵學習模型,透過感測器拓撲預測被遮蔽的 taxel embedding,將原本分散的時間序列轉成可供下游任務重用的表示。
它沒有把感測面硬套成規則影像網格,而是沿着 sensor connectivity graph 抽取局部及全局遮罩;預設組合包含兩個 local masks 和兩個 global masks,兼顧局部接觸細節與整個表面的狀態。模型由 context encoder、exponential-moving-average (EMA) target encoder 和 predictor 組成,predictor 預測隱藏 embedding,再以 mean squared error 對齊 target encoder 輸出;預訓練完成後,凍結的 target encoder 可配合 task-specific heads 使用,而下游編碼不再需要圖結構。
項目涵蓋 Xela magnetic hand skins、piezoresistive tactile socks,以及雙手 DECO-50 等不同感測器形態,支援 force estimation、in-hand 及 full-body pose estimation、object/action classification 和 visuo-tactile policy learning。首頁報告指,模型相對各任務最強基線,in-hand orientation error 減少 20.8%,force estimation error 減少 6.3%,但預訓練模型及論文連結仍標示為 TBD,結果重現程度要視乎後續資源是否補齊。
測試需要 Linux、Conda 及具 CUDA-compatible driver 的 NVIDIA GPU,並由儲存庫建立環境、以 editable package 方式安裝。三個資料集合共涉及數百個 taxels,下載及整理成本不低,較適合研究觸覺感知、機械人操作或 visuo-tactile learning 的團隊;只需要單一感測器分類器的工作,未必能抵銷圖結構整理及 GPU 預訓練成本。
- 以拓撲遮罩取代影像式規則遮罩,貼近不規則電子皮膚的實際排列。
- Local 與 global targets 同時捕捉接觸細節及整體感測狀態。
- 預訓練 encoder 可服務力量、姿態、物件及動作等多種下游任務。
- 圖結構只參與預訓練,之後的編碼流程較容易接入不同任務。