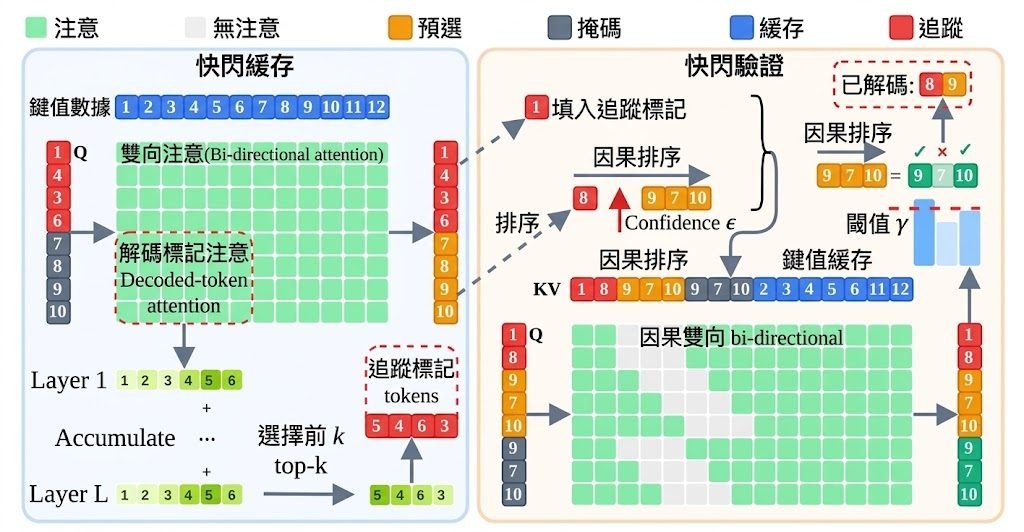
擴散式語言模型每輪去噪都可能同時產生多個 token,但反覆更新 KV-cache 會令 GPU 花大量時間讀寫資料。Flash-dLLM 屬於免訓練推理加速框架,針對這個記憶體瓶頸提升解碼速度,亦保留可調校的準確度與吞吐量取捨。
Flash-Cache 以融合式 Triton kernel 一次處理 QKV projection、rotary positional embedding(RoPE)及 cache writes,並透過 block-scheduled attention 支援批次內不同查詢長度。它只刷新新解碼 token 及按 attention importance 選出的少量關鍵位置,避免每輪重算全部內容。
Flash-Verify 再利用同一個 diffusion model 同時擔任 drafter 和 verifier,毋須額外模型或訓練;draft token 與 [MASK] token 會透過兩種視圖驗證,符合信心門檻的預測可一併接受。
• LLaDA-1.5 測得 148–211 tokens/s
• 比無 caching 的 greedy decoding 快 22.3 至 148.2 倍
• GSM8K 和 HumanEval 比 Elastic-Cache 快 5.1 倍及 11.0 倍
• GPU 記憶體約比 Fast-dLLM 少 48%,可擴展至 batch size 32
這個項目適合研究 diffusion LLM 推理、GPU kernel 或高吞吐量服務的團隊。使用前需按儲存庫提供的環境及模型設定進行安裝和 evaluation;結果會受 GPU、批次大小、信心門檻及模型支援程度影響,數字未必能直接套用到其他 dLLM。