RefineEdit : 免訓練 Prompt-to-Prompt 編修

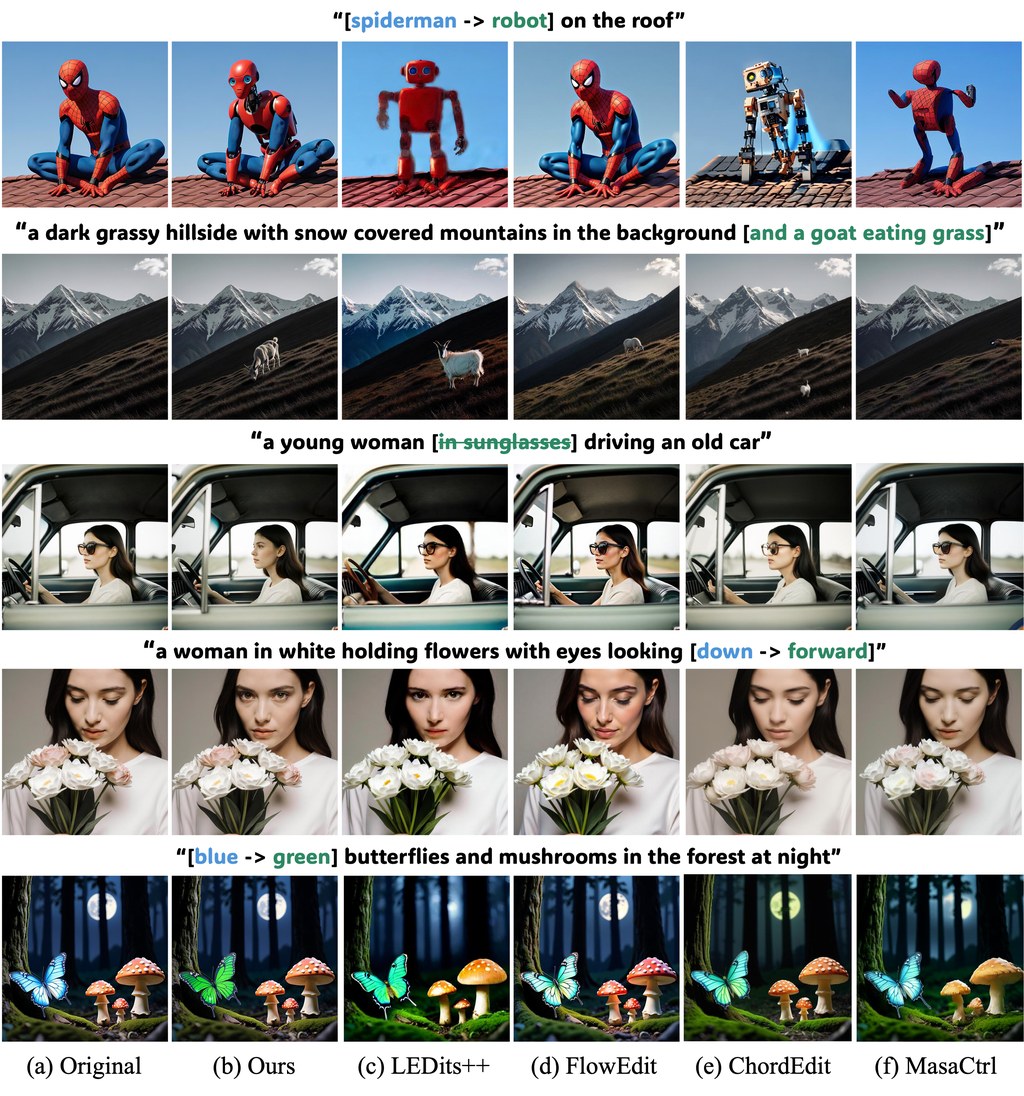
RefineEdit 以文字提示生成來源與編輯結果,毋須額外訓練或遮罩,但未能直接處理任意真實照片。

compare

由 source prompt 改成 editing prompt 時,RefineEdit 會先生成來源圖,再重用中間 refinement state,讓 1024 × 1024 編輯結果較容易保留原有內容。這個項目屬於免訓練的 prompt-to-prompt 影像編輯方法,實際處理的是文字驅動編輯中「改變指定內容」與「維持畫面穩定」之間的取捨。

GRN 負責生成流程,HBQ tokenizer 和 UMT5 encoder 會一同載入;RefineEdit 本身沒有額外 checkpoint。source-anchored bit routing 先選出可編輯座標,再配合 adaptive spatial freezing(AdaSF)及 finite bit locking(FBL)限制後續變化,毋須外部 editing mask。

RefineEdit 需要 Linux、支援 BF16 的 CUDA GPU,以及官方 GRN 預訓練權重;A100 80 GB 是參考配置,項目並不適合低記憶體 GPU 或 CPU 推理。FlashAttention 2 可加速原始流程,未能安裝時可改用 PyTorch scaled dot-product attention,但速度、記憶體消耗和數值結果都可能不同。

  • 不需額外訓練、RefineEdit checkpoint 或外部遮罩
  • 只支援由提示詞內部生成的來源 refinement trajectory
  • 不直接編輯任意真實圖片,應用範圍比一般照片編輯流程窄
  • 附有 mask summary/step PNG 及 adaptive bit lock stats.csv,方便檢查座標選擇和鎖定狀態

它適合研究文字生成影像編輯、需要可重現實驗的團隊,以及已有 GRN 推理環境的開發者。儲存庫未提供統一 benchmark 數字,不能單靠 1024 × 1024 輸出判斷畫質;不同 attention backend 即使使用相同 seed,也不保證產生逐像素一致的結果。
GitHub

Categories: 開源, 模型訓練, NVIDIA, Image, 提示詞, Linux, Python, 庫, Dataset 數據集

OmniVChat:測試 AI 能否同時聽懂及看懂

直接把聲音和影像交給AI,回覆是否仍有根據?OmniVChat 提供評分工具,但測試與訓練分數不能混用。

OmniVChat: Synthesizing, Benchmarking, and Training for Native Audio-Visual Dialogue

讓AI直接接收用戶的聲音和影像,再以文字回答,OmniVChat(Omni Video Chat)提供了檢驗這類對話的評估與訓練獎勵工具。問題藏在影音之中,不另附文字提問、外部影像描述或自動語音辨識(Automatic Speech Recognition,ASR)轉錄,適合測試多模態模型能否連結所見所聞。

OmniVChat-Bench包含2,800段合成對話,按分層準則評分,涵蓋五類能力:

  • Dialogue-State & Link Perception(DSLP):理解對話狀態與連結。
  • Multimodal Entity Alignment(MEA):把說話對應至正確的可見實體。
  • Model Self-Awareness(MSA):交代自身身分與物理限制。
  • Anti-Hallucination(AH):回答以影音證據為依據。
  • Emotion Recognition(ER):結合面部與聲線辨識情緒。

評估分數r(y)介乎0至1,以Subcategory Mean匯報;OmniVChat-RL共用評分核心,另加格式、效率與風格獎勵,範圍為0至1.5,兩者不能直接比較。

研究團隊可先查看儲存庫的評分程式與範例,再到Hugging Face取得完整標註及媒體。這個項目只提供程式碼、範例與文件;合成對話的結果亦不足以單獨判斷模型在真人影音互動中的可靠程度。

GitHub

Categories: 開源, 香港中文大學, 阿里巴巴, 多模態模型, Video, Audio, 工具, 庫, 語音

TeleAntiFraud 開放反詐數據與模型,建立可重現研究基礎

TeleAntiFraud 將數據集、模型、評測和程式碼集中開放,讓電信反詐研究更容易驗證與延伸。

Hero image preview

面對電信詐騙檢測需要數據、模型和一致評測標準的問題,TeleAntiFraud 以開源研究社區形式,集中提供相關資源,涵蓋數據集、模型、論文及可重現的研究基礎設施。項目由中國人民公安大學聯合發起,適合研究人員、反詐技術團隊及需要測試檢測方法的開發者使用。

社區目前公開 TeleAntiFraud 數據集、AntiFraud-SFT 模型,以及論文與程式碼倉庫,並提供 Hugging Face 模型與數據入口。相比只發布單一模型或個別研究結果,這種整合方式讓使用者可以由數據、訓練資源一路追到論文和程式碼,較方便重現實驗及比較不同方法。

可直接關注的資源包括:
– TeleAntiFraud 數據集及相關論文入口
– AntiFraud-SFT 模型發布與研究資料
– 已錄用論文及對應的公開程式碼、模型和數據
– 面向音頻文本反詐檢測的 SAFE-QAQ 研究

社區列出的最新進展包括 TeleAntiFraud-28k 獲 ACM MM 2025 接收,以及 SAFE-QAQ 獲 ACL 2026 主會接收;後者聚焦慢思考強化學習框架。網站目前未提供統一的性能數字或詳細測試結果,讀者仍需按各論文及資源頁面的評測設定理解模型能力和限制。

項目主頁

Categories: 開源, 模型, 模型訓練, 框架, 庫, 中國, Dataset 數據集

RecreationWorld:從操作到重建軟件介面

代理不只觀察介面,還要自行寫程式、啟動成品及核對結果,測試由操作走向完整交付。

RecreationWorld logo

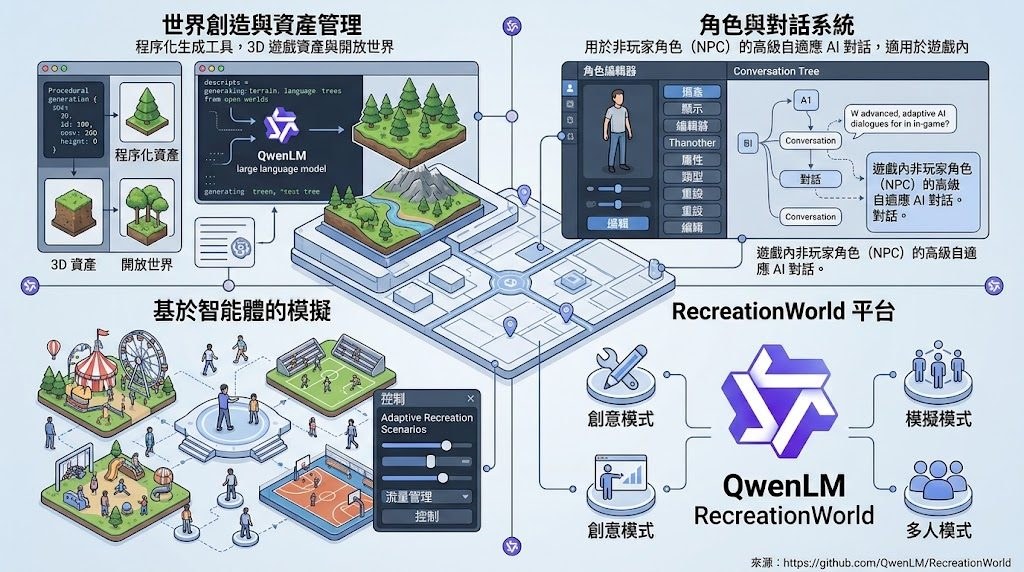
給代理一個正在運行的參考程式,它要邊操作、邊寫程式,再自行啟動及檢查成品。RecreationWorld 是研究混合式電腦操作代理(hybrid computer-use agents)的五平台框架,處理代理能否按可見行為重建軟件的問題。

它把參考程式當作可執行判準,讓代理反覆進行探索、實作與驗證,而非依固定階段完成任務。最終評分看功能與畫面是否吻合,不要求源碼、語言或架構相同,保留了實作自由。

  • 涵蓋 Ubuntu、macOS、Windows、Android 與 Web
  • RecreationBench 提供 250 個未公開於訓練流程的應用任務
  • 同時採用程式化檢查與視覺模型(Vision-Language Model,VLM)評分
  • 可比較完成度、接近滿分的應用比例及每項任務成本

已列出的結果中,GPT-6 Astra 平均 58.06%,領先 Claude Opus 5 的 44.16%,但估算成本達每項任務 115.80 美元;較便宜的模型則要接受明顯分數差距。這反映長時間探索、編碼與視覺核對仍然昂貴,而且只有少量應用能達到完整功能分數。

開發代理、GUI 自動化或程式生成系統的團隊,可下載 RecreationBench 資料集並依儲存庫的 Quickstart 配置環境;自行託管模型的正式評估需要聯絡團隊。它較適合作研究與模型比較,未見足夠資料證明可直接充當一般軟件重建服務。

項目主頁 · GitHub · 數據集

Categories: 開源, 阿里巴巴, Agentic, 視覺模型, 多模態模型, 模型訓練, Qwen, 框架, Mac, Linux, 庫, Dataset 數據集

ComfyUI-NodeSnapshots:複雜流程卡頓救星:把節點變成圖片緩存

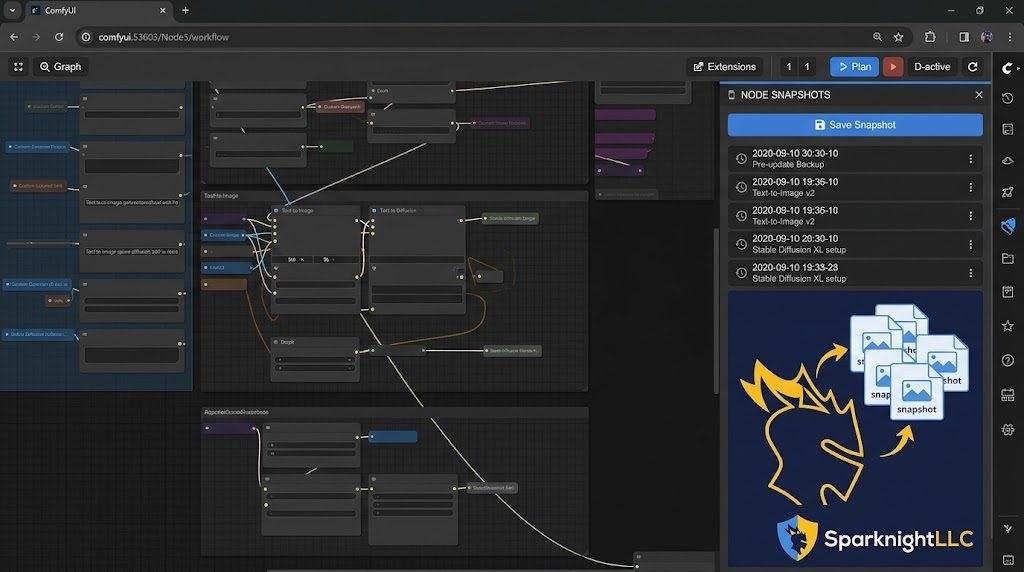
當 ComfyUI 工作流動輒幾百個節點,拖拉節點時幀率掉到個位數是常態。NodeSnapshots 把閒置的節點先渲染成透明畫布,移動時直接重用圖片,把一張圖的幀率從 20 拉回 60。

Repository image for SparknightLLC/ComfyUI-NodeSnapshots

當 ComfyUI 的工作流膨脹到幾百個節點,畫面停頓幾乎是必然。Sparknight 開源的 NodeSnapshots 是一個純前端擴充套件,目標就是把這種拖拉時的卡頓感處理掉。它不動推論邏輯、不改工作流格式、不裝額外模型,把閒置節點預先渲染成一張張透明畫布,平移、縮放、拖動節點時直接重用圖片,跳過昂貴的重繪。

在約 350 節點的實測流程裡,繁忙區塊的平均幀率從 20 FPS 拉到接近 60,改善幅度並非「感覺順」而是的明顯跳升。早期版本其實試過一次截整張圖的做法,速度更快,但截全圖那一刻會卡住;NodeSnapshots 改用逐個節點、分批閒置排程來拍快照,避開那個停頓,同時保留重用帶來的流暢感。

它處理了幾個關鍵取捨:

  • 滑鼠停留、被選取、正在編輯、媒體預覽以及執行中的節點一律維持即時渲染,避免圖片覆蓋掉需要即時更新的狀態。
  • 只有真正改到內容(值、大小、連線、繪製設定)才會把該節點的圖片標記失效;單純移動位置或縮放視窗不會清掉緩存。
  • 視窗移動中會以 100 毫秒為週期檢查緩存是否可用,停下來才回到逐幀檢查,避免邊拖邊做完整校驗。

需要注意的限制:

  • 快照以圖形座標的全細節拍攝再縮放顯示,畫面大幅放大時文字會變糊,可以透過 capture pixel ratio 取捨清晰度與記憶體。
  • 切換調色盤、換字型、整個工作流被替換時緩存會清空,第一次進入子圖也可能觸發字型刷新造成短暫等待。
  • 如果你同時裝了其他會覆蓋同樣繪製方法的擴充,可能互相影響。

對需要反覆在大型 Stable Diffusion、影像生成流程裡微調節點位置的使用者來說,這類擴充幾乎是工作流跑得起來的必要條件。安裝方式只需把資料夾放到 ComfyUI/custom_nodes/ComfyUI-NodeSnapshots,重啟後到 Settings > NodeSnapshots 開關即可。

GitHub

Categories: 開源, ComfyUI, Image, 庫

HyperFlow 自蒸餾影片生成省六成推論成本 – MiniMax-H3 八步出片

Video Rebirth 推出嘅 HyperFlow 係一個針對 MiniMax-H3 嘅 8 步 LoRA 適配器,透過 data-free flow self-distillation 將 50 步推論壓到 8 步,仲行得喺官方 diffusers Modular Pipeline 之上。

Repository image for Video-Rebirth/hyperflow

影片生成模型一直面對一個現實樽頸:想要更高品質,就要更多 sampling steps,亦意味住更長嘅等待同更高嘅運算成本。Video Rebirth 推出嘅 HyperFlow 就直接針對呢個取捨落手,喺 MiniMax-H3 官方權重之上加一個 8 步 LoRA(PEFT,rank/alpha 256,覆蓋 attention、feed-forward 同兩組 time embedder),將官方 50 點 sigma schedule 嘅 49 次前向推論壓到 8 次,而且唔需要額外訓練資料。

你可以把它理解成一個「加速層」:base weights、VAE、conditioner 同 t2va、fl2va、ref2va 三種 workflow(全部對應影片加音訊)都維持官方版本,呢個項目只負責載入 LoRA、兩個 time embedder 同固定嘅 8 步 sigma grid。官方修訂號、權重路徑、適用範圍等資料都收錄喺 hyperflow.json manifest 入面。LoRA 喺 Hugging Face 開源,授權沿用 MiniMax H3 Community License,呢個倉庫就提供 loader 同 example scripts,透過 hyperflow_blocks("fl2va") 等 API 直接接入 diffusers Modular Pipeline。

HyperFlow 嘅特點係 data-free:模型自己產生候選影片、篩走不合格嘅、然後用通過嘅樣本做 self-distillation,屬於佢哋 RSI(Recursive Self-Improvement)訓練範式嘅 self-distillation 部分。對比一般影片生成流程,呢種做法唔需要額外收集標註資料,亦唔需要人手標籤。實際運行時仲可以選擇加裝 NVIDIA Sol-Attn sparse attention(PyTorch ≥ 2.10、CUDA ≥ 12.8、Triton ≥ 3.6,支援 SM80–SM120),官方聲稱喺 H200 上比 dense attention 快約 13%,並可透過 Ulysses context parallel 擴展至最多 4 張 GPU。

對想用 MiniMax-H3 出片、又希望壓低推論時間嘅團隊或獨立開發者嚟講,HyperFlow 提供咗一個直接掛載嘅方案;對研究自蒸餾或自改進路線嘅從業者嚟講,佢亦係一個具體嘅開源參考。需要注意嘅係 num_inference_steps 唔應該手動指定,步數同 sigma grid 都由權重檔案內置決定。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視頻模型, NVIDIA, Video, Audio, Python, 庫, MiniMax

PANORAMA 把場景描述逐個詞對應到像素

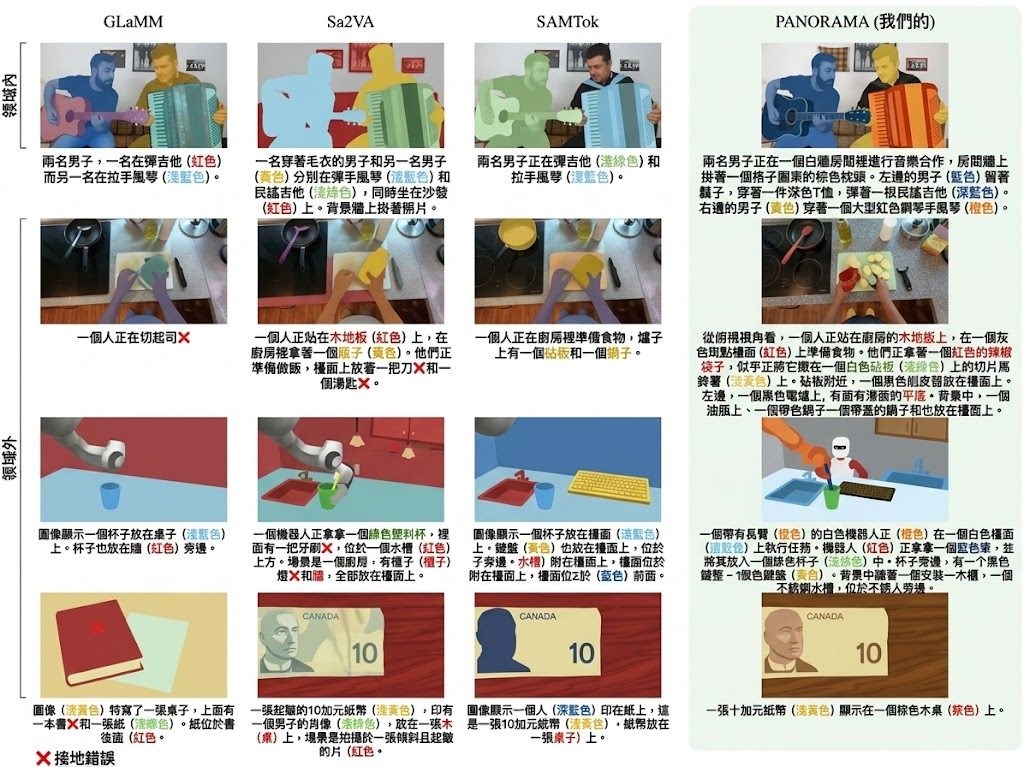
Inria 與捷克理工合作開源的 PANORAMA,能為整個場景生成描述並把每個實體精確對應到像素遮罩,並同步釋出近全幅覆蓋的人工標註基準 PanoCaps。

PANORAMA compared with prior grounded captioning models, in and out of domain

現時的視覺語言模型(VLM)寫得出漂亮描述,卻往往無法把句子裡的物件真正對到像素,導致「說的是一回事、畫出來又是另一回事」。PANORAMA 想處理的是 panoptic grounded captioning:模型要不只描述前景物件,還要連背景區域都講清楚,並為每個提到的實體給出像素級遮罩。

做法上,它把短語定位(phrase grounding)重新定義成「從短語條件化的遮罩提案池中挑選」。預訓練分割器根據每個短語的上下文表徵生成候選遮罩,模型再從中選出真正對應的那一塊,無論是單一區域、多個實例,或根本沒有對應都涵蓋在內。這樣把分割與語言生成用同一介面聯合訓練,文字與遮罩就不再各說各話。

配套資源同樣在 Hugging Face 公開:PanoCaps 約有 3.5K 張圖片、34K 個遮罩和 17.9K 條獨立短語,參照區域覆蓋近 99% 像素;COCONut-PanCap-Recaptioned 提供 118K 張訓練圖的重新標註;MRSeg-Referring-Expressions 則帶來約 101K 條改編自 SegLLM 的單輪指代表達。評估端還提出 generalized Panoptic Quality(gPQ),把文字與遮罩的一致性納入單一指標。實驗結果顯示,PANORAMA 在 PanoCaps 上整體定位表現最佳,並在多個像素級任務上與專門模型持平或更強。

這個項目適合以下情境:

  • 做機器人感知或場景理解的研究團隊:需要模型同時提供自然語言描述與實例級遮罩,減少對接多個模型的成本
  • 訓練數據匱乏的多模態團隊:PanoCaps 與兩份重新標註集合計逾十萬張圖,可直接用作訓練或微調
  • 需要精細指代(referring expression)任務的工作:MRSeg-Referring-Expressions 提供多粒度指代表達,比單一句式更有助泛化
  • 對 VLM 評測有疑慮的研究者:gPQ 指標把文字與遮罩綁定,避免「描述漂亮但對錯位置」的高分陷阱

對想直接跑實驗的人,訓練、微調與評估程式碼已隨倉庫釋出;模型權重則透過 Hugging Face 取得。如果你關心的是 VLM 能否真正「看懂」場景而不只是寫句子,這套統一框架比多數把描述與分割拆開處理的方案更接近落地需求。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Image, 框架, 庫, Dataset 數據集

Hypit:把爆款短片變成可換臉的模板

Hypit 是一套開源影片克隆工具,主打把 TikTok、Reel 或 Short 變成可重用的版面,換掉主持人、產品、開頭與長寬比,就能快速產出多個變體做投放測試。

Hypit

短片團隊最常遇到的卡位,是手上有一條跑出來的素材,卻要趕在疲勞前把它複製成十幾條變體測試新 Hook。Hypit 想解決的正是這個工序:丟一條影片進去,它會拆解成鏡頭、字幕、B-roll、效果這些可組合的工作流部件,而不是只輸出一份腳本分析。對做付費社交投放的人來說,這意味著可以從 Meta Ad Library 複製一條已經贏過的廣告,換掉商品與開場就當日出 50 條 Hook 變體;等兩星期素材疲勞,再用同樣的主體版型換新開頭,主體片段完全保留。

它和一般「AI 影片生成器」差別在定位:生成式模型負責補上會變的部分,Hypit 則是負責把會變跟不會變的部分拆乾淨、串起來。每個組件都能被替換或 fork,使用者不必動到字幕或剪輯邏輯。商業模式上,項目本身是開源(Apache-2.0 with conditions),沒有平台座位費或浮水印,模型服務費則看你接的是哪一家。

技術偏向給內容團隊或 growth marketer 自建的工程師整合進既有管線。素材來源涵蓋 TikTok、Reel、Short,也可以從 Meta Ad Library 抓一支跑得好的 paid ad 當模板。對需要大量 A/B 測試 hook、不同市場語言切版、或長線養帳號的工作流來說,這種「一次結構、N 次變奏」的思路,比每次從腳本重頭來要省事不少。

我用AI 10分钟复刻爆款视频:Hypit详细教程,直接拆成可编辑工程
  • 不是單次生成,而是變奏生產線:同一支片可以反覆換主播、產品、語言、長寬比
  • 組件化設計:字幕、B-roll、效果都能獨立替換,不影響整體結構
  • 開源但非全免費:項目本體免費、無浮水印;模型推理依賴外部服務計費
  • 適合 paid social 與 viral clone 場景:Meta Ad Library、TikTok、Reel 都能當模板來源
  • 技術門檻在整合端:需要 Node.js + TypeScript 環境,較適合有工程支援的團隊

GitHub

Categories: 開源, AI productions, Video, 工具, 庫, Skill 技能

BVB 用 影片內容令 AI 自動轉為 Blender 3D 場景

BVB 拋開選擇題,要求 AI 代理直接用 Blender 重建 288 段真實室內影片,從程式碼品質判斷它到底有冇真正理解畫面內容。

BVB logo

現時大多數影片理解 benchmark 都係問 AI 「張圖入面有幾多張椅」,但 BVB(Blender-VideoBench)行另一條路:畀 AI 睇一段室內影片,然後叫佢自己寫 Blender 腳本,把場景、鏡頭動線逐個 primitive 砌返出嚟。如果代理人交到一個可以重新開啟、可以渲染嘅 .blend 檔,代表佢真係睇明條片。

每個代理會都被困喺同一個 Blender 4.2 Docker 沙盒入面,淨係可以用 bash 同 frames,仲有共享成本上限。禁止使用任何外部素材庫,幾何體全部由代理自己用基本操作砌出嚟。呢種「同條件競技」設計解決咗以往影片 benchmark 靠選擇題容易被 prompt hack 或者背答案嘅問題。

數據方面,BVB 用咗 ARKitScenes、ScanNet、ScanNet++ 嘅 288 段室內影片,配合 5,130 條時空題目,並涵蓋 10 個模型家族、共 51 個配置。評分用兩條軸:Dual VQA 睇重建場景保留幾多影片入面嘅時空事實;Latent Similarity 就用凍結影片 embedding 對比重建結果同原片嘅感知距離,再以平方根均值合成綜合分數。

對做空間智能、機器人感知或者影片理解研究嘅團隊嚟講,呢個 benchmark 提供咗一個更貼近「代理人真係要喺軟件入面操作世界」嘅測試場景。視頻生成、動畫製作或者世界模型團隊亦可以直接借用 Mini-BVB harness 喺自己 pipeline 度做壓力測試。

團隊結果顯示,最強配置喺 Latent Similarity 做到 88.6,但 Dual VQA 仲有明顯差距,代表現時頂級模型仲未做到「理解」同「重建」兩條線同步推進。呢個落差本身就係 BVB 想凸顯嘅訊號:識答題未必等於識建模。

重點摘要

  • 288 段真實室內影片,全部來自 ARKitScenes、ScanNet、ScanNet++ 嘅 held-out split。
  • 51 個代理配置橫跨 10 個模型家族,統一跑喺 Mini-BVB 沙盒同成本上限下。
  • 禁止使用外部素材庫,逼代理人由 Blender primitives 自己砌幾何。
  • 評分用 Dual VQA 加 Latent Similarity 兩條軸,避免單一指標偏廢。
  • 目標係可執行、可重新渲染嘅 .blend 檔案,而唔係文字描述或者單張圖。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, Embedding, 視覺模型, 多模態模型, 世界模型, Qwen, OpenAI, Gemini, Video, 軟件, 庫, Anthropic, 動畫, Dataset 數據集

Ambient CSS 用物理光照重新定義 box-shadow

一個以光線方向驅動嘅 CSS 工具庫,唔再需要逐個元素微調 shadow-sm、shadow-lg,所有陰影同邊緣高光會跟住同一個光源自動生成。

A hardware panel raytraced in Blender, rotating to a flat-on view, then wiped across to reveal the same panel rendered b

Ambient CSS 最大嘅改變係將 UI 表面當作真實物料嚟處理。傳統嘅 CSS 陰影階只係裝飾,卡片用 shadow-lg、掣用 shadow-sm,兩個元素之間並無物理關係。呢個工具庫引入咗 key light 同 fill light 兩盞光源嘅概念,所有陰影、邊緣高光、表面漸層都由同一組 CSS 自訂屬性推算出嚟。當你改變容器嘅光線方向,底下每一個子元素都會即時跟住調整,唔使逐個改。

引擎將每個元素拆成五層 box-shadow 合成:方向性嘅 drop shadow、面對光源嘅 fillet 高光、背光邊嘅 fillet 暗影、斜面嘅 chamfer 高光同暗影,加埋材質表面嘅漸層。表面類型分 flat、concave、convex 三種弧度,邊緣可以揀 chamfer、fillet 或 groove,仲有 matte、shiny、glass 呢幾種材質,最後用 elevation 0–3 控製投影高度。所有參數都係用 Blender raytrace 嘅結果做標定。

對一般開發者嚟講,安裝同整合都幾直接。純 CSS 版可以喺 HTML 直接掛入,框架版本分別支援 Tailwind、PureCSS、React 同 React-Bootstrap。命名空間用 .ambient 做容器、再用 .amb-surface、.amb-chamfer-2 等工具類調整細節,常用距離值跟 12/20/32 mm 嘅間距比例,避免頁面入面出現零碎數值。Demo 頁面將 Blender raytrace 同 live DOM 並排展示,幾容易睇出差距。

重點摘要

  • 將 UI 視為真實光照環境,所有陰影、高光、表面漸層由統一光源參數衍生
  • 每個元素由五層 box-shadow 合成,包含 drop shadow、fillet 同 chamfer 嘅高光與暗影
  • 表面類型(flat/concave/convex)、邊緣類型(chamfer/fillet/groove)、材質(matte/shiny/glass)同 elevation 0–3 可自由組合
  • 參數以 Blender raytrace 結果做物理標定,唔係靠肉眼調較 blur 值
  • 支援 PureCSS、Tailwind、React、React-Bootstrap 幾種整合方式

對需要管理大量卡片、面板、控制台介面嘅團隊嚟講,呢套系統可以避免每個設計師各自調較 shadow 嘅問題。對於追求像素級一致嘅硬件風格介面、儀表板或產品頁,效果會特別明顯;但若然你嘅介面本來就偏好扁平設計、唔需要表面弧度嘅呈現,呢層物理光照帶嚟嘅額外 box-shadow 開銷同學習成本就未必值得。

項目主頁 · GitHub

Categories: 開源, 框架, 工具, 庫, UI/UX

Page 10 of 17
1 … 8 9 10 11 12 … 17