CANOPY 讓多模態 RAG 按證據壓縮上下文

CANOPY 會在文字、表格及影片內逐區域保留證據,減少干擾內容,同時避免剪走理解所需的上下文。

Og image

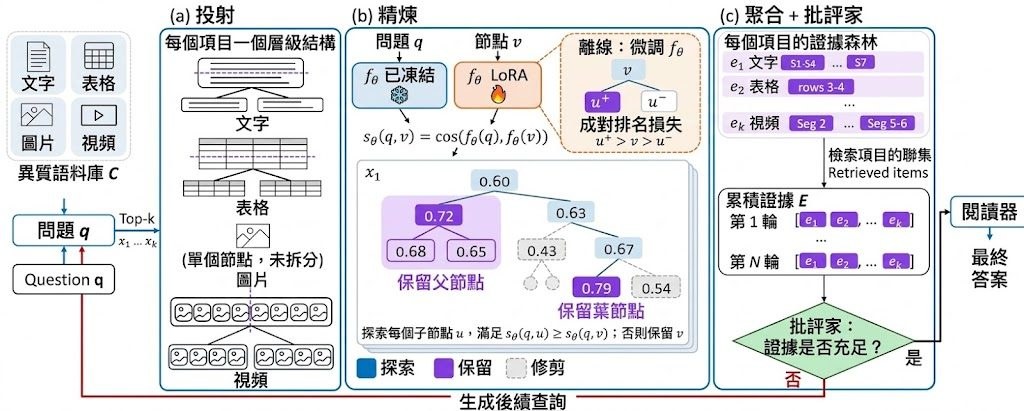
面對一段很長的文章、一張表格或一段影片,問題通常只需要其中一小部分證據,但過度保留會浪費讀者的上下文,剪得太細又可能失去理解線索。CANOPY(Canonical Projection over Hierarchy)是 POSTECH 提出的多模態 RAG 後檢索證據壓縮框架,按項目內不同區域決定保留範圍。

CANOPY 會把每個檢索項目整理成層級結構,再以經 gold evidence 微調的 node encoder,按照查詢評分不同區域。系統會比較子區域與父區域的相關程度,保留句子、表格列、關聯文字或影片片段等合適粒度,而非為整個項目套用單一截取規則。

保留的證據不足以回答問題時,critic 會要求針對性追加檢索;新找回的項目同樣先經壓縮,再加入讀者輸入,減少無關內容反覆累積。這個設計亦處理了壓縮本身無法補回「從未檢索到的證據」這項限制。

  • 在五個 QA benchmark、包含 3,300 萬個異質項目的語料庫上,平均答案準確率高於參與比較的檢索基線。
  • 消融結果顯示,多跳問答的準確率提升主要來自追加檢索。
  • 在未經路由的 Qwen3-VL-8B-Instruct 讀者設定中,證據 token 輸入量減少 14.2% 至 27.7%。
  • 壓縮後答案準確率保持相若,適合需要同時處理文字、表格及影片的 RAG 工作流。

CANOPY 的價值不在於單純縮短檢索結果,而在於讓每個項目內的保留範圍跟隨證據位置及上下文需要變化。它仍受初始檢索品質限制,但對多跳查詢和長內容閱讀,可在保留可解釋線索的同時降低 reader 的輸入負擔。
項目主頁

Categories: AI productions, RAG, 多模態模型, Qwen, Video, 框架, 庫, Dataset 數據集

Spatial Memory Intelligence:讓世界模型記住空間關係

長影片生成愈往後,舊畫面愈難整理,也容易出現空間前後不一致。SMI 以理解能力管理長期空間記憶,現時仍未公開程式碼與模型權重。

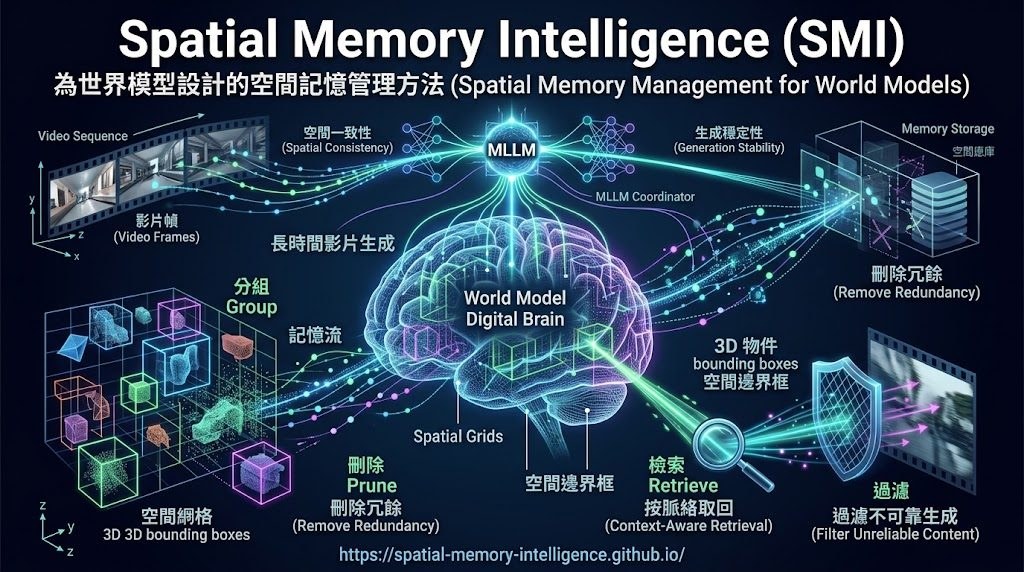
SMI overview: organizing spatial memory, retrieving relevant observations, and improving consistency and stability.

長影片生成要延續物件位置與場景結構,不能只靠不斷累積舊觀察;記憶太多會帶來冗餘,也可能把不可靠內容帶進後續生成。Spatial Memory Intelligence(SMI)是為世界模型設計的空間記憶管理方法,目標是改善記憶精簡度、空間一致性與生成穩定性。

SMI 以具語義與空間理解能力的多模態大型語言模型(MLLM)協調四項操作:把相關觀察分組、刪除群組內冗餘內容、按近期脈絡及下一步動作取回記憶,並過濾不可靠的生成觀察。它不只整理記憶,也會在生成過程中更新及提取資料,適合研究長時間影片生成與世界模型記憶管理的團隊。

項目網站提供 HY1.5 與 Wan2.2 的同步影片比較,主要對照 SMI 與 Base;部分案例亦列出 FramePack、Deep Forcing、MoC、VMem 及 MemFlow。紅框標示部分空間或結構不一致之處,方便檢視案例,但目前沒有公開可供核對的量化指標,不能單靠示範影片判斷改善幅度。

  • 記憶管理涵蓋分組、精簡、檢索與可靠性過濾。
  • 檢索會考慮近期上下文及下一個使用者動作。
  • 網站可觀看 HY1.5、Wan2.2 的影片比較。
  • 訓練、推理及評估程式碼、資料集與模型權重仍在準備發布。

目前 GitHub 儲存庫主要提供項目介紹與示意圖,尚未能據此安裝或自行重現結果。研究人員可以先查看網站示範及論文,待程式碼、資料集和權重公開後,再測試它能否在不同世界模型與長片段生成任務中維持空間一致性。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 南京大學, 阿里巴巴, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, Video, 香港, 庫, Dataset 數據集

ProAR 讓影片模型先想目標再生成

ProAR 把自回歸影片生成變成視覺推理流程,兼顧最終目標與中間步驟的合理性。

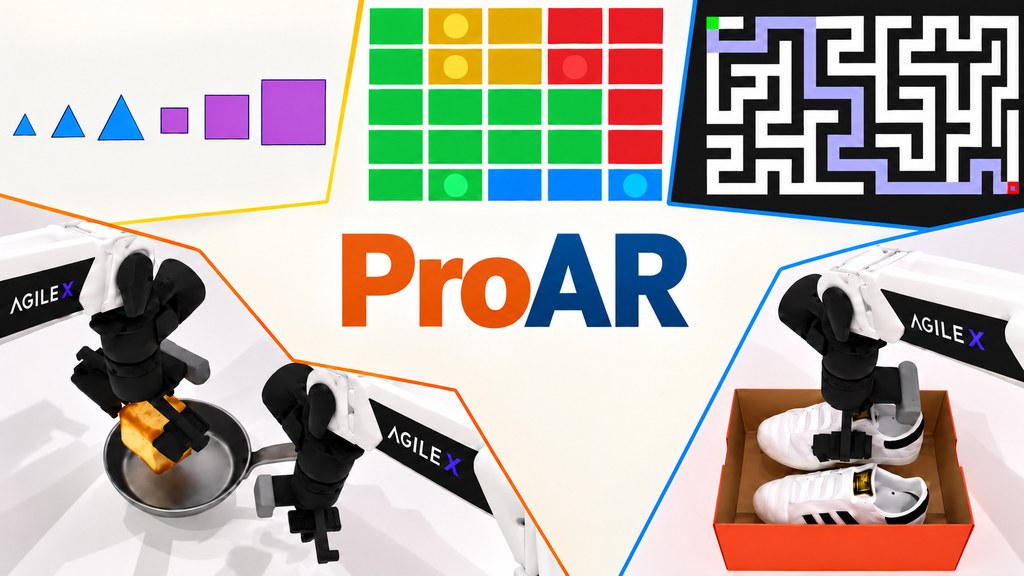
ProAR overview

當影片模型只按過去畫面逐步預測,畫面即使局部合理,也未必能完成指定任務。ProAR 屬於自回歸影片模型項目,透過 prospective reasoning 預測未來視覺狀態,處理長程目標與中間轉換容易失控的問題。

ProAR 以 Wan2.2-TI2V-5B 作為共享 backbone,加入兩條互補機制:outcome guidance 會一同預測未來 goal frame,讓目前 chunk 參考目標信念;transition guidance 則在訓練期間利用 predictor,令目前 hidden states 對齊乾淨的 next-chunk representation。前者偏向長距離規劃,後者補足短距離的狀態銜接。

• Outcome guidance 幫助生成結果符合任務目標
• Transition guidance 鼓勵中間步驟遵守時間及物理邏輯
• 推理時不需要真實未來畫面,訓練用 predictor 會移除
• 項目提供模型 checkpoint、ProAR-test 數據集及 VBVR-10Tasks 實驗配置

要測試項目,需要 Python 3.10、PyTorch 2.8.0,並把 Wan2.2-TI2V-5B 權重、VAE、T5 編碼器及 tokenizer 放到指定本地路徑;flash-attn 屬於可選的加速元件。這套流程較適合研究視覺推理、物理推演及 embodied intelligence 的團隊,未必是即裝即用的影片創作工具。

提供的資料確認了 AR 與 ProAR checkpoint,以及 VBVR-10Tasks 和測試數據集,但未列出足夠的數值結果,難以單憑儲存庫內容判斷提升幅度。推理時間會增加,換來模型在生成前預測目標及未來轉換;取捨是否合理,要視乎任務是否重視步驟有效性多於生成速度。

項目主頁 · GitHub · 模型

Categories: 開源, 香港理工大學, AI productions, 模型, 模型訓練, 微軟, Video, 香港, 工具, Python, 庫, Dataset 數據集, Tokenize

MotorMind-Code:通用視覺語言模型零樣本操控機械人

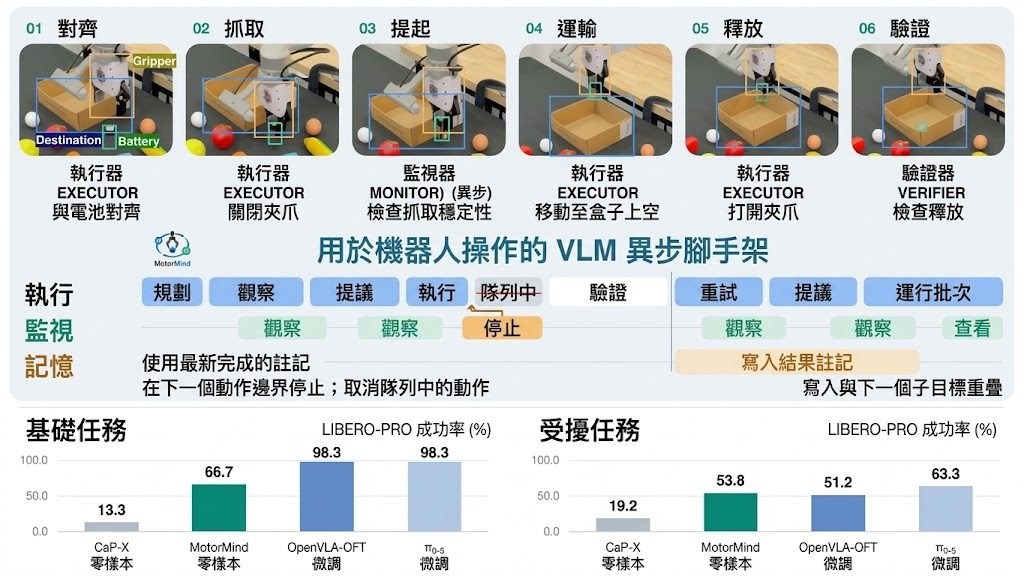
MotorMind 讓通用視覺語言模型透過中階動作控制機械人,並用即時回饋檢查進度、修正失誤。它在模擬環境和真實機械人上測試,毋須針對任務訓練策略。

MotorMind overview: robot execution frames, asynchronous monitoring, and manipulation results

要令機械人按指示完成操作,模型不只要看懂畫面,還要判斷下一步、確認動作有否奏效。MotorMind 是一個機械人操控研究項目,讓凍結的通用視覺語言模型(Vision-Language Model,VLM)提出中階動作,再由執行框架把決策交給機械人,並以量度到的回饋檢查結果;過程不需針對特定任務訓練策略。

模型不會一次過決定整個操作流程。MotorMind 會並行監察機械人執行情況,確認子目標是否完成;若觀察到的結果不符預期,便可修正動作、恢復執行或重新規劃。這種做法把 VLM 的推理與機械人控制接起來,但不依賴專用動作專家、技能 API 或動作規劃工具。

項目在 LIBERO-PRO 模擬環境及 xArm6 真實機械人上測試,亦以 240 條視覺問題評估模型選擇動作、判斷進度和確認子目標完成的能力。評估結果指出,動作選擇是各模型較難處理的部分;因此,即使加入持續監察與結果核實,也不能視為每次都能正確控制機械人。

現時 GitHub 儲存庫尚未提供程式碼或執行指引,項目預告會在 10 月 15 日前發布程式碼。目前可先參考研究介紹及其模擬、真機測試結果,待程式碼和設定方法公開後,才適合自行重現或接駁機械人。

  • 不需為特定操作訓練專用策略,改以通用 VLM 提出中階動作。
  • 執行期間持續核對觀察結果,支援修正、恢復及重新規劃。
  • 測試涵蓋 LIBERO-PRO 模擬環境與 xArm6 真實機械人。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, API, Robotic, 框架, 工具, 庫, Skill 技能

GTR 以循環架構壓低高解像度視覺推理成本

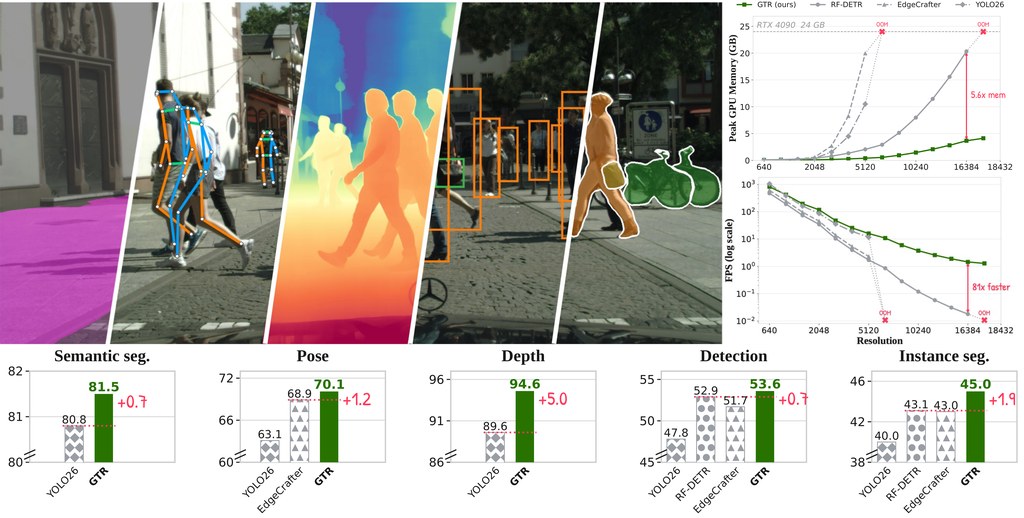
GTR 以無 softmax 的循環式視覺骨幹處理多種密集預測,在速度與精度之間尋找更實用的平衡。

teaser

高解像度影像令全域 softmax attention 的計算量隨 token 數量平方增加,GTR 以無 softmax 的循環式視覺骨幹處理這個瓶頸,支援物件偵測、分割、姿態、深度及定向偵測。它屬於視覺模型,實際解決同一組影像特徵如何兼顧多種密集預測任務與推理速度。

GTR 由 12 層 Gated Linear Attention(GLA)組成,每層輪換二維掃描方向,再配合加入 3×3 depthwise convolution 的 Spatial SwiGLU,補足鄰近 patch token 的局部資訊。模型以 stride-16 單尺度特徵圖運作,並透過輕量三尺度 projector 和 query-based head 輸出不同任務所需結果。

  • 以單次平方 L2 loss,將學生模型最終 patch token 對齊 detection-specialized DINOv3 teacher
  • 同一個 GTR backbone 支援六類密集預測任務
  • RTX 4090、FP16、batch 1 下,GTR-L 達到 58.9 COCO box AP,median forward pass 為 1.908 ms
  • 提供 chunkwise CUDA operator,亦支援 TensorRT 部署到 DRIVE AGX Thor

倉庫包含環境準備、資料處理、訓練、評估、推理及 TensorRT 部署流程,適合研究高效視覺骨幹、車載感知或需要多任務共用模型的團隊。代價是 CUDA 專用算子及編譯流程提高了硬件依賴;官方延遲數字來自 RTX 4090 或 DRIVE AGX Thor 的特定設定,換用其他裝置時仍需重新量度。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 模型, 視覺模型, 模型訓練, NVIDIA, Image, 香港, 庫

ScientificSlop:AI 論文不只要讀得順,也要檢查證據是否接得上

SciSlop 把焦點放在 AI 論文的論證、結構與研究材料,並以 390 組人類與 AI 論文測試能否辨認科學內容中的空洞之處。

Repository image for yerimoh/ScientificSlop

一篇論文即使句句通順,論點、方法和證據仍可能接不上。SciSlop 是一套衡量 AI 生成論文科學內容品質的評估工具,從結構、論證和研究材料三個面向檢查六種問題,而不是只判斷文字像不像 AI 所寫。

配套的 SciSlopBench 收錄 390 組 AI 生成論文與人類撰寫論文,讓研究者比較不同評分方法分辨兩者的能力。已釋出的分數中,SciSlop 的配對準確率為 0.859;作為基準的 Binoculars 為 0.687。這是特定測試集上的結果,不能直接解讀成工具能判定任何論文真偽。

另一部分 SciSlopHarness 會引導固定的大型語言模型修改論文,但只在實驗紀錄能支持修改時才動筆。這個限制有助避免模型為了讓文字看起來更好而擅自改變研究主張;不過,現有說明沒有提供足以判斷修改品質的完整數字。

儲存庫同時提供基準資料、評估程式、比較用的偵測器與自動審稿系統,以及分析 2017 至 2026 年 ICLR 審稿分數和決策的程式。資料以三個 Parquet 表格釋出;安裝 Python 依賴後,可先讀取分數表重算配對準確率與 AUROC,再按文件流程重跑部分確定性指標。GPU 套件屬可選項,模型相關指標則可能需要外部模型呼叫。

  • 六項指標涵蓋結構、論證與研究材料。
  • SciSlopBench 包含 390 組配對論文。
  • 公開分數中的配對準確率為 0.859,高於 Binoculars 的 0.687。
  • SciSlopHarness 只在實驗紀錄支持時才修改內容。

對研究團隊而言,這套工具適合用來檢查 AI 輔助寫作是否削弱論證連貫性,也能作為研究論文評估方法的測試材料。項目應視為研究用途,不能取代專家對方法、證據及引用的審閱。

項目主頁 · GitHub

Categories: 開源, Embedding, 模型, 工具, Python, 庫, Dataset 數據集

mg-styles-15:AI 寫出 15 種動態設計短片

Claude Opus 5.5 以程式碼生成畫面、動畫、音樂與音效,並公開提示詞和完整源碼。

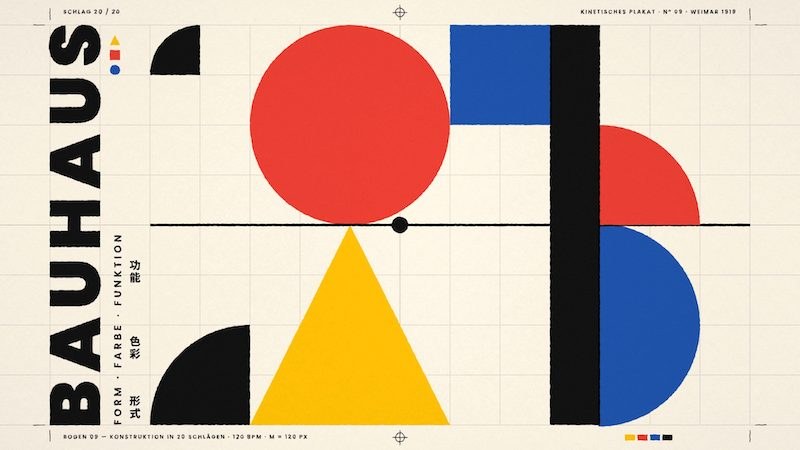
The showcase page: the Frame-by-Frame film next to its style notes, with the prompt open below

由一段提示詞開始,Claude Opus 5.5 便能寫出 15 支各具風格的 10 秒動態設計短片,連畫面、動畫、配樂和音效都由程式碼生成。這個開源項目同時提供成片、風格說明、完整提示詞和源碼,實際解決的是把視覺創意轉成可重現瀏覽器渲染流程的問題。

每支片本質上是一個能按時間繪製畫面的網頁,以背景執行 Chrome 逐幀截圖,再由 ffmpeg 合成影片和音軌;3D 作品則額外使用 Blender。使用者需要 Node、Chrome 和 ffmpeg,複製指定提示詞後可修改故事、品牌、配色、尺寸和時長,亦可用 rubric.md 交由另一個 AI 評審再迭代。

• 15 種風格,涵蓋逐格動畫、等距 2.5D、像素藝術、液態動態及 9:16 字幕作品
• 畫面每次重新生成未必相同,原作經過多輪修訂,單次執行通常達不到相同完成度
• 音效腳本具確定性,但只有 4 支能在指定環境精確重現原音軌,其餘 11 支可能因數值庫版本而有差異
• 字體未隨倉庫提供,缺少指定字體會令文字造型與原片不同

對內容創作者、動態設計師和想研究 AI 輔助編程的人,這個項目更像可拆解的製作案例,而不是按掣即出的成品工具。它把創意、提示詞、瀏覽器渲染和聲音合成放在同一條可閱讀的流程內,方便比較不同風格如何透過程式結構呈現;代價是需要自行處理環境、字體和多輪修訂。

項目主頁 · GitHub

Categories: 開源, AI productions, Video, Audio, 提示詞, 工具, Content Creator, 3D, 庫, 編程, Anthropic, 動畫, 音樂

OneStreamer 讓串流影片懂得記憶與適時回應

影片畫面離開視窗後,OneStreamer 仍可保留具時間線索的證據,並自行判斷何時已有足夠資訊回應問題。

OneStreamer

直播影片一閃即逝,畫面離開模型的視覺視窗後,之後的提問仍可能需要引用那些細節。OneStreamer 屬於串流影片大型語言模型,處理的正是記錄證據、理解新畫面,以及在資料足夠時主動回應之間的取捨。

它以 Qwen3-VL-4B-Instruct 為基礎,OneStreamer-4B 透過 Proactive Hierarchical Caption Memory(PHCM)保存局部細節和已完成事件摘要,再配合近期畫面作答,減少重看歷史影片特徵的需要。Proactive State Transition Learning(PSTL)則保留輸出錨點,挑選具代表性的狀態變化與持續狀態,只有 27.5% 標註狀態 tokens 需要監督。

你可從 Hugging Face 取得 OneStreamer-4B 模型及 OneStreamer-1M 數據集,配合串流影片、問答或字幕資料測試;儲存庫目前提供模型、數據集和示範頁面,但完整推理指令未在提供內容中列出,因此部署前仍需確認執行框架、硬件需求和輸入格式。OneStreamer-1M 合併串流字幕、串流 QA 及整理後的開源資料,共有 1.16M 筆互動記錄。

八項涵蓋線上感知、記憶和主動回應的基準測試中,OneStreamer-4B 在比較方法中取得最高的整體結果;這對需要持續觀看教學、監控或家庭影片的團隊較有參考價值,但生成式記憶仍可能受字幕品質、延遲和錯誤累積影響。

  • PHCM 同時保留局部細節與完成事件摘要
  • PSTL 針對回應時機和重複等待狀態作訓練
  • 模型、數據集及示範頁面均已公開
  • 八項基準測試涵蓋感知、記憶與主動回應
  • 適合研究串流影片理解及長時間上下文的團隊

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 南京大學, AI productions, 模型, 視覺模型, 模型訓練, Qwen, Video, 框架, 教學, 庫, Dataset 數據集

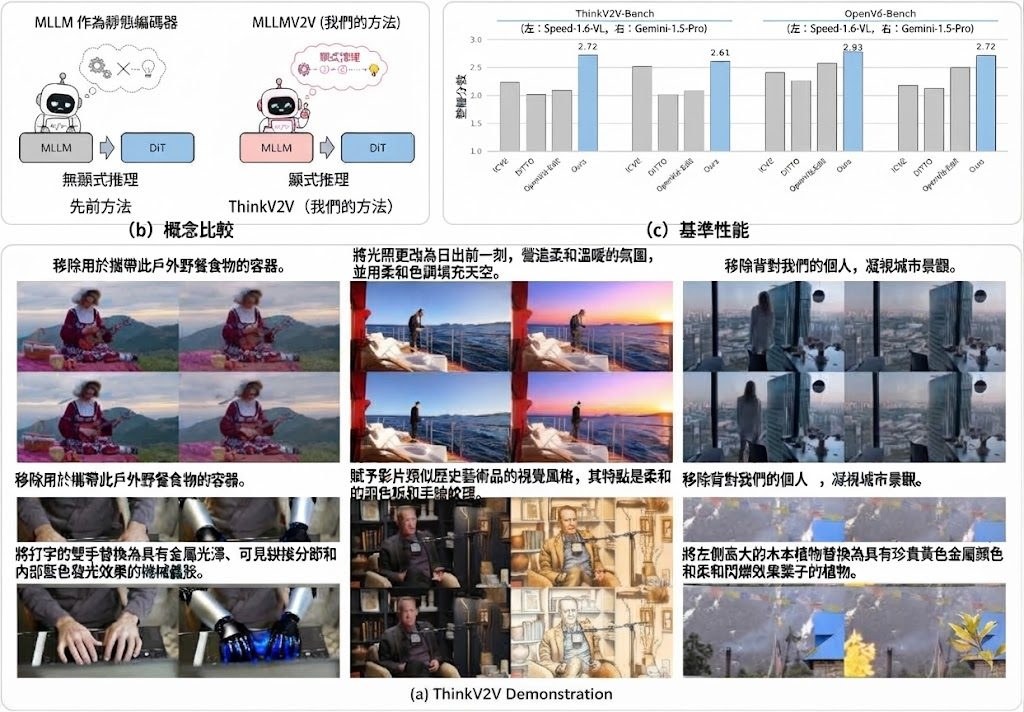
ThinkV2V 讓影片編輯先思考再生成

ThinkV2V讓多模態模型先理解影片中的因果與隱含意圖,再交由DiT完成較複雜的指令式影片編輯。

ThinkV2V Overview

面對「按場景關係修改影片」這類指令,單靠文字語意對齊往往不足。ThinkV2V屬於推理導向的影片編輯框架,讓Multimodal Large Language Model(MLLM)先分析來源影片與指令,再把推理結果轉成DiT影片生成器可用的條件訊號,處理物件關係、時間變化及隱含意圖。

MLLM並非只擔任靜態語意編碼器,Qwen3-VL-8B-Thinking負責理解和推理,connector則把相關特徵對齊至DiT條件空間;原始文字嵌入、MLLM隱藏狀態及來源影片的VAE特徵會一同交由ThinkV2V-5B執行編輯。訓練由穩定的基本編輯逐步過渡至高解像度及推理密集案例,推理階段亦會生成多個候選計劃,再由MLLM篩選較可靠的一個。

  • 適合場景:需要根據時間脈絡、物件互動或因果關係修改影片的工作流程。
  • 評估資源:提供ThinkV2V-150K訓練數據集及ThinkV2V-Bench,後者包含308個樣本和5類推理密集編輯,預設支援720p。
  • 執行條件:Python 3.10、CUDA 12.x、PyTorch 2.6.0,並以torchrun或accelerate進行多GPU運算。
  • 資料限制:OpenVE-HQ-1M與ThinkV2V-150K主要是metadata釋出,下載腳本不會一併取得OpenVE-3M影片資料。

項目需要同時準備ThinkV2V、Qwen3-VL-8B-Thinking、Wan2.2-TI2V-5B及Lucy-Edit-Dev等權重,並按儲存庫指定的data與weights結構放置,較適合有CUDA多GPU環境及影片生成經驗的研究團隊。它相較只把MLLM當編碼器的做法,換取更深入的指令理解,但推理、多候選篩選及多模型權重亦會增加顯存、時間和安裝成本;儲存庫提供模型、資料集與基準測試,卻未在提供內容中列出可直接引用的量化領先幅度,不能只憑架構宣稱全面勝過其他影片編輯器。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 字節跳動, AI productions, 模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, 框架, 香港, Python, 庫, Dataset 數據集

HybridCUA 讓 Agent 懂得何時用命令列

浙江大學、北京大學與清華大學團隊,讓 Computer-use agents 在 GUI 操作與 CLI 指令之間作出選擇,減少冗長點擊流程及連鎖錯誤。

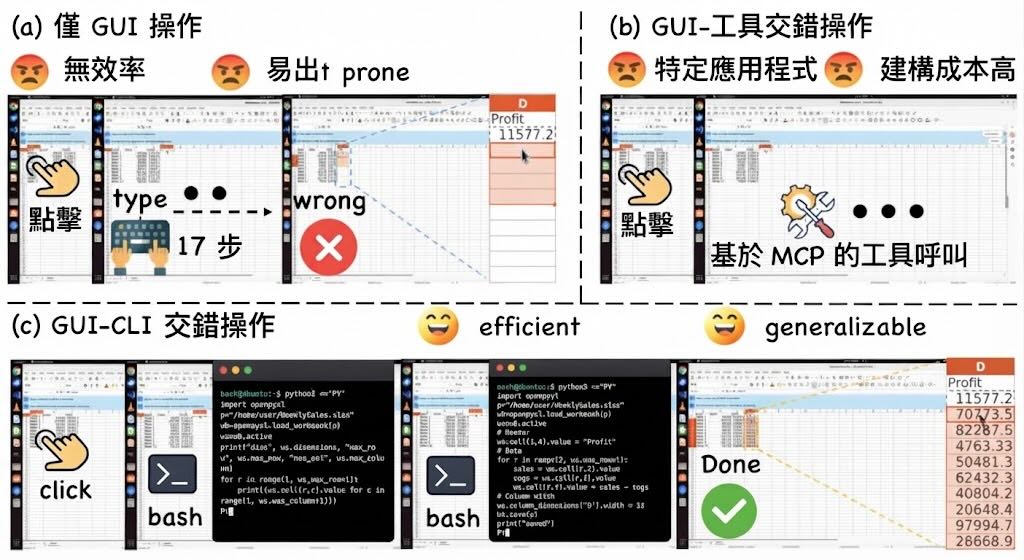
浙江大學、北京大學與清華大學的研究團隊,將 CUA (Computer-use agents) 從單靠滑鼠鍵盤操作,帶到 GUI 與 command line interface(CLI)協作的工作方式。HybridCUA 屬於訓練框架及模型項目,處理的是代理知道可以用 shell 之後,仍未能判斷何時使用、如何使用的問題。

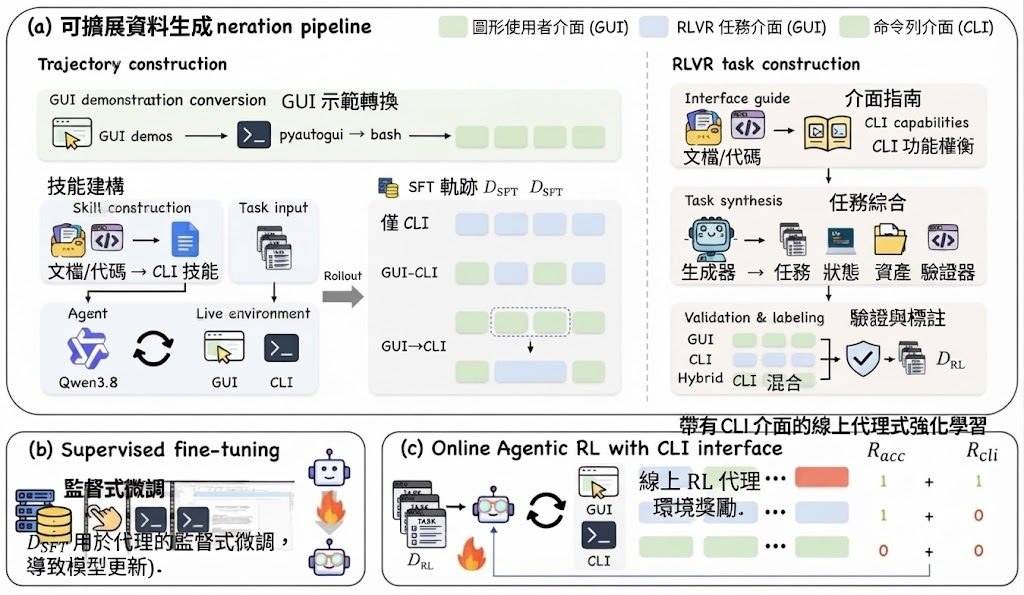
連串的 GUI 操作可以由一條命令取代,但 CLI 暴露給未受訓練的代理,反而令 OSWorld 準確率下降 2.5 至 11.5 個百分點。HybridCUA-8K 收集 GUI only、CLI only,以及交錯使用兩者的軌跡,再配合 supervised fine-tuning 和 CLI-aware rewards,訓練 HybridCUA-9B 選擇較合適的操作方式。

HybridCUA pipeline: (a) scalable generation of GUI-only, CLI-only and interleaved trajectories plus annotated RLVR tasks

• HybridCUA-9B 在 OSWorld 達到 53.6%,較基礎模型高 14.8 個百分點
• 平均每項任務使用 14.0 步,並可轉移至 OSWorld-MCP 及 Windows
• HybridCUA-8K 包含 5K 條混合軌跡及 3K 個已驗證 RLVR 任務
• CLI reward 分為 trajectory level 與 step level,分別鼓勵成功完成及減少失敗指令成本

儲存庫以 env_infra、online-rl 和 site 分開環境平台、GRPO 訓練流程及項目網站;前兩者透過 HTTP 的 /v1/sessions 協作,訓練器毋須自行啟動 VM 或容器。README 提供安裝腳本及 GPU、nvcc、Ray 等環境要求,但模型仍標示為 coming soon,因此目前較適合研究 Computer-use agents、GUI automation 或跨平台代理訓練的團隊閱讀資料集與訓練架構。

結果在 WindowsAgentArena 提升 4.0 個百分點,OSWorld-MCP 達 47.1%,Windows 達 36.0%,顯示 GUI 加 CLI 的方法具備一定跨平台能力;不過項目仍依賴複雜的分散式訓練環境,未提供即時可下載模型,距離一般使用者直接安裝仍有距離。

項目主頁 · GitHub · 模型

Categories: 開源, 北京大學, 清華大學, Agentic, MCP, 模型訓練, 庫, Dataset 數據集

Page 8 of 17
1 … 6 7 8 9 10 … 17