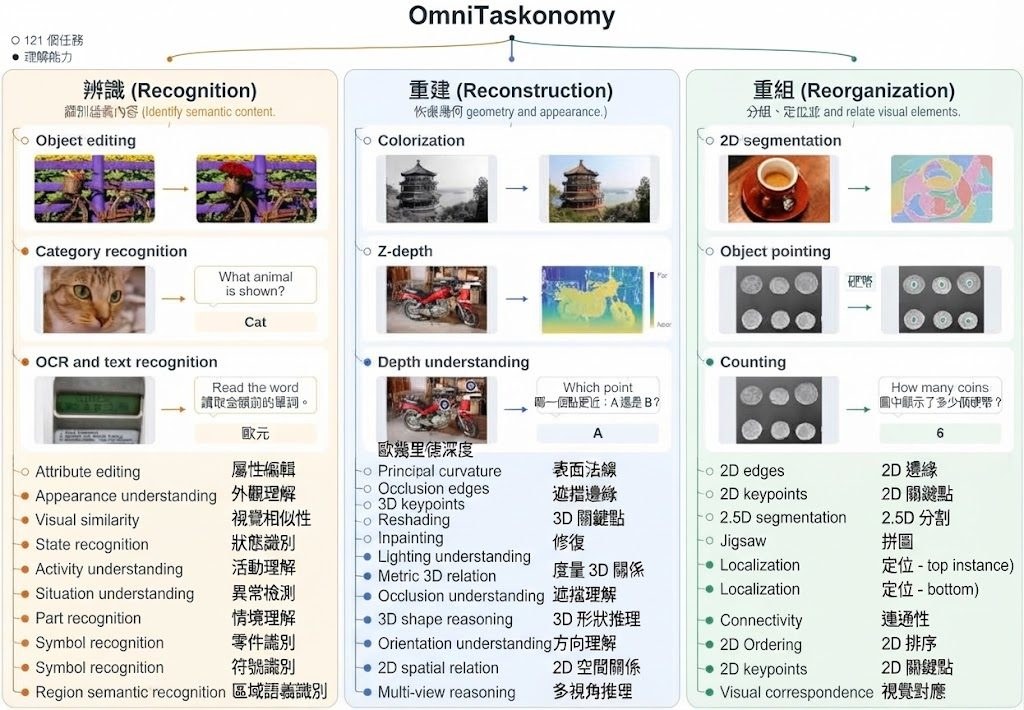
同一個多模態模型既要生成圖片,又要讀懂圖片,兩種能力未必會自然互相提升。OmniTaskonomy 是一個研究型 benchmark 與資料集項目,透過 Image-to-Image(I2I)和 Image-to-Text(I2T)配對任務,測試視覺生成訓練何時能改善視覺理解。
項目沒有把生成與理解混成單一分數,而是比較六種訓練流程,包括只做 I2T、先做 I2I 再做 I2T(I2I → I2T),以及從一開始混合兩種目標。結果顯示,先以 I2I 更新與理解能力共用的權重,再進行 I2T 微調,通常比同步訓練或凍結共用權重更穩定;I2I 資料增加時,I2I → I2T 和 I2I → Mixed 的收益亦持續上升。
從 GitHub 儲存庫了解實驗流程,並配合 Hugging Face 上的 OmniTaskonomy 資料集重現配對任務。項目適合研究多模態模型訓練、視覺能力轉移及 curriculum learning 的團隊,但並非即裝即用的影像工具,重現結果仍要配合模型、訓練資源和原有設定。
幾個結果有助判斷它的研究價值:
– 定位與物件指向對 counting 的增益最大。
– 深度及 surface-normal prediction 可改善 metric 3D relation。
– 各種理解能力的 mean alignment 與 mean transfer 相關係數為 r = 0.795。
– 133 個 source–target pair 的相關係數降至 r = 0.529,反映任務之間的轉移並不一致。
Gradient alignment 主要集中在早期 pre-attention normalization layers,並與下游 transfer 呈正向關係。這讓 OmniTaskonomy 不只回答「生成能否幫助理解」,亦提供一套分析哪些生成任務值得加入訓練、哪些能力不應直接互相推論的方法。