PanoWorld 把 360 影片生成拉回真實場景

想做會記得路徑同方位的全景生成,PanoWorld比一般短片模型更有方向感。它瞄準長距離一致性,重點不只係畫面靚,仲要前後場景講得通。

PanoWorld logo

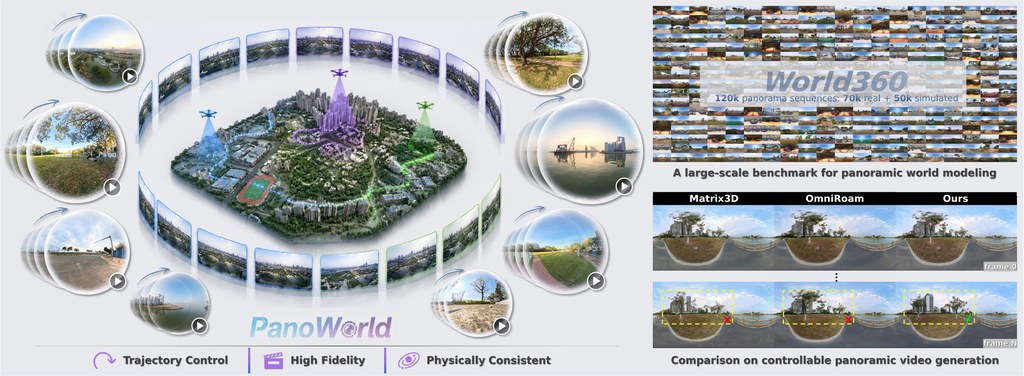
做 360° 影片生成,最易穿崩的往往不是單幀畫質,而是鏡頭轉了一大圈之後,場景記憶是否仍然連貫。PanoWorld屬於世界模型兼影片生成模型,針對全景 world model 的 long-range memory 問題,目標是生成更符合空間幾何與物理一致性的 panoramic video。

這個項目的取向幾明確:不是單純追求更短時間出片,而是利用 omnidirectional representations 的 rotation-equivariant 特性,將旋轉視為隱含幾何變換,再把相機軌跡簡化成固定朝向下的平移。核心做法包括 Dense Panoramic Ray-Conditioning (DPRC)Geometry-aware Memory Augmentation (GMA),並建基於 Wan2.2 backbone 的 triple-stream DiT,處理當前動作建模與長程記憶。

現階段公開資訊較適合做推理測試與結果驗證,訓練代碼仍未釋出。環境要求也不算輕:Linux(已測 Ubuntu 22.04)、CUDA 12.8 以上、Python 3.10,並需要至少 20GB VRAM 的 CUDA GPU;README 亦提供 demo assets,可先用來跑 inference,觀察 81-frame 與 161-frame panoramic video 的生成表現。

  • 重點放在 long-range memory,而非只提升單段片段觀感
  • 可生成 81-frame、161-frame 的 panoramic video
  • 評測依託 World360,涵蓋真實全景無人機片段與 AirSim360 模擬資料
  • 官方表示在 World360 上明顯勝過其他方法,但目前公開細節以展示頁與推理資源為主

受益最明顯的,會是做 360 內容生成、沉浸式視覺、無人機視角模擬,或研究世界模型長時序一致性的團隊。它未必是最容易部署的項目,但定位很清楚:當一般 video model 在大範圍空間變化與光照變化下容易失憶,PanoWorld正面處理這個痛點,並且連同 World360 一起把評測場景拉近真實世界。
項目主頁 · GitHub

Categories: 開源, 清華大學, 視頻模型, 世界模型, NVIDIA, Video, 影像處理, 3D, Linux, Python, Dataset 數據集

Needle 想把微型 AI 帶落手機同手錶

Needle唔係追求萬能對話,而係集中做好 function call。26M 參數做到可本地微調,方向相當鮮明。

Logo

想喺手機、手錶或者眼鏡一類裝置放入可用嘅個人 AI,卡位往往唔係模型夠唔夠大,而係夠唔夠細、夠唔夠快,仲要肯做工具呼叫。Needle 就係朝呢個位置落手:一個以 Simple Attention Network 為核心嘅微型模型項目,重點處理 single-shot function call,目標唔係長篇對話,而係幫個人 AI 更穩定咁叫工具做事。

呢個項目最值得留意嘅地方,在於佢將 Gemini 3.1 蒸餾到 26M 參數,並且保留到可以喺 Mac/PC 本地 finetune 嘅路線。對開發者同產品團隊嚟講,意思好直接:你未必要綁死雲端大模型,亦可以先用開放權重同資料生成流程,試自己嘅工具介面、指令格式同 function schema,再按需要微調。

Cactus Needle - The 26M Function Calling Model

同類小模型通常會喺「尺寸、速度、泛化能力」之間拉扯,Needle 明顯揀咗功能導向呢一邊。README 已經講得很坦白:佢喺 single-shot function call 勝過 FunctionGemma-270m、Qwen-0.6B、Graninte-350m、LFM2.5-350m,但呢類較大模型喺對話範圍同容量上仍然更強,所以 Needle 比較似一把專用工具,而唔係通才助手。

  • 類型上屬於開源模型項目,集中解決小裝置上嘅 function call 效率與部署成本。
  • 權重同 dataset generation 都已開放,適合拿來測試自家工具鏈同微調流程。
  • 生產環境配合 Cactus,可達 6000 toks/sec prefill 同 1200 decode speed,取向非常著重吞吐。
  • 預訓練用 16 TPU v6e 跑 200B tokens,之後再用 2B tokens 嘅 single-shot function call dataset 做 post-training。

模型結構亦反映咗呢種取向:Simple Attention Network 採用 encoder-decoder 佈局,配合 GQA+RoPE、Cross Attn、ZCRMSNorm 同 shared embedding,目的係用更細規模支撐工具呼叫輸出。要留意嘅限制同樣清楚,小模型本身比較 finicky,對資料格式、工具定義同微調質素會更敏感;需要穩定多輪對話或者更廣知識覆蓋嘅場景,仍然未必係 Needle 最合適。

GitHub

Categories: 開源, Embedding, 模型, 模型訓練, Qwen, Gemini, Mac, Dataset 數據集

audio.cpp-webui:本地音訊 AI 一站式介面

想在電腦本地試語音生成、轉寫同聲音處理,唔想先整理一堆 Python 依賴,audio.cpp-webui 走的是更直接的路線。

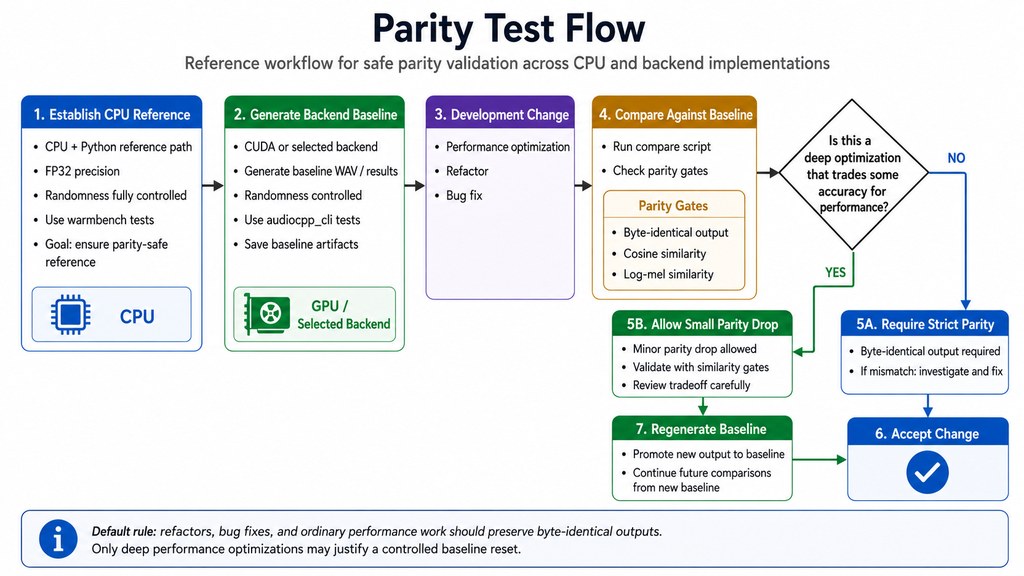
Parity test flow

要同一部電腦處理 TTS、voice cloning、ASR 同音訊增強,最大阻力往往唔係模型本身,而係部署鏈太散。audio.cpp-webui 把這件事收斂成一個偏向本地部署的音訊推理框架+WebUI 工具:核心沿用上游 0xShug0/audio.cpp,以 C++ 配合 ggml 執行,這個分支再補上完整任務介面同較友善的 Windows 啟動方式。

它的定位幾清楚:唔係只做單一模型展示,而係想用同一套 runtime 接住多類音訊工作流。你會見到它涵蓋 TTS、voice conversion、ASR、diarization、VAD、source separation,連 denoise、resampling、STFT/ISTFT 都內建,較接近「把多個音訊 AI 能力放入同一個本地工作台」,而唔係逐個 Python 項目分開跑。

本地语音 AI 终于统一了! 实时对话、声音克隆、AI 翻唱8G 显存全跑通|audio.cpp|整合包

跟常見 Python 參考路徑相比,這個項目的取向是用原生執行環境換取更穩定的部署體驗同速度,代價是功能節奏仍然受上游整合進度影響,而且部分高階流程像 JSON pipeline 仍屬 experimental。效能數字是它最值得留意的一環:多條 TTS 路徑在 CUDA 上可比 Python reference paths 快 1.8x 至 5.0x,端到端延遲可降低 45% 至 80%;README 亦列出 VibeVoice 1.5B 能在 18.2 分鐘生成 93.9 分鐘 podcast。

  • 可用 webui.bat 啟動 Gradio WebUI,本地網址是 http://127.0.0.1:7860
  • 支援按需載入模型、模型切換、下載模型、上傳或錄製 reference voice
  • 內建進階參數控制,同頁可見執行狀態與錯誤訊息
  • 較適合想在 Windows 或本地 CUDA 環境整合多種音訊任務的人員與小團隊

相關模型與路線目前集中在多種本地音訊模型家族,文中點名 VibeVoice 1.5B,整體則圍繞現代 audio models 的統一推理。對內容製作、語音原型、內部工具驗證,甚至要把多步驟流程包成固定操作的人來說,它補上的並非新奇功能,而是把本來零散的模型執行方式整理成較可重用、較易維護的本地項目基礎。

GitHub

Categories: 開源, 文字轉語音, NVIDIA, Audio, 工具, Clone, Python, 語音

MOSS-Transcribe-Diarize:多人長音訊一站式轉錄

錄音一長、講者一多,整理內容最怕時間碼亂、人物又對唔上。MOSS-Transcribe-Diarize 把轉錄同分辨講者合併處理,明顯是想減少後期整理工序。

OpenMOSS Logo

會議、訪談、podcast 呢類長音訊,最麻煩唔係單純變成文字,而係要一路保留時間碼、一路分清楚邊個講緊。MOSS-Transcribe-Diarize 屬於音訊理解模型,集中處理長篇多人語音轉錄同 speaker diarization,輸出已經連同時間戳同講者標籤,例如 [S01]、[S02],比起先做 ASR 再另外接 diarization,流程更完整。

呢個項目的取向相當鮮明:它唔係把幾個系統串連,而係用 end-to-end 方式一次過完成 transcription、speaker diarization、timestamps,連 acoustic event awareness 都納入同一模型。好處係輸出格式更統一,段落對位較自然;代價則是你要接受它的整體輸出設計,而唔係自由替換其中一段模組。

目前公開的是 MOSS-Transcribe-Diarize 0.9B,定位為開源 SOTA 模型;另有更強的 MOSS-Transcribe-Diarize Pro,但會以 API 形式提供。部署路線算清楚,倉庫已列出 Python 用法、自訂 prompt 與 hotwords、用 vLLM 或 SGLang Omni 提供服務,亦有 Subtitle Web App,表示它不只適合研究測試,也可朝內容整理、字幕製作同語音工作流整合發展。

  • 把 ASR 與 speaker diarization 合併,減少多階段對齊誤差
  • 直接輸出帶時間戳的文字流,適合字幕、會議紀錄、訪談整理
  • 支援長篇、多講者、較混亂的真實錄音場景
  • 0.9B 已開源,Pro 版本主打更高整體表現並將經 API 提供

受惠最大的會係做會議紀錄、媒體轉寫、客服通話分析同教育內容整理的團隊,因為他們最在意的往往不是單句辨識,而是整段內容可否穩定交付。現有資料提到它屬於 SOTA 等級,也有獨立 Evaluation 章節,但未見完整數字細節一併列出;能夠確認的是,相關模型目前包括 MOSS-Transcribe-Diarize 0.9BMOSS-Transcribe-Diarize Pro,前者著重開源可用性,後者走更高性能與 API 存取路線。

GitHub · 模型

Categories: 開源, 模型, API, Python, 語音

ABot-World 把互動世界模型帶上桌面 GPU

ABot-World想解決的,不是再做一段更長影片,而是讓生成世界可以持續回應操作。你可以把它理解成一個開始接近可玩狀態的互動式世界模型示範。

ABot World 0

影片生成做到流暢並不罕見,但能一邊接收操作、一邊把世界延伸落去,門檻就高得多。ABot-World定位屬於模型加示範工具,核心處理的是 action-conditioned world rollout:用戶輸入動作之後,系統持續生成可探索的世界,而唔係播完就停的被動片段。

呢個項目的取向相當鮮明:它唔係先追求超高畫質,而是把「可互動、可持續、可在單張桌面顯示卡跑起來」放到前面。官方公開的數字是單張 NVIDIA RTX 5090 可在 720P、16 FPS、1.2 秒延遲、19GB GPU 記憶體下運行,配合 LongForcing training 減少 scene lock-in,令 rollout 期間可以擴展新場景同動態,唔使靠 prompt switching 硬接續。

測試方式算直接:項目已提供本地 gradio demo,同時有線上版 ABot World Studio;想自己部署,它在 Ubuntu 22.04、CUDA 13.3、NVIDIA RTX 5090 環境驗證過,並要先下載 ABot-World-0-5B-LF checkpoint。換句話說,現階段較適合把它理解成高階桌面 GPU 上的研究型互動系統,而唔係一般消費級硬件都能順手跑的輕量工具。

幾個重點值得留意:
ABot-World-0-5B-LF 已公開,屬於 causal student model
– 互動重點在連續探索,不是固定長度 video generation
– 本地推理與線上 playground 都已提供,驗證路徑清楚
– Bidirectional Teacher Model 仍未釋出,生態暫時未算完整

適合研究 world model、interactive video generation、Agentic 模擬環境,或者想為遊戲原型與具身智能測試場景找參考的團隊。現階段的吸引力在於它把「無限 rollout」和「單桌面 GPU 即時推理」放到同一個項目內。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 視頻模型, 世界模型, 模型訓練, Google, NVIDIA, Video, Linux, 蘋果

Qwen3.6 全新的動態 NVFP4 量化器

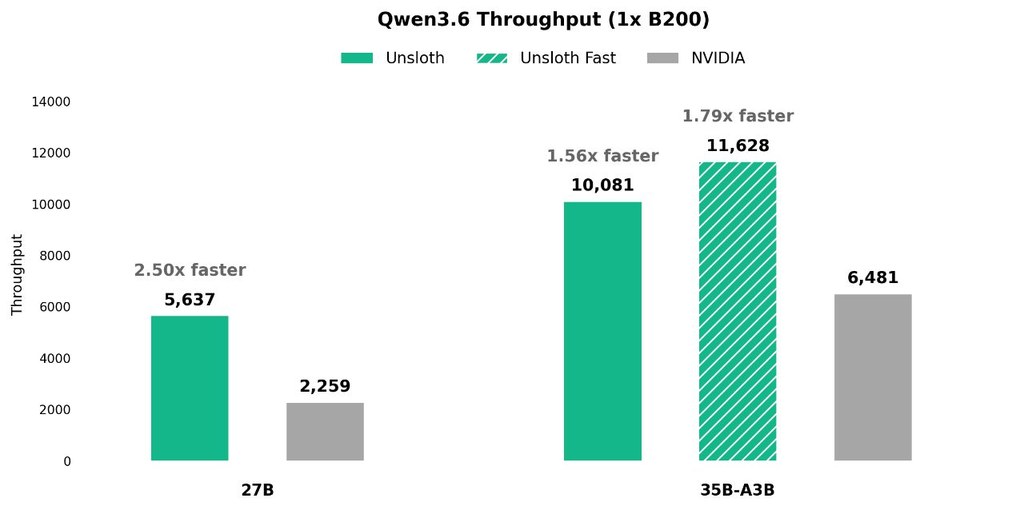
運行速度比其他 NVFP4 量化器快約 2.5 倍,效能更佳,檔案大小也相近。在24GB 記憶體上,Qwen3.6-27B NVFP4 的運行速度提升 2.5 倍;在32GB 顯存上,Qwen3.6-35B-A3B 的運行速度提升 1.7 倍。

Og image

想喺自己電腦上跑到規模較大的多模態模型,最大卡位通常唔係功能,而係記憶體同速度。Qwen3.6 屬於阿里巴巴的新一代多模態 hybrid-thinking 模型系列,重點在於用相對可控的硬件需求,處理 agentic coding、vision 同 chat 等工作。

現有資料提到兩個主力型號:Qwen3.6-27B 同 35B-A3B。前者可在約 18GB 記憶體配置下運行,後者約需 22GB 至 23GB 左右,並支援 256K context 及 201 種語言。對想喺本地做長內容理解、跨語言對話,或者配合工具調用工作流的人來說,這個取向幾實用。

相比只講「可量化、可本地跑」的常見做法,Unsloth 這邊更著重點樣揀到速度與準確度較平衡的版本。Qwen3.6 GGUFs 採用 Unsloth Dynamic 2.0,會按真實使用資料做 calibration,並把重要 layers upcast;另外新推出的 NVFP4 quants 主打在 GPU 上帶來約 2.5 倍更快速度,MTP 則標示可把 inference 再加快 1.4 至 2.2 倍,同時不犧牲準確度。

  • 適合本地部署多模態模型,兼顧編碼、視覺與對話
  • 27B、35B-A3B 記憶體需求相對克制,較易在個人設備起步
  • GGUF 格式配合 Unsloth Dynamic 2.0,重點是量化後仍保持可用表現
  • NVFP4 與 MTP 主要改善推理速度,幫助減少等待時間

使用上仍有幾點要留意:總可用記憶體最好高於下載的量化模型大小,否則雖然可經 llama.cpp 用 SSD/HDD offloading 繼續運行,但推理會慢得多;文件亦明確提醒不要使用 CUDA 13.2,以免輸出異常。整體來看,這不是單純把 Qwen3.6 搬到本地,而是把「跑得動、跑得快、精度仍可接受」這幾個取捨整理得更清楚。

所引用的模型列表:Qwen3.6-27B、Qwen3.6-35B-A3B。

項目主頁 · 模型

Categories: 開源, 阿里巴巴, Agentic, MCP, 模型, 多模態模型, Qwen, NVIDIA, API, 教學, Medical醫學, Python, 編程, OpenClaw, Anthropic

DrugGen-2:把疾病上下文拉進分子生成流程

你可以在指定疾病與蛋白靶點後,讓模型直接吐出候選藥物分子。DrugGen-2 補上了以往只針對靶點或通用性質做生成的盲區。

Logo

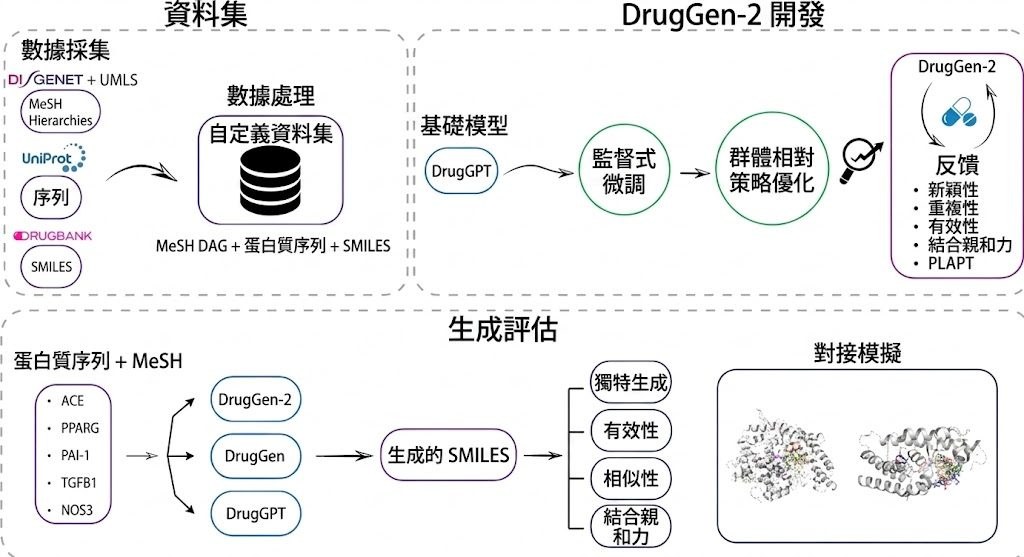
很多老牌分子生成模型只盯着單一蛋白靶點或通用化學性質做條件生成,往往忽略了同一個靶點在不同疾病背景下行為可能完全不同。DrugGen-2 正是針對這個落差而來,它是一個用 MeSH DAG(疾病本體層級結構)加上蛋白序列做條件輸入的語言模型,輸出端直接給出 SMILES 結構,既支援 de novo 設計,也能用於藥物再利用篩選。

這個項目屬於開源模型與訓練框架的混合體,背後以 liyuesen/druggpt 為基底,先做 Supervised Fine-Tuning(SFT),再用 Group Relative Policy Optimization(GRPO)做強化學習微調,整個流程跑在 Hugging Face transformers 與 TRL 上。作者認為舊做法把疾病與靶點切割看待,於是提出以疾病為錨點重新組織資料的 framing,這也是它和同類工具最大的差異點。

對做計算化學、藥物篩選前期探索或想快速做假說驗證的研究團隊來說,這類輸入比直接丟一個蛋白 ID 更貼近真實用藥情境。要部署的話只要 clone 倉庫、安裝 requirements,再透過 Python API 或 CLI 餵入疾病名稱、MeSH ID 與 Uniprot 序列即可生成候選分子,預訓練權重已放在 Hugging Face 上方便取用。

不過要留意,模型表現仍受限於 alimotahharynia/approved_disease_target_drug 訓練集的覆蓋範圍,對冷門疾病或新興靶點的泛化能力尚未有公開 benchmark 直接驗證。它比較適合作為初期探索與假說排序的輔助,而非取代濕實驗驗證的工具。

項目主頁 · GitHub · Paper

Categories: 開源, 模型訓練, API, Clone, Medical醫學, Python, Dataset 數據集

Canvas360 把全景生成拉回可用水平

全景圖最易穿崩嘅位置,往往唔係畫質,而係左右接縫同空間感。Canvas360 針對呢個痛點落手,想令文字生成同後續修補都更連貫。

teaser

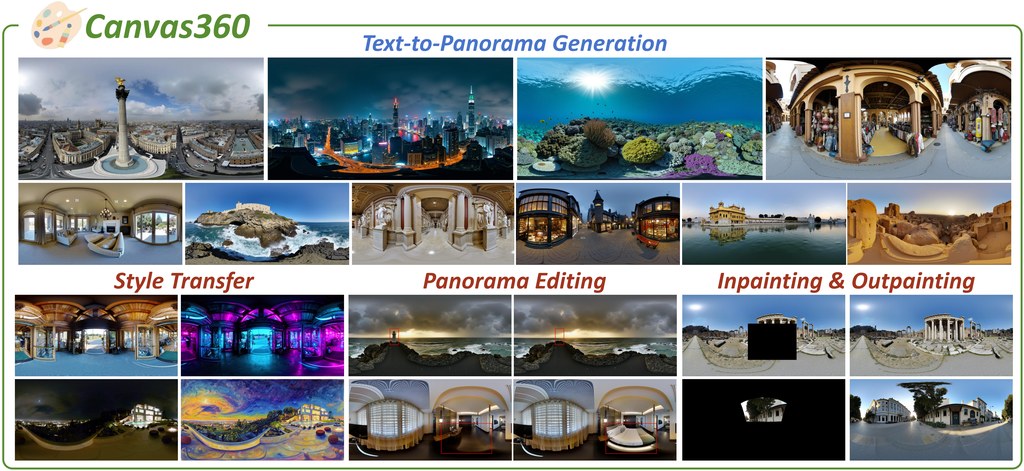
最值得留意嘅地方,在於佢唔只想生成一張闊圖,而係想處理 360 度全景最常見嘅破綻:左右邊界接唔上、透視變形唔自然、補圖後空間結構散開。Canvas360 屬於影像生成框架,建基於 FLUX,處理嘅係 text-to-panorama image generation,同時延伸到 inpainting、outpainting、editing 同 style transfer 呢類全景工作流。

現有做法多數先把全景當成一般平面圖片生成,再靠後處理減少接縫;作者認為呢種範式忽略咗 panoramic projection 本身嘅幾何特性,所以容易喺邊界、深度關係同局部結構出現錯位。Canvas360 用 two-stage framework 重組呢件事:先做 geometry-aware pretraining,引入 parallel RGB-depth pretraining,再配合 continuous position encoding、circular latent padding 同 per-block feature synchronization,將 360 度連續性直接放入模型學習過程。

同類項目相比,Canvas360 嘅取向唔係單純追求更華麗嘅畫面,而係優先修正全景生成最影響可用性嘅一致性問題。項目亦補上 Canvas360Dataset,提供 1M paired panoramic samples,支援 style transfer、inpainting、outpainting 同 editing,反映作者唔止做單一模型改良,仲想連訓練資料結構一併補強。

  • 核心定位係 FLUX-based framework,主打 text-to-panorama image generation 同全景補全
  • 關鍵方法包括 geometry-aware pretraining、continuous position encoding、circular latent padding
  • 已公開 inference code 同 training code,但 model weights 與 online demo 仍然未釋出
  • 需要 base model black-forest-labs/FLUX.1-dev,並可配合自備 LoRA 跑生成或下游任務
  • 相關比較對象包括 PanFusion、SMGD、PAR、WorldGen、HunyuanWorld、DiT360,以及 FLUX.1-Kontext-dev、FLUX.2-dev、Qwen-Image-Edit

測試同現階段較接近研究型項目而唔係即開即用服務。儲存庫已提供 inference.py 同 inference_downstream.py,代表你可以在本地環境配好 PyTorch、依賴套件、FLUX.1-dev 存取權同 LoRA 後,直接驗證文字生成全景,或者試全景補圖與延展;不過權重未公開,所以現時更適合研究團隊、全景影像工具開發者,或者想研究 360 度生成方法嘅人先行閱讀同跟進。現有介紹強調結果比多個舊方法更少接縫瑕疵、結構更清晰,但儲存庫內容未見完整量化指標表,判斷性能仍要等論文與權重進一步公開後先更穩陣。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, 字節跳動, 模型, 視覺模型, 模型訓練, Stable Diffusion, Image, 影像模型, 框架, Python, Dataset 數據集

LongE2V 把事件流變成穩定長影片

LongE2V 針對事件相機最難處理的長時序穩定度落手,想同時做好重建、預測與補幀。你可以把它理解成一套用 video diffusion model 補回連續畫面的研究型框架。

Logo

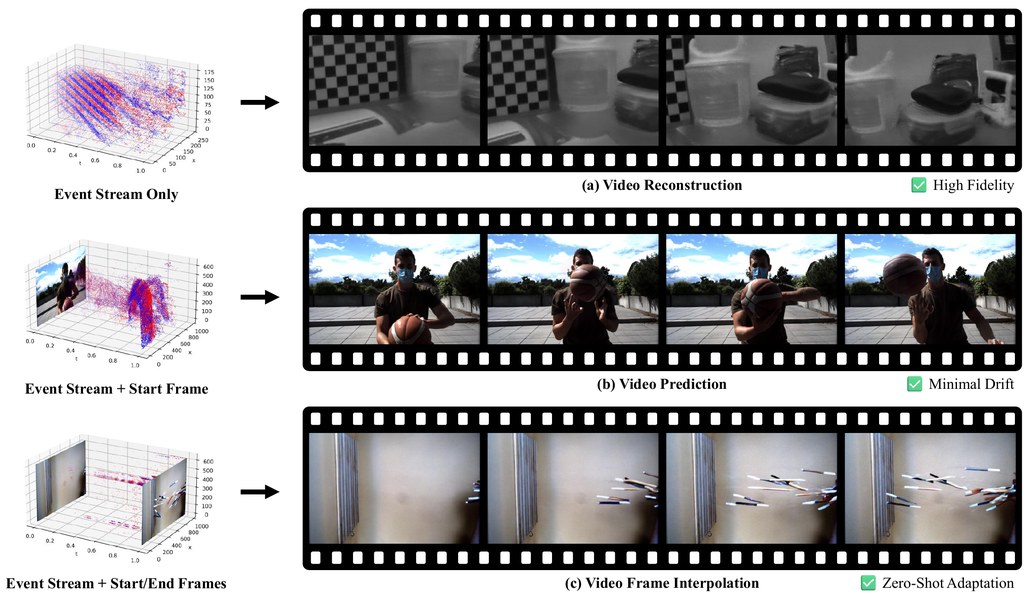
事件相機資料本身又稀疏又碎,畫面一拉長,很多方法不是紋理發糊,就是前後段落開始飄。LongE2V 走的是研究型模型/框架路線,目標不是只修一段短片,而是把 sparse event streams 轉成較穩定的長影片,並且同時處理 reconstruction、prediction 同 frame interpolation。

同類做法常見兩條路:一類用 regression methods,速度直接但容易損失細節;另一類雖然有 generative models 的畫質優勢,長序列又容易出現 temporal drift。LongE2V 把 pre-trained video diffusion priors 拉進 event-based video 任務,再加上 Autoregressive Unrolling、Adaptive Context Switching,以及插幀用的 Reencoding Alignment with Cross Residual Correction,核心取向很清楚:接受系統更複雜,換取較長時間的一致性同感知品質。

部署環境以 Python 3.10 為基礎,Linux 加 NVIDIA GPU,同時依賴整理好嘅資料結構;訓練要每段 sequence 準備 images/.png、voxels/.npz 同 cogvlm_prompts.txt,推理前亦要確保 voxel 檔名、數量同資料夾完全對齊,因為多一個或少一個 voxel 檔,都會改變事件切塊方式,直接影響訓練同推理結果。

重點整理如下:
– 同一套框架覆蓋 reconstruction、prediction、frame interpolation,減少每個任務各自維護一套模型的割裂情況
– reconstruction / prediction 以 ECD、MVSEC、HQF 為主,interpolation 用 BS-ERGB 同 HQF
– 空事件區間會寫入 zero voxels,避免時序長度對不上
--reverse-time --reverse-polarity 產生的 voxels_reverse 只供 interpolation 測試使用,唔需要帶入 reconstruction、prediction 或訓練
– 在 real-world benchmarks 上優於多個 state-of-the-art 方法,並強調 temporal coherence 同 zero-shot generalization

相關模型包括 E2VID、FireNet、ET-Net、SPADE-E2VID、SSL-E2VID、HyperE2VID、VDM-EVFI、CBMNet-Large 同 TLXNet+。LongE2V 較適合做事件相機、視覺生成、機械感知或學術重現的團隊參考;它吸引之處在於把三類任務收進同一個 video diffusion framework,但代價是資料前處理要求嚴格、硬件門檻偏高,整體更像面向研究與實驗室工作流。

項目主頁 · GitHub · Paper

Categories: 開源, 模型, NVIDIA, Video, 框架, Linux, Python

UniClawBench 點樣測主動式代理

要比較主動式 AI agents,單看單輪答題已經唔夠。UniClawBench把工具操作、瀏覽器、檔案同 GUI 流程放入同一個閉環評測。

UniClawBench

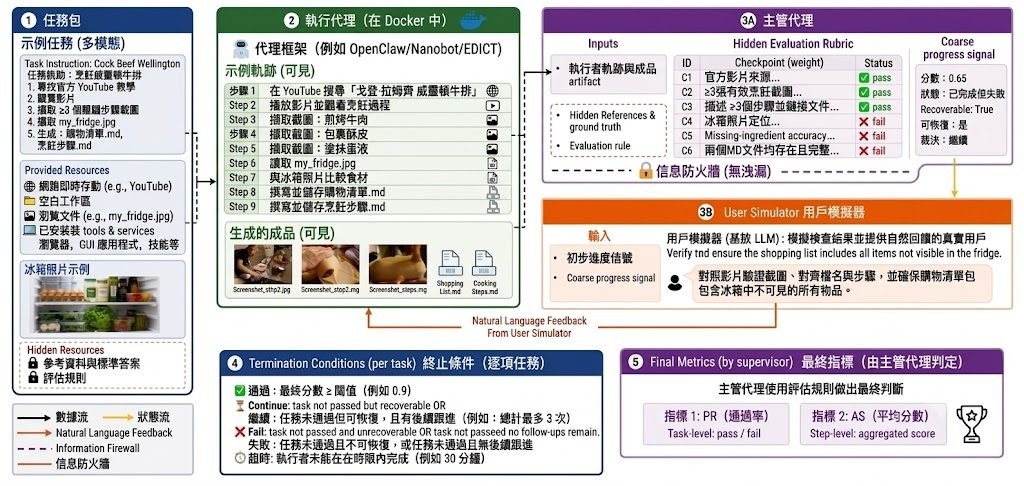
比起只問模型識唔識答,UniClawBench更在意代理能否一路做、一路修正,直到完成整個工作流。它屬於benchmark 項目,針對 proactive AI agents 在真實工具、瀏覽器、檔案處理與桌面 GUI 任務中的完成能力,補足傳統單步評測難以反映連續操作表現的缺口。

現有做法常把 agent evaluation 壓縮成靜態問答、固定軌跡重播,或者只看最後答案;作者明確改用 three-role closed-loop evaluation framework,將 executor、hidden answer supervisor 同 public user simulator 分開。呢個設計的重點,是同時檢查代理點樣行動、途中有冇偏離、收到回饋後能否繼續修正,而唔係只計一次輸出啱唔啱。

公開版本提供 400 個雙語任務,英文與中文各 200 個,覆蓋 Skill Usage、Exploration、Long Context、Multimodal、Cross Platform 五類能力。部署思路亦算清晰:倉庫已放入 packaged task resources、Docker-based runtimes、distributed dispatch scripts,同埋可檢視 leaderboard、trace、artifacts 與 timeline 的 WebUI;要跑測試,核心其實是先填好 executor、Codex provider 同 API keys 相關設定檔,再用它的執行環境批次評估。

  • 用 three-role 閉環評測取代一次性答題
  • 任務同時涉及 browser、files、GUI apps 與其他工具
  • 400 個雙語任務,較易檢查跨語言穩定性
  • WebUI 可回看 traces、artifacts 同示範流程

從補充資料看,作者想指出的取向幾鮮明:framework choice 對能力表現的影響,往往比 model choice 更大,而 long-context 與 multimodal 仍是主要瓶頸。相關模型與組合亦有列出,例如 GPT-5.4、Claude Opus-4.8、Kimi-2.6,並配合 OpenClaw、EDICT、Nanobot 等框架比較;對研究 agent system、企業內部自動化流程,或者想建立較完整評測流水線的團隊,這個項目的參考價值高過單純看排行榜。

項目主頁 · GitHub · Paper

Categories: 開源, 香港大學, Agentic, 多模態模型, OpenAI, API, 框架, OpenClaw, Anthropic, Dataset 數據集, Skill 技能

Page 36 of 92
1 34 35 36 37 38 92