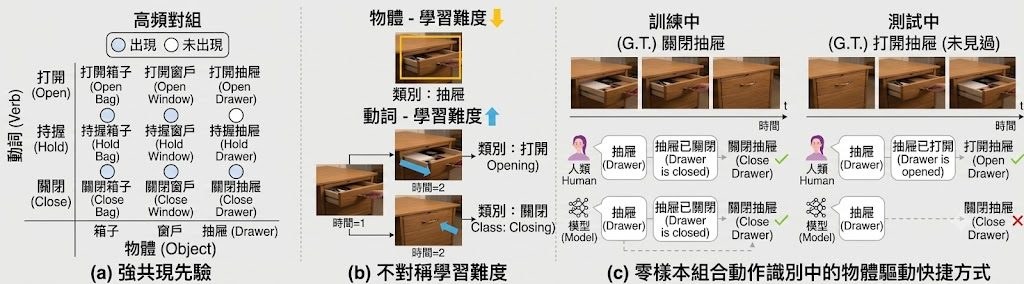
RCORE 為什麼我打不開抽屜

同一個抽屜,模型可能只見到物件就判成「關上」。RCORE 針對這種偏差補上時序線索,重點不在多記類別,而是少走錯路。

RCORE teaser

見到抽屜就猜「關上」、見到杯就猜「拿起」,正是 Zero-Shot Compositional Action Recognition (ZS-CAR) 最容易失手的位置。RCORE 是一個研究型模型項目,處理的是新 verb–object 組合辨識,核心不是再加更多標籤,而是壓低模型依賴物件類別走捷徑的傾向。

現有做法多數沿用已見過的共現關係去推斷動作,作者指出這種 fixed compositional supervision 會令模型把 object 當成近路,忽略影片中的 temporal evidence。RCORE 的回應很直接:用 CPR(Co-occurrence Prior Regularization)補足原本缺席的組合監督,同時把常見配對當成 hard negatives;再用 TORC(Temporal Order Regularization for Composition)迫使 verb 表徵對時間順序敏感,而不是學成靜態語意。

這個取向的價值,在於它不是單純追求更強 backbone,而是修正 ZS-CAR 的學習偏差。論文亦加入 FSP、FCP 與 Compositional Gap 這幾個診斷指標,不只看最後準確率,亦檢查模型是否真的較少受 co-occurrence patterns 牽引;已公開資訊指出,它在 Sth-com 與 EK100-com 都能改善 compositional generalization。

  • 重點放在減少 object-driven shortcuts,不是單靠物件猜動詞
  • CPR 針對訓練配對偏斜,TORC 針對時序線索不足
  • 準備 Python 3.10、requirements,以及特定 tokenizer 詞彙檔
  • InternVideo2 1B backbone 依賴 flash-attn,CLIP / InternVideo2-Base 則較易測試

部署與測試方式偏向研究流程:先安裝相依套件、準備資料,再跑 training 與 evaluation;它較適合做影片理解、組合泛化或 benchmark 分析的團隊,而不是即插即用的產品工具。相關模型與骨幹包括 CLIP、InternVideo2-Base、InternVideo2 1B;對於想研究模型為何會「看錯動作」的人,RCORE 比單看分數更有參考價值。
項目主頁 · GitHub · Paper

Categories: 開源, 模型訓練, Qwen, VLA, Robotic, Python, Dataset 數據集

Video-Oasis 想重做影片理解評測

不少影片 benchmark 分數看似漂亮,其實未必真係考到影片理解。Video-Oasis 把焦點放回評測本身,專門拆解捷徑題與真正需要時序證據的題目。

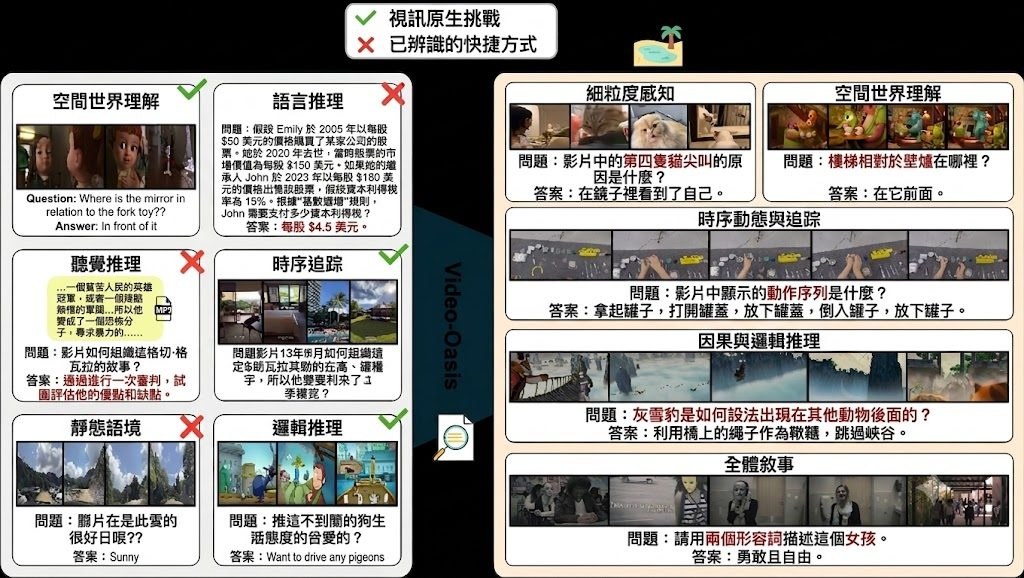
video native challenges

高分未必代表模型真係睇得懂影片,呢個項目正正針對呢個落差。Video-Oasis 屬於資料集與評測項目,重點不是再加一份題庫,而是重新檢查現有 video benchmark 到底有幾多題目真的需要 visual grounding 與 temporal reasoning,避免模型只靠文字線索、單幀畫面或靜態背景就答中。

普遍做法是把不同影片問答 benchmark 直接合併比較,作者認為這種固定範式忽略了「是否真係需要影片」這個前提。Video-Oasis 先整理 14 個 benchmark、24,416 個 QA samples,再用共享的 visual 與 temporal criteria 審視題目,結果指出約 55% 樣本可被 non-video shortcuts 解開,之後再萃取出 11,033 個較具代表性的 Video-Native 挑戰。

它和同類 benchmark 最大分別,在於不是追求覆蓋更多題型,而是先清理評測污染。官方資料提到五類 video-native challenges 才是核心難點,而現時模型在這部分表現仍然偏弱,最佳模型 Gemini-2.5 Pro 只有 46.7%,接近 chance 25.63% 之上不遠,說明這套評測更能拉開「答得中」與「真理解」之間的差距。

  • 涵蓋 14 個 benchmark,任務由 perception 延伸到 reasoning,片段長度由幾秒到數小時
  • 以 shared visual and temporal criteria 重新審核題目,不是單純拼接舊 benchmark
  • 約 55% QA samples 可用 non-video shortcuts 解答,真正 video-native 部分約佔 45%
  • 評測流程建基於 lmms-eval,並支援透過 huggingface_hub 下載模型
  • README 已提供資料下載、影片修復與目錄整理方式,但完整程式碼仍標示為 coming soon

部署理解上,它較像一個研究型 benchmark workflow:你要先準備 Python 3.12、CUDA-compatible GPUs、torch、vllm 0.11.0 與 transformers 4.57.0,再下載各 benchmark 影片、用 ffmpeg 腳本修復損毀檔案,之後透過內建 lmms-eval 跑 vqa_total 或 v_oasis 任務。現階段較適合做模型評測、研究比較,或者幫團隊檢查自家 video model 是否只是在 benchmark 上「識考試」,未必適合作為即裝即用的應用工具。

項目預設支援可由 huggingface_hub 下載的模型,示例提到 Eagle2.5-8B;成績說明中則點名 Gemini-2.5 Pro 為目前最佳表現者。整體來看,Video-Oasis 最有價值的地方不是再造一個排行榜,而是把影片理解評測裡最容易被忽略的捷徑問題公開化,令後續模型比較更可信。

項目主頁 · GitHub · Paper

Categories: 開源, AI productions, 視覺模型, 視頻模型, NVIDIA, Gemini, Video, Python, Dataset 數據集

PhyMRI-SR:MRI 超解像唔只靠放大

PhyMRI-SR 針對 MRI 超解像入面常見的取捨:解析度愈高,訊噪比未必愈好。它唔係單純補像,而係把 MRI 成像物理一併放入重建流程。

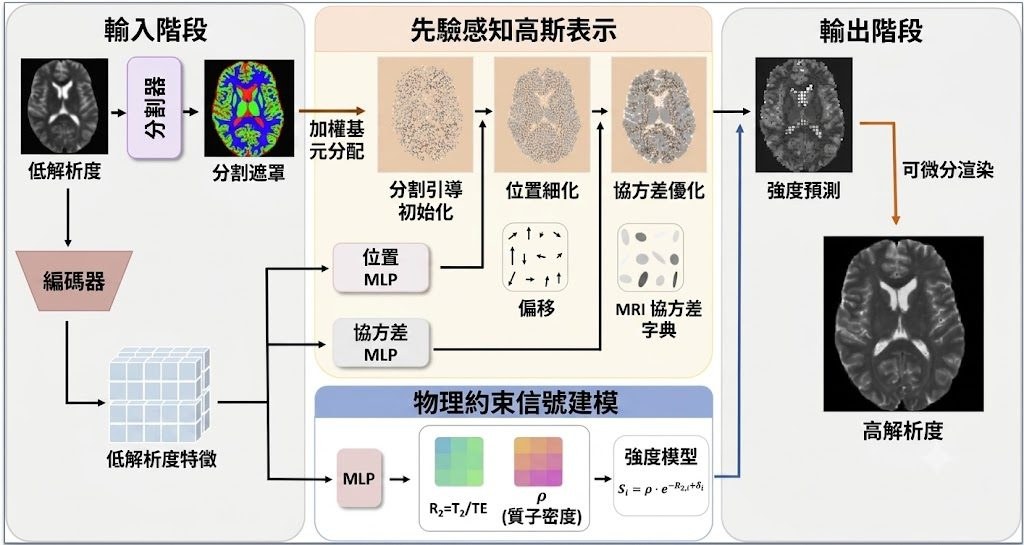
Repository image for weilihua0205/PhyMRI-SR

做 MRI 超解像時,問題往往唔係「放大得夠唔夠」,而係高解析度同 SNR 會互相拉扯。PhyMRI-SR 把這個矛盾放到核心處理;它屬於一個醫學影像超解像模型/研究項目,目標不是盲目追求最高輸入解析度,而是找出更有結構資訊的重建位置。

現有做法多數把低解析度 MRI 當成一般影像放大;作者認為這種 fixed paradigm 忽略 MRI acquisition physics,亦未必對應最有資訊量的輸入條件。PhyMRI-SR 因而改用 physics-aware Gaussian splatting,把組織先驗、MR signal equations 同 continuous-scale super-resolution 合併,嘗試沿住 resolution-SNR spectrum 找到更合理的平衡點。

它不是直接生成高解像圖,而是先經 segmentation-guided primitive allocation 分配 Gaussian primitives,再由 prior-aware representation 預測位置偏移與協方差,之後用 physics-constrained signal modeling 根據 tissue properties(例如 alpha、R2)計算訊號強度,最後經 differentiable splatting 合成影像。另加 meta-learning-based adaptation,用來縮窄 synthetic training 與真實 low-field MRI 之間的 domain gap。

  • 與一般影像式 SR 比較,重點放在物理一致性,唔係純粹視覺銳化
  • 支援 arbitrary-resolution 輸入,同 continuous-scale MRI super-resolution 取向一致
  • 結構上結合 segmentation、Gaussian representation 同 MR signal equations
  • 結果顯示最佳表現未必出現在最高輸入解析度,回應作者的核心假設

項目列出 simulated 與 real multi-resolution MRI datasets 的比較:模擬資料在 x0.7 時錄得 PSNR 28.10 dB、SSIM 0.9234、HFEN 0.3051、DISTS 0.1148;真實資料在 x0.76 時取得最低 HFEN 0.4570,其他指標亦有競爭力。這類結果較適合醫學影像研究、MRI 重建與超解像團隊參考;部署與測試細節仍需回到 GitHub 程式碼確認,但整體定位已很清楚:它不是通用修圖工具,而是面向 MRI 成像規律的專門方法。

項目主頁 · GitHub · Paper

Categories: 開源, 模型訓練, 影像處理, Medical醫學, Meta, 中國, Dataset 數據集

Vidu S1 把即時互動影片拉近一步

對住數碼角色直接開聲指揮,畫面仲可以一路生成一路改,Vidu S1瞄準的正是這種近乎通話式的影片互動。它未必是最通用的影片模型,但在即時控制這件事上明顯有自己路線。

Vidu S1 Experience Preview

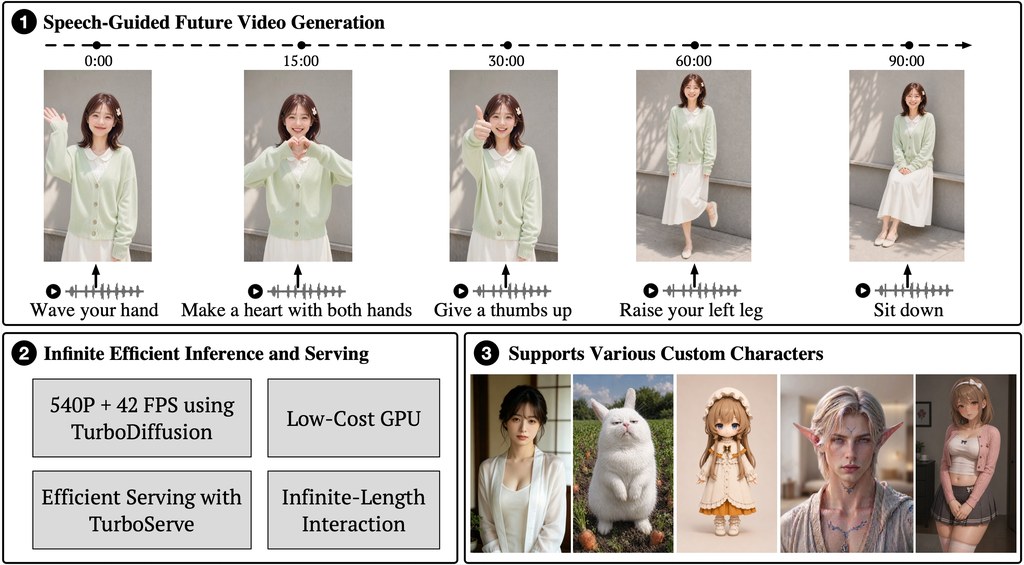
比起先寫好提示詞再等片段輸出,Vidu S1更接近一種可對話的視頻模型:你一邊講,數碼角色一邊跟住反應,處理的是「影片生成能否即時被人打斷、改向、持續延長」這個卡位。項目把重心放在 voice-controlled digital characters,而不是一次過產出完整短片,定位很清楚是互動內容而非傳統文生影片。

現有做法多數仍是 prompt-driven、片段式生成,用戶先提交指令,再等待固定長度輸出;作者主張這種範式難以支援 live interaction。Vidu S1改用 real-time speech control 與 infinite-length real-time interactive generation,讓角色在生成途中持續接受 spoken instructions,方向上更接近直播角色、虛擬主播和即時陪伴互動,而不是 cinematic clip 製作。

  • 支援以語音即時控制角色動作,重點在連續互動而非單次出片
  • 可自訂角色形象與 voice tones,涵蓋真人、二次元、寵物等 avatar
  • 官方資料提到 540p、最高 42 FPS,並可在 consumer GPUs 運行
  • 除了網頁體驗,也提供 API 文件,較適合接入互動產品流程

現有公開資訊較偏向服務化體驗:可先在 Vidu Stream 網頁建立角色、選擇或 clone 聲線,再開啟麥克風與鏡頭進行 live call;團隊要接入自家產品,則更可能經 API 而非直接本地完整重建。GitHub 儲存庫目前公開了論文、說明文件與入口,但未見完整本地訓練或推理流程,較像展示能力與提供接入方式的研究/產品型開源項目。

取捨也很明顯:它強調流暢、低延遲、可長時間互動,代表優先次序未必是最高解析度或最複雜鏡頭語言。受益最大的會是做虛擬主播、互動陪伴、角色扮演、品牌數字人和即時內容演示的團隊;要做電影感分鏡、長敘事剪輯或高度後期控制,現階段未必是它最強的一面。相關模型則包括 Vidu S1 本身,以及同一服務脈絡下的 Vidu Stream 互動入口。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, 數字人, 視覺模型, 多模態模型, 視頻模型, API, Clone, 語音, Dataset 數據集

OpenCoF 用影片學會推理

推理未必只靠文字一步步寫出來,OpenCoF 把重點放到影片幀與幀之間的連續變化。它想證明,生成影片本身都可以成為推理過程。

Repository image for xinyan-cxy/OpenCoF

文字 Chain-of-Thought (CoT) 之外,OpenCoF 把推理搬到影片時間軸上,主打 Chain-of-Frame (CoF) reasoning:模型不是靠外部工具拆步驟,而是在連續生成的畫面裡理解因果、規則同狀態變化。這屬於一個研究型框架,核心想處理的問題,是現有影片生成模型多數只見過一般影片資料,未必學到穩定的時序推理能力。

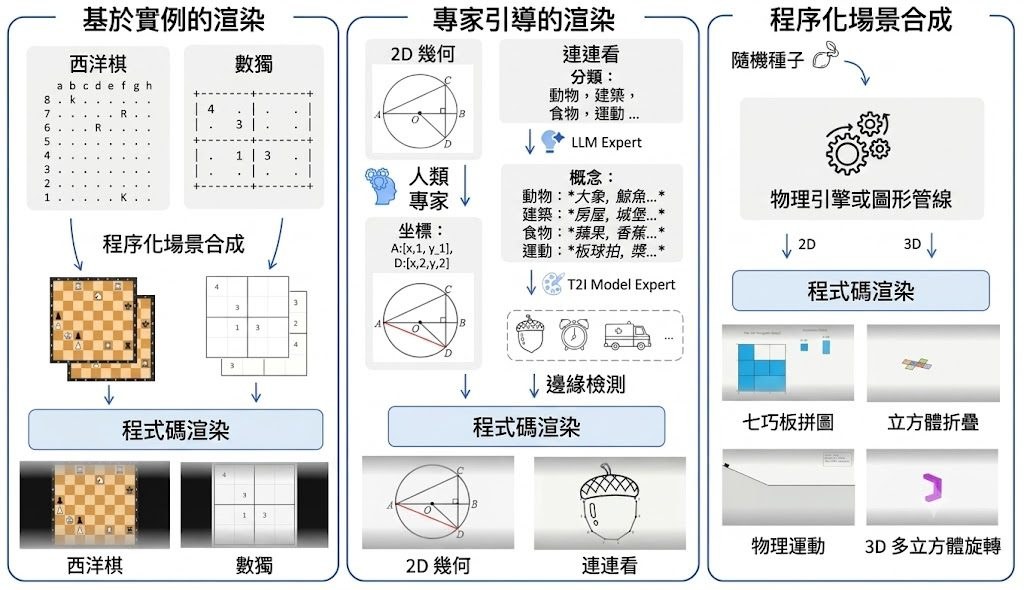
作者對既有做法的批評很明確:以往影片模型通常用通用影片語料訓練,缺少專門針對 CoF reasoning 的監督,因此即使畫面能動起來,都未必真係「識推」。OpenCoF 於是補上兩層東西:先有 OpenCoF-17K 這個包含 17,312 段影片、覆蓋 11 類任務的資料集,再用它把 Wan2.2-I2V-A14B 經 LoRA 微調成 Wan-CoF,之後再加上 Visual Reasoning Tokens (vt) 與 Textual Reasoning Tokens (tt) 兩種設計。

OpenCoF 先用資料監督驗證影片推理能否被教出來,再用 token 設計補強中間推理狀態,而不是一開始就堆很多複雜推理機制。公開資訊顯示,Wan-CoF 單靠資料監督,已經在 MME-CoF、Gen-ViRe、VIPER、RULER-Bench 四個外部 benchmark 全面勝過基線;Wan-CoF vt 與 Wan-CoF tt 則再向前一步,但兩者偏重不同,vt 較擅長低階視覺線索,tt 較著重高階語意先驗。

  • OpenCoF-17K 由四條資料整理流程建成,兼顧規則型任務、程序生成場景與真實影片多樣性
  • Wan-CoF 以 Wan2.2-I2V-A14B 為底,靠 LoRA 微調驗證資料本身已可提升推理表現
  • Wan-CoF vt / Wan-CoF tt 分別從視覺 latent 與文字條件序列加入 reasoning tokens,走兩條互補路線
  • 評測覆蓋 MME-CoF、Gen-ViRe、VIPER、RULER-Bench,結果指向同一件事:時序監督對影片推理有明顯幫助

OpenCoF 適合研究團隊、做視覺推理評測的人,或者關注 Video reasoning 與 Video generation 交界的開發者參考:儲存庫已公開論文與方法框架,但 code、dataset 同 model checkpoints 仍在內部審核,暫時未能直接下載測試;現時較合理的理解方式,是先把 OpenCoF 視為一個針對 CoF reasoning 的資料與訓練範式,等正式釋出後再判斷重現成本與落地價值。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, 字節跳動, 視覺模型, 多模態模型, 視頻模型, Video, 蘋果, Dataset 數據集

IdeasHaveGenomes:用血統追蹤科研點子

研究提案寫得像樣,未必代表模型真正明白想法點樣演化。IdeasHaveGenomes把重點放在「點子血統」,專門測試 AI 能否追蹤繼承、變化同重組。

Ideas Have Genomes overview

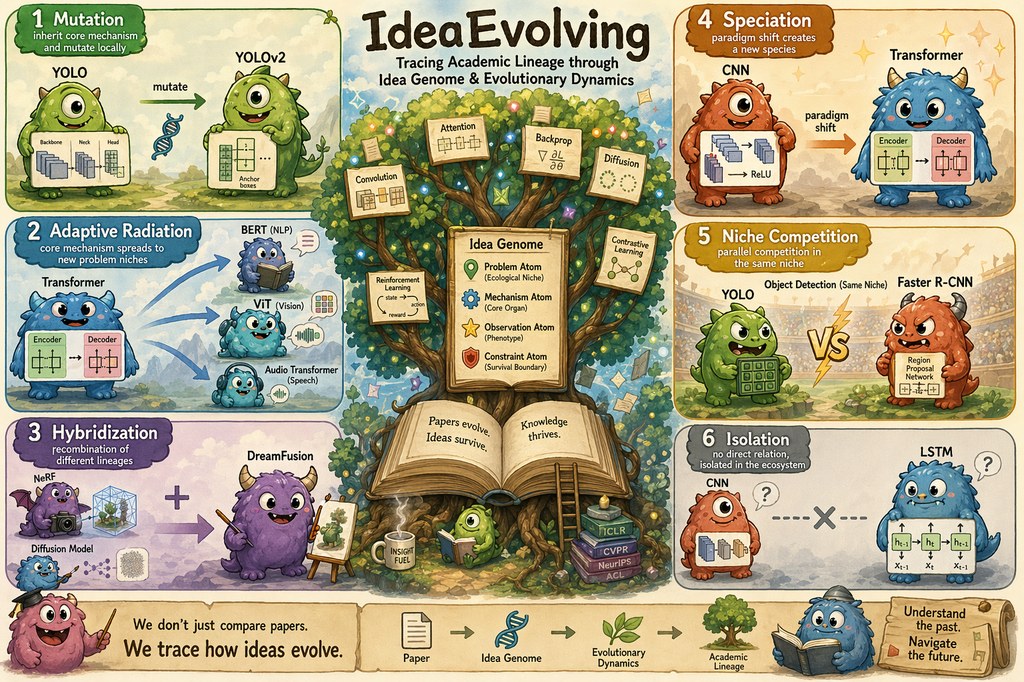
只會搵相似論文,已經唔足夠判斷 AI scientist 是否真係理解研究想法。IdeasHaveGenomes 把科學點子當成有 lineage 的對象去看,屬於 benchmark/數據集類型的項目,針對的正是 Auto Research 入面最難驗證的一環:模型能否講清楚一個 idea 由邊度嚟、點樣修補舊限制,最後點解值得延伸。

現有做法好多時集中在 related paper retrieval、proposal writing,或者用開放式生成結果做人手印象分。作者認為呢種範式捉唔到 inheritance tracing 同 evolutionary reasoning,所以提出 IdeaGene-Bench(IG-Bench),把任務分成封閉式測試 IG-Exam,同埋用 Population-Evolution Score(PES)評分的 IG-Arena,前者問理解是否精準,後者先看生成內容有冇 lineage 根據。

項目的可取之處,在於它唔只問「像不像新點子」,而係追問 Heredity、Variation、Selection 有冇成立。資料規模亦算完整,包括 1,961 條 golden lineage traces、1,085 個 Idea Genome objects、920 筆 GenomeDiff records,覆蓋 10 個 scientific domains;IG-Exam 進一步拆成 42 類 task、1,029 個 closed-form instances,適合做可重覆比較。

  • IG-Exam 主要測 abstraction、inheritance tracing、evolutionary reasoning、lineage verification
  • IG-Arena 針對開放式提案生成,用 PES 檢查血統延續與變化是否合理
  • 項目可用 OpenAI-compatible API 跑 smoke test 或完整評測,不一定綁死單一模型
  • 現有結果反映難度高,最佳 IG-Exam exact accuracy 只有 27.3%,最佳 T4 verification 為 17.4%
  • 榜單涵蓋 GPT、Claude、Qwen、Gemini、DeepSeek,以及 AI Scientist v2、Codex、Claude Code 等系統

部署理解上,這不是拿來直接替代研究助手的成品工具,而是用來測試模型或 agent workflow 是否真的具備「科研點子血統推理」能力。較適合做 AI scientist、research agent、proposal generation pipeline 的團隊評測基準;想比較不同模型、judge 組合,或者檢查生成提案有冇沿住正確 lineage 發展,這個項目比一般文字基準更有辨識度。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Qwen, 微軟, OpenAI, DeepSeek, Gemini, API, 框架, Anthropic, 中國, Dataset 數據集

TESSERA 把全年衛星影像壓成地表嵌入圖

想用衛星資料做分類或預測,最麻煩往往不是模型,而是前處理。TESSERA把一整年 Sentinel-1 與 Sentinel-2 壓成每像素 embedding,先替下游分析省走一大截工夫。

banner

做地表分類、樹冠高度預測,或者想先整理一塊區域的衛星時序資料,卡位通常出在雲遮、感測器差異同時間序整理。TESSERA 屬於地球觀測 foundation model,核心做法係把一年份 Sentinel-1 同 Sentinel-2 觀測壓成 10m 解析度、逐像素的 representation(embedding)map,讓後續任務直接食用較穩定的特徵,而唔使每次由原始影像重新清洗。

TESSERA 同常見只做 cloud-free composite 或單時點特徵抽取唔同。作者明顯想保留 temporal-spectral 訊息,將不規則觀測、光學與雷達資料一齊編碼,所以它較像先建好一層通用地表表示,再交畀分類、回歸或視覺化項目使用;代價係流程唔算輕量,現階段亦仍然係 alpha,對外存取有限。

部署流程分成資料預處理、推理、再把輸出的分塊結果拼回最終 representation map;輸入會包括 ROI 的 TIFF、Sentinel-1/2 的起止日期,而且目前 downsample rate 只支援 1,即維持 10m 解析度。README 亦提到要先看完整教學,並涉及 Docker 與一定硬件需求,較適合有遙感或資料工程能力的團隊測試。

  • 把全年 Sentinel-1 與 Sentinel-2 壓成逐像素 embedding,而唔係只輸出單次影像結果
  • 適合接駁土地分類、樹冠高度預測、表示視覺化等下游任務
  • 目前偏研究與內部測試階段,外部使用門檻仍然存在
  • 10m resolution、TIFF 輸入、按時間範圍抽取資料,工作流相對完整但較重

相關模型 TESSERA 前身為 BTFM;延伸資料亦顯示 TESSERA v2 研究緊 pixel-wise EO foundation models 點樣擴展,並包含 0.5B、1B,以及訓練中的 2B 模型,再蒸餾成較細的 student。當中 21M 參數的 distilled 版本主打 embeddings-as-data 部署,仲提供 MATRYOSHKA representations,16 維前綴已可保留大部分 128 維表現。對想長期經營遙感特徵底座的團隊,呢個方向比逐任務重訓更有吸引力。

項目主頁 · GitHub · Paper

Categories: 開源, Embedding, 模型, NVIDIA, Dataset 數據集

CrossViewTokenFusion:乳房 X 光雙視角分類新路線

同一個病灶在兩張乳房 X 光角度入面,線索未必一致。CrossViewTokenFusion 想處理的,正正是點樣保留兩個視角各自訊息,再逐層交換關鍵證據。

Repository image for PartAI-Projects/CrossViewTokenFusion

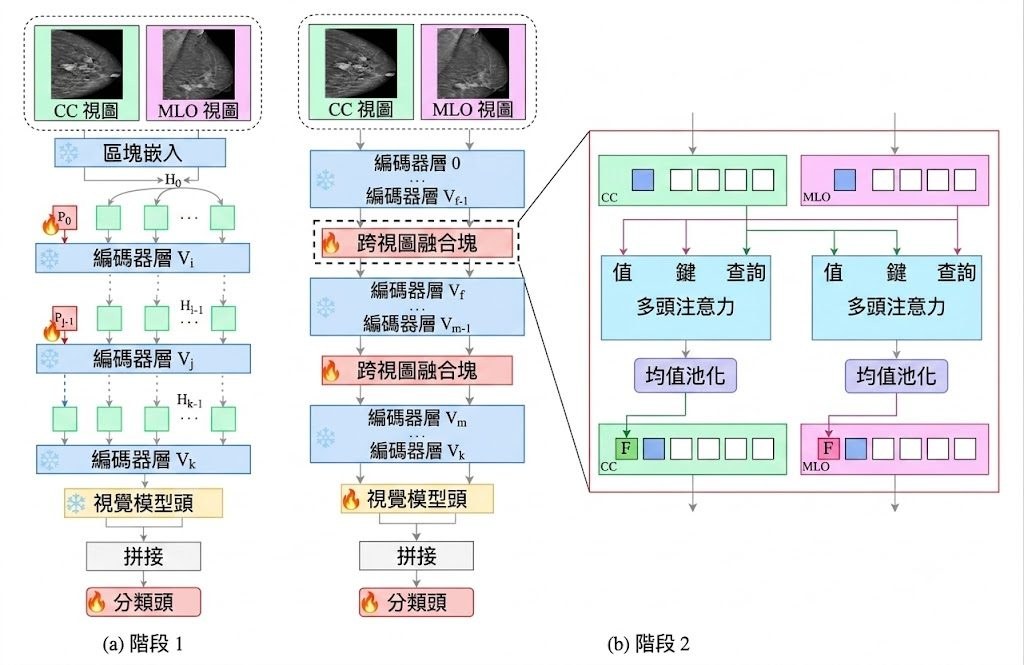
臨床判讀乳房 X 光唔會只望單一角度,但不少多視角方法仍然偏向把特徵提早合併,或者只做一次 cross-attention,結果容易把 view-specific 線索同共享資訊混埋。CrossViewTokenFusion 屬於醫學影像分類模型/研究原型,針對 dual-view mammography classification,重點係讓 CC 與 MLO 兩個視角以 token 為單位逐步交換資訊,而唔係一開始就粗略融合。

項目建基於 frozen MedSigLIP vision model,採用兩階段流程:先做 deep prompt learning 適配,再做 cross-view token-based fusion。作者批評既有 multi-view learning 常見的 feature-level aggregation 同 single-stage cross-attention 互動太淺,於是改用 dedicated fusion tokens 作為中介,透過 cross-attention 在多個 transformer 深度反覆傳遞雙向訊息,之後再把 fusion tokens 放回 token sequence 繼續細化。

部署要求先準備 VinDr-Mammo 或 CMMD(Chinese Mammography Database),再做 preprocessing、stage 1 訓練、stage 2 訓練,最後載入 checkpoint 測試。

它比較適合做醫學影像研究、醫療 AI 團隊驗證多視角融合設計,未見到直接面向臨床系統的封裝介面。

  • 舊範式多數用 feature-level aggregation 或單層 fusion;這個項目改為 multi-depth token 互動
  • 以 frozen vision transformer backbone 配合 prompt learning,取向係少改主幹、多做適配
  • 公開資料集包括 VinDr-Mammo 同 CMMD,方便學術重現與橫向比較
  • VinDr-Mammo BI-RADS classification 達到 50.40% F1-score、0.8090 AUC
  • 相比 dual-view fusion baseline,二分類設定下 AUC 提升 0.10

它的價值係重新定義雙視角點樣溝通:保留各自結構,再用 fusion tokens 逐層傳遞互補證據。

GitHub · Paper

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Medical醫學

SPLASH 讓小型 MLLM 學會觸覺

SPLASH想處理的,不是單純加一個感測模組,而是令小型多模態模型學觸覺時唔會忘記原本的視覺語言能力。你可以把它理解成一種有節制的微調方法,專門避開災難性遺忘。

figure

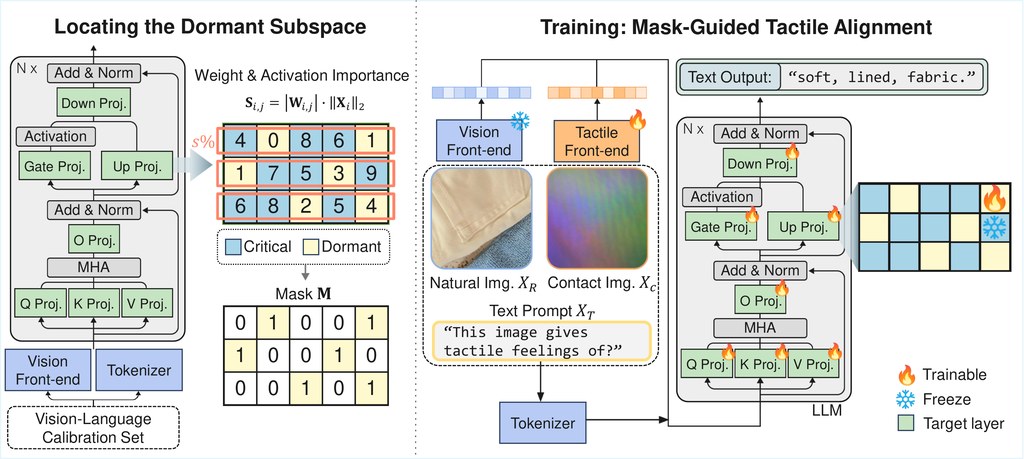
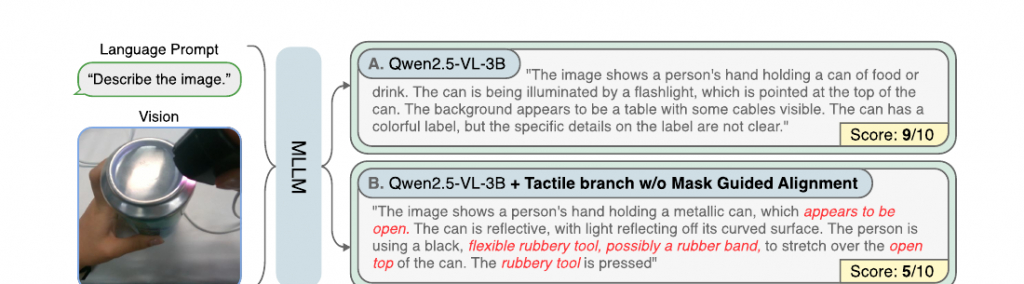
想將觸覺資料接入小型多模態模型,最麻煩的地方往往不是接唔接到,而是模型一邊學「摸到乜」,一邊把原本「睇到乜」的能力搞亂。SPLASH屬於模型訓練框架,針對的正是 MLLMs 在加入 tactile perception 後容易出現的 catastrophic forgetting,目標是在保住 vision-language 能力之下完成 visuo-tactile 對齊。

它的取向幾清楚:唔係全面重訓,也唔係隨便加一條 tactile branch 就算,而是先在 LLM backbone 入面找出較「沉睡」的參數空間,再把觸覺學習限制在呢部分。項目提到它用 weight 與 activation importance scoring 生成 dormant masks,之後做 mask-guided sparse training;好處是唔使大幅動到關鍵視覺語言參數,代價則是整個流程仍然偏研究型,部署前要先備好資料集、分割資料,同時需要 CUDA 12.0 以上與至少兩張 GPU 做分散式訓練。

現有版本主要有兩個模型變體:SPLASH-1B 以 InternVL2.5-1B 為 base MLLM,SPLASH-3B 則建基於 Qwen2.5-VL-3B,兩者都配合 ViT-Tiny + MLP adapter 作 tactile frontend。資料部分亦唔算輕量,除了 LLaVA-CC3M-Pretrain-595K 與 CC3M 用來生成 mask,仲要配合 Touch-Vision-Language-Dataset、TacQuad 等項目做訓練與 OOD 評估,所以它比較適合做多模態研究、機械感知、或想驗證觸覺—視覺聯合推理的團隊。

  • 重點不在新增多少參數,而在把觸覺更新隔離到 dormant subspace
  • 基底模型包括 InternVL2.5-1BQwen2.5-VL-3B
  • 觸覺前端採用 ViT-Tiny + MLP adapter
  • 評估覆蓋 SSVTP、TVL、TacQuad,並強調保留原有通用能力

以公開資訊判斷,SPLASH最值得留意的不是單一 benchmark 分數,而是它明確押注「non-destructive modality expansion」:讓模型多學一種感官,而唔需要用視覺能力做交換。對打算在緊湊參數預算下擴展 MLLMs 感知模態的研究項目而言,這個方向比單純追高表現更有參考價值。

項目主頁 · GitHub

Categories: 開源, 多模態模型, 模型訓練, Qwen, NVIDIA, Dataset 數據集

AgentCanvas:把 embodied agent 變成可編輯圖譜

想試 embodied agent,最花時間往往不是想法,而是把模擬器、模型與工具串起來。AgentCanvas 把這層 execution stack 圖像化,方便研究團隊直接改結構、跑實驗、比較結果。

AgentCanvas editor: the MapGPT executor loads as a node-and-wire graph, then a live R2R episode runs end-to-end

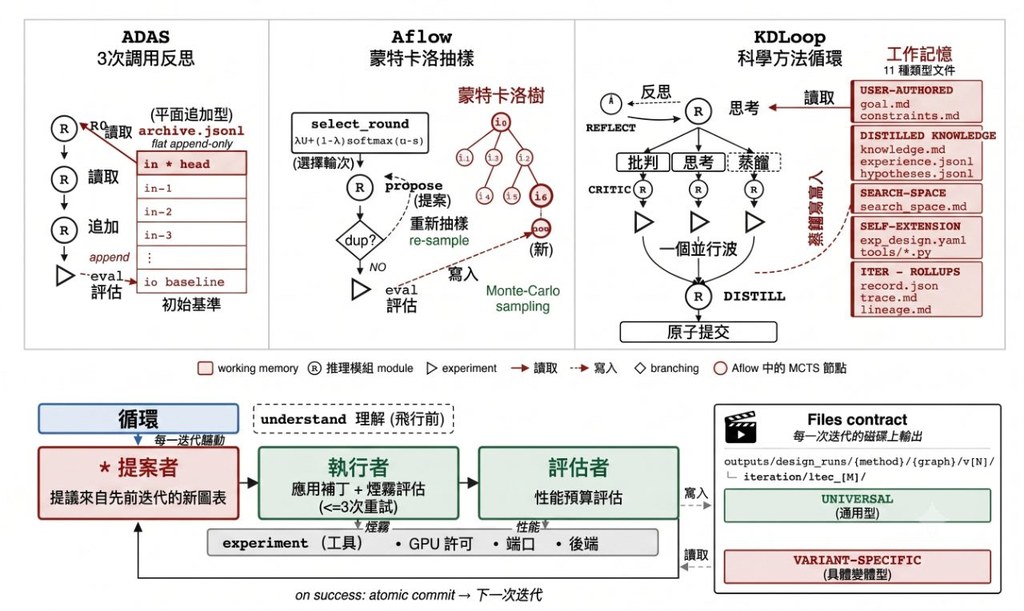
卡位不在模型夠唔夠新,而在整個 embodied agent 系統太厚:simulator、perception、memory、planning 同 control 全都要接通。AgentCanvas 把這件事收斂成可執行的 typed graph 平台,用單一 JSON 保存一個 agent 結構,讓 VLN、EQA、VLA 一類工作不再每次都由 execution layer 重搭起步。

這個項目是把 embodied agent 改寫成可視化、可重播、可修改的圖譜程式。現有做法多數靠手寫 imperative code 逐層綁死 simulator、工具與 foundation models,作者認為這種範式難以比較、難以重現,也不利 architecture search;所以 AgentCanvas 先提供 substrate,再用 KDLoop 與 AAS 讓 coding agent 反覆改圖、驗證、再分析。

AgentCanvas 重點放在把 agent 結構標準化,而不是只交一份論文內部 executor。你可以在 editor 直接載入節點圖,跑真實 R2R episode,也可接 Habitat-Sim、MatterSim、SAPIEN/ManiSkill2、MuJoCo/robosuite 這些 simulator;新加入的 Source tab 還可就選定 node 回看 source slice,改完再 syntax-checked hot-reload,這對反覆試設計特別有用。

  • 支援 hand-built graphs,也支援 AAS 自動搜尋 agent 架構
  • 已接入 29 個 foundation models,包括 Qwen3-VL、InternVL3、Gemma 3、SmolVLM2、SigLIP2、OWLv2、Grounding DINO
  • 可覆蓋 VLN、EQA、VLA 與鄰近 embodied 任務
  • 研究預覽版已開源,環境基礎要求為 Python 3.10+

受益最明顯的,會是做 embodied AI 的研究團隊、要重現論文 executor 的學生,以及想比較不同 graph 設計而不是重寫整個系統的人。現階段它仍是 pre-1.0 research preview,性能數字應結合原論文結果閱讀;但單看定位,AgentCanvas 最有價值的地方,是把「難以維護的 agent 系統工程」變成「可被搜尋與修改的圖譜工作流」。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 多模態模型, Qwen, Gemini, VLA, 框架, Vibe Coding, Python, 編程, Anthropic, Dataset 數據集

Page 37 of 92
1 35 36 37 38 39 92