Self-in-Space 補上無人機空間理解盲點

無人機睇得見環境,未必真正理解自己點樣移動。Self-in-Space把評測、數據同模型放埋一齊,專門拆解呢個落差。

Teaser

講無人機視覺理解,很多方法集中在環境辨識或任務完成,但較少正面處理飛行器本身的狀態感知。Self-in-Space屬於研究型基準測試、訓練數據集與模型組合項目,核心是把 UAV 的 spatial cognition 與 self-awareness 分開檢查,看看模型是否不只「見到空間」,亦知道自己在場景中如何移動。

作者明確批評現有 UAV-oriented MLLMs 普遍偏向 environment-centered、task-oriented 範式:重視周圍有什麼,較少處理自身運動如何影響理解。為此,他們提出 SIS-Bench、SIS-Motion-54K 與 SIS-Motion,重新把 aerial understanding 拆成 perception、memory、reasoning 三層,再同時覆蓋空間與自我兩條軸線,令問題定義比一般影片問答 benchmark 更貼近 embodied UAV 場景。

SIS-Bench 包含 1,646 段真實 UAV 影片與 4,856 組 QA,覆蓋 13 個任務;團隊用它測試 26 個 video MLLMs,包括 6 個 proprietary models 與 20 個 open-source models。結果指出兩個穩定現象:模型對 self 的建模弱過 space,而且能力會由 perception 走到 memory、再到 reasoning 時逐步下跌,這個診斷比單看整體分數更有參考價值。

  • 結合 benchmark、training dataset 與 motion-aware model,不是單一模型發佈
  • 直接針對 UAV embodied intelligence 的 self-awareness 缺口
  • 評測設計有清楚分層,方便看出模型在哪一段開始失準
  • SIS-Motion 嘗試用 motion-aware representation 改善 aerial video understanding
  • 已公開 SIS-Bench 與 SIS-Motion-54K,可在 Hugging Face 或 ModelScope 了解內容

這項目的受眾很清楚:做 UAV 視覺、aerial video understanding、embodied AI、video MLLMs 評測的人,都會較容易用得着。現階段它更像研究與比較基礎設施,而不是即裝即用產品;想部署測試,較合理做法是先從 SIS-Bench 驗證現有模型在 self-awareness 與 spatial reasoning 的表現,再看 SIS-Motion 是否能為下游 UAV navigation tasks 帶來可轉移的增益。相關模型與資源以 SIS-Motion、SIS-Bench、SIS-Motion-54K 為主,並且對照了多個 video MLLMs 的表現。
項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, 字節跳動, 多模態模型, 模型訓練, Qwen, Gemini, Video, Dataset 數據集

awesome-Self-Improving-Agents:拆解自我改進 Agent 地圖

想追蹤 self-improving agents 點樣由概念走到方法,呢個整理庫比單看論文更省時間。它把分散做法收成一張可導航地圖,方便快速判斷研究路線。

Main figure of the survey

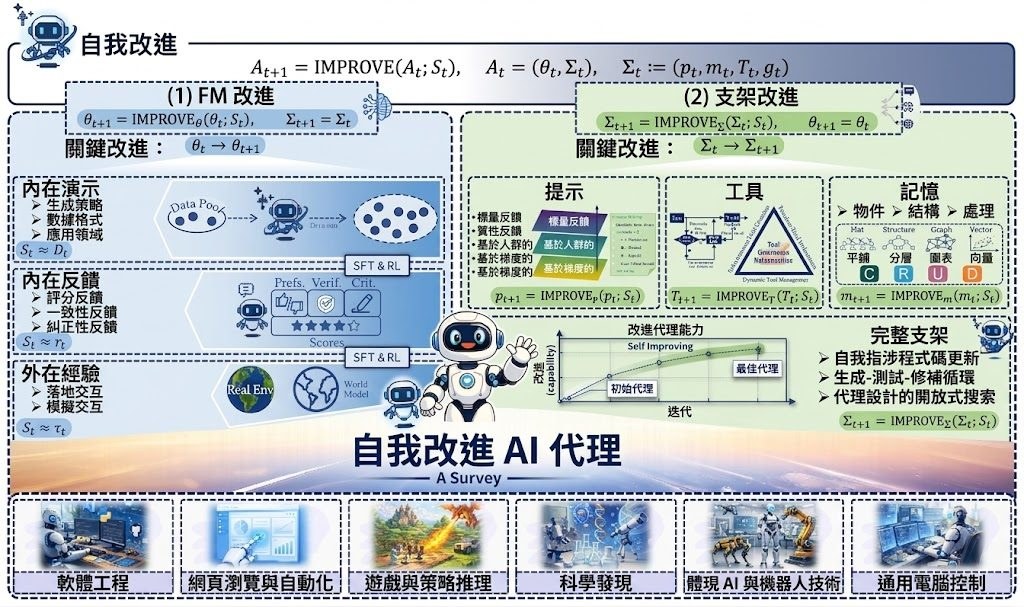
當大家都在談 Agent 會否愈跑愈聰明,真正麻煩的往往不是資料太少,而是做法太散、名詞太多、更新位置又不一樣。awesome-Self-Improving-Agents 把這件事整理成一個論文地圖型資源庫,核心不是教你直接部署系統,而是幫你分清楚 self-improving agentic systems 究竟在改進模型本身,還是在改進 prompt、memory、tools 與 control logic 這些外圍 scaffolds。

現有討論常把各類自我改進方法混在一起看,作者則用一條很實際的分界重組內容:一邊是 Foundation Model Improvement,另一邊是 Scaffolding Improvement。這個切法的好處,是你很快知道某篇工作追求的是更持久但較重的參數更新,還是較快、較平、亦較容易回退的代理層更新,閱讀時不會把 LoRA、工具路由、記憶結構調整當成同一類問題。

它不是可即裝即跑的軟件工具,更像研究與產品規劃都用得著的索引庫。你可以直接從 GitHub README、survey hub 同 arXiv 論文交叉閱讀;要測試這個項目的價值,最直接的方法是按 taxonomy 揀一條路,例如 Intrinsic Generative Demonstrations、Intrinsic Evaluative Feedback,或者 memory、tool refinement、full scaffolding,看看它能否幫你更快找到代表性工作與相近分支。

  • 把 self-improvement 分成 Foundation Model Improvement 與 Scaffolding Improvement 兩大路線
  • 收錄 239 篇 papers,當中 73 篇屬 FM improvement,166 篇屬 scaffolding improvement
  • 細分到 Intrinsic Generative Demonstrations、Intrinsic Evaluative Feedback、dynamic tool routing、autonomous tool creation 等機制
  • 適合研究員、Agent 產品團隊、技術寫作者整理文獻脈絡與比較方法取向

相關模型與系統脈絡圍繞 Foundation-Model-Based Agents 展開,但這個項目本身不提供單一模型權重或 benchmark 分數,也不是 OSWorld 那類直接跑任務的評測框架。它的價值在於建立閱讀順序與判斷框架;想找可落地的 agent 改進方向,這份 curated map 比單篇 survey 更接近工作清單。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 模型, 多模態模型, Meta, Dataset 數據集

PalmClaw 把手機變成可落地 AI 助理

PalmClaw唔係把桌面代理硬搬上手機,而係直接把 Android 當成代理運行環境。想要私隱、速度同部署簡化兼顧,呢個方向幾有意思。

PalmClaw Line Logo (light mode)

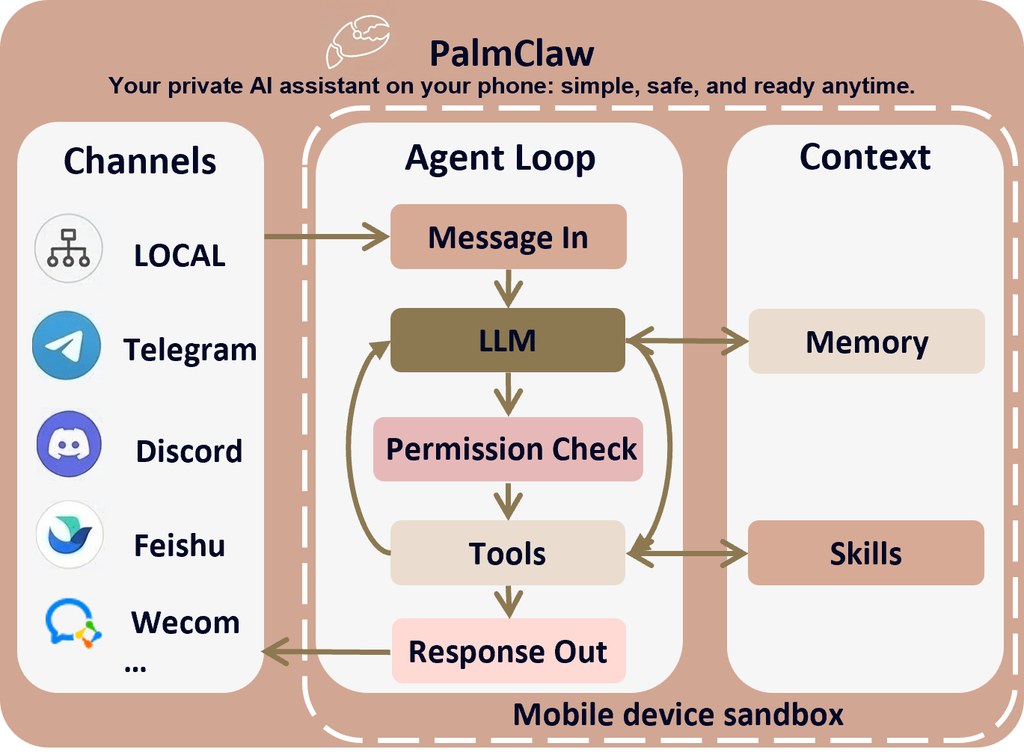
想在手機上跑 AI 助理,最大問題通常唔係模型夠唔夠聰明,而係行動流程太依賴點擊介面、太多步,又難清楚限制每次操作。PalmClaw 選擇唔跟 GUI 自動化嗰條路走,而係做成一個原生 Android 代理框架,直接在裝置內管理 session、memory、skills、tools 同 agent loop,處理的是「手機可唔可以自己成為代理執行環境」呢個問題。

同類做法很多會把手機當成一個要被點擊、滑動、輸入的目標畫面,PalmClaw則把裝置能力包裝成有明確參數同結構化結果的 device tools。呢個取向的好處很直接:動作邊界更清楚,執行鏈更短,亦較少受介面改版影響;代價是它偏向整合系統能力與通道,而唔係模擬人手操作所有 App 畫面。

安裝理解上亦算直接,項目已提供 APK,重點不是先搭 server,而是把代理本身部署到 Android。應用程式內可管理設定、工具同 channels,並連接 Telegram、Discord、Slack、Feishu、Email、WeCom 等通道;資料與硬件存取留在本機,較適合在意私隱、想減少雲端依賴的個人用戶,或者要做流動工作流驗證的小團隊。

  • 原生 Android 代理框架,重點在裝置內執行而非遙控手機介面
  • 沿用 OpenClaw 啟發,但定位更貼近直接 mobile deployment
  • 提供 APK,可在手機內完成設定、工具管理與通道連接
  • 論文數據提到,相比最強基線有 11.5% 相對任務成功率提升,完成時間減少 94.9%
  • 相關脈絡包括 OpenClaw,以及以 Large Language Model(LLM)agent 為核心的 session、memory、skills、tools 架構

PalmClaw最值得留意的地方,在於它把手機代理由「會操作畫面」改成「直接調用裝置能力」。對想把 AI 助理放進日常通訊與個人裝置流程的人來說,這種 local-first、明確工具邊界的設計,比純粹追求花巧自動化更接近可長期使用的方向;現階段平台重心明確落在 Android,跨平台與生態覆蓋仍要看後續發展。

項目主頁 · GitHub · Paper

Categories: 開源, 香港理工大學, Agentic, Gemini, 香港, Discord, OpenClaw, Anthropic, Skill 技能

EgoMemo 讓助手懂得幾時先開口

唔少助手識回應,真正難的是判斷應否打擾你。EgoMemo把連續第一身影片整理成可檢索記憶,嘗試把主動提醒變成可評測的能力。

Repository image for SitongGong/EgoMemo

助手最難處理的,不是看見了甚麼,而是判斷幾時該出聲、幾時應該保持安靜。EgoMemo對準的正是這個空位:它屬於一個面向連續第一身影片的記憶增強代理系統,同時附上 benchmark,目標是讓系統根據累積情境主動提供服務,而不只是等人發問或對每個事件都作反應。

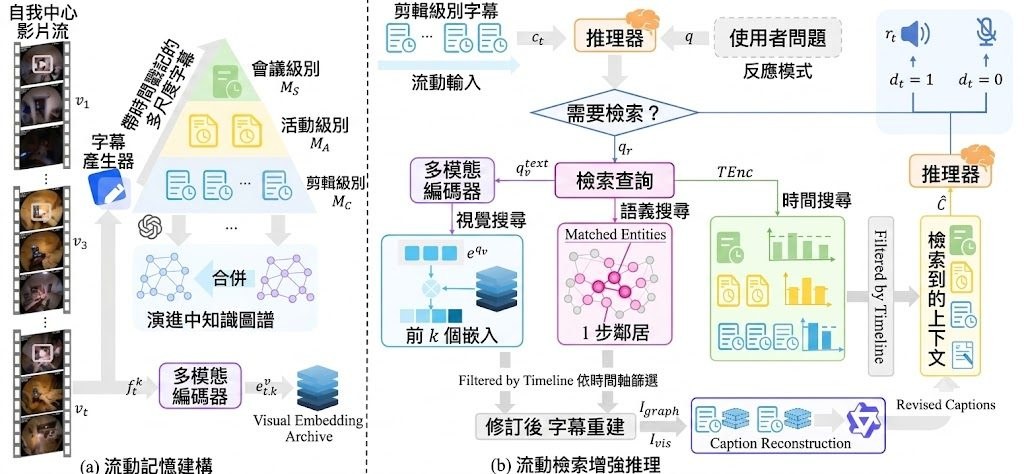
現有做法多數落在兩個範式:reactive,只會被問到先答;semi-proactive,偵測到預先定義事件就回應。作者認為這兩類方法都欠缺對使用者歷史、當前活動與介入時機的判斷,所以用 EgoServe 重新定義問題,把主動協助視為 context-dependent decision problem,再由 EgoMemo用 three-level temporal memory graph、semantic knowledge graph 同 visual embedding archives 做 retrieval-augmented reasoning。

這個 GitHub 項目不止放出模型思路,亦包含 memory-graph construction + retrieval pipeline、evaluation suite、dataset annotation 與 streaming demo。理解部署方式並不複雜:先準備 Python 3.10 環境與 .env 內的 API keys、資料路徑,再下載 EgoServe 註釋及對應來源影片,之後按不同資料集分開執行 processing 與 retrieval 兩階段,前者建立記憶圖,後者生成 proactive-service response。

  • EgoServe 收錄超過 3,000 個 service instances,橫跨 4 個 temporal memory horizons 與 10 類服務
  • EgoMemo 採用 training-free 設計,重點放在記憶組織與檢索,而不是再訓練一個大模型
  • 項目同時支援 EgoLife、HoloAssist、CaptainCook4D、EyeWo / ESTP-Bench、OVO-Bench 等資料來源
  • retrieval 可切換 caption retrieval、visual retrieval 等設定,方便做 ablation

EgoMemo 不是追求單次問答表現,而是補上長時間情境累積後的判斷能力。受益最大的是做 egocentric AI、智能助理、穿戴式裝置或多模態 Agentic 項目的研究團隊;限制也同樣直接,整個流程依賴外部影片資料、API keys 與多階段處理,重點更接近研究基線與評測框架,而未算一個即裝即用的消費級產品。相關模型與組件方面,儲存庫示例已出現 QwenVL 3 8B Instruct、GPT-5、Gemini 等作為 caption 或 response 端選項。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Embedding, 多模態模型, 模型訓練, OpenAI, Gemini, API, KnowledgeGraph, Python, Dataset 數據集

Hallo4D 點樣補救 3D 與 4D 生成穿崩

3D同4D生成最怕畫面一轉角度就走樣,或者動起來之後角色忽然變臉。Hallo4D想處理的,正正是這類跨視角、跨時間都難收拾的失真。

4d boy

做3D同4D內容生成,最麻煩往往唔係單張畫面唔夠靚,而係鏡頭一轉、時間一推進,物件結構開始重複、錯位,角色仲會出現 jitter、identity flicker 同 structural drift。Hallo4D沿住呢個痛點出發,屬於一個研究型框架,重點唔係再訓練新模型,而係插入現有流程,幫3D與4D生成結果找出並修正時空不一致。

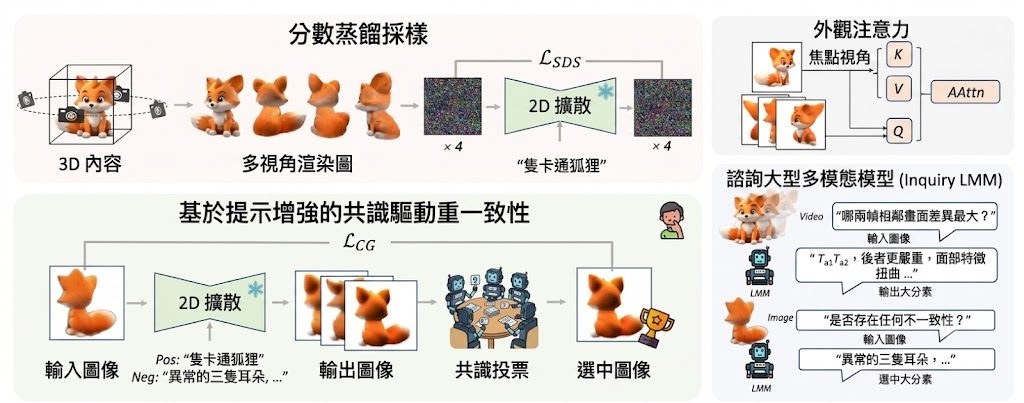
而家常見做法多數仍然依賴 2D diffusion-based supervision,但欠缺直接約束幾何一致性的機制,所以會出現 duplicated structures 同 misaligned geometry;去到4D,問題再擴大到時間軸。Hallo4D提出的是 generation-detection-correction 範式:先生成,再用 Large Multimodal Models(LMMs)從 multi-view、multi-frame renderings 判斷邊度出錯,之後以 image-space consistency optimization 做修正,並用 multi-model voting 揀較穩定的候選結果。

它不是跟同類方法鬥基礎生成能力,而是做一層 tuning-free、model-agnostic 的補救機制,聲稱毋須 retraining 或 architectural modification。代價亦很明顯,整個流程更依賴外部 LMM 推理、候選修正與投票判斷,較像高質後處理,而唔係最省算力的路線。

  • 重點放在 spatio-temporal hallucination mitigation,不是直接取代原有 3D / 4D 生成模型
  • 用 LMMs 檢查多視角、多幀輸出,再引導修正不一致位置
  • 針對時間穩定性加入 optical flow 驅動的 keyframe sampling
  • 以 CSEA、log-dynamic-range loss 同 union-of-frusta visibility pruning 處理曝光崩壞

目前較適合當作研究方法理解,而不是即開即用的產品工具。測試方式大致應是把它接到既有 Text-to-3D、Image-to-3D 或 4D pipeline,對比 baseline 與修正後結果,觀察多視角幾何、角色身份穩定度同曝光控制有無改善;頁面亦提供多組 visual comparisons,以及在 SV4D 的額外 4D 場景結果。

十分適合本身已經在做 3D / 4D 生成、又經常被跨視角穿崩同時序閃爍拖慢流程的研究團隊。相關脈絡亦值得一併看:Hallo3D主攻 multi-view-consistent 3D generation,Hallo4D則把範圍擴展到統一處理 3D + 4D 的時空一致性;量化表現,現有儲存庫文字未見完整指標表,判斷仍要以論文與項目頁面的可視化對比為主。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, Image, 3D, 中國, Dataset 數據集, 任何模型

MetaView 補回生成的空間感

只用一張相就想轉出大幅度新視角,最難是畫面似真之餘仲要守住空間比例。MetaView 針對的正是這個卡位。

teaser

單靠一張圖片生成大角度新視角,很多方法一轉得遠就會出現結構鬆散、比例飄移,鏡頭控制亦未必準。MetaView 屬於影像生成框架,集中處理 monocular novel view synthesis,目標是在不做顯式 3D reconstruction pipeline 的前提下,仍然保住 geometry consistency 同可控的 camera pose rendering。

它的取向幾清楚:唔想被重建流程綁死泛化能力,但又唔接受純 implicit 方法常見的 scale drifting。項目把 Depth Anything 3 提供的 implicit geometry priors 接到 pretrained MM-DiT backbone,做法是加入 non-invasive parallel attention layers;同時再用 modified RoPE,配合 PRoPE 為 z-axis 留出額外子空間,把場景尺度固定在較一致的 3D metric space。

對研究團隊、做 novel view synthesis、3D-aware image generation,或者需要從單張圖控制鏡頭輸出的工作流,這個項目值得留意。現有資訊較像研究原型:README 與 project homepage 已提供 paper、demo 與 model 入口,但未見完整安裝與部署細節,所以現階段較合理的理解方式,是先用 demo 看大視角轉換與 spherical poses control 的效果,再等待公開模型與程式流程補齊。

  • 單張圖片輸入,主打大幅度 viewpoint changes 下仍保持高保真輸出
  • 不走 explicit 3D reconstruction pipelines,換取更高彈性與泛化空間
  • 用 Depth Anything 3 幾何先驗補結構,再用 modified RoPE 處理 scale anchoring
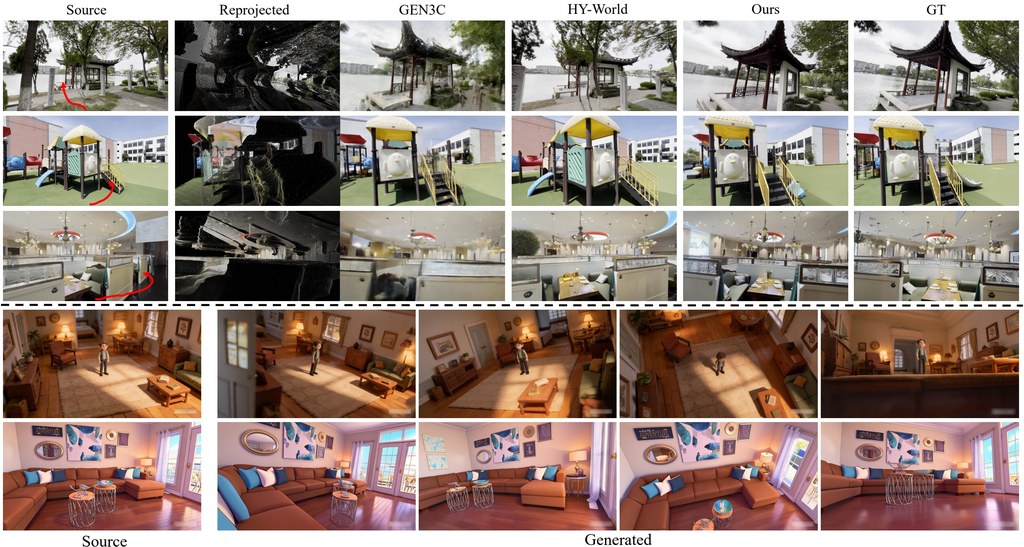
  • 比較對象包括 ViewCrafter、Gen3C、Voyager、PE-Field、HY-World、Lingbot-World

MetaView 在具挑戰性的 monocular large viewpoint changes 測試中,表現優於多個 reconstruction-based 與 implicit 方法,強調的是 geometry consistency、precise controllability 與 generalization。現階段較適合把它視為一個方向鮮明的研究項目:它不是單純追求更靚畫面,而是嘗試把單圖生成長期欠缺的空間尺度感補回來。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 模型, Image, 影像模型, 香港, 3D

GigaWorld-Policy-0.5 推向機械人即時反應

機械人要邊看邊動,卡位往往不在「會不會做」,而在「能不能夠即時做」。GigaWorld-Policy-0.5嘗試用更輕量的推理路徑,保留世界模型訓練收益,同時壓低本地延遲。

機械人控制最難受的地方,常常不是動作生成本身,而是模型一邊理解畫面、一邊預測未來場景時,推理成本高到難以閉環運作。GigaWorld-Policy-0.5屬於 World Action Model(WAM),重點是保留未來視覺動態對訓練的幫助,但在執行階段只解碼動作,減少為了生成未來影片而付出的額外開銷。

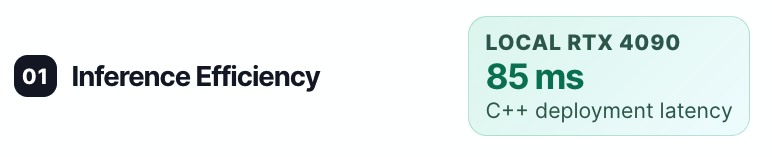
它延續 action-centered 的路線,再加入 Mixture-of-Transformers 架構,將視覺建模與動作生成分成不同 expert。咁樣做的取捨很清楚:訓練期間仍然利用未來場景演化強化動作學習,推理時則走較輕的 action-only pathway,提升即時控制效率。資料提到,它在本地 RTX 4090 上可做到 85ms inference latency,目標就是支援更接近即時的部署。

另一個值得留意的位置,是它不只改模型結構,亦加入 agent-based AutoResearch pipeline 來搜尋訓練配置。這種做法主要是減少手動調 hyperparameter 的時間,讓實驗設定更有系統地被篩選。對做 Robotic、世界模型或策略學習的人來說,這比單純追求更高指標更實用,因為整個訓練流程的效率同樣影響迭代速度。

  • 保留 future visual dynamics 的訓練收益,但推理時只輸出動作
  • 用 Mixture-of-Transformers 分開 visual expert 與 action expert,降低活躍計算量
  • 以 mixed Action-Conditioned World Modeling(AC-WM)和 WAM 訓練,加強視覺與動作的耦合
  • 引入 agent-based AutoResearch pipeline,提升訓練配置搜尋效率
  • 已公開論文、程式碼與模型,方便研究用途跟進

整體來看,GigaWorld-Policy-0.5處理的是世界模型常見的速度與控制落地矛盾:訓練想要看得多、學得深,部署又要夠快。現有資料顯示,它把重心放在更有效率的 action-centered WAM 路線,適合關注即時機械人控制、閉環部署與本地推理表現的人。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, Agentic, 模型, 模型訓練, Video, Robotic, 框架, 編程

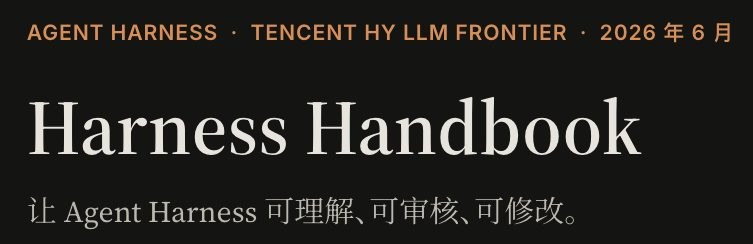
用行為地圖看懂 Agent Harness

想查清代理會唔會刪檔前先確認,最難唔係搵唔到碼,而係搵唔齊完整行為鏈。Harness Handbook 把分散實作整理成可追溯的行為地圖。

Hero image preview

想理解 coding agent 點樣真正執行、點樣做安全檢查,或者想改成自己團隊用得上的流程,卡位通常唔在於缺少文件,而在於行為分散喺大量程式碼之中。Harness Handbook 就是針對 agent harness 的整理方法,把「某個行為點樣發生」變成可導航、可核對、可修改的路徑。

它處理的是行為同實作之間斷開的問題。像「刪除檔案前會否先詢問」這類問題,往往涉及多個 implementation sites,不是搜 delete、permission、confirm 就能直接還原全貌。Harness Handbook 以 behavior-level manual 方式重組這些零散位置,讓人可以由問題出發,一步步找到對應的 behavior units、相關程式碼證據,以及可能受影響的修改位置。

  • 把分散程式碼整理成可閱讀的 behavior map
  • 每個行為步驟都連到可驗證的 code evidence
  • 支援理解、審核與修改共用同一套入口
  • 著重 human in the loop,方便持續檢查系統變化

這種做法同一般 code index 或關鍵字搜尋的差異,在於它不是單純列出檔案,而是直接對應「系統會點做」。對開發者、維護大型 agent 項目的人,或者要審視安全邏輯的團隊,都會比較實用;連 coding agents 也可借這份 Handbook 更準確找到相關程式碼。

資料顯示,項目還提供 Handbook Studio,將這套 behavior map 變成可操作的入口。現階段重點不在推出另一個模型,而是為複雜 agent harness 建立一層可解釋、可審核的結構,令系統隨版本演進時,仍然保留清晰的行為脈絡。

項目主頁

Categories: 開源, 騰訊, Agentic, 框架, Vibe Coding, 編程

KnowAct-GUIClaw 跨平台 GUI 代理

想讓代理真正代你點按、輸入同切 App,難處從來不只係識畫面。KnowAct-GUIClaw把記憶、路由同技能接埋,重點放喺長流程任務穩定完成。

GUIClaw

要代理跨桌面、Android、iOS 同 HarmonyOS 幫你做事,最易失手的位通常唔係單一步驟,而係多個 App 之間點樣接續執行。KnowAct-GUIClaw屬於 Agentic 自動化框架/工具,核心處理的是長流程 GUI automation:由理解意圖、揀路徑、執行操作,到把經驗寫回記憶與技能庫,令之後的任務唔使每次由零開始。

同類 GUI agent 常見做法,是把畫面理解同動作決策綁成單次 observe-reason-act 迴圈;作者認為這種固定範式一遇上跨 App、跨系統流程,就容易缺少任務分解、歷史經驗同可重用技能。KnowAct-GUIClaw改用 Know–Route–Act–Reflect,前面先整理證據與路由,後面再把軌跡蒸餾成 memory 同 skills,取向明顯偏向「愈用愈熟手」而唔係單次回答最聰明。

部署上有兩條路:一條是完整 host,配合 nanobot webui、gateway 同 agent 去跑;另一條是獨立 guiclaw 工具,讓其他 host、腳本或終端直接調用。GUI automation 會改變裝置狀態,驗證任務應先用 dry-run,同時用測試裝置或測試帳號,這點對企業內部流程、自動測試、數碼助理場景尤其重要。

  • 支援 desktop、Android、iOS、HarmonyOS,重點係跨平台一致流程
  • 以 memory store 同 skill store 補強長流程任務,而唔只靠即場推理
  • 在 MobileWorld benchmark 取得 64.1%,頁面稱超過多個 open agent frameworks 及部分 closed agents
  • 對不同底模有泛化效果:Kimi-2.6 提升 8.5%,Qwen3.5-35B-A3B 提升 16.2%

受惠最大的,會是要處理重複 GUI 流程的團隊,例如行動裝置測試、跨 App 任務編排、個人助理型代理開發。不過它的價值未必只在榜單,而係把 GUI agent 從「會操作畫面」推向「會累積經驗再操作畫面」。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 工具, Dataset 數據集, Skill 技能

MonkeyOCRv2 文件通用 OCR 底座

掃描文件、表格、公式到場景文字,往往要分開處理。MonkeyOCRv2想做的是用同一套視覺編碼器,接住多語言文件理解與 OCR 工作流。

overview

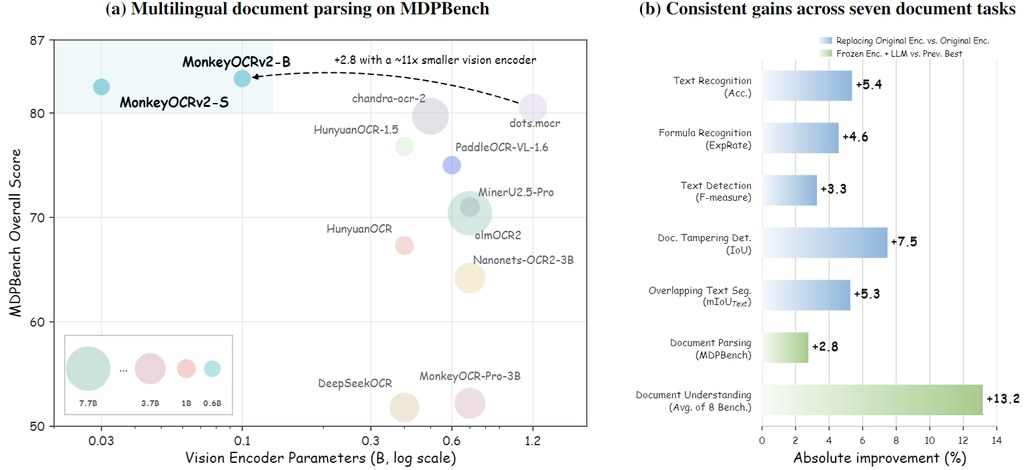
文件 AI 最麻煩的地方,在於文字辨識、版面解析、文件理解、公式辨識,甚至竄改檢測,很多時都要拆成幾個模型串起來。MonkeyOCRv2 把自己放在視覺文字基礎模型的位置,核心不是只追單一 OCR 指標,而是想用同一個 encoder 同時覆蓋多語言文件 parsing、understanding、text recognition、formula recognition 以至 scene text detection。

它採取的路線很明確:不像部分做法會按任務各自訓練小模型,MonkeyOCRv2 強調 fine-grained text modeling、cross-task representation learning 同 cross-lingual generalization,等於先把「文字作為視覺內容」這件事學得更深,再把能力分流到不同文件任務。這種取向的好處,是同一套底座較適合研究團隊或產品團隊整合工作流;代價則是現有資訊仍以模型發布為主,完整效能對比與部署細節還要結合論文與 checkpoint 再判斷。

現階段最值得留意的,是項目已不只放出單一模型名稱,而是分成幾條較清晰的能力線。 MonkeyOCRv2 vision encoder,以及面向 multilingual document parsing 的 MonkeyOCRv2-Parsing、面向 efficient document understanding 的 MonkeyOCRv2-Und,並提供 Hugging Face 與 ModelScope checkpoint,代表測試方式大致會圍繞下載權重後,按任務接入 parsing、recognition 或 understanding 流程,而不是單純打開一個聊天介面就完成。

  • 涵蓋 OCR、文件理解、公式辨識、竄改檢測、重疊文字分割等多類任務
  • 提供 MonkeyOCRv2-S、MonkeyOCRv2-B、MonkeyOCRv2-AS,不同 backbone 對應不同場景
  • S、B 版本偏向 Recognition / Parsing / Understanding,AS 版本偏向 Detection / Segmentation
  • 已公開 Demo、Hugging Face 集合與 MonkeyDocv2 數據集線索,方便交叉驗證

從現有公開資訊看,這個項目較適合做 Document AI、智能審核、票據與表單處理,也適合想比較 dots.mocr、PaddleOCR-VL、Qwen3-VL 這類路線差異的人。它未必是最輕量的選擇,但「一個編碼器橫跨多任務與多語言」這個方向,對需要長期維護文件工作流的項目有相當吸引力。

GitHub · Paper

Categories: 開源, 模型, 多模態模型, Qwen, OpenAI, 影像處理, 框架, Medical醫學, Dataset 數據集

Page 34 of 92
1 32 33 34 35 36 92