當一份文件同時夾雜模糊掃描、手寫註記、複雜表格與數學公式時,多數 OCR + 版面分析的流水線都會在交接處出錯——模型間責任不清,錯誤層層放大。騰訊 WeChat Vision 團隊開源的 WeVisDoc 系列正正針對這個痛點,把「文件頁 → 結構化 Markdown(含 LaTeX 公式、HTML 表格)」收進單一端到端模型,避免不同模組互相推卸責任。
WeVisDoc 推出 2B 與 4B 兩款模型,皆以 Qwen3-VL 為基座微調而成,覆蓋文字、公式、表格與閱讀順序四個維度。訓練方法分兩階段:Stage I 先擴大語義、結構、外觀三方面的數據覆蓋;Stage II 則用殘差診斷找出 Stage I 仍出錯的樣本,針對性地補充與重新分配訓練數據。這套做法與單純堆數據量的路線不同——它把精力集中在模型最容易跌倒的角落。
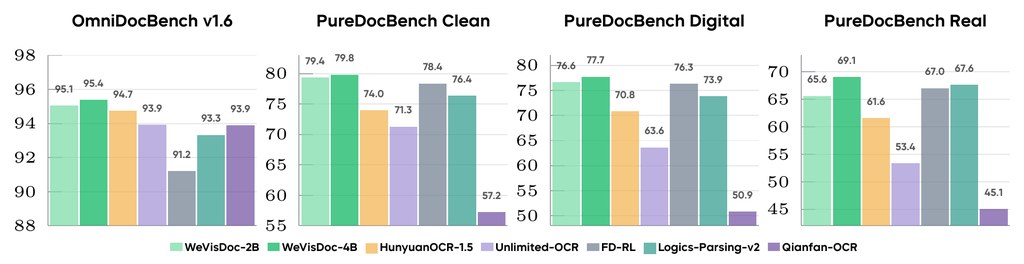
在 OmniDocBench v1.6 上,WeVisDoc-4B 取得 95.38 的 Overall 分數,三條 PureDocBench 軌道的平均分為 75.54,均為目前端到端解析器的最佳成績。在更貼近真實擷取條件的 PureDocBench Real(模擬四次實體拍攝劣化)上,相對次強基線仍拉開 1.44 分,是四個比較場景中差距最大的一項,正好對應 Stage II「在真實擷取最難看的外觀變化上獲得最大增益」的設計初衷。
對需要把大量歷史紙本文件、學術論文、表格報表轉成結構化內容的研究團隊與企業來說,WeVisDoc 提供了一個開源、可在本地用 GGUF 等格式部署的小模型選項。模型現已上載 Hugging Face,並附技術報告與互動式 Recovery Lab,方便逐頁對比 Stage I 與 Stage II 修復了哪些具體錯誤(例如被漏掉的 9×9 數獨格線)。
- 騰訊 WeChat Vision 團隊開源的端到端文件解析模型,2B/4B 兩個規模,皆基於 Qwen3-VL 微調
- 兩階段「數據中心」訓練框架:Stage I 擴大覆蓋、Stage II 以殘差診斷針對性補強
- 輸出結構化 Markdown,內含 LaTeX 公式與 HTML 表格,涵蓋文字、公式、表格、閱讀順序四維度
- WeVisDoc-4B 在 OmniDocBench v1.6 與三條 PureDocBench 軌道均居端到端解析器首位
- 開源釋出模型權重、技術報告與互動式範例頁,方便逐頁審視修復效果