SciReasoner 想把科學推理拉回結構本身

做蛋白質、分子同材料推理,只靠文字序列往往唔夠。SciReasoner把3D結構直接變成可推理證據,重點是答案背後的科學線索都盡量保留。

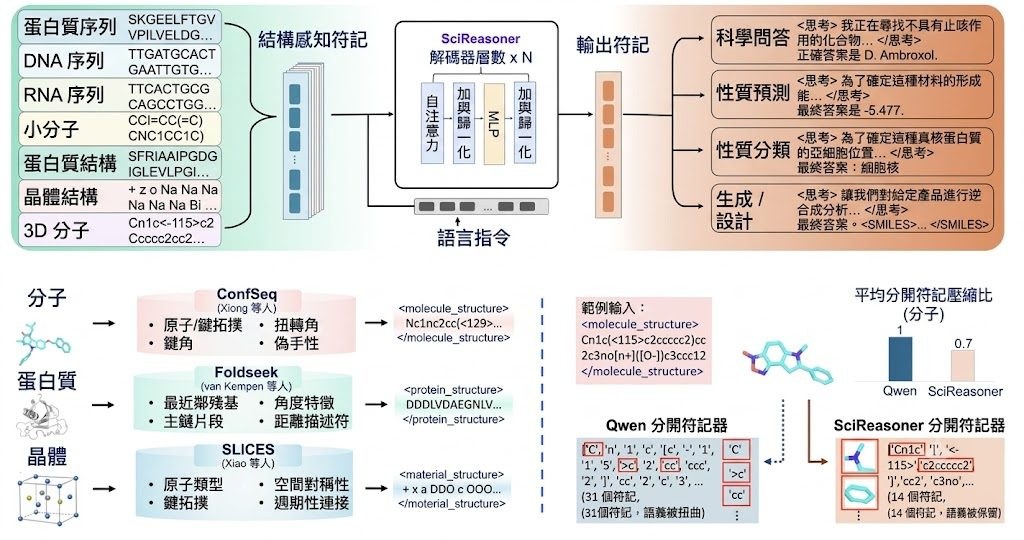
SciReasoner architecture overview

只看文字去判斷蛋白質功能、分子反應性或材料性質,經常會漏掉真正關鍵的空間結構。SciReasoner屬於多模態 scientific foundation model,針對的正是這個落差:把 protein structures、3D molecules、crystals、sequences、formulas 同 text 轉成可對照的 structure-aware evidence tokens,再用來做 scientific QA、prediction、classification 同 generation/design。

與科學資料先「文字化」再交畀大型語言模型處理的做法不同。作者明確押注 native structural reasoning,保留 Foldseek 3Di、ConfSeq、SLICES 呢類結構編碼,令模型唔係淨係讀描述,而係可以沿住 residues、fragments、conformers 甚至晶體配位環境去推理;官網展示的 traces 亦反映出,項目希望連推理路徑都可以檢查,而唔只係輸出答案。

GitHub 上的 models 同 demo 仍標示為 coming soon。換句話說,眼前較合理的理解方式係先把它當成研究型項目:閱讀 benchmark、看案例 traces,判斷它是否適合生物資訊、化學資訊或材料 AI 團隊之後的評測與整合方向,而唔係即刻下載部署到生產流程。

  • 在 86 個評測任務入面,67 個做到 state-of-the-art,對比 generalist LLM baselines 有 75 個任務表現最好
  • 與已發表的 specialist 方法相比,在 33 組比較入面有 26 組持平或更好
  • 範圍唔只化學,亦覆蓋 proteins、DNA/RNA、small molecules、3D molecular structures 同 inorganic crystals
  • traces 可檢查,雙盲專家評分中,與 DeepSeek-V4-Pro 相比有 98% 判斷屬 preferred 或 comparable

相關模型方面,SciReasoner以 Qwen3-14B 初始化,再對齊 domain-native structural vocabularies。對需要跨蛋白質、核酸、分子同材料做統一推理介面的團隊,呢個方向幾有吸引力;限制同樣明顯,因為公開模型與可直接測試的 demo 尚未提供,現階段更適合當成值得追蹤的研究項目,而唔係可即用工具。
項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, 南京大學, 模型, 多模態模型, Qwen, DeepSeek, 香港, Medical醫學, 3D, 中國, Dataset 數據集

WildCity 把城市級空間智能拉回真實街道

想做城市級重建或模擬,最缺的往往不是模型,而是夠大、夠亂、又貼近真實道路的資料。WildCity正好補上這個缺口。

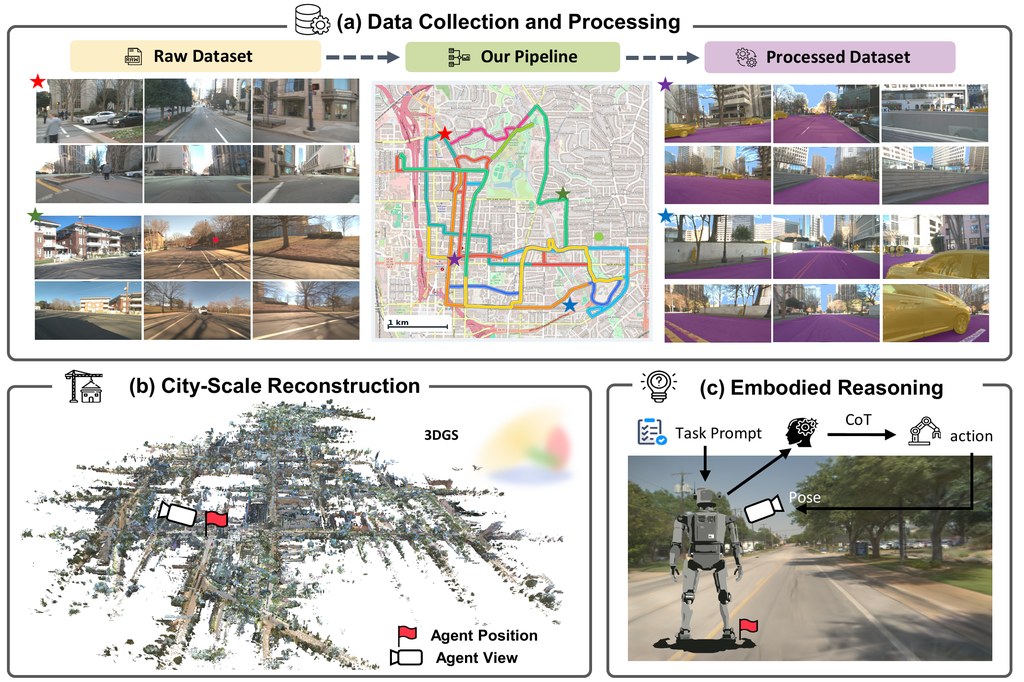
wild city

做城市級重建最麻煩的,不是把街景拼得靚,而是要在車流、光線變化、模糊影像同定位誤差同時存在時,仍然保留可用的空間結構。WildCity屬於Dataset 數據集兼研究測試平台,重點不是展示單一模型,而是提供一套面向真實城市環境的資料、重建基線與 closed-loop simulator,處理 rendering、simulation 同 spatial intelligence 之間長期脫節的問題。

這個項目的價值,在於資料規模同場景難度一齊拉高。,它覆蓋美國 6 個城市、18 段長距離行車軌跡、合共 1,507 公里,並整理成 3.01M synchronized keyframes,配合 6 個環視鏡頭、LiDAR、IMU 同 GPS。對研究團隊而言,這不只是多模態資料集,亦是一個可以檢查城市級 reconstruction、extrapolated rendering 與 embodied reasoning 能否真正落地的共同基準。

跟不少較乾淨、較短路段的資料集相比,WildCity的取向明顯更偏向「野外條件」:dynamic objects、lighting and appearance changes、motion blur、imperfect poses 都保留下來。代價是結果未必容易做得好看,但好處是更接近自動駕駛車隊、數碼孿生同機器人模擬會遇到的現實限制。它也不是即插即用型工具,因為 README 已寫明 code、dataset access 同 baseline 仍在準備釋出。

[ECCV26] WildCity: A Real-World City-Scale Testbed for Rendering, Simulation & Spatial Intelligence
  • 以真實車隊採集的城市級多模態資料為核心,而非單一演示場景
  • 除了資料集,亦規劃 urban-tailored 3D Gaussian Splatting baseline 與 closed-loop simulator
  • 適合測試大範圍 reconstruction、rendering 外推與 embodied reasoning
  • 現階段較適合先追蹤研究與評估設計,完整部署流程仍要等官方釋出

現時可以把 WildCity 理解為一個正在成形的基礎設施項目:資料已公開描述,Hugging Face 亦有資料集入口,而官方儲存庫之後會補上 loaders、evaluation scripts、reconstruction baseline 同 simulator。相關模型方向目前最明確的是 urban-tailored 3D Gaussian Splatting;若你做的是自動駕駛感知、城市數碼孿生、robotics simulation 或 spatial intelligence,這套基準值得提早留意,因為它測的不是理想條件下的漂亮結果,而是城市尺度下能否持續運作。

項目主頁 · GitHub

Categories: 開源, Agentic, 多模態模型, 世界模型, NVIDIA, Robotic, 3D, Dataset 數據集

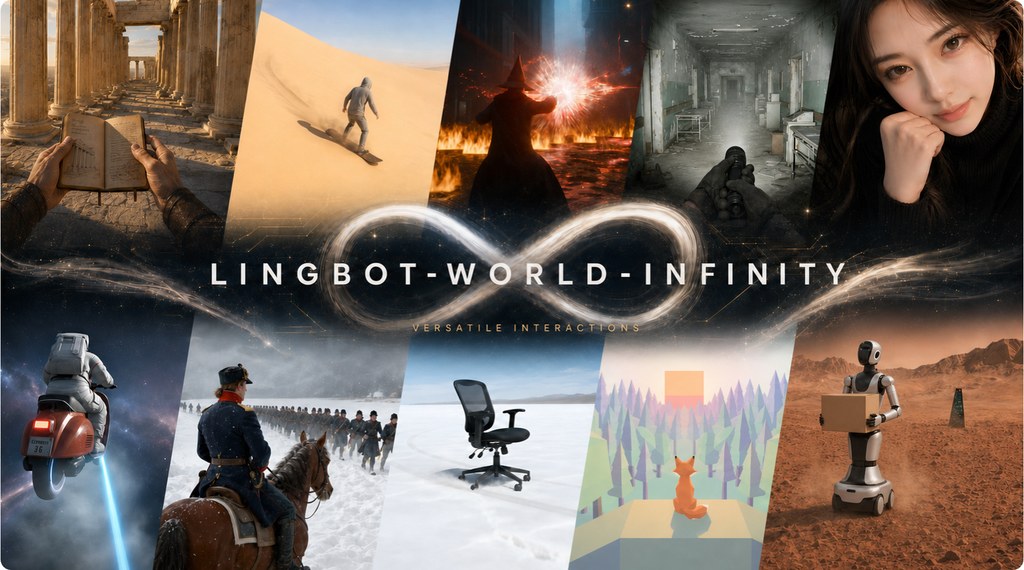
LingBot-World 2.0 把互動世界拉長

想像一個會持續生成、又跟得上操作節奏的互動世界模型。LingBot-World 2.0吸引人的地方,在於它同時追求連續性、速度與可玩性。

teaser

最值得留意的,不是單純生成影片,而是它嘗試把世界模型做成可持續互動的系統:畫面不只要動,還要在長時間互動下維持一致,並且跟得上即時操作。LingBot-World 2.0,也叫 LingBot-World-Infinity,定位上屬於模型項目,處理的是互動式世界生成容易愈玩愈散、反應又唔夠快的問題。

同類做法很多時偏向短片段展示,或者重視視覺效果多於操作連續性;這個版本反而把焦點放在「interaction horizon」拉長,同時保住輸出穩定度。它亦加入 agentic harness,由 pilot agent 規劃角色行為、director agent 補出新環境元素,方向上更接近可演進的遊戲式世界,而唔只係被動播放內容。

現階段最容易理解的試法,是先經 Reactor 的 Web 版本或 LingGuang 的流動平台體驗即時版;README 亦提供 Hugging Face 與 ModelScope 上的模型頁面。官方說明指出,平台版本方便試玩,但完整能力仍以官方設置為準,換句話說,公開體驗較適合感受互動節奏,未必等同完整表現。

  • 支援長時間互動,主打 unbounded interaction horizon
  • 提供即時變體,官方稱可驅動 720p、60 fps 影片串流
  • 動作與事件更豐富,包括攻擊、射箭、施法、射擊等互動
  • 以 pilot agent 與 director agent 分工,推進角色與場景演化

現有資料未見完整基準表或系統化對比結果,性能描述主要來自項目方公開說明,所以較適合把它視為一個展示取向鮮明的前沿模型。相關模型目前可見的是 lingbot-world-v2-14b-causal-fast;而從 Robbyant 整體路線來看,它亦與 LingBot-Vision、LingBot-Depth、LingBot-VLA、LingBot-Video 等項目一起指向 embodied AI 與世界模型的長線布局。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 多模態模型, 世界模型, Video, VLA

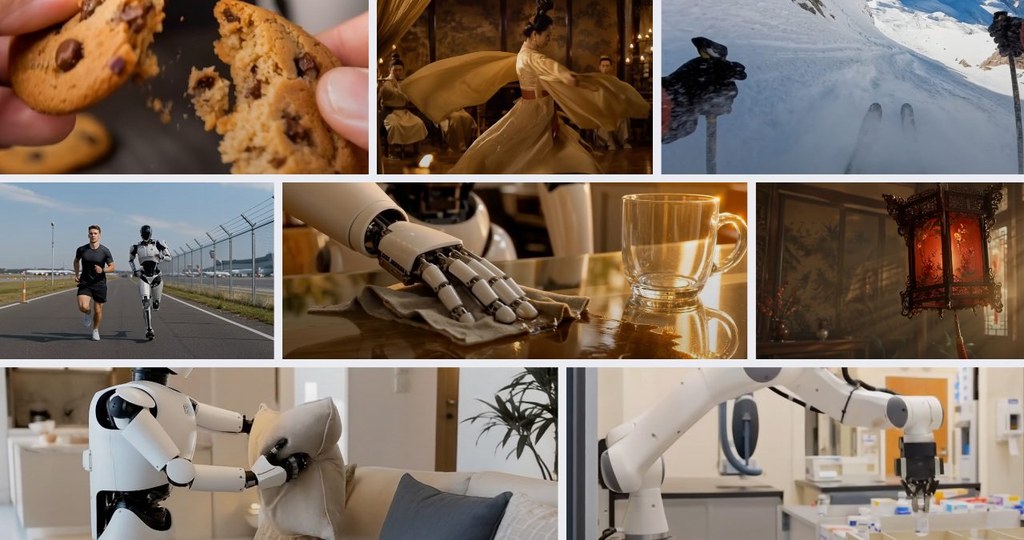
LingBot-Video 想做懂物理的生成影片

首个面向具身智能的大规模开源 MoE 视频基础模型。一般影片模型擅長畫面氣氛,未必處理到動作同物理合理性。LingBot-Video把重點放到具身智能場景,取向相當鮮明。

T2V Quality Score

生成影片要做到「似真」,唔只係畫面靚,仲要交代到動作、物件同物理世界之間嘅關係。LingBot-Video屬於開源視頻模型,主打 embodied intelligence,想補足一般 T2V 只重視視覺效果、但對任務過程同物理合理性掌握較弱呢個缺口。

呢個項目的取向幾清楚:唔係單純追求更大參數,而係用 MoE(Mixture-of-Experts)架構去平衡容量同推理成本,官方說法指推理可快約 3 倍。訓練資料亦唔只靠網絡影片,仲加入超過 70,000 小時 embodied data,再配合 multi reward system,同時兼顧美感、physical rationality 同 task completion。

部署理解上,它已提供完整模型下載入口,同時覆蓋 Hugging Face、ModelScope 以及文件站;推理路線分成 diffusers 同 SGLang Diffusion,代表團隊唔只放權重,亦有考慮不同推理堆疊。README 亦列出 rewriter,當中包括以 Qwen3.6-27B 為基礎嘅版本,以及 Qwen3.6-27B LoRA adapter,表示提示詞改寫都係整個工作流一部分。

  • 提供 LingBot-Video-DenseLingBot-Video-MoE,前者較像基線路線,後者加入 Refiner
  • 任務覆蓋 T2I、T2V、TI2V,唔只限純文字轉影片
  • 以 embodied data 同多重獎勵機制強化動作合理性
  • 有文件、模型頁同技術報告,較適合研究團隊同進階內容生成流程測試

受益最大嘅,會係想做機械人模擬、具身智能研究、動作導向影片生成,或者需要比較「任務是否完成」而唔只係「畫面是否好睇」嘅團隊。現有資訊未見到完整基準分數整理,所以性能判斷暫時仍要配合官方技術報告同實測;不過以開源定位、MoE 架構、Refiner 同 rewriter 一併公開嚟睇,LingBot-Video明顯係朝住較完整嘅研究與部署鏈路去設計。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, 多模態模型, 視頻模型, Qwen, Video

vLLM 新後端跑出原生級速度

同一份 transformers 模型實作,依家可以直接食到 vLLM 的高速推理。對部署大型語言模型的人而言,少咗移植工序,吞吐量亦未必輸原生實作。

Og image

卡位一直在於:想用 vLLM 的高吞吐推理能力,過去往往要為個別模型寫或等專用實作。呢篇內容講的是 Hugging Face 把 transformers 直接作為 vLLM 的 modeling backend,而且頁面沒有提供 base model 資訊,因為它不是單一模型頁,而是針對推理後端整合的技術更新。

重點價值很直接:模型作者只要已有 transformers 實作,就有機會不用再額外移植到 vLLM,也能拿到接近原生,甚至更快的推理表現。對 LLM 與 VLM 都有意義,因為 serving 設定基本不變,只是加入 --model-impl transformers 旗標。

文中展示了三組 Qwen3 測試:Qwen3-4B 單 GPU、Qwen3-32B 以 tensor parallelism 跑 2 GPU,以及 Qwen3-235B-A22B-FP8 Mixture-of-Experts 在同一個 8×H100 節點上以 data parallelism 加 expert parallelism 執行。結果指向同一件事:transformers backend 的 throughput 已經追平或超過 vLLM 手寫 native implementation。

  • transformers 已支援 450+ architectures,角色像參考級 modeling library
  • vLLM 繼續負責 continuous batching、custom attention kernels 等高效推理優化
  • 啟用方式很簡單:升級 vllm,並在 serve 時加入 --model-impl transformers
  • 可與 --tensor-parallel-size--data-parallel-size--enable-expert-parallel 一起使用

取捨亦要講清楚:頁面重點在 backend 整合與效能展示,不是 GGUF 發布頁,所以沒有提供 GGUF 格式、量化等級、mmproj、chat template、MTP draft speculation 或 LM Studio/Ollama/llama.cpp 檔案資訊。硬體需求方面,示例至少涵蓋單 GPU、2 GPU,同埋 8×H100 節點;不同模型是否都能複製同樣增益,仍要視架構與部署環境而定。

項目主頁 · GitHub

Categories: 開源, Qwen, 框架, Ollama, Python,

DeepSeek-V4-Flash 本地 GGUF 版

想喺本地跑 DeepSeek-V4-Flash,重點唔只係能否啟動,仲要留意量化後準確度、記憶體門檻同對話模板是否貼近官方表現。呢個版本主打用 GGUF 格式換取更易部署,但硬件要求仍然偏高。

Og image

最值得先講的是,它明確基於 deepseek-ai/DeepSeek-V4-Flash 製作,屬於面向本地部署的 GGUF 量化版本,處理的是大型語言模型喺本機執行時常見的記憶體壓力與部署門檻。頁面同時提醒要配合最新版本的 llama.cpp 或 Unsloth Studio,否則 DeepSeek-V4 可能無法正確運行,代表它對推論框架版本有一定依賴。

Unsloth 把焦點放喺量化後仍盡量保持原模型表現,並提到改良了 DeepSeek-V4 的 chat jinja template,經過超過 4000 段對話測試後,效果與官方 baseline 等效。對使用者來說,呢點比單看可唔可以載入更重要,因為同一個模型換咗模板後,回答風格、工具調用格式甚至思考開關行為都可能出現明顯差異。

檔案資訊方面,頁面清楚列出 UD-Q8_K_XL 屬於 full precision lossless 的建議選項,大小約 162GB,而且只比 Q4 的 UD-Q4_K_XL 大 7GB。描述亦提到 3-bit 可喺 110GB Mac、RAM 或 VRAM 配置運行,full precision lossless 則需要大約 168GB RAM;不過目前提供內容未見完整 GGUF 檔名清單、各量化級別大小、mmproj 附加檔案或上下文長度細節,因此無法逐一確認。

  • 已確認 base model 是 deepseek-ai/DeepSeek-V4-Flash
  • 建議使用最新 llama.cpp 或 Unsloth Studio
  • UD-Q8_K_XL 約 162GB,主打 lossless
  • 3-bit 版本可面向約 110GB 記憶體配置
  • chat template 經 4000+ 對話測試,目標貼近官方 baseline

同類模型比較上,呢個項目的差異不在重新訓練,而在於 GGUF 量化封裝、Unsloth Dynamic 2.0 量化方法,以及對 DeepSeek-V4 對話模板的修正。頁面提到 Unsloth Dynamic 2.0 準確度優於其他主流 quants,但未附上完整對比分數; v2 更新內容、檔名變更、MTP draft speculation 支援、Ollama 與 LM Studio 的具體載入方式,現有資料只足以確認支援方向,未足以逐項下定論。

項目主頁 · 模型

Categories: 開源, 模型, DeepSeek, Mac, Ollama

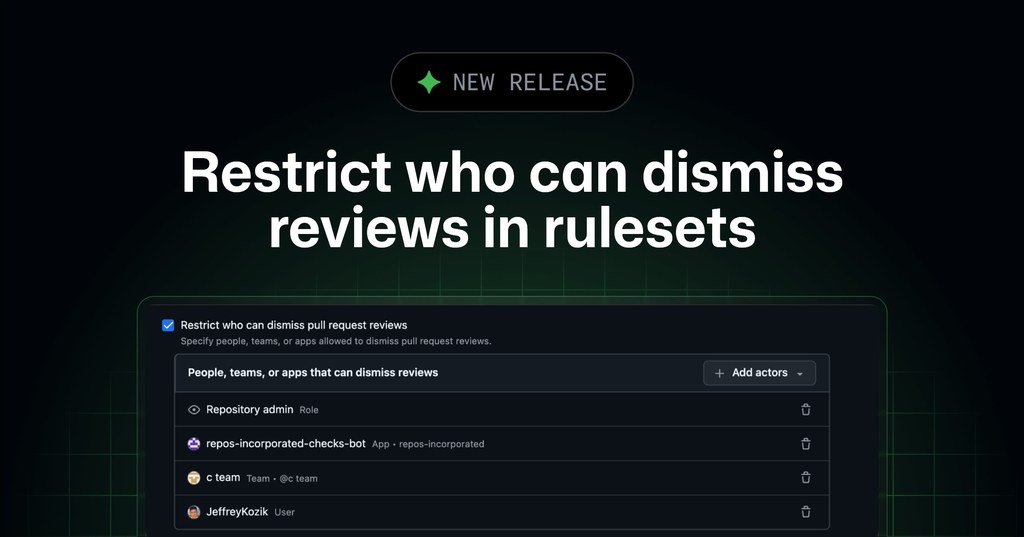
GitHub 規則集新增審核撤銷權限控制

團隊而家可以直接限制邊啲人有權撤銷 pull request 審核。對需要嚴格合併流程嘅項目,呢個更新可減少誤操作同權限過闊帶來嘅風險。

Og image

當團隊依賴 pull request 審核去把關程式碼質素時,最怕唔係冇人批核,而係批核已經完成後,任何唔合適嘅人都可以把審核撤銷。GitHub 今次更新屬於 repository rulesets 功能強化,處理嘅正正係合併前權限邊界唔夠細緻呢個問題。

新設定放入 Require a pull request before merging 規則之中,管理者可以直接指定邊啲 users、teams 同 apps 能夠 dismiss reviews。對比以往較寬鬆或者分散嘅管控方式,呢種做法將審核撤銷權限收返去規則集內統一管理,分支保護流程會更清晰。

重點整理:
– 可限制特定 users、teams、apps 撤銷 pull request reviews
– 設定位置已整合到 repository rulesets 既有審核規則內
– 可透過 UI、REST API 同 GraphQL 配置
– 功能已經 generally available,適用於 github.com 上嘅 repository rulesets

呢個更新最適合有多人協作、需要明確審批責任,或者要配合內部治理要求嘅開發團隊。Rulesets 本身已經係 GitHub 建議用來保護 branches 嘅方式,而家再加上審核撤銷限制,等項目喺合併前多一層可追蹤、可控嘅流程保護。

使用上做法唔複雜,只要打開 repository-level ruleset,啟用 Require a pull request before merging,再選擇 Restrict who can dismiss reviews 就可以。呢類更新唔係花巧功能,而係直接改善日常協作入面最常見嘅權限管理細節。

項目主頁

Categories: 開源, 微軟, API, 教學, 軟件, 安全

Qwen-Image-Bench:難分高下的是細節

生成圖像模型愈做愈靚,真正難分高下的是細節表現。Qwen-Image-Bench 把評分拆得更細,較容易看清模型在哪些創作場景會失手。

Qwen-Image-Bench dimension framework and representative model outputs

只看一張圖夠唔夠靚,已經不足以判斷 text-to-image (T2I) 模型值唔值得放入創作流程。Qwen-Image-Bench 把焦點放到更貼近創作工作的檢查方式:它屬於評測工具包,同時連同 benchmark dataset 同 judge model,一併處理生成圖像模型難以客觀比較的問題。

這個項目的可取之處,在於它唔係只計語意對齊或整體畫質,而是用 fine-tuned 的 Q-Judger(Qwen3.6-27B)按 5 個階層維度評分,包括 Quality、Aesthetics、Alignment、Real-world Fidelity、Creative Generation,並細分到 56 個 facets。對做品牌視覺、遊戲美術、漫畫分鏡或者要處理文字渲染的人來說,呢種拆法比單一總分更有參考價值,因為你會直接見到模型係構圖、真實感、創意約束,定係文字生成出問題。

部署理解上,它唔係即開即用的網頁服務,而是偏研究與團隊驗證流程的 Python 工具。你要準備好虛擬環境、PyTorch,同埋包含 prompt、image_path、ID 的 CSV/JSON/JSONL 輸入,再透過 judge.py 跑 Qwen/Qwen-Image-Bench;另一條路線是直接用已公開的 benchmark responses 重現排行榜分數。底層推理沿用 ms-swift,跟釋出 benchmark 結果時的設定一致,這點有助減少評測流程前後不一。

  • 支援替任何 T2I 模型打分,較適合做橫向比較
  • 分數結構比一般 benchmark 細,方便定位失誤位置
  • 可重現公開資料集結果,適合研究或團隊內部驗證
  • 使用門檻偏技術向,需要本地推理環境與整理輸入格式

它的取向也很清楚:重點不是提供生成能力,而是提供一把較細緻的尺。代價是評測仍依賴 judge model,本身並不是人手審稿,也未必完全等同最終用戶審美;但對需要批量比較模型、整理回歸測試、追蹤版本變化的團隊,這種一致而可重跑的框架反而更實用。相關模型與資源包括 Q-Judger(Qwen3.6-27B)、Hugging Face 上的 Qwen/Qwen-Image-Bench,以及配套 benchmark dataset。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Qwen, Image, txt2img, 工具, Python, Dataset 數據集

OmniRoute:免費 AI 路由閘道值唔值得用

想用 Claude Code、Codex 或 Cursor,又唔想被單一供應商限額綁死,OmniRoute 提供咗一條幾務實的路。它把免費模型池、備援切換同壓縮節省 token 放埋一齊。

OmniRoute Dashboard

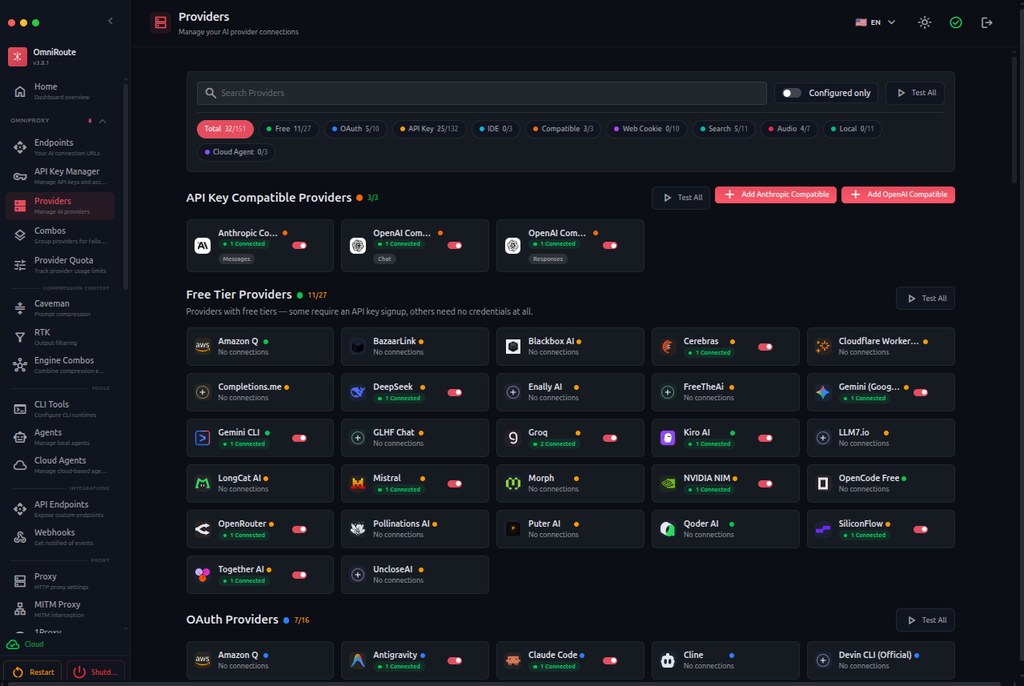
寫程式最怕做到一半先撞到配額上限,或者工具只綁死某一個模型。OmniRoute 把自己放在 AI gateway 呢個位置,直接處理多個 AI coding 工具同多個模型供應商之間的路由問題,重點唔係再造一個聊天介面,而係幫你維持請求可用、控制成本,並用 auto-fallback 減少中斷。

同類做法通常會主打單一 API 聚合,OmniRoute 的取向明顯更偏向「免費額度整合 + 路由策略 + 壓縮節流」。它聲稱可接到 237 個 providers,當中 90+ 提供 free tiers,並以 RTK + Caveman compression 把 token 消耗壓低 15% 至 95%。呢個方向的好處係對長提示、程式碼上下文同重複輸出較有幫助,但壓縮始終係取捨,所以它加咗 inflation guard,遇到壓縮後反而變長,就會送回原文。

OmniRoute + OpenCode: 100% Free AI Coding Setup, Free AI Gateway
New FREE Unlimited AI Coder | OmniRoute

你可以把它理解成放在 Claude Code、Codex、Cursor、Cline、Copilot、Antigravity 後面的中介層。部署後,工具經同一個 endpoint 出請求,再由 OmniRoute 分配到 Claude、GPT、Gemini 及其他供應商;README 也提到每個模型會列出本月已用與剩餘額度,並標示 provider terms,這點對團隊控管比較有用。

幾個值得留意的重點:
– 定位屬於工具 / 閘道型軟件,解決的是多模型切換、免費額度整合同配額中斷
– 支援 Claude Code、Codex、Cursor、Cline、Copilot、Antigravity,適合多工具並行的開發流程
– 以 documented free tokens/month 作招徠,現有資料提到穩定約 1.6B,首月可到 2.1B
– 內建 17 routing strategies,並加入 auto-fallback,減少單一 provider 失效帶來的停頓
– 壓縮模組已針對 German、French、Japanese、Chinese,以及 Gradle、.NET 輸出做過強化

受益最大的一般會係重度依賴 AI 編碼助手的個人開發者、細團隊,同想把成本壓到最低的實驗性項目。要留意的是,免費池本身受各 provider 條款影響,OmniRoute 雖然強調統計方式較透明,但效能與穩定性仍然建基於外部服務;它較像一個把資源調度做得更聰明的控制層,而唔係保證品質一致的模型平台。

GitHub

Categories: 開源, 微軟, Gemini, API, Vibe Coding, 工具, IDE, 編程, Anthropic

Rank-Then-Act 點樣用影片學出獎勵

想像你只得示範影片、冇現成 reward function,Rank-Then-Act 就係針對呢個卡位而來。它先學會判斷進度,再把次序感轉成強化學習可用的訊號。

Screenshot

做強化學習最麻煩的地方,往往不是訓練本身,而是根本冇一個好用的 reward function。Rank-Then-Act 針對的正正是這個缺口:它屬於一個以 Vision-Language Model (VLM) 為核心的強化學習框架,目標是在沒有環境獎勵的情況下,從示範影片推回任務進度,再把這種進度感變成 agent 可學習的 dense reward。

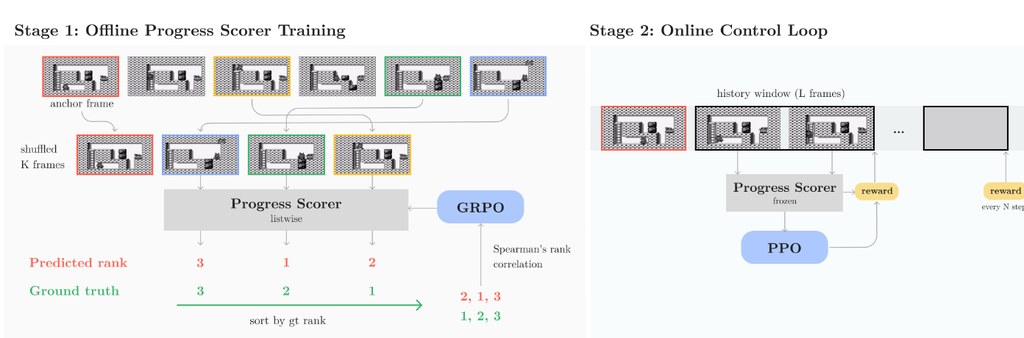
同類方法很多時會直接學一個 scalar reward,或者預測成功與否,但作者刻意避開這條路。RTA 先用 GRPO 微調 VLM,要求模型在打亂次序的畫面序列中估計 task-completion 百分比與排序,再用 VOC 這個 rank-correlation reward 去約束模型真的理解時間進展,而不是偷看絕對時間線索;之後在第二階段,系統不是直接輸出分數當 reward,而是用 Spearman rank correlation 比較預測進度排序與真實時間索引,得到一個 bounded、scale-invariant 的學習訊號。

這種取向的好處,是 reward 較不容易因尺度漂移而失真,亦較有機會跨任務重用同一個 progress scorer。現有資料指出,它在離散環境如 PyBoy 上的 Catrap、Kirby,以及連續控制環境如 MetaWorld、PointMaze 都有不錯表現,對 unseen tasks 亦有泛化能力;不過這仍然是研究型項目,重點在方法驗證,未算是即裝即用的成品工具。

  • 重點不是直接預測分數,而是先學會判斷畫面進度排序
  • 第一階段用 GRPO 訓練 VLM,第二階段用 PPO 訓練策略
  • reward 來自 VOC 與 Spearman rank correlation,訊號範圍固定在可控區間
  • 已覆蓋 Game Boy 模擬器 PyBoy 與 MetaWorld 這類不同控制場景
  • 需要 Python 3.10+、CUDA GPU,第二階段還要 xvfb、ROM 與 save state

理解和測試這個項目,最合理的方式不是把它當普通套件安裝,而是當成兩階段實驗流程來看:先在 stage1 用 gameplay videos 訓練 progress scorer,再到 stage2 把該模型凍結成 reward model,放進 PPO 訓練流程。儲存庫已把資料處理、Hydra 設定、多 GPU 配置、PyBoy 包裝器與 VOC 計算分開整理好,適合研究團隊、做 video-based RL 的人,或者想比較 ordinal reward 與 scalar reward 差異的讀者深入追蹤。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 視覺模型, 多模態模型, 模型訓練, NVIDIA, Video, Python

Page 38 of 92
1 36 37 38 39 40 92