GauntletBench 評測框架點出 Agent 盲點

這是用來測試 agent 泛化能力的評測工具。它避開常見應用,專攻視覺密集又偏專業的網頁任務。

GauntletBench logo

GauntletBench 是一個極具挑戰性的基於 Web 的基準測試,用於衡量智能體系統在複雜、基於視覺的專業任務中的泛化能力。

GauntletBench 圍繞著五個鮮為人知的應用場景構建——視頻編輯器、工作流程構建器、3D 建模器、飛行分析器和電路設計器——評估了三個尚未充分探索的能力:時間感知、圖形理解和3D 推理。該基準測試涵蓋100 項人類可完成的任務、模組化的評估流程以及自動化的領域特定評分,揭示了前沿智能體與人類表現之間存在顯著差距:被評估的最強智能體的成功率僅為19.1%,而非專家人類標註者的成功率則超過80%,這表明當前的智能體在復雜的真實世界中仍可達到可靠的真實世界的性能水平。

現有 benchmark 多數放在熱門應用和較直接的任務,容易令新一代 agents 出現分數飽和,未必真能反映它們離真實工作有幾遠。GauntletBench 的取向剛好相反:刻意避開常見 app,改用 Circuit Designer、Flight Analyser、Video Editor、3D Modeller、Workflow Builder 五類較少被覆蓋的環境,重新把問題定義成「能否在不熟悉介面完成視覺密集工作」。

這個 GitHub 項目本身不是模型,而是跑評測的框架;README 已交代可按單一 task、整個 application,甚至用 JSON 批次執行實驗,也支援並行執行與 YAML task file。底層 agent run mechanics 直接沿用 REAL 的 browser harness 與 task loop,這個項目新增的重點則是 evaluation framework、batch runner、objective and LLM-as-a-judge evaluators,以及新的 task suites。

  • 100 個任務,每個應用 20 個,全部屬 vision-intensive tasks
  • 預設模型參數 可指定 --model,預設為 o3
  • 可擴充測試方式,支援 YAML 任務檔與 JSON 批量設定
  • 結果訊號清楚:最佳 agent 約 19.1% 至 20.9% success,非專業人類標註者超過 80% 至 90%

最值得留意的是它反映出一個很實際的落差:agent framework 普遍比單純 raw models 好,但整體距離人類仍然很遠;open-source models 甚至普遍低於 1%。Video Editor 屬較可處理的範圍,Circuit Designer 則接近「幾乎做不到」,所以這套工具特別適合研究 Agentic、Computer-use agents、網頁自動化與多模態能力的團隊,用來找出模型不是「答錯」,而是根本看不懂時間、圖形與空間結構的位置。
項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, Agentic, 模型, 多模態模型, Qwen, Gemini, Video, 框架, 香港, 工具, 3D, Anthropic

Qwythos-9B GGUF 技術拆解

這是 Qwythos-9B-Claude-Mythos-5-1M 的 GGUF 量化版,主打 1M context、推理與工具調用。頁面亦交代 v2 檔案更新與 MTP 用法。

Og image

這個模型之所以值得注意,主要是因為它把 推理能力、超長上下文、以及本地部署友好性 結合在一個 9B 級別的模型裡。它是基於 Qwen3.5-9B 的全參數推理模型,並用 5 億多條 Claude Mythos / Claude Fable traces 做後訓練,還支援 1M context、vision 和 function calling 。

Hugging Face empero-ai/Qwythos-9B-Claude-Mythos-5-1M 的 GGUF 量化版本屬於 quantized 形式,而非原始訓練權重。它的主要用途是在 llama.cpp、Ollama、LM Studio 等 GGUF 執行環境中部署一個支援推理、視覺輸入、function calling 與長上下文的 9B 模型;其表現超越 base Qwen3.5-9B,但這一層關係屬於上游模型說明。

Qwythos-9B 是 full-parameter reasoning model,經過超過 5 億 tokens 的 Claude Mythos / Claude Fable traces 後訓練,並使用 Empero AI 內部 rethink 工具生成 chain-of-thought。能力上支援 1,048,576 tokens(1M context),透過 YaRN rope-scaling 預設開啟;同時標示為 image-text-to-text、multimodal、vision、agentic,表示它不只是文字聊天模型。

v2 已要求重新下載,原因包括 tokenizer metadata 對 Qwen3.5 GGUF runtimes 的修正、chat template 更新,以及新增 -MTP- 版本。已列出的一般版本包括:Qwythos-9B-Claude-Mythos-5-1M-Q4_K_M.gguf(5.24 GiB,官方建議預設)、Q5_K_M(6.02 GiB)、Q6_K(6.85 GiB)、Q8_0(8.87 GiB)與 BF16(16.69 GiB);頁面亦提到 vision projector smoke-tested,但截取內容未見 mmproj 檔名。

  • Q4_K_M 是最適合起步的量化級別,容量較低,而且頁面直接標成 recommended default
  • Q5_K_M / Q6_K 較適合想提高品質、又想控制記憶體佔用的部署
  • Q8_0 接近 near-lossless,較適合重視輸出穩定度的情境
  • -MTP- 檔案是為 llama.cpp MTP draft speculation 準備,一般相容性則以普通檔名版本較穩陣

與一般只做指令微調的同類模型相比,這個項目強調三點:一是 1M context 已預設可用,二是 native function calling 依照 Qwen3.5 spec,三是 v2 連 chat template 都針對 tool calling 與 OpenCode-style agent loops 修正。限制亦很清楚:完整訓練細節與評測數字需要回到 base model card 查看,而這個頁面主要是量化分發頁;使用時亦要留意舊版 GGUF 檔名已被替換,否則 chat template 與 runtime 相容性可能受影響。

項目主頁

Categories: 開源, Agentic, 模型, 多模態模型, Qwen, Image, Anthropic

Robust-TO:更穩陣的影片理解代理框架

Robust-TO 針對 Video-LLMs 在受干擾影片中的誤判問題,用信心分數協調工具與證據。重點不只準確率,還包括出錯時能否有節制地退化。

Repository image for ROVA-V2/Robust-TO

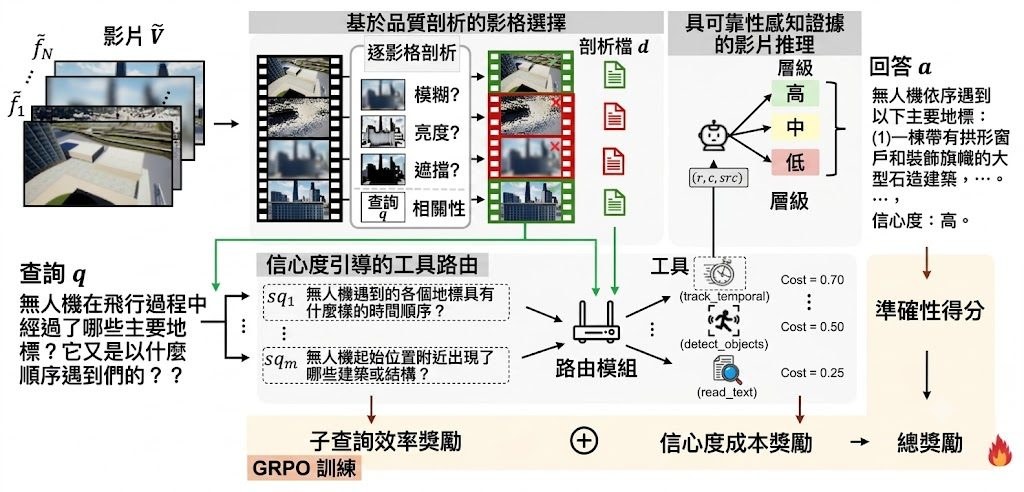
Robust-TO 是一個面向影片理解的 agentic framework 研究原型。它主要解決 Video-LLMs 在模糊、過暗、遮擋等干擾下,仍然盲目相信每一格畫面,導致答案與自信程度脫節的 Blind Trust Problem。

現有做法常把所有影格近乎同等對待,再交由單一模型或固定流程推理;作者認為這種範式忽略了畫面可靠度,所以提出 Confidence-Aware Tool Orchestration。它先用不需額外參數的 profiler 為每格評估 blur、brightness、occlusion,只保留較可靠片段,再把問題拆成子查詢,交由 track_temporal、detect_objects、read_text 等工具處理,最後用 High / Mid / Low 三層證據整合答案。

這個項目最值得留意的,不是單靠更大模型硬推結果,而是把 (result, confidence, source) 當成統一介面,連工具成本與可靠度一併納入。取捨也很明顯:流程比直接問一個 Video-LLM 更複雜,但換來對受污染影片更穩定的表現,而且官方指出在乾淨輸入上延遲開銷低於 5%。

  • 平均準確率比最強開源基線高 +10.6
  • clean-to-corrupted accuracy drop 最小,重點在抗干擾而非只看乾淨數據
  • 使用 GRPO 訓練 policy,獎勵同時考慮正確性、證據可靠度與計算成本
  • 相關組件與模型角色包括 profiler、Router,以及工具如 track_temporal、detect_objects、read_text

目前較適合把它理解為方法框架與研究結果,而不是立即可部署的成品。較受用的會是做 Video-LLMs、Computer-use agents、CUAs 式多工具協作、影片問答或魯棒性評測的研究團隊,特別是想把「模型知道自己何時不可靠」納入系統設計的人。

GitHub

項目主頁

Paper

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, Video, 框架

CantoneseChat:會聽聲調語氣的粵語聊天 App

一個針對粵語互動而做的 iOS 項目,把語音辨識、語氣調整同 TTS 串成完整對話流程。重點不只在聊天,而是回應更貼近香港人口吻。

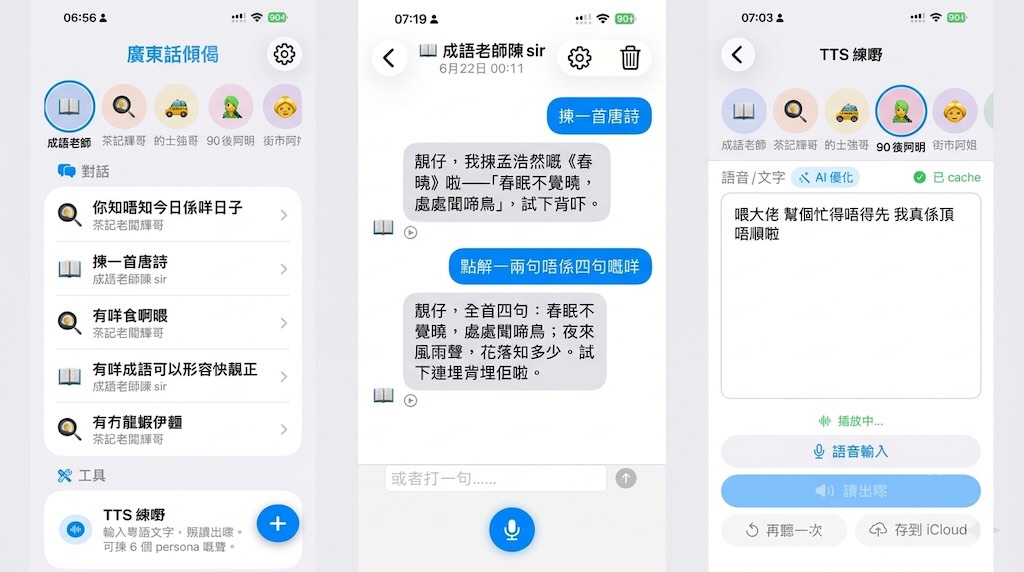
Cantonese Chat iOS app demo — Home / Chat / TTS Lab

CantoneseChat 是一個 iOS 粵語語音聊天工具項目,核心目標不是做通用聊天介面,而是把 iPhone 收音、on-device 粵語 STT、MiniMax cloud 的 LLM + TTS,以及 persona 語氣控制接成一條完整流程。它實際解決的問題,是一般語音助手識到字,但未必講得似香港人,亦未必會按說話者特徵調整語氣。

這個項目最值得留意的地方,是它會先用 AVAudioEngine 收音,再把音訊 downsample 去 16kHz,用 autocorrelation 估 pitch,推斷 VoiceType、Gender 同 AgeGroup,之後把結果注入 LLM system prompt。這種做法不是高精度聲紋身份辨識,而是偏向 heuristic 的語氣適配,所以速度會較直接,代價是分類準確度很受環境噪音、聲線變化同 pitch 規則影響。

安裝與理解方式也算清晰:它是 iPhone 真機導向的 iOS App,因為核心功能依賴 mic、AVAudioEngine、本機語音輸入同雲端模型串接,單看資料已可判斷模擬器未必能完整反映效果。測試時應分開看幾部分:persona 對話是否有語氣差異、TTS Lab 經 AI 粵語優化後是否更口語、pronunciation_overrides.txt 能否修正讀音,以及 iCloud export 有沒有順利保存音頻。

  • 支援 6 個 persona,適合示範同比較不同說話風格
  • 用 pitch heuristic 分類 VoiceType,再推斷 Gender、AgeGroup
  • 整合 on-device 粵語 STT、MiniMax cloud 的 LLM + TTS
  • 提供 pronunciation_overrides.txt 修正粵語讀音
  • 可將生成音頻匯出到 iCloud Drive

適合想做香港市場語音互動介面,例如客服示範、教育對話、角色語音內容,或者想研究粵語人機互動體驗的小團隊。若你重視可控語氣、多 persona 展示同本地口語感,它有明確方向;若你追求嚴格年齡性別判斷,這套規則式分類就應視為體驗輔助,而不是可靠的人口統計模型。

相關模型與模組包括 MiniMax cloud 的 LLM 與 TTS、iOS on-device 粵語 STT,以及項目內以 pitch 為基礎的 VoiceType 分類流程。公開資訊未見標準基準測試或 OSWorld 這類評測結果,所以較合理的判斷方式,是把它看成一個完成度不錯、偏產品原型取向的粵語語音互動項目。

GitHub: https://github.com/elbartohub/CantoneseChat

Categories: 開源, 文字轉語音, Audio, 香港, 語音, 蘋果, MiniMax, 廣東話

PhysiFormer 用座標預測物理運動

這是個用世界座標模擬3D物體運動的擴散模型。它把剛體、彈性體與多物件互動放進同一個生成框架。

Og image

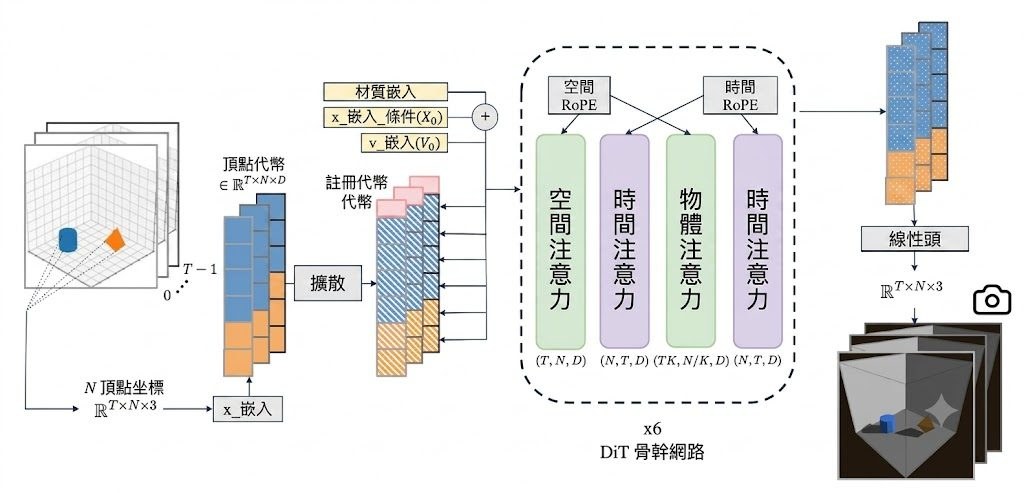
PhysiFormer 是一個 diffusion transformer 模型,用世界座標中的 3D mesh 直接模擬物體運動。它要處理的是在已知初始頂點位置、速度與材質條件下,生成之後一段時間內合理可信的 4D 動態軌跡。

它和常見 video world models 的分別,在於不是在視角相關的像素空間推測畫面變化,而是直接預測 world coordinates 裡的 vertex trajectories。論文指出,這個做法不依賴手動指定的模擬結構、shape latent,亦不需要明確加入 rigid-transform prediction 一類限制,改用單一步驟的去噪擴散過程學習完整時域軌跡。

模型同時支援 rigid 與 elastic 物件,亦能處理 mixed-material dynamics、碰撞,以及靜止與移動中的多個物件。為了提升效率,PhysiFormer 採用在時間、空間與物件三個維度分解的 attention,令多物件推理保留 permutation-invariant 特性,毋須額外手動編碼物件身份。

  • 以 3D coordinate diffusion 建模,重點是視角無關而且幾何結構清晰
  • 用超過 100k simulated trajectories 訓練,覆蓋多種剛體與彈性體運動
  • 可生成多個合理未來,而非只輸出單一路徑,適合存在未觀察不確定性的情境
  • 它在 trajectory accuracy、rigidity preservation 與 momentum-based physical consistency 上明顯優於 autoregressive baselines

這類項目較適合 robotics、graphics、physical design,以及需要幾何感知 world modelling 的工作流。現有資料顯示它對未見過的真實幾何形狀、更大的物件數量,以及混合材質場景有一定泛化能力,但內容主要來自模擬資料與論文結果,真實部署表現仍要配合具體場景再驗證。

項目主頁: https://yimingc9.github.io/physiformer/

Paper: https://arxiv.org/pdf/2606.27364

Categories: 開源, 模型, 世界模型, 模型訓練, Video, Robotic, 框架, Vibe Coding, Content Creator, 3D, 深度學習

DanceOPD:多能力影像生成的場景蒸餾框架

DanceOPD 提出 on-policy 生成場景蒸餾方法,將不同影像能力整合到單一模型,同時保持 T2I 與編輯表現。

ByteDance Seed

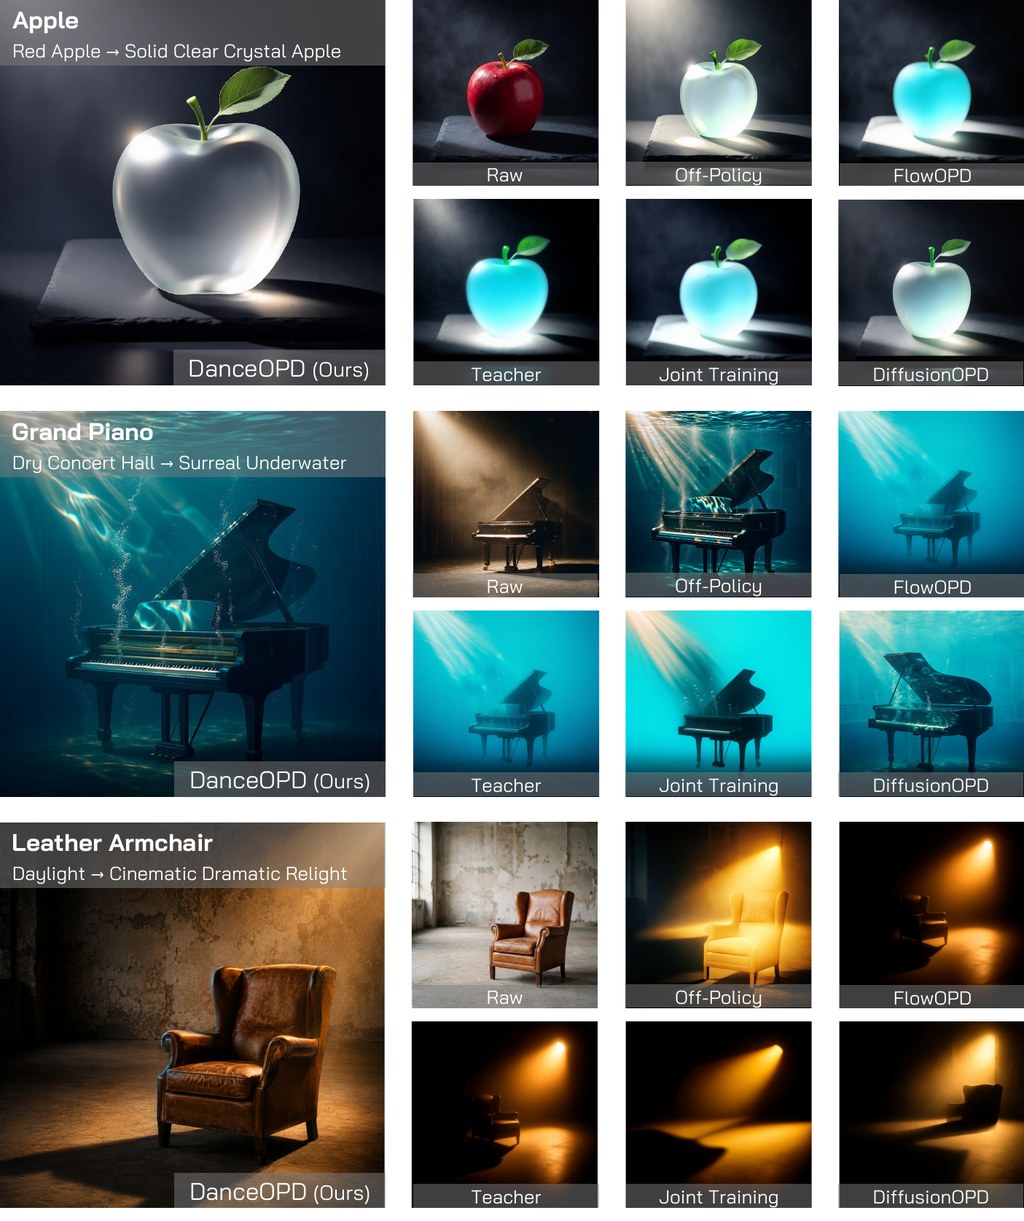
DanceOPD 是一個針對 flow-matching 模型設計的 on-policy 生成場景蒸餾框架,目標是讓單一影像生成模型同時具備文字生成影像(T2I)、局部編輯與全域編輯等多種能力。核心做法是將每個來源能力視為一個速度場(velocity field),然後在學生模型自己產生的 on-policy 狀態上查詢這個場景,再以簡單的速度 MSE 損失進行訓練。

這套方法最值得留意的差異在於 hard-routed 設計:每個樣本只被路由到一個被選中的能力場,並且只查詢一個低噪聲的語義側狀態(semantic query),避免了對多個來源場景做平均而模糊語義身份的問題。同一套框架也能吸收 operator-defined fields,例如 classifier-free guidance,讓引導機制自然融入訓練。

在評估方面,DanceOPD 報告了多項指標,包含 GEditBench-avg 在 T2I + Edit Composition 上達到 5.347、GenEval Overall 達到 0.849 同時保持 T2I 表現,以及 Local + Global Edit Composition 的 5.498、CFG 吸收診斷中 5.833 的最佳值。

這項工作適合關注多能力影像生成整合、蒸餾方法以及 flow-matching 模型研究的開發者與研究者。由於 Code 標示為「Soon」,目前尚未提供源碼或模型下載,因此暫無可對應的安裝或使用步驟可分享。

主要重點:

  • 核心定位:flow-matching 模型的 on-policy 生成場景蒸餾框架
  • 方法差異:hard routing 單一能力場景加單一低噪聲語義查詢,避免場景平均造成的語義模糊
  • 支援能力:T2I、局部編輯、全域編輯,並能吸收 classifier-free guidance 等 operator-defined fields
  • 評估數字:GenEval 0.849、GEditBench T2I+Edit 5.347、Local+Global 5.498
  • 現有狀態:論文可在 arXiv 瀏覽,原始碼尚未公開

項目主頁: https://danceopd.github.io/

Paper: https://arxiv.org/pdf/2606.27377

Categories: 開源, 字節跳動, 模型, 模型訓練, Image, 影像模型, txt2img, 框架, 教學, Content Creator, 深度學習

ShutterMuse:拍照當下即時引導構圖與姿勢的多模態模型

ShutterMuse 是統一多模態大型語言模型,針對拍照瞬間提供構圖決策與人物姿勢推薦,並隨附 CaptureGuide 資料集與評測基準。

ShutterMuse logo

ShutterMuse 是一個統一的多模態大型語言模型(MLLM),專門用於拍照瞬間的攝影引導,解決「按下快門前該怎麼構圖、被攝者該擺什麼姿勢」這個長期被忽略的問題。傳統做法多以「事後美學裁剪」為主,只評估模型能否從既有照片中挑出最佳裁切區域,卻沒有涵蓋拍攝當下的構圖決策,更完全不處理被攝者的姿勢推薦;通用型 MLLM 雖然能給出構圖建議,卻難以精準定位需要調整的區域,而專門的美學裁剪模型雖然定位能力強,卻只能處理裁切這一項任務,兩者皆無法提供結構化、可即時執行的姿勢指引。ShutterMuse 透過同時輸出「保留/微調/重拍」三類構圖決策,搭配 COCO-17 關鍵點與可見度資訊的姿勢骨架,把拍攝引導整合成單一模型。

CaptureGuide-Bench 與 CaptureGuide-Dataset 是這個項目的兩大支柱:前者涵蓋構圖決策/微調與姿勢推薦兩類互補任務,後者包含約 13 萬筆樣本,附帶文字推理與結構化視覺標註,供監督式微調與強化學習微調使用。從評測結果來看,ShutterMuse 在攝影師端引導的 IoU 達到 74.30、BDE 降至 0.054、MLLM-Score 為 0.64,皆優於 Gemini-3.0-Pro、GPT-5.5 與 Venus 等對照組;在被攝者端姿勢推薦方面,平均分數與互動性指標亦具競爭力,且推論時間與 token 消耗明顯低於 Nano-Banana-Pro 與 GPT-Image-2。

這個項目由復旦大學與 StepFun 共同開發,模型權重、評測腳本與範例已於 Hugging Face 與 GitHub 同步釋出。原始資料提供了模型下載連結與項目頁面的示範影片,部署細節需參考項目頁面或模型卡片的後續說明。

重點摘要

  • 統一處理構圖決策(保留/微調/重拍)與姿勢推薦兩類拍攝引導任務
  • 隨附 CaptureGuide-Dataset(13 萬樣本)與 CaptureGuide-Bench 兩項資源
  • 在 CaptureGuide-Bench 多項指標上超越 Gemini-3.0-Pro、GPT-5.5 與 Venus
  • 姿勢推薦推論成本低於 Nano-Banana-Pro 與 GPT-Image-2
  • 適合攝影教學、智慧相機助理、AR 拍攝引導等需要即時回饋的場景

對攝影 App 開發者、相機廠商研究團隊,或任何想把「構圖教練」與「姿勢教練」整合進拍攝流程的產品而言,ShutterMuse 提供了一個可直接微調與評測的起點;至於一般使用者,則可先透過 Hugging Face 上的模型權重與項目頁面示範影片了解其能力,再依官方後續釋出的腳本進行本地部署。

GitHub: https://github.com/lijayuTnT/ShutterMuse

項目主頁: https://lijayutnt.github.io/ShutterMuse/

模型: https://huggingface.co/ShutterMuse/ShutterMuse

Categories: 開源, 模型, 視覺模型, OpenAI, Image, 影像處理, 教學, 工具, Dataset 數據集

UnityShots:多鏡頭影音生成的記憶驅動新方案

由快手 Kling Team(快手) 與學界合作推出,UnityShots 把單鏡頭擴散模型改造成可保持人物、場景與聲音一致的多鏡頭敘事系統,並釋出 200 段基準測試集。

UnityShots Logo

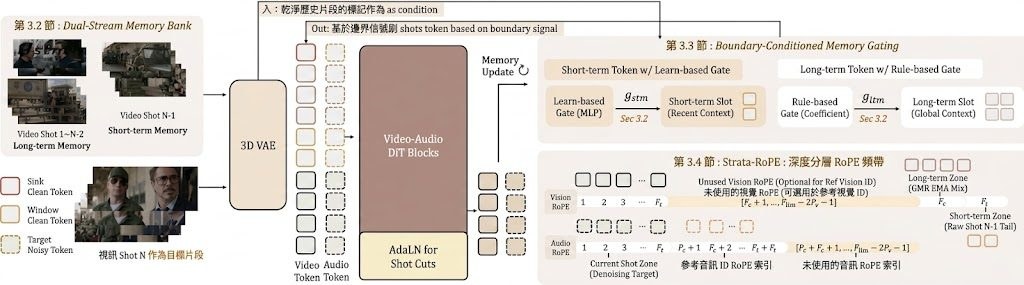
UnityShots 是一個研究性質的多鏡頭影音生成框架,核心任務是解決現有方法在長序列多鏡頭影片中難以維持人物、場景與聲音一致性的問題。它基於已有的單鏡頭影音擴散模型 LTX-2.3(22B 參數)建構,從一段結構化提示詞直接生成 3 至 9 個鏡頭的連續 .mp4 影片,確保角色容貌、場景光影與配音語音在各鏡頭間保持連貫。

現有做法通常依賴三種路線:端到端訓練固定長度序列但難以擴展、以記憶庫逐鏡頭生成但容量隨鏡頭數線性膨脹,或用大型語言模型規劃器調度預訓練生成器而缺乏多鏡頭感知骨幹。UnityShots 的切入點是引入邊界感知門控(Boundary-Aware Gating)與雙槽記憶機制:影片流維持兩個固定大小記憶槽,長期記憶(LTM)錨定開場鏡頭,短期記憶(STM)保留前一鏡頭尾部,兩者在每次剪接時由門控網路更新;音訊流則在每個鏡頭注入參考說話者 token,避免滑動音訊庫的負擔。另一個辨識度高的設計是透過 AdaLN 學習離散剪接類型先驗(cut-type prior),讓使用者可在推論階段調整轉場強度。

以下為重點摘要:

  • 類型:多鏡頭影音生成研究框架,附帶資料集與基準測試。
  • 核心差異:用固定大小雙記憶槽取代線性增長的記憶庫,並加入參考語者 token 維持聲音一致性。
  • 控制能力:剪接類型先驗成為推論時可調旋鈕,使用者可指定轉場強弱。
  • 相關模型:以 LTX-2.3 22B 為基座,整合 AdaLN 門控機制。
  • 資料集:釋出 UnityShotsBench,涵蓋六大文化區域、13 種語言的 200 段多鏡頭序列。

現有評估涵蓋 I2V、T2V、R2V 三種條件模式,UnityShots 在跨鏡頭一致性與音畫品質上與開源及閉源基準相當。對從事多鏡頭敘事、短影音自動化或數位人內容生成的團隊而言,這套框架提供了較完整的記憶與控制設計思路。原始資料庫明確指出,檢查點、訓練程式碼與代理系統尚未釋出,因此目前無法從儲存庫直接取得安裝指令或模型權重;讀者若有興趣部署,需等待官方後續發布。資料集本身可從 Hugging Face 的 KlingTeam/UnityShotsBench 下載,供研究者評測自家模型。授權為 CC BY-NC 4.0,僅限非商業學術用途。

GitHub: https://github.com/JIA-Lab-research/UnityShots

項目主頁: https://jackailab.github.io/Projects/UnityShots/

Paper: https://arxiv.org/pdf/2606.21661

Categories: 開源, 香港中文大學, 香港科技大學, 清華大學, 字節跳動, 數字人, 模型, 視頻模型, Video, 提示詞, 框架, 香港, 庫, 語音, LTX

TryOnCrafter:首個鏡頭可控的影片虛擬試穿框架

TryOnCrafter 是首個支援鏡頭軌跡控制的影片虛擬試穿框架,以 4D 代理模型分離人物與背景,實現任意視角的試穿效果。

TryOnCrafter teaser

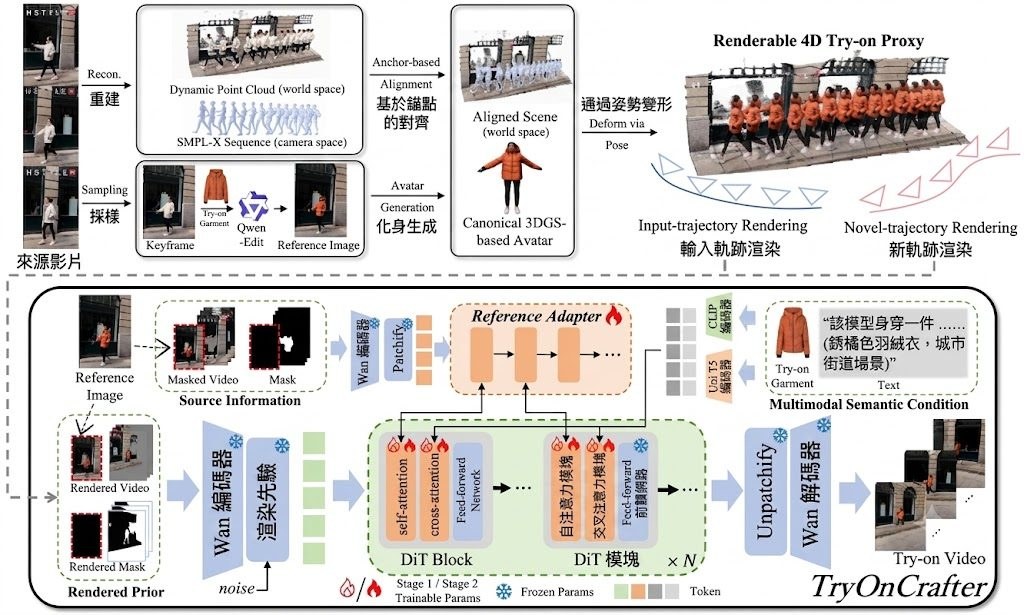
TryOnCrafter 是一個基於 DiT(Diffusion Transformer)的虛擬試穿影片框架,專門處理「鏡頭可控影片虛擬試穿」(Camera-controllable Video Virtual Try-on, CaM-VVT)這個新任務。它的主要用途是讓使用者能夠在指定鏡頭軌跡(例如推近、傾斜、環繞)的情況下,生成穿著指定服裝的人物影片。

傳統的影片虛擬試穿只能沿著原始影片的鏡頭路徑生成結果,無法讓使用者自由改變視角。TryOnCrafter 的做法是引入一個「可渲染的 4D 試穿代理」(Renderable 4D Try-on Proxy),先把 2D 試穿結果提煉成一個基於 3D Gaussian Splatting(3DGS)的穿衣化身,再用 SMPL-X 序列驅動動作,最後把這個化身對齊到重建的背景點雲中。這個代理模型把人物與環境分離開來,提供穩定的幾何骨架,讓後續的影片生成能夠在任意鏡頭下保持結構一致。

在生成階段,框架採用 Proxy-Anchored Video DiT,把代理模型渲染出來的多層資訊(包括渲染先驗、參考特徵、服裝語意提示)作為幾何錨點,確保最終影片在指定軌跡下保持物理合理的形變與外觀。這種設計同時支援多項延伸應用,包括人物重新定位、子彈時間效果,以及 360 度環繞檢視。

團隊建立了 CaM-VVTBench 評測基準,結果顯示 TryOnCrafter 在結構一致性與服裝身份保留方面,明顯優於現有方法。這個框架較適合需要展示服裝 3D 效果的研究團隊、電商內容製作,以及對鏡頭語言有要求的多媒體創作場景。

重點摘要

  • 首個鏡頭可控試穿框架:突破傳統 VVT 只能被動沿用原片鏡頭的限制,支援使用者自訂鏡頭軌跡。
  • 4D 試穿代理模型:以 3DGS 化身 + SMPL-X 動作序列,把人物與背景解耦,提供密集幾何引導。
  • Proxy-Anchored Video DiT:以代理渲染結果作為幾何錨點,確保任意視角下的結構與服裝一致性。
  • 多元延伸應用:支援人物重定位、子彈時間、360 度環繞等下游編輯。
  • 新基準 CaM-VVTBench:團隊建立的專用評測集,在結構一致性與服裝身份保留上明顯領先既有方法。

模型與源碼說明:原始資料為項目主頁,未提供具體的源碼下載連結、安裝步驟或模型權重取得方式。

項目主頁: https://sunhao242.github.io/TryOnCrafter_web.github.io/

Paper: https://arxiv.org/pdf/2606.26092

Categories: 開源, 阿里巴巴, AI productions, RAG, 數字人, 模型, 視覺模型, 視頻模型, Video, 影像模型, 影像處理, 框架

DomainShuttle 開源:把主角穿梭到任何風格的影片

香港科技大學 C4G 團隊發表 DomainShuttle,以 14B 參數規模實作跨域主體一致性影片生成,並釋出權重與推理代碼。

teaser

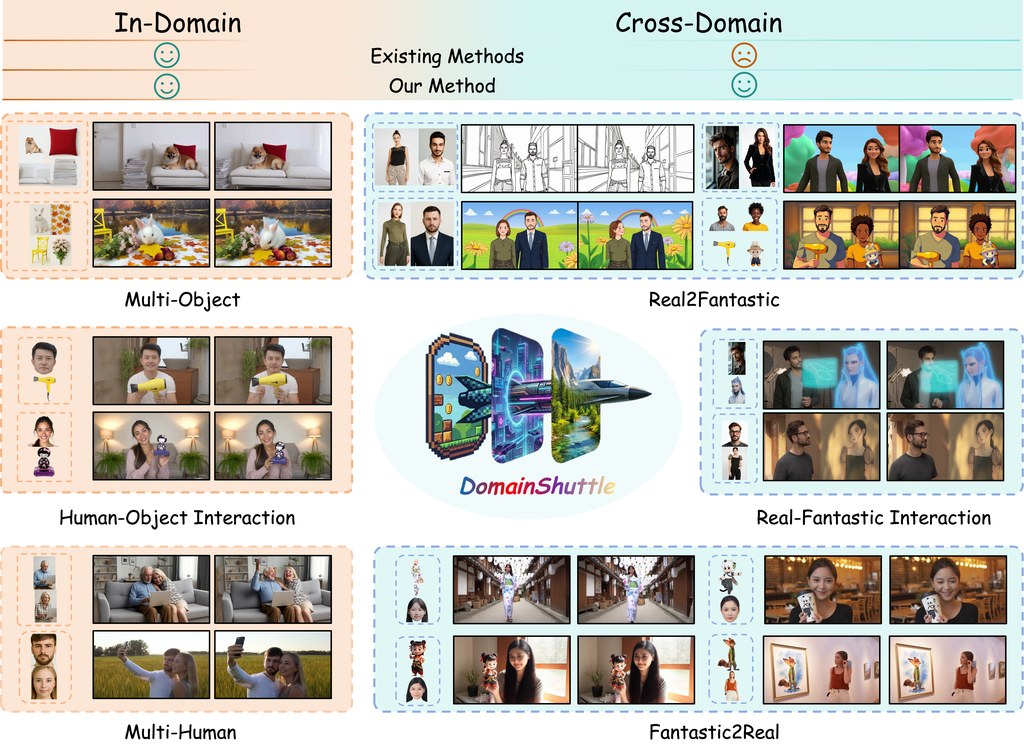
DomainShuttle 是一個以 Wan2.2-T2V-A14B 為基底的 subject-driven text-to-video(主體驅動文字轉影片)框架,目標是讓用戶提供一張參考圖後,能在不同視覺風格與場景中維持同一角色的身份一致性。過去的 subject-driven 方法多在 in-domain(與訓練資料同域)下能保留主體細節,但一旦跨域到風格差異大的場景,主體往往走樣或失去身份特徵;DomainShuttle 把參考特徵與影片特徵解耦,並引入 domain attribute 建模與 intrinsic subject representation,試圖兼顧 in-domain fidelity 與 cross-domain editability。

開發團隊來自香港科技大學 C4G 實驗室,作者群包括 Nan Chen、Yiyang Cai、Rongchang Xie、Junwen Pan、Cheng Chen、Weinan Jia、Zhuowei Chen、Wen Zhou(項目負責人)、Zhenbang Sun 以及通訊作者 Wenhan Luo。等貢獻作者共同發表技術報告,並同時釋出 14B 規模的非官方權重與推理代碼。

先以 conda 建立 Python 3.10 環境並安裝 PyTorch 2.5.1(CUDA 12.4),接著執行 build_env_conda.sh。模型準備分兩步:先用 huggingface-cli 下載 Wan-AI 的 Wan2.2-T2V-A14B 作為基底模型,再下載 CNcreator0331/DomainShuttle_weight,最後將 VAE、configuration.json 等檔案移入指定的 ./models/Diffusion_Transformers/Wan2.2-DomainShuttle-A14B/ 目錄。原始資料未提供完整推論指令片段,相關細節需參考技術報告與項目頁面的後續說明。

從示範結果看,DomainShuttle 能在寫實人物、動漫風、Ghibli 風、3D 動畫風等不同域之間切換,同時保留臉部與服飾特徵,跨域 personalisation 效果明顯。適合短片創作、角色 IP 化、廣告分鏡與動畫預覽等需要「同一角色穿梭多場景」的團隊。需注意目前釋出的是非官方實作,且依賴 14B 規模的基座模型,部署對顯存要求較高。

重點摘要:

  • 類型:subject-driven text-to-video 框架,建基於 Wan2.2-T2V-A14B
  • 開發團隊:香港科技大學 C4G 實驗室,Wen Luo 為通訊作者
  • 核心設計:解耦參考與影片特徵、加入 domain attribute 與 intrinsic subject representation
  • 與同類差異:強調 cross-domain editability,補足過往方法跨域走樣的缺陷
  • 資源:已釋出 14B 權重、技術報告與推理代碼,需 CUDA 12.4 環境

GitHub: https://github.com/HKUST-C4G/DomainShuttle

項目主頁: https://cn-makers.github.io/DomainShuttle/

模型: https://huggingface.co/CNcreator0331/DomainShuttle_weight

Categories: 開源, 香港科技大學, 模型, 視覺模型, 視頻模型, NVIDIA, Stable Diffusion, Video, 框架, 香港, Content Creator, IDE, 3D, Python NLP, Python, 動畫

Page 44 of 55
1 … 42 43 44 45 46 … 55