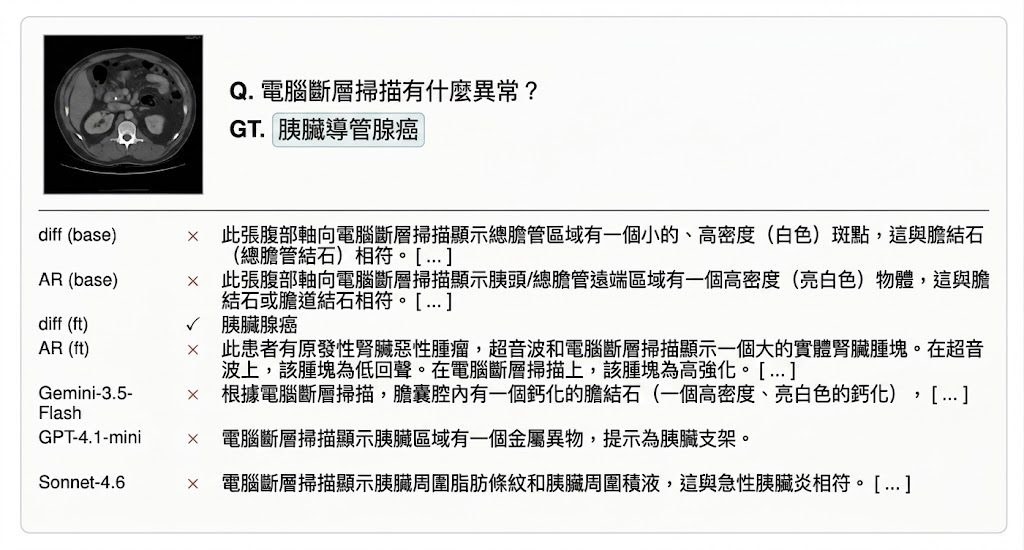
discrete_diffusion_RRG:離散擴散模型點樣寫胸肺 X 光報告

這是一個醫學影像語言模型微調與評測項目,重點是比較 DiffusionGemma 與自回歸基線。它也示範任何順序補全文本在放射報告草稿中的價值。

Repository image for mxvp/discrete_diffusion_RRG

這是一個醫學影像語言模型微調與評測項目,核心是把 image-conditioned discrete-diffusion language model 與 autoregressive baseline 放在同一家族骨幹下直接比較。它主要處理 chest X-ray VQA 與放射報告補全,目標不是單純生成文字,而是讓模型根據 X 光影像回答問題,或在已知部分句子的情況下補寫其餘內容。

項目的設計重點在於控制變因:DiffusionGemma 與 Gemma-4-26B 使用相近的 backbone family、vision tower、資料與 LoRA 配方,令比較更集中於生成方式本身。diffusion 路線把報告當成可逐步去噪的 decoder canvas,autoregressive 則沿用 next-token 順序生成;前者的優勢是可以做 any-order infill,用雙向脈絡補空位,後者則較接近現時多數 VLM 的常見做法。

部署與測試門檻不算低。模型權重透過 Hugging Face IDs 載入,設定檔要接駁本地 JSON 資料索引;倉庫也提供 synthetic: {n: 16} 這種小型 smoke test,適合先確認流程有沒有跑通。硬件要求比較明確,diffusion backbone 需要支援 bf16 的 GPU,而且記憶體大約要 80 GB,這已經把它定位成研究團隊或具備高階 GPU 環境的醫療 AI 項目。

效能表現有幾個值得留意的點。支援內容提到 Discrete Diffusion Language Models 在醫療 VQA 上可追平,甚至略勝同系 autoregression,解碼速度亦可達 3.5 至 4.4 倍;不過目前較完整的準確度重心仍放在 VQA,而報告生成部分主要展示互動式 infill 能力,未算是完整臨床報告生成系統。語義評分還可接 LLM judge,但這部分需要額外 API 金鑰,也表示結果解讀仍有一定研究性質。

  • 類型上,它較接近研究原型加評測程式碼,不是即裝即用的臨床軟件。
  • 主要資料來源包括 VQA-RAD、SLAKE、VQA-Med 與 MIMIC-CXR。
  • 相關模型包括 DiffusionGemma-26B、Gemma-4-26B,並以 LoRA 方式微調。
  • any-order infill 是最有辨識度的能力,適合先固定部分報告內容,再由模型補全其餘位置。
  • 適合需要比較生成範式、研究 radiology report drafting,或想驗證 discrete diffusion 在醫療場景表現的團隊。
項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, Google, Gemini, API, Image, Medical醫學, Dataset 數據集

MrFlow:文字生成圖片提速新路線

MrFlow 用分階段取樣加速 flow-matching 圖像生成,重點是唔使重新訓練模型。它追求高倍提速,同時盡量守住畫面細節。

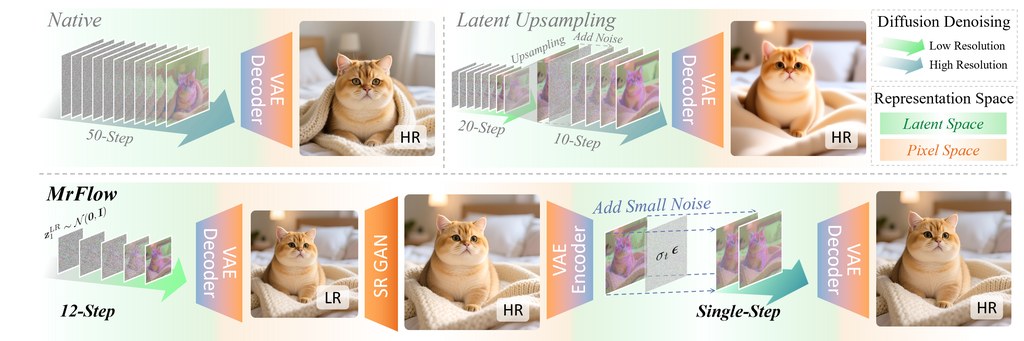
MrFlow framework

MrFlow 是一個訓練免除的圖像生成加速方法,屬於針對 flow-matching text-to-image diffusion models 的研究原型與實作。它要解決的問題很直接:高解析度出圖太慢,因此先在低解析度完成大部分生成,再用較短的高解析度修補流程補回細節。

現有多解析度加速方法,通常會在 latent space 做上採樣,或者只改動部分區域;作者認為這種固定範式容易帶來模糊感與 artifact。MrFlow 改用 pixel space 的 Real-ESRGAN 做超解析度,之後重新編碼、注入與 scheduler 一致的低強度雜訊,再做短步數 refinement,將昂貴的高解析度 denoising 成本,大幅轉移到較便宜的低解析度階段。

這個項目的取向相當務實,因為它不要求 finetuning、learned upsampler,亦唔需要 model-specific retraining 或 custom kernels,直接建立在 PyTorch、Diffusers 與既有 scheduler 控制之上。部署理解上,它比較像一條可插入現成模型流程的 sampling pipeline:先準備 Diffusers 相容環境、對應的預訓練模型權重,以及 Real-ESRGAN 的 x2 權重,再把 README 內示例腳本的 checkpoint 路徑換成本地設定即可。

效能數字是這個項目的核心賣點。資料指出,MrFlow 在 Qwen-Image 可做到超過 10x end-to-end speedup,論文亦提到相對加速前的 OneIG 差距可控制在 1% 以內;再配合 timestep-distilled models,例如 Pi-Flow 與 FLUX-schnell,整體加速可進一步去到 25x。這種設計也已展示可轉移到 Qwen-Image、FLUX.1-dev、FLUX.2 Klein 與 Z-Image family,代表它不是只綁死單一模型。

  • 類型定位:訓練免除的 staged sampling 加速方法,唔係新底模本身
  • 主要差異:避開 latent space 上採樣路線,改用 pixel space 超解析度加短程高解析度修補
  • 部署重點:依賴 PyTorch、Diffusers、Transformers、Real-ESRGAN,並需自行配置模型與權重路徑
  • 適合場景:要保留畫質、又想縮短生成時間的圖像生成團隊與研究人員
  • 相關模型:Qwen-Image、FLUX.1-dev、FLUX.2 Klein、Z-Image、Pi-Flow、FLUX-schnell

MrFlow 最適合放在已有文字生成圖片流程的項目之中,作為加速層而不是完整替代品。它的限制亦很清楚:仍然依賴外部超解析度模型與既有 backbone 品質,重點在於重新分配算力成本,未必等於所有提示詞、所有畫風都能無代價複製原本高解析度長步數生成的結果。

GitHub · Paper

Categories: 開源, Qwen, NVIDIA, Stable Diffusion, Image, txt2img, Python, 中國

AnyGroundBench 點出影片定位模型盲點

AnyGroundBench不是新模型,而是專門測試影片理解能力的 benchmark。它把專業場景放入同一套規則,直接揭示現有 VLMs 的適應落差。

Repository image for rinost081/AnyGroundBench

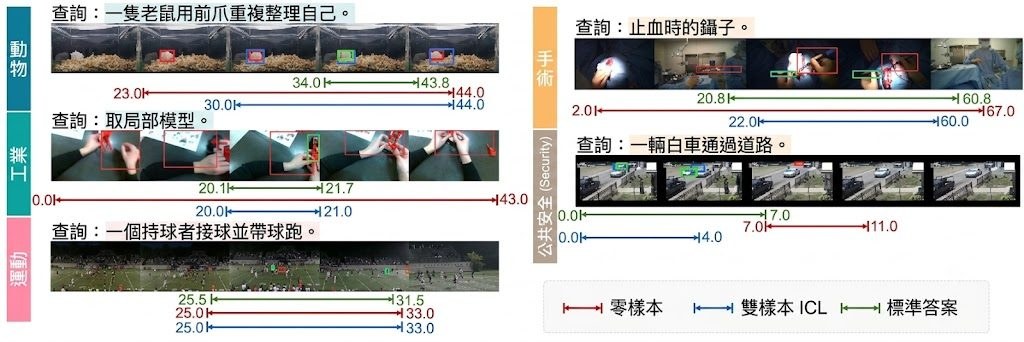
AnyGroundBench 是一個影片 grounding benchmark,也是面向專業領域的資料集與評測基準。它主要用來測試 Vision-Language Models(VLMs)在 animal、industry、sports、surgery、public security 幾類場景中,能否把文字描述準確對應到影片中的時間、位置,以及時空同時發生的事件。

現有做法多數停留在 general、daily-life benchmark 的 zero-shot 測試,重點是看模型有沒有通用理解力;作者認為這種範式無法反映專門場景,因為稀有視覺概念、複雜動作關係與領域術語,通常不會在通用資料裡被充分學到。AnyGroundBench 因而把評測重心轉去 domain adaptation,並加入 dedicated training subsets,令測試不再只問模型「有沒有見過」,而是進一步量度它「能不能適應新領域」。

這個項目的差異,在於它把 temporal、spatial、spatio-temporal annotations 用統一方式整理,並混合 newly captured videos 與 existing datasets。資料來源涵蓋 mouse、american_football、Animal-Kingdom、MECCANO、EgoSurgery 等,覆蓋面比單一領域 benchmark 廣,亦更接近研究團隊、產業分析、醫療影像研究與安全監測場景會遇到的資料分佈。

項目提供 Hugging Face dataset、project page:這不是即插即用應用程式,而是供研究與模型比較的 benchmark。部署重點不是介面安裝,而是按 domain 讀取整理後的資料,然後以 STVG、TVG、SVG 三類任務跑推理與評分;指標分別用 vIoU@0.3、tIoU@0.3、sIoU@0.3。

  • 類型屬於 benchmark / 資料集,目的是測量 VLMs 的 specialized-domain video grounding 能力
  • 舊範式以 zero-shot general benchmark 為主,新設計改為檢查 domain adaptation 與 In-Context Learning(ICL)是否真的有效
  • 評測涵蓋 temporal、spatial、spatio-temporal 三層,較容易看出模型究竟是看錯時間、找錯位置,還是兩邊都失準
  • 已評測 15 個 state-of-the-art VLMs,結果指出現有模型在 specialized domains 的 zero-shot 與 ICL 表現都不穩定

建議模型包括 GPT-4o、GPT-5.1、Gemini-2.5-Flash 等 proprietary VLMs;現有結果顯示,加入 2-shot ICL 雖然在部分 domain 有改善,但整體仍未解決 specialized-domain spatio-temporal reasoning 的缺口。對研究 VLM evaluation、video grounding、視覺模型遷移能力的團隊來說,這個項目最有價值的地方,是它把「通用測試看似可用」與「專業場景仍然失手」之間的差距量化出來。

項目主頁 · GitHub · Paper

Categories: 開源, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, OpenAI, Gemini, Video, 安全, Dataset 數據集

Higgs TTS 3:4B 多語語音生成模型

這是一個主打對話語音生成的 4B TTS 模型,支援 100+ 語言與 zero-shot voice cloning。並提供清楚架構與限制,但未見 GGUF 量化檔。

Og image

這是一個文字轉語音模型 Higgs TTS 3 4B;暫沒有標明它是基於哪個 base model 微調而成。它主要用來把模型回應轉成更接近對話風格的語音,而不只是朗讀文字,並支援 zero-shot voice cloning、情緒、語氣、停頓同 sound effects 控制。

模型核心是約 4B 參數的 autoregressive decoder,規格包括 36 layers、hidden size 2560,以及 GQA 32/8。音訊端先由 Higgs Tokenizer 編碼成 8 個 codebooks、25 fps 的 audio tokens,再透過 delay pattern、multi-codebook fused embedding 同 multi-codebook fused head 處理,最後還原成 24 kHz waveform;這種設計重點在於同時建模文字與音訊 token,讓語音表達更連續。

訓練序列長度為 8,192 tokens,對長句、多輪語音回應會有幫助。語言覆蓋超過 100 種,並提到 102 種語言做到單位數 WER/CER,其中 85 種達到低於 5 的水準,代表它不只追求可讀性,亦重視跨語言穩定度。

  • 定位清楚:偏向 voice chat 與 expressive conversational speech,而非單純 TTS 朗讀器。
  • 控制能力完整:可直接控制 emotion、style、prosody、pauses 與 sound effects。
  • 多語能力強:支援 100+ 語言,102 種語言有公開 WER/CER 描述。
  • 授權限制明確:只開放 research and non-commercial use,商業用途需另取授權。

模型未提供 GGUF 格式、量化級別、檔案大小、mmproj、llama.cpp、Ollama 或 LM Studio 支援資訊,也未見 v2 檔名變更、chat template 注意事項與 MTP draft speculation 相關內容;這些多數屬於 LLM 或多模態推理頁面常見資訊,並非此 TTS 頁面的重點。使用上更值得留意的是授權條款與風險限制,包括未經同意的 voice cloning、冒充、詐騙、選舉誤導與生物識別監控都被禁止。

項目主頁 · 模型

Categories: 開源, 文字轉語音, 模型, Audio, Clone, 語音

OpenMontage:AI 代理拍片流程

OpenMontage 想把 AI coding assistant 變成自動化影片製作流程。它重點不只生圖做片,亦會搜集真實動態素材再完成剪輯。

影片製作最花時間的,往往不是按下生成按鈕,而是串接研究、腳本、素材、配音與剪接。OpenMontage Studio 是一個由 AI agents 驅動的創意工作空間,處理影片、圖片、音訊、動畫與 3D 內容,亦可從既有素材開始完成單一任務。

它把製作拆成 8 個階段及 1 個審批關卡:Brief、Research、Script、Scene Plan、The Gate、Narration、Music、Compose 與 Render。系統會先整理受眾、时长、語氣與訊息,再研究產品畫面、參考影片及競爭對手,繼而產出附旁白與 B-roll 指示的劇本。The Gate 會列出將使用的素材、模型、旁白及音樂,待確認或修改後才繼續製作。

  • 研究與定位資料會寫入 decision log,保留決策依據。
  • 場景可混合採用現有素材、素材庫、Stock 素材或生成內容。
  • 旁白可按句子加入修改意見,不必重寫整篇內容。
  • 音樂可按氣氛、每分鐘拍數及能量配對,亦可另行生成。
  • 製作可在 OpenMontage Studio、Claude Code 或 ChatGPT Codex 進行。

這種做法適合已有品牌資料、產品錄影或商品素材的團隊,可由一個構思直接建立完整短片,也可只處理配音、音訊清理或視覺生成。代價是製作仍需經過 The Gate 審批,AI 的研究、定位與場景選擇亦不代表最終成品必然準確;創作者仍要核對品牌訊息、素材授權及輸出質素。

GitHub

Categories: 開源, Agentic, 微軟, Video, Image, txt2img, Content Creator, IDE, Anthropic

MemoBench 點樣測世界模型記憶力

MemoBench專門檢查世界生成模型會否在物件離鏡後再出現時「記錯樣」。它用V-D-R流程,把畫質、一致性與語意判斷拆開量度。

Repository image for MemoBench-Team/MemoBench

MemoBench 是一個 benchmark,屬於用來評測 world generation models 的數據集加評測工具組。它主要檢查模型在鏡頭移開再回來之後,能否把同一個物件的外觀、位置與狀態準確重建,而不是只生成一段看似流暢的影片。

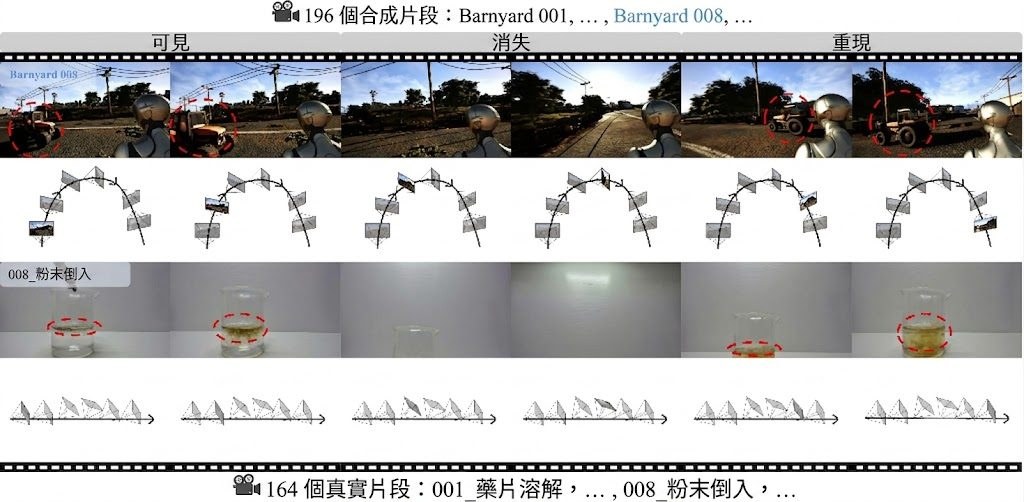
現有影片生成或世界模型評測,很多時集中在畫質、動作流暢度,或者短時間一致性;作者認為這類範式未必能測到 visual memory。MemoBench 因此用 V-D-R (Visible → Disappeared → Reappear) 結構重組任務:先見到目標物件,再讓它離開視野,最後要求模型在重返視野時保持物件永久性與幾何一致性,這比單看首尾畫面更接近真正的記憶測試。

資料部分有 360 段片,分成 196 段 synthetic 與 164 段 real-world clips,並提供 V-D-R 邊界、GT camera poses、目標物件文字描述、VQA question banks 等配套。部署思路相當清楚:環境以 Linux、Python 3.11、CUDA GPU 為主,評測流程分成自動指標、Object Revisit Score (ORS),以及 VQA 三步,輸入格式是逐格 PNG 圖片;camera controllability 會用到 MapAnything,ORS 會用到 SAM-3。

它和同類 benchmark 的差異,不在於片段數量特別大,而在於把「物件消失後再出現」設成核心壓力測試,並同時覆蓋 synthetic 與真實場景。14 項指標亦不是只量畫面好不好看,還會看 temporal consistency、geometric fidelity、object permanence、camera controllability,以及 VQA-based reasoning,取向明顯偏向診斷模型缺口,而不是只做單一排行榜。

  • 適合比較 不同 world generation models 在長時序記憶上的穩定度
  • 測試材料完整,包含 phase 邊界、相機姿態、文字提示與 VQA 題庫
  • 評測角度較細,把低階畫質與高階語意一致性分開量度
  • 部署門檻不算低,需要 Linux、CUDA GPU,亦依賴 MapAnything 與 SAM-3

相關模型方面,官方內容提到已基準測試 8 個模型,但這份儲存庫摘要未列出完整名稱,因此較穩妥的理解是:MemoBench 重點不是提供新模型,而是提供一套可重覆的記憶一致性測試基準。對研究 world modeling、影片生成、camera-controlled generation 的團隊尤其有參考價值,因為它能幫你分辨模型是「畫得靚」,還是真正記得之前見過什麼。

項目主頁 · GitHub · Paper

Categories: Google, NVIDIA, Image, 框架, Linux, Python

PRA:像素級自回歸生圖的新路線

PRA 是一個 PyTorch 影像生成研究項目,主打 pixel-space autoregressive 生成。它嘗試用較細模型規模,換到更低 FID 表現。

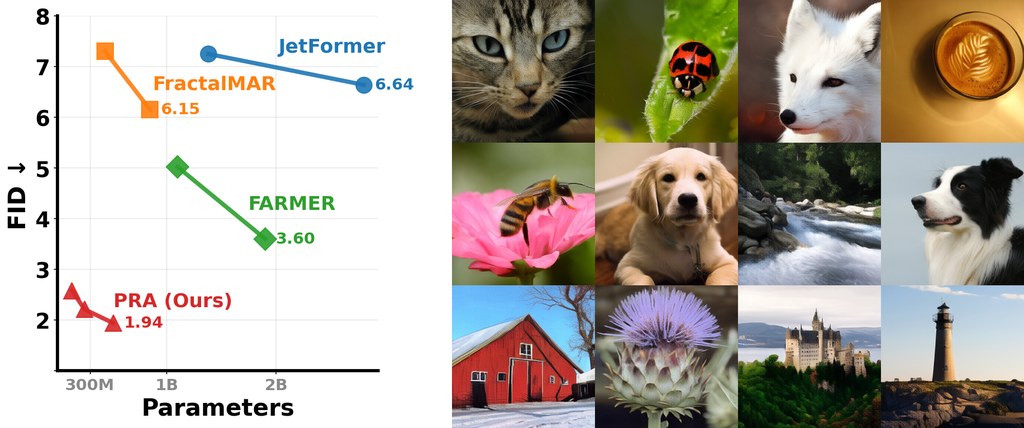
result

PRA 是一個以 PyTorch 實作的影像生成研究項目,屬於 class-conditional pixel-space autoregressive image generation 模型與訓練框架。它要解決的問題,是直接在像素空間逐步生成圖片時,單步誤差大、而且 teacher-forced training 與推理流程不一致,令誤差一路累積。

現有 pixel-space continuous-token autoregressive 做法,多數直接預測高維像素 patch,或用 x-prediction、input noise injection 減輕誤差,但改善有限;exact rollout training 雖然更貼近推理,代價又太高。PRA 的取向是加入 Parallel Rollout Approximation (PRA):先生成低維 intermediate states,再經 pixel decoder 映射回 pixel-space tokens,同時用近似推理時的 pixel-feedback 方式保留平行訓練效率。

這個設計的重點,不是單純追求更大模型,而是重新處理「訓練見到的輸入」與「生成時真正收到的回饋」之間的落差。論文資料顯示,它在 ImageNet-1K 256×256 的 class-conditional 生成上,PRA-S 135M 參數已做到 FID 2.58,優於先前 billion-scale pixel-space AR 的 3.60;PRA-L 511M 進一步到 1.94,定位很清楚,就是衝着 pixel-space AR 的 SOTA 而來。

部署理解上,儲存庫已提供 environment.yml、requirements.txt、預訓練權重與 sample_ddp.py,代表作者預設你會用多卡分散式抽樣與評測。評估指標包括 FID、Inception Score、precision、recall,另有 ImageNet classification probing accuracy 作為生成以外的補充觀察,表示作者也在測試表徵能力,而不只看出圖漂亮與否。

  • 項目類型:研究原型兼模型實作,集中展示 PRA 訓練與取樣流程
  • 相關模型:PRA-S、PRA-B、PRA-L,參數量約 135M、250M、511M
  • 主要差異:不用離散 tokenizer,維持 pixel-in、pixel-out AR 介面
  • 較適合情境:研究 pixel-space AR、比較生成指標、重現 ImageNet 類條件生圖結果
  • 需要留意:目前公開內容偏向研究重現,不是即裝即用的終端應用工具

受益最大的,會是做影像生成研究的團隊、想比較 autoregressive 與 diffusion 路線的人,以及要研究像素空間建模取捨的學術項目。對一般開發者來說,這個項目較像高水準實驗平台;有現成 checkpoint 和評測流程是優點,但 CUDA、PyTorch 與 FlashAttention 相容性仍需自行處理。

GitHub · Paper

Categories: 北京大學, 模型訓練, Image, 影像模型, Python

微軟用殘差強化學習補強機械人 VLA

這是一個提升機械人操控穩定性的研究方法。它用模擬訓練的殘差策略,零樣本補強真實世界的 VLA 表現。

Og image

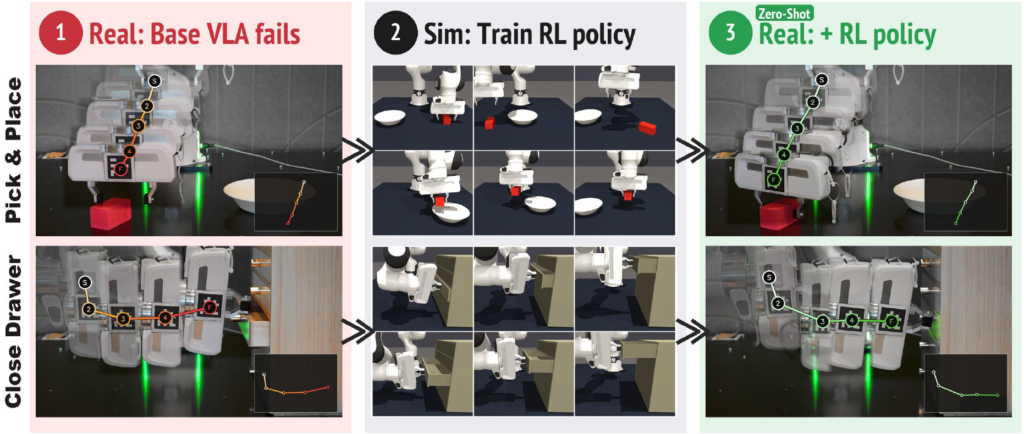
這是 Microsoft Research 的 Object-Centric Residual RL 方法。它的用途是為 Vision-Language-Action(VLA) 模型加入一層修正策略,減少機械人在真實操控中因細小誤差累積而失手的情況。

核心做法是把一個已凍結的 base VLA 保留不變,再額外疊加一個輕量 residual policy。這個 residual policy 完全在模擬環境訓練,輸入不是原始影像,而是 object-centric state、proprioception,以及 base VLA action,藉此避開常見的 visual sim-to-real gap,令策略可直接 zero-shot 轉移到真實機械人。

這個方法處理的是 imitation learning 常見的脆弱性:示範資料未覆蓋到的狀態一旦出現,誤差會一路放大。與直接微調 VLA、或在真實世界再做 reinforcement learning 相比,這個方法的差異在於只學「修正量」,而且訓練放在模擬中完成,成本與風險都較低。

  • 保留 frozen base VLA,不用重訓整個模型
  • residual policy 以物件中心狀態為主,減少依賴影像對齊
  • 目標是 zero-shot sim-to-real enhancement
  • 適合需要精準抓取、放置或接觸操作的機械人工作流

這類方法較適合關注 VLA、Robotic 與 sim-to-real transfer 的研究者和開發者。現有資料清楚交代方法方向與問題設定,但未提供完整安裝流程或操作步驟;評估部分可確認作者以真實機械人成功率改善作為重點,更多數值細節仍需參考原始論文。

項目主頁 · Paper

Categories: Agentic, AI productions, 視覺模型, 多模態模型, 微軟, Image, VLA, Robotic, 框架, 編程, 安全

SimFoundry:單段影片變機械人模擬場景

這是 NVIDIA 的 real-to-sim 項目,可把真實場景影片自動轉成可互動模擬環境。它主打機械人策略訓練、評測與 sim-to-real 遷移。

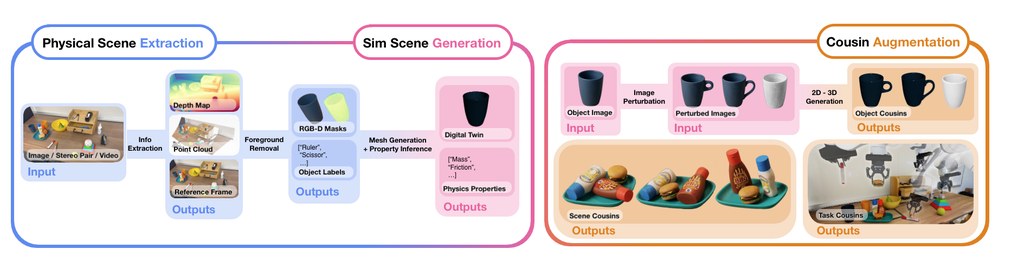
Digital twin and cousins of the wooden drawer organizer

這是一個由 NVIDIA Research 推出的 robot learning 項目。它的主要用途是把單一真實場景的圖片或影片,自動轉成可供機械人策略訓練與評估的互動式 simulation environment,減少真實世界收集數據與反覆測試的成本。

SimFoundry 的核心做法是建立 modular and automated 的 zero-shot real-to-sim pipeline,從單一影像或影片生成 sim-ready digital twins,並支援 object、scene 與 task editing。除了重建原場景,系統亦可自動產生多種 digital cousins,讓同一個任務在不同物件配置、場景條件或操作要求下擴展訓練資料,提升策略泛化能力。

和常見要大量人工建模、手動調參或依賴多視角掃描的做法相比,這個項目強調以較低輸入門檻快速建立可用模擬場景。頁面亦提到 hybrid scene 表示方式,結合 3D Gaussian Splat 背景與 textured object meshes,重點不只在視覺重建,而是要讓場景可直接用於 policy learning and evaluation。

重點摘要:
– 以單一 image 或 video 建立 real-to-sim 場景
– 可生成 sim-ready digital twins,並編輯 object、scene、task
– digital cousins 有助擴充訓練變化,改善 sim-to-real 泛化
– 在 7 個 manipulation tasks、5 個 policies 上,simulation evaluation 與真實表現高度相關
– object、scene、task cousins 分別帶來平均 17%、21%、50% 任務成功率提升

評測結果顯示,SimFoundry 在 7 項 manipulation tasks 與 5 個 policies 上,simulation evaluation 對真實世界表現具有很強預測力,mean Pearson correlation 為 0.928,mean maximum ranking violation 為 0.018;用於評估真實策略時,頁面亦列出 mean Pearson correlation 0.911。文中提及的策略包括 DreamZero、Gr00t N1.7、π 0.5,顯示這個項目適合用於機械人操作研究、policy benchmarking,以及想以較低成本建立可重複測試流程的團隊。

項目主頁 · Paper

Categories: 模型訓練, NVIDIA, Video, Robotic, 3D

PhysisForcing 提升機械人世界模擬可靠性

這是一個強化影片生成物理一致性的訓練框架,用來改善機械人操作模擬的可信度。

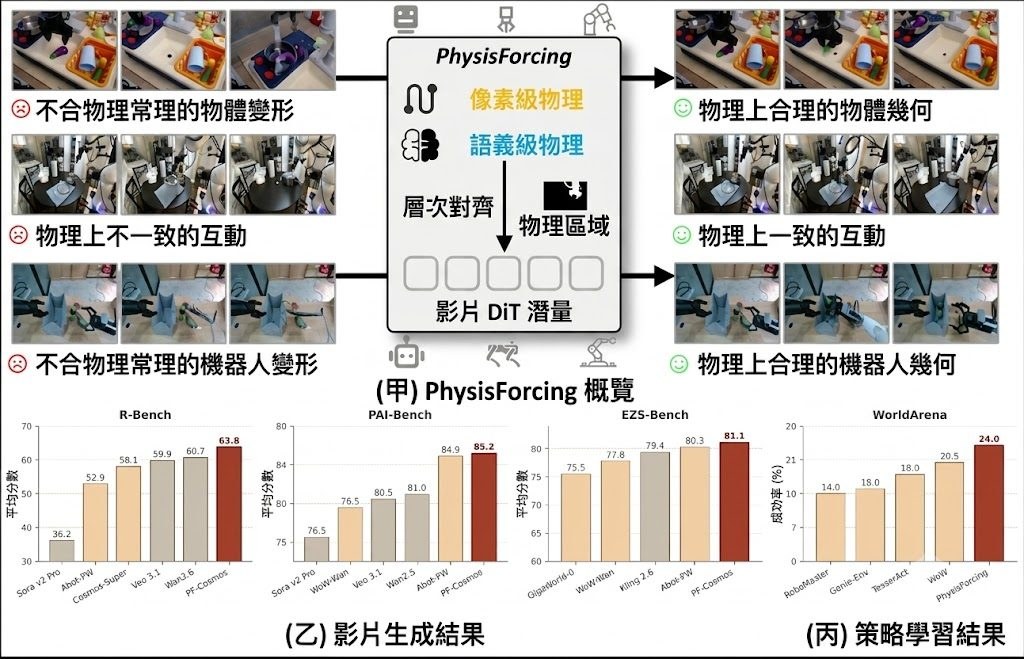
Teaser Figure

這是一個用於機械人操作的世界模擬訓練框架,名為 PhysisForcing。它主要解決影片生成模型在模擬抓取、推動與物件互動時,常出現動作軌跡不連續、物件變形和互動不合物理規律的問題。

PhysisForcing 的做法不是單靠生成更像真的畫面,而是把訓練重點放在與物理相關的區域,並同時加入像素層與語意層兩種約束。像素層的 trajectory alignment loss 會用參考點軌跡監督 DiT features,語意層的 relational alignment loss 則利用凍結的影片理解編碼器,對齊區域之間的互動關係,令機械臂與物件之間的時空關聯更穩定。

和一般通用影片生成模型,或只針對機械人資料做微調的方法相比,這個框架更集中處理「物理合理性」而非單純畫面觀感。它可套用在標準 diffusion video backbones 之上,已展示於 Wan2.2-I2V-A14B 與 Cosmos3-Nano 這兩個基礎模型。

  • 核心重點是分層物理對齊:同時改善運動一致性與互動關係一致性
  • 適合用於 embodied world simulation、robotic manipulation 與下游動作規劃
  • 在 R-Bench、PAI-Bench、EZS-Bench 都較強基線有提升
  • R-Bench 上,Wan2.2-I2V-A14B 提升 +22.3%,Cosmos3-Nano 提升 +9.2%
  • 納入 WorldArena action-planner protocol 後,closed-loop success rate 由 16.0% 升至 24.0%

這項工作對需要用影片模型做機械人訓練、模擬驗證或策略學習的人較有參考價值,因為它不只改善生成片段的外觀,亦提升作為 world model 的可用性。現有資料顯示,物理對齊後的影片表徵亦能帶動下游 policy success,說明這類方法不只是視覺修飾,而是直接影響機械人操作結果。

項目主頁 · Paper

Categories: 開源, 北京大學, 模型, 視頻模型, 世界模型, 模型訓練, NVIDIA, Video, Robotic, 框架

Page 43 of 55
1 … 41 42 43 44 45 … 55