InternVLA-A1.5:機械人策略一體化新路線

想像同一個模型既睇得明畫面與指令,又會預想下一步場景,再直接輸出動作。InternVLA-A1.5吸引之處,正正在於它把這三件事收在同一套機械人政策裡。

InternVLA-A1.5 teaser

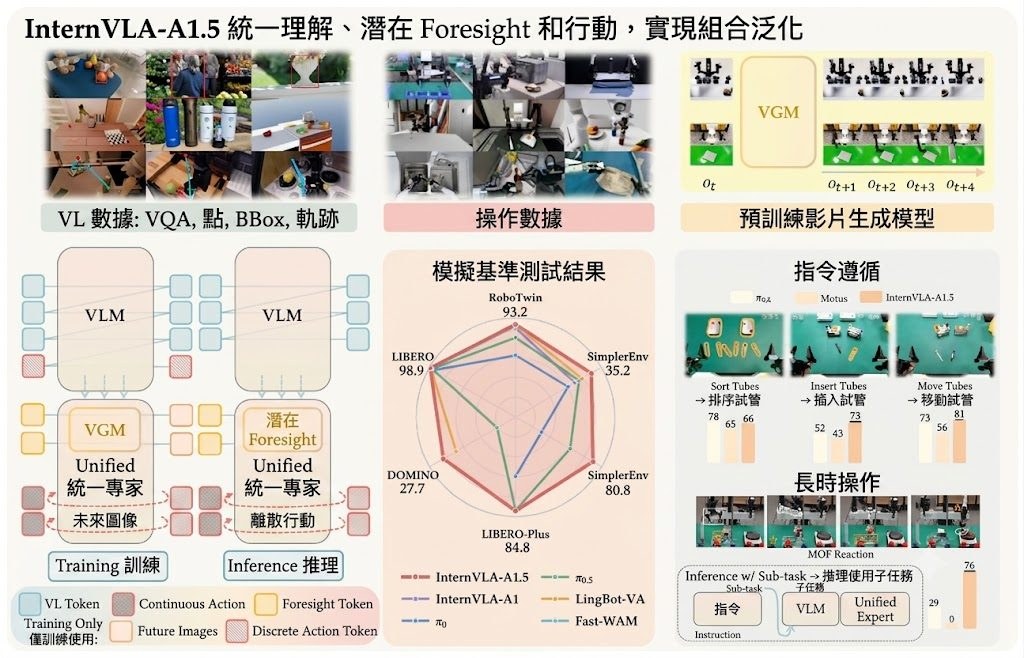
機械人操作最麻煩的地方,往往不是單純辨認畫面,而是要同時理解指令、估計接下來會發生什麼,再穩定地做出連續動作。InternVLA-A1.5屬於開源框架兼機械人政策模型,焦點放在把 vision-language understanding、latent visual foresight 與 action generation 合併,減少多模組串接帶來的延遲與協調成本。

它的取向很清楚:不少做法會把感知、未來預測、控制分開訓練或分開部署,InternVLA-A1.5則把 foresight 放進同一條政策路徑,在訓練期間借助凍結的 WAN2.2-5B video generation model 提供未來動態監督,但推理時丟棄 video branch,只保留動作預測。這個設計的好處是保住「先想一步」的能力,同時避免部署到真實機械人時推理太重。

模型骨幹建基於 Qwen3.5-2B VLM,透過 shared full-attention layers 接上一個輕量 unified action expert,並保留 modality-specific Gated DeltaNet processing;動作輸出則用 flow matching 預測 continuous action chunks。README 亦提到它可用於部署、數據收集和評估真實機器人上訓練有素的操作策略,但公開資訊較集中在模型與 benchmark,具體安裝流程與真機部署步驟未見完整展開。

  • 舊路線常把理解、預測、控制拆開,這個項目改為單一 policy 統一處理
  • 訓練用 WAN2.2-5B 學未來動態,推理時移除相關分支,換取較實際延遲
  • 已在 LeRobot V2.1 dataset 微調,亦結合大規模機械人與多模態資料
  • 基準成績突出:RoboTwin 2.0 為 93.2,LIBERO 為 98.9,LIBERO-Plus 為 84.8
  • 可取得的相關模型包括 InternVLA-A1.5-base、InternVLA-A1.5-RoboTwin、InternVLA-A1.5-Libero

從定位來看,它較適合想把研究原型推近真機驗證的團隊,尤其是同時重視語言理解、視覺泛化與操作成功率的人。現階段最值得留意的,不只是分數高,而是它示範了一種更接近完整機械人工作流的整合方式;限制則是公開說明仍偏研究導向,真正落地前仍需自行補足部署細節與硬件整合資訊。
項目主頁 · GitHub · 模型

Categories: 開源, 上海人工智慧實驗室, 視覺模型, 多模態模型, 視頻模型, Qwen, Video, VLA, Robotic, Dataset 數據集

PixWorld 把 3D 重建與生成收在同一路線

想由幾張視角圖重建場景,或者直接做 text→3D、image→3D,PixWorld 把兩條路合併成同一個模型。它的吸引力不只在速度,亦在於訓練目標更貼近 3D 場景本身。

PixWorld teaser

做 3D 場景時,很多方法會把重建同生成分開處理,PixWorld 就反其道而行,把兩者收進同一個開源框架式研究項目:同一個 end-to-end pixel-space diffusion model,同一趟 forward pass,同時兼顧 reconstruction 同 generation。對想比較 text→3D、image→3D 同多視角重建流程的人來說,這種設計最大意義在於少一層轉換,也少一套彼此割裂的模型心智負擔。

它批評的舊範式很明確:不少做法先進 latent space,要經過 VAE/RAE,再由 3D decoder 還原成 3D 表示;PixWorld 則直接在 rendered multi-view images 上施加 pixel-space flow-matching loss,令優化目標更貼近 3D scene fidelity,而唔係先對準中介 latent target。作者再加上一個 geometry perception loss,借助 frozen 3D foundation model 的 π³ / VGGT feature space,補回純 2D photometric loss 同 perceptual loss 對 3D 結構監督不足的問題。

它會把 posed multi-view inputs 分成 clean views 同 noisy views:前者走 reconstruction,後者走 generation,並由 two-stream diffusion transformer 處理,最後解碼成 pixel-aligned 3D Gaussian representation。這個取向的好處,是把 3D reconstruction、text→3D 同 image→3D 放到同一個表示與訓練框架;代價則是項目目前仍偏研究原型,README 已提到 cleaned RealEstate10K、DL3DV、ACID datasets 以及 PixWorld-480P-4steps distilled weights 與 inference code 尚未完整釋出。

  • 類型定位:屬於模型導向的開源項目,處理 3D scene generation 與 reconstruction 分裂成兩套流程的問題。
  • 主要差異:直接在 pixel space 訓練,避開 VAE/RAE 中介表示,並加入 geometry-aware 監督。
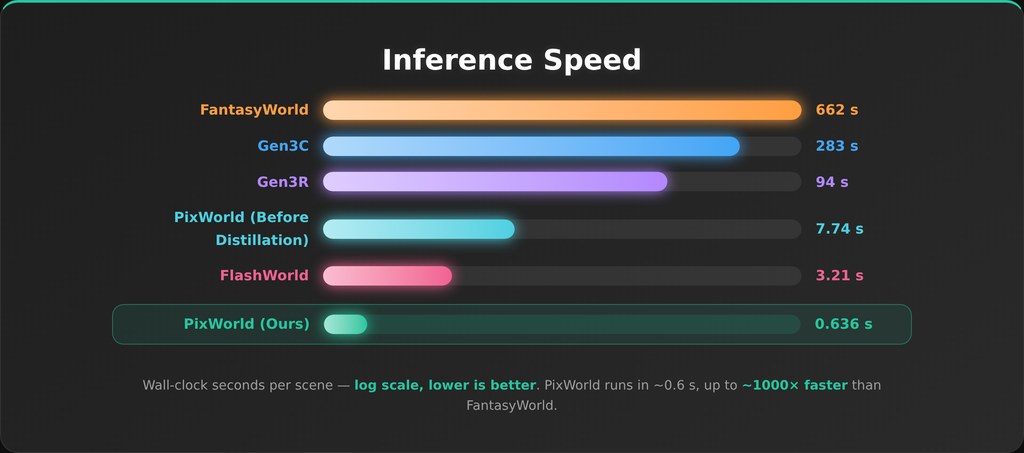
  • 已知表現:distilled 4-step 版本每個 scene 約 0.6 秒,官方稱相對 diffusion-based world generators 峰值可達約 1000× 加速。
  • 重建指標:提供 71.04 WorldScore average,以及 RealEstate10K 4-view reconstruction 的 26.21 dB PSNR。
  • 相關模型與模組:two-stream diffusion transformer、pixel-aligned 3D Gaussian、frozen 3D foundation model π³ / VGGT。

現階段較適合研究 3D world generation、3D Gaussian Splatting、multi-view reconstruction 的團隊先用來判斷方法價值,而唔係即刻當成完整生產工具部署。可惜目前公開資訊仍以論文、示範頁與方法介紹為主,未見完整安裝、評測腳本與權重發布,因此較合理的理解方式,是把 PixWorld 視為一條很有方向感的新路線:它不只是追求更快,還試圖重新定義 3D 生成與重建應該共用同一套訓練目標。

項目主頁 · GitHub · Paper

Categories: 開源, 模型, 模型訓練, Image, 3D

EVA-Client 補上真實機械人部署斷層

訓練好嘅操作策略,去到真實機械人往往先開始出現混亂。EVA-Client想處理嘅,正正係部署、記錄同評測之間長期分散嘅那段流程。

EVA-Client Logo

研究團隊把模型訓練做得愈來愈完整,但一到真實機械人落地,常見情況仍然是靠零散 script、臨時橋接同各自為政嘅除錯流程撐住。EVA-Client屬於開源框架,集中處理已訓練操作策略喺真機部署、數據收集與評估之間嘅斷層,重點唔係再訓練一個新模型,而係令整個閉環更可重用。

它同一般只覆蓋單一步驟嘅工具唔同,將 transport、policy backend 同 inference strategy 放入同一套流程,支援 ROS1、ROS2、ZeroMQ 同 offline dataset,也能接 OpenPI、OpenPI-RTC、StarVLA、GR00T、mock、replay。作者明顯想修正「訓練框架成熟,但真機端仍然拼裝化」呢種既有範式,所以瀏覽器內直接整合 debug、部署、錄製、重播同比較,定位相當鮮明。

使用路徑方面,現有資料已交代可以用 .py config 串接機械人通訊、策略後端與推理策略,再透過介面喺 DEBUG、COLLECT、RESULT 分頁切換;不過完整安裝細節仍然要配合官方文件先夠穩陣。資料收集亦唔止錄影,還會保存 camera video、3D URDF scene、state charts、milestone scores,同步回放亦保留 QC PASS/FAIL 與每幀品質旗標,對做 dataset 整理同失敗分析幫助幾大。

  • 把部署、收數同評測放入同一個 browser workflow,減少真機迭代時來回切換工具
  • 支援多種 transport、backend 同 inference strategy,取向偏向兼容不同機械人與策略棧
  • 內建 live latency compensation、async strategy 同 replay,重點放喺真機穩定度而唔只係跑通
  • Teleop demos 與 model rollouts 共用同一套 on-disk layout,方便後續整理成 LeRobot v2.1 episodes

性能數字方面,現有資訊未見統一 benchmark 分數,較多是能力與流程層面的描述,所以暫時唔適合把它理解成用單一指標決勝負嘅項目。較受惠嘅會是做 VLA、VAM、WAM 或機械人操作研究嘅團隊,尤其要頻繁比較 checkpoint、遠端連 policy server、或者同時管理多款真機平台嘅場景;已列出可配合嘅相關模型與系統包括 OpenPI、OpenPI-RTC、StarVLA、GR00T,以及 LeRobot、VLA Foundry 呢類訓練側框架。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, NVIDIA, DeepSeek, Video, VLA, 3D, Dataset 數據集

LingBot-Vision 補強密集空間感知

想做深度估計或語意分割,但又唔想每個下游任務都重訓視覺編碼器,LingBot-Vision正是針對這個卡位而來。它把邊界、形狀同語意區域一併學好,重點放在更可靠的空間特徵。

Boundary-centric masked modeling

做深度估計、語意分割或者影片物件分割時,最麻煩往往唔係有冇大模型,而是編碼器抽出的特徵夠唔夠貼近物件輪廓。LingBot-Vision屬於模型,更準確地說是自監督預訓練的 Vision Transformer 視覺骨幹,處理的是密集空間感知裏面「語意有了,但邊界唔夠準」這個老問題。

它的取向幾明確:唔係一味追求分類式語意表示,而是用 masked boundary modeling 去逼模型同時保留空間結構與語意訊息。凍結後的 patch tokens 已經可以直接支援輕量 readout,涵蓋 depth estimation、semantic segmentation、video object segmentation,亦作為 LingBot-Depth 2.0 的 visual encoder 初始化,這種設計比起只偏重全局語意的 ViT 骨幹,更適合需要逐像素判斷的工作流。

這個項目較接近「取用預訓練骨幹再接下游任務」的用法,而唔係即裝即用的完整應用。模型已放到 Hugging Face 與 ModelScope,較合理的理解方式,是把不同尺寸的 LingBot-Vision 權重接入現有 dense prediction pipeline,先測 frozen features 的表現,再決定需唔需要額外微調。

  • 重點不在生成內容,而在提高 dense spatial perception 的特徵品質
  • 已公開多個相關模型:ViT-S/16、ViT-Base、ViT-L/16,以至 1.1B 參數的 ViT-g/16
  • 支援的方向包括 depth estimation、semantic segmentation、video object segmentation、depth completion
  • 與同類做法相比,更重視 boundary-faithful features,而唔係只強化高層語意表示

受益最大的會是做機械人視覺、3D 感知、影像理解基建的團隊,尤其當你手上已有 segmentation 或 depth 項目,只差一個更穩定的 encoder。性能方面,README 用「substantial performance gains」形容 LingBot-Depth 2.0 在換上 LingBot-Vision 編碼器後的提升,但公開內容未列出完整基準數字,所以現階段較值得先留意其特徵可遷移性,以及在邊界敏感任務上的潛力。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, Video, VLA, 影像處理, Robotic, 3D

Wan Streamer v0.2 提升實時視頻對話畫質

想做會講話、會望向場景嘅即時 AI 角色,畫面清晰度同延遲通常要二揀一。Wan Streamer v0.2 嘗試保住低延遲,同時把視訊互動提升到更自然可用。

Wan Streamer framework

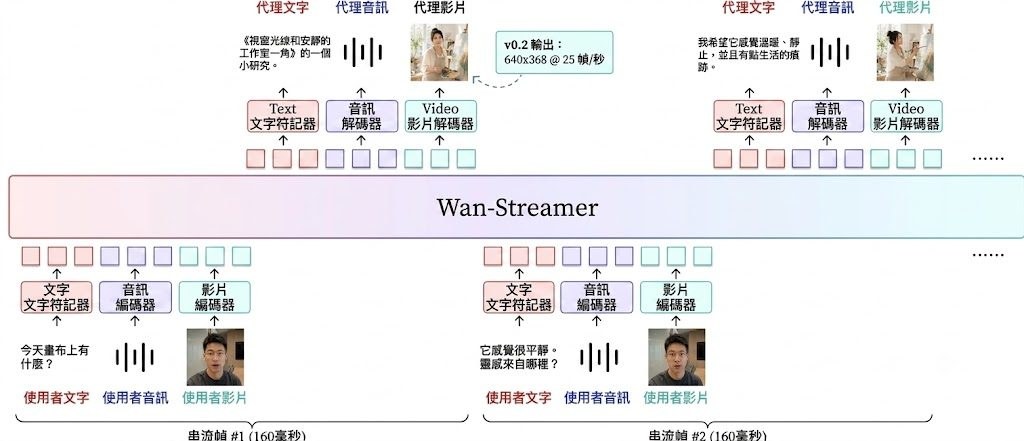
做即時音視頻互動時,最麻煩往往唔係模型識唔識回應,而係畫面一清晰,延遲就容易升高。Wan Streamer v0.2 屬於原生流式 audio-visual interaction model,針對呢個取捨下手:把輸出由 192×336 提升到 640×368,仍維持 25 fps,同時把模型側延遲控制在約 200 ms。

它延續 v0.1 的做法,將文字、音訊、影片放在同一條 causal timeline,用單一 Transformer 協調,並以 block-causal attention 處理串流互動。重點唔係換掉整個架構,而係在低延遲預算不變下,令畫面由近景視像通話,擴展到更有場景感的中景 agent,連姿勢、視線、手部同附近物件都更易看清。

為咗撐起更高解析度而唔增加可見等待時間,v0.2 把高成本 latent 生成路徑移到 Ulysses-style context-parallel performer;另一邊的 thinker 仍留在單 GPU,負責流式感知、狀態更新、KV 建構同最終解碼。呢種分工代表項目唔係單靠堆硬件換速度,而係重新安排推理拓撲,把重負載部分放到更適合並行處理的位置。

  • 輸出解析度由 192×336 提升到 640×368
  • 幀率維持 25 fps,模型側延遲約 200 ms
  • 支援 scene-grounded mid-shot agents,而唔只係近景通話畫面
  • 保留單一 Transformer 的 native-streaming formulation
  • 以 thinker + performer 分工處理低延遲與高成本生成

呢個項目最適合想做即時數字人、互動客服、教學導覽或直播型 agent 的團隊,因為使用者會直接感受到畫面資訊量增加,但對話節奏未必因此變慢。現有資料主要強調架構升級同延遲維持,更完整畫質穩定性、部署成本與長時間使用表現,仍要配合論文與示範一齊判斷。

項目主頁 · Paper

Categories: 阿里巴巴, Agentic, 多模態模型, Video, Audio

GigaWorld-1:機械人世界模型開源路線圖

GigaWorld-1 不只是模型,亦是一套圍繞機械人世界模型的訓練與推理流程。它的重點是用模擬 rollout 協助評估 robot policy。

GigaWorld-1 Teaser

GigaWorld-1 是一個面向 robot world models 的開源工具鏈與研究原型。它主要用來訓練、推理、處理資料,並把世界模型當成 robot policy evaluation 的替代評估器,減少每次都要落真機做 rollout 的成本。

現有做法通常依賴真實機械人測試,或者用偏重短片畫質的 video world models 觀察結果;作者認為這種範式未必足夠反映 policy 是否可靠,因為短期視覺真實感不等於長時序、動作一致的 rollout 準確度。這個項目連同 WMBench 一齊提出較清晰的評測框架,重點放在 long-horizon、action-faithful rollout consistency,而不是只看畫面似唔似真。

和一般只放模型權重的 GitHub 項目相比,GigaWorld-1 較完整地公開了訓練、inference、資料處理、checkpoint conversion 及 LoRA merge 流程,取向明顯偏向可重現與可擴充。基礎模型亦不是由零開始孤立建立,而是結合 Wan、Diffusers、Helios、Genesis 等元件,反映它更像一條可調整的工作流程,而不只是單一模型展示。

  • 重點不在短期畫面好看,而在 rollout 是否長時間維持動作一致性
  • 提供 training、inference、data processing、checkpoint conversion、LoRA merge 等完整流程
  • 相關模型與元件包括 Wan、Diffusers、Helios、Genesis
  • 配套有 ToyDataset、CVPR 2026 WorldModel Track Dataset 與 WMBench benchmark

部署思路相對明確:環境以 Python 3.10+、PyTorch 2.x、Linux 為主,再按 README 準備資料、模型與推理流程;需要下載模型或資料時,亦已有獨立工具說明。硬件需求未算輕量,但首頁提到 1.3B / 5B 變體與低於 24GB 記憶體的生成設定,代表它並非只面向超大規模研究機構。

較適合受益的群體,是做 embodied AI、robotics、world model research 的團隊,以及想建立 policy evaluator 管線的人。現有資訊顯示它背後有 12,000+ 小時訓練影片、324,000+ 模擬 rollout 配對真機執行,以及 7 類 video world models、4 種 action representations 的比較;這些數字未必等於任何場景都會即插即用,但足以說明它的價值在於提供一套有 benchmark 支撐的評估方法,而不只是再多一個生成模型。

項目主頁 · GitHub · Paper

Categories: 開源, 模型, 世界模型, 模型訓練, Video, VLA, Robotic, 框架, Linux, Python, Dataset 數據集


LiveEdit:串流影片編輯走向即時化

LiveEdit 把文字指令變成串流影片編輯,重點放在速度與畫面穩定。它嘗試兼顧即時反應,以及背景與非編輯區域的保留。

Image 1

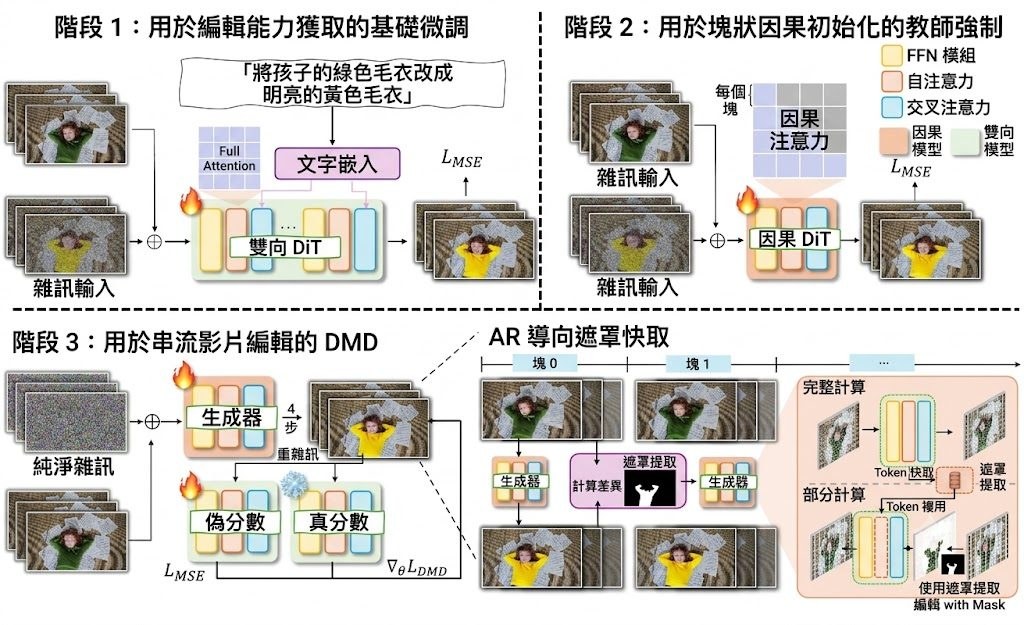
LiveEdit 是一個 diffusion-based streaming video editing 系統,屬於影片編輯模型與方法項目。它的核心任務是根據來源影片加上文字指令,逐段完成 causal chunk-by-chunk editing,並盡量保留背景與沒有修改的區域。

這個項目不是追求離線影片慢慢算到最靚,而是針對接近即時的串流編輯。它建基於 Wan2.1 和 Self-Forcing codebase,並用 three-stage distillation,把雙向編輯 teacher 的能力轉移到串流 student,再配合 AR-oriented Mask Cache 減少重複運算,換來較低延遲。

部署與測試資訊算是完整,提供 inference scripts、training code、checkpoint instructions,也講明建議在 Linux 配合 NVIDIA GPUs 執行;單 GPU 可做 inference,多 GPU torchrun 主要用於訓練。輸入方式是準備一個 JSON,填入 source video 路徑和 instruction,然後配合已釋出的權重與 Wan2.1 base model 進行推理。

有一個相當關鍵的參考值:項目頁列出 12.66 FPS,並表示透過 4-step distilled diffusion generation 達成 real-time streaming inference。這個成績對互動式影片編輯很重要,不過公開資訊未見更完整的硬件條件、顯存需求或不同解析度下的比較,因此判斷效能時仍要保留一點。

  • 重點不是一般文字生片,而是保留原片內容的串流影片編輯
  • 主要技術包括 three-stage distillation、Causal DiT、AR-oriented Mask Cache
  • 已公開 inference 與 training 程式碼,也提供 Hugging Face checkpoint 指引
  • 已知較適合 Linux、NVIDIA GPU 環境,研究團隊或影像生成工程師較易受益
  • 相關模型與基礎包括 Wan2.1-T2V-1.3B、bidirectional editing teacher、streaming student

整體來看,LiveEdit 的價值在於把 streaming video editing 做得更接近可互動系統,而不只是展示級效果。它較適合研究即時影片編輯、互動內容製作、直播視覺處理或需要低延遲生成的團隊;一般用家若想直接在圖形介面一鍵開用,現有資料未提供管理後台整合、免手動設定流程,仍然比較像面向研究與開發者的項目。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 模型, 視覺模型, 視頻模型, NVIDIA, Video, 框架, Linux, 蘋果

MRPO:醫療多模態推理訓練新路線

MRPO 不是再追最終答案分數,而是直接修補推理中途出錯的位置。醫療 VQA 表現因此更穩,也更有可遷移性。

alt text

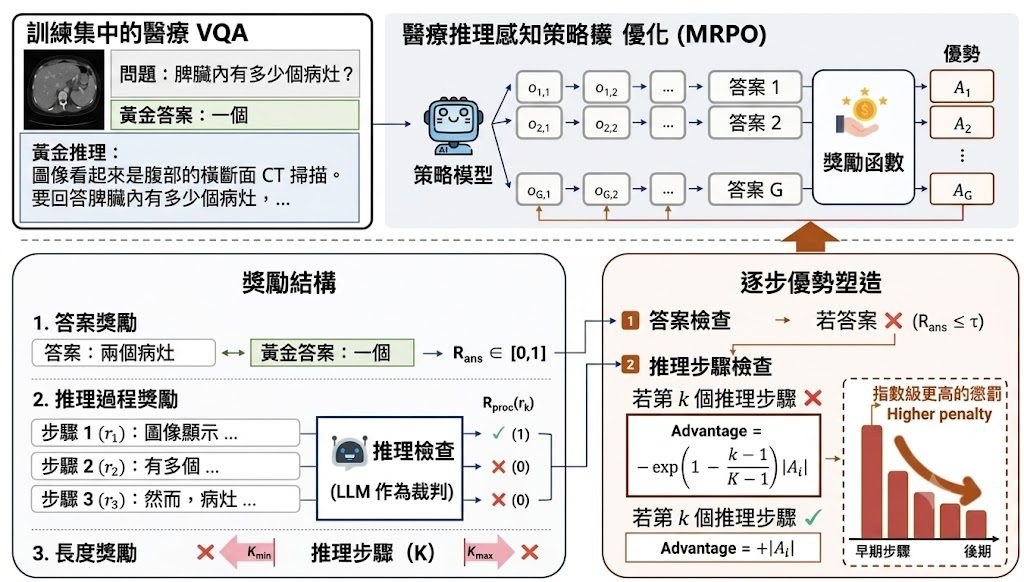
MRPO 是一個用於醫療多模態推理的強化學習框架(reinforcement learning framework)。它要解決的問題不是單純答對與否,而是醫療 VQA 過程中推理鏈一早出錯,之後一路連鎖失誤,令最後答案偏離。

現有 post-training 做法多數偏向 outcome-centric,主要看 final answer correctness 或 sequence-level preferences。作者認為這種範式的問題是 sparse credit assignment,模型知道答錯,卻未必知道究竟由哪一步開始失準;MRPO 因而改寫 GRPO-style advantages,結合 answer-level reward 與 step-wise process rewards,並在最終答案錯誤時,對較早出現的 invalid steps 給予更大懲罰。

這個設計的取向很明確:它不是只罰錯答案,而是重新分配學習訊號,優先修正最早發生的推理錯誤,避免 failure cascades 擴大。README 提到,MRPO 在三個 multimodal LLM backbones 上都優於 standard GRPO 與另一個近期 RL baseline;在 Qwen3-VL-8B-Instruct 上,更以只用 13K training samples 超過較大的醫療 MLLMs,例如 HuatuoGPT-Vision-34B,分數高出 2.79。

  • 核心方法:以 answer-level reward 加 step-wise process rewards 重整 GRPO-style advantages
  • 主要差異:重點放在 first failure,而不是只看最後有冇答中
  • 已公布內容:完整 reinforcement learning recipe、code、datasets 同 infrastructure
  • 可重現方式:項目提供環境腳本、資料下載與前處理流程,訓練資料包含 image、problem、solution 欄位
  • 相關模型:Qwen3-VL-8B-Instruct、HuatuoGPT-Vision-34B,以及 README 提及的另外兩個 multimodal LLM backbones

量化結果最值得留意的是推理質素分析。MRPO 將 early-stage reasoning failures 由 64.0% 降到 13.0%,反映它不只是把答案分數推高,而是令中途推理較少一開始就偏離;這對醫療影像問答尤其重要,因為錯誤往往不是出在最後一句,而是前面觀察與判斷已經失焦。

這個項目較適合研究醫療 AI、醫療影像問答、multimodal reasoning post-training 的團隊參考,也適合想比較 RL 訓練配方差異的人閱讀與重現。它現階段更接近研究原型與訓練方法展示,不是即裝即用的臨床產品;重點價值在於,它把「模型哪一步開始諗錯」正式納入訓練訊號,為醫療 MLLMs 提供一條比只看最終答案更細緻的優化方向。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, OpenAI, DeepSeek, Image, 框架, Medical醫學

RDM:一步生成影像的新取向

RDM 係一個一步式影像生成研究項目,目標係用一次網絡推理,做出接近多步模型質素的圖像。

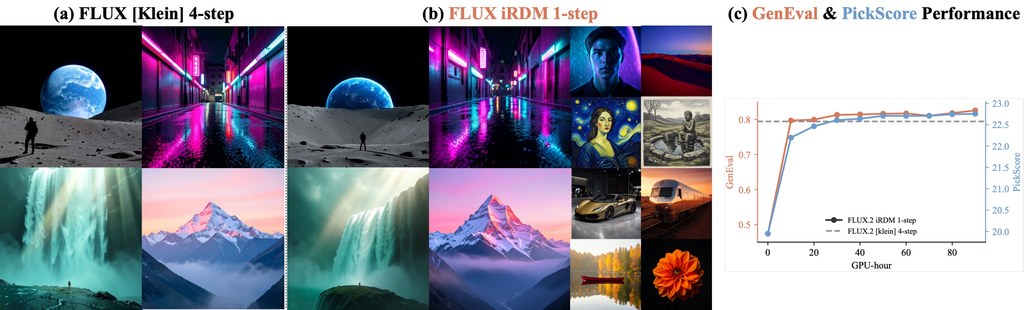
iRDM post-trains four-step FLUX.2 [klein] into a one-step generator at matched quality; GenEval and PickScore climb past

RDM 是一個一步式影像生成研究項目,也是面向 one-step visual generation 的訓練方法。它要解決的問題很直接:把原本需要多次採樣的生成流程,壓縮成一次 network evaluation,仍然盡量保住影像質素。

現有做法通常會依賴 online teacher、adversary,或者追蹤 trajectory 來蒸餾多步生成器;作者認為這類範式訓練成本高、流程複雜,亦容易被單一訊號牽著走。RDM 改用 Representation Distribution Matching,把生成圖與真實圖在多個 frozen pretrained encoders 之下的特徵分佈對齊,核心比較方式是 squared MMD with a Gaussian kernel,同時配合 Nyström attraction、within-batch repulsion,以及 joint image-text law。

這個取向和同類方法的差異,在於它不靠 online teacher、no adversary、no trajectory,訓練邏輯更像直接校準「生成分佈是否接近真實分佈」。作者亦刻意不用單一 encoder,而是用一組 frozen encoders(10 train + 4 held out),再用 proportional Lagrangian controller 平衡各個表示空間,這個設計明顯是想減少模型只迎合某一種評分器的問題。

README 已交代基本理解方式:安裝後可用 ImageNet-256 影像樹做訓練與驗證,也可沿 FLUX text-to-image 路線配合 COCO、GenEval、Pick-a-Pic 做評測;另有 Hugging Face demo 與 checkpoints,可直接看輸出效果。部署上它較像研究型訓練框架,不是即開即用的終端應用,較適合有 GPU 資源、想重現論文結果或做後訓練實驗的團隊。

性能數字有辨識度。RDM 報稱達到 one-step ImageNet state of the art,SW_r14 為 1.30;在 FLUX.2 [klein] 的 post-training 路線中,one-step 模型於 GenEval 達到 0.826,高於 four-step teacher 的 0.794,PickScore 亦升到 22.76,高過 teacher 的 22.58。相關模型與組件包括 FLUX.2 [klein]、open_clip、DreamSim,以及多個 frozen pretrained encoders;整體更適合關注模型訓練、生成效率與影像評測方法的研究或產品項目。

  • 項目類型:研究型訓練方法/框架,重點在一步式影像生成
  • 核心差異:不用 online teacher、adversary、trajectory,改做分佈匹配
  • 測試方式:可用 ImageNet-256、COCO、GenEval、Pick-a-Pic 驗證結果
  • 主要取捨:流程更乾淨,但仍需要資料準備、GPU 資源與完整評測環境
  • 受益情境:想把多步生成器壓成單步模型的研究團隊與影像生成項目

項目主頁 · GitHub · 模型

Categories: 開源, 模型訓練, Stable Diffusion, Image, 影像模型, txt2img, 框架, Dataset 數據集

Page 42 of 55
1 … 40 41 42 43 44 … 55