SpatialClaw:用程式碼推動空間推理代理

SpatialClaw把程式碼變成代理的動作介面,主攻複雜空間推理。它在20個基準上交出明顯領先的平均成績。

SpatialClaw logo

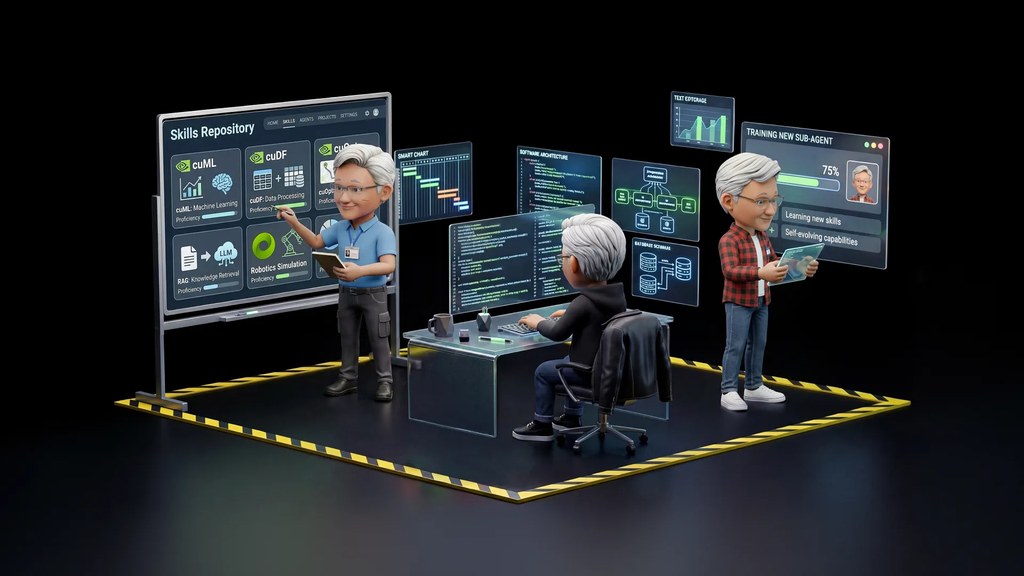
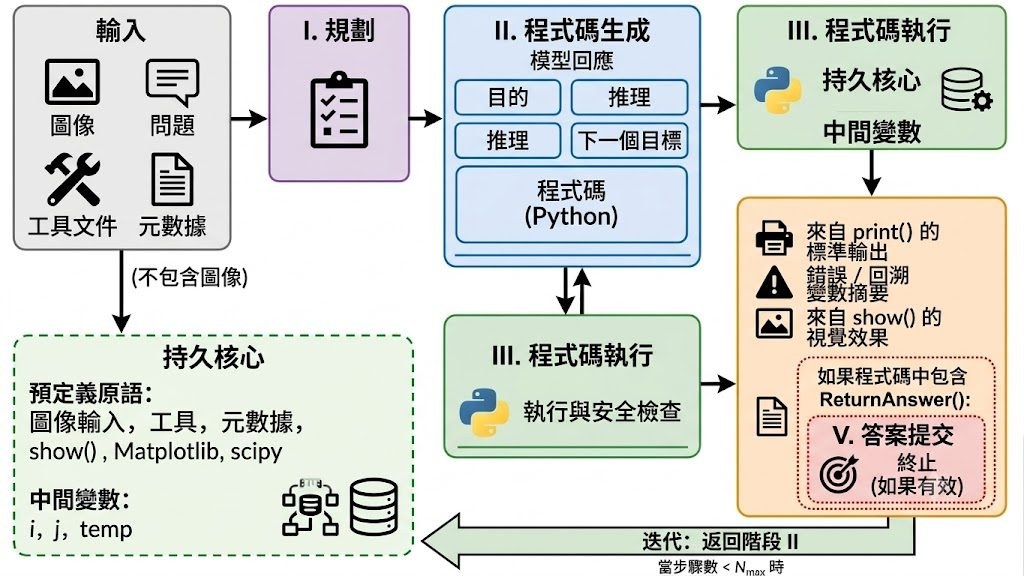
SpatialClaw 是一個免訓練的空間推理框架,重點不是再加更多工具,而是改寫代理如何調用工具。它把程式碼當成動作介面,讓 Vision-Language Model 代理逐步寫入 Python cell,在同一個持續運行的 Jupyter kernel 內查看中間結果、再調整下一步判斷,目標是處理 3D、4D 以及影片場景中的空間理解問題。

這個項目的新意,在於它避開單次執行整段程式或僵硬的 tool-call 方式。代理每次只提交一格程式,能結合 SAM3 segmentation、Depth-Anything-3 reconstruction、geometry utilities,以及 NumPy、SciPy、Matplotlib 這類科學運算庫,分析過程更像逐步查證,而不是一次過猜答案。

如果你想測試它,較合適的做法是用多視角圖片、影片片段,或需要判斷位置、距離、遮擋、移動關係的題目來跑。文件亦提到部署模型有明確硬件要求:FP8 版本需要 Linux 與 NVIDIA Hopper(H100)或更新 GPU;若手上是 A100 或 L40S,則可改用 models.json 內列出的 AWQ 或 GPTQ Int4 條目,並沿用相同 served_name,模型設定毋須重改。這也反映 NVIDIA 近年在 Robotic 與 World Model 相關項目上的投入相當積極。

成績方面,公開資料指出它在 20 個空間推理基準取得 59.9% 平均準確率,比先前最佳空間代理高 11.2 個百分點。更重要的是,這個結果據稱在相同 system prompt、工具組合與 hyperparameters 下完成,覆蓋六個 VLM 骨幹,代表它的提升未必只靠特定 benchmark 微調。

  • 屬於空間推理代理框架,解決 VLM 在 3D/4D 關係判斷上不夠靈活的問題
  • 核心方法是以程式碼作為動作介面,逐步執行與修正分析
  • 支援的感知模組包括 SAM3 segmentation、Depth-Anything-3 reconstruction 與 geometry utilities
  • 公開結果涵蓋 20 個 benchmarks,平均準確率為 59.9%
  • 相關模型家族包括 Qwen3.5、Qwen3.6、Gemma4,規模由 26B 至 397B

這個項目特別適合研究 Computer-use agents、空間智能、機械人感知,或者想比較 tool-augmented agent 與 VLM 推理流程的人。若你關心的不是聊天表現,而是模型能否一步步觀察畫面、調工具、修正推論,SpatialClaw 展示了一條幾有說服力的路線。
GitHub: https://github.com/NVlabs/SpatialClaw

項目: https://spatialclaw.github.io/

Categories: 開源, Agentic, 模型, 視覺模型, NVIDIA

Stream3D-VLM 把串流影片變成 3D

處理的不只是影片,而是邊看邊理解空間。Stream3D-VLM把串流畫面、幾何資訊與語言回應連起來。

Stream3D-VLM Logo

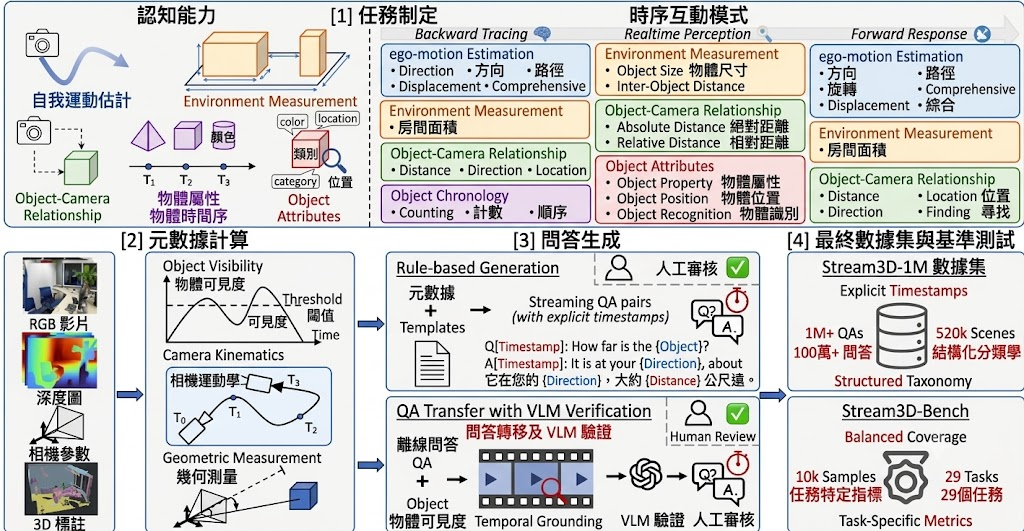
Stream3D-VLM 是一個 online 3D vision-language model,重點是直接從串流影片做即時空間理解,而不是等整段影片或整個場景收集完才分析。對想研究機械人、空間問答,或 3D 場景互動的人來說,這個項目處理的是「模型可否一邊看、一邊建立場景概念,再即時回答問題」這件事。

使用這個項目時,核心資源包括已公開的 Stream3D-VLM-4B 模型、Stream3D-1M Dataset,以及 Stream3D-Bench。資料方面未有直接釋出原始媒體,但有提供標註、GLB 與 RRD 等重建結果;GLB 可放入一般 3D viewer 逐步查看點雲,RRD 則可配合相機姿態與點雲記錄觀察完整重建流程。

Stream3D-VLM 加入 incremental geometry priors,令模型隨時間吸收對齊的 3D 幾何線索。項目亦提出 Visual-Spatial Feature Integration(VSFI)模組,以及 Geometry-Adaptive Voxel Compression(GAVC)模組,前者負責把幾何資訊逐步注入視覺串流,後者用 3D 結構去壓縮 visual tokens,減少長序列推理負擔。

團隊亦建立了可擴展的資料生成流程,整理超過 1M online spatio-temporal 3D QA pairs,並設計涵蓋 29 項任務的基準。項目聲稱在 online 與 offline 的 3D spatial understanding、reasoning、grounding 任務上,表現優於部分 proprietary 與 open-source models;不過文章未在這份資訊中列出完整數字,閱讀結果時仍要配合論文與實驗頁面一起看。

  • 解決痛點:傳統 3D Large Multimodal Models 多數依賴離線處理,這個項目改為面向 streaming video。
  • 主要方法:結合 autoregressive streaming control、VSFI 與 GAVC。
  • 資料與基準:提供 Stream3D-1M Dataset 標註及 Stream3D-Bench,涵蓋 29 項任務。
  • 可視化資源:支援 GLB 與 RRD,方便檢查增量重建與相機軌跡。
  • 相關模型:已公開 Stream3D-VLM-4B,可作為了解整體能力的主要入口。

整體來看,Stream3D-VLM 最適合用來觀察 3D 多模態模型如何由「看完整段再答」走向「邊看邊答」。它未必是一般開發者即裝即用的輕量工具,但對研究串流場景理解、3D 問答、空間推理流程的人,這個項目有相當清晰的方向與實驗野心。

GitHub: https://github.com/hanxunyu/Stream3D-VLM

項目: https://stream3d-vlm.github.io/

Categories: 香港科技大學, 騰訊, 模型, 視覺模型, 多模態模型, NVIDIA, Robotic

PhaseLock:用兩步鎖住影片物理感

這項目用免訓練方法,改善影片生成中的不合理動作,同時盡量保留高畫質。

yonsei emblem

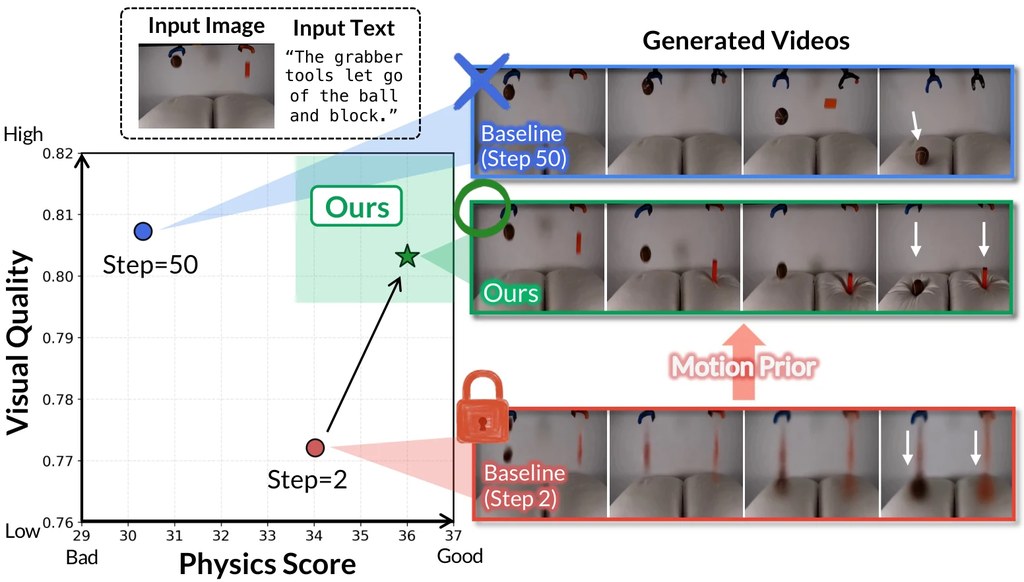
PhaseLock 是一個針對 Image-to-Video diffusion models 的方法,重點是修正影片生成中常見的物理錯誤。主要是針對 inference-time method / sampling strategy。模型在完整 50 步去噪時雖然畫面更細緻,但動作反而可能偏離物理規律;相對地,只做 2 步去噪時,動作先驗更可信,只是質感較粗糙。

項目的核心做法是兩階段流程,而且不需要額外訓練。它會先用 2 步去噪抽出 motion prior,文中以 Δ phys 表示,再在 50 步完整生成期間以 Latent Delta Guidance 重新注入,目標是在高保真畫面中保留較合理的動態結果。

例子很直觀,例如非磁性的網球不應被帶磁的籃子吸起。基線結果會產生違反常識的動作,PhaseLock 則較能維持物件應有的移動方式。這類情況很適合用於需要基本物理合理性的影片生成項目,例如物件互動、掉落、抓取或接觸場景。

重點可歸納為:
– 以 training-free 方式改善影片中的物理一致性
– 發現 2-step generation 的 physics 可能比 50-step output 更好
– 透過 Latent Delta Guidance 把早期 motion prior 鎖回最終結果
– 報告指出 physical consistency 平均提升 +6.2 points
– 額外成本相對有限,約 1.06× time、1.02× memory

如果你本身已在用影片擴散模型,這個項目的使用概念不算複雜:先跑短步數結果取出動作訊號,再配合完整步數生成。從現有內容看,PhaseLock 的價值不在於更換主模型,而是在同一模型之上補回被後期去噪「磨走」的動作先驗。文中提到測試用的模型包括 Wan 2.1。

GitHub: https://github.com/dnwjddl/phaselock

項目: https://dnwjddl.github.io/phaselock/

Categories: 開源, NVIDIA, Robotic, 框架

OmniDreams:NVidia 點樣重塑自駕模擬

OmniDreams把單張畫面、文字提示與地圖軌跡結合,實時生成多鏡頭擬真影片。這類 world model,正改變自動駕駛模擬的可擴展性。

Repository image for nv-tlabs/omni-dreams

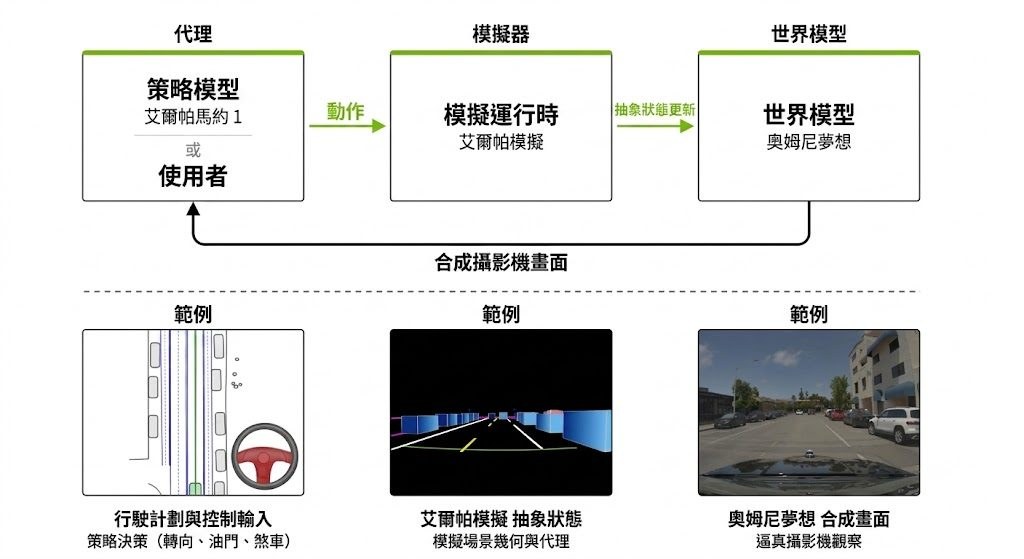
NVIDIA OmniDreams 是一個用於自動駕駛模擬的 world model,重點不在重播已錄好的路面片段,而是在系統提供條件後,持續生成多鏡頭、近乎寫實的影片畫面。它吃進一張真實 RGB 起始影像、文字提示,以及每幀的 coarse HD map image 和 trajectory poses,再以分段方式推進後續畫面。

這個項目想處理的核心問題,是傳統神經模擬器雖然可以很像真,但通常受限於原本拍到的資料,遇到少見天氣、突發交通行為或未見過的場景時,彈性不足。OmniDreams 走的是自回歸生成路線,會根據過往畫面、模擬器狀態與即時駕駛動作,繼續生成下一段感測畫面,較接近 closed-loop simulation 的需要。

從公開資料看,它的創新點在於把 Cosmos diffusion model 的視覺先驗,延伸成可即時反應動作的生成式 world model,並且支援 multi-camera photorealistic video。論文亦提到它曾在 21k 小時駕駛場景上做 mid-training 與 post-training,目標是覆蓋更多傳統模擬器難以刻畫的情境。

使用這個項目時,較適合把它視為研究與後訓練樣本發佈點;互動式推論與 live driving demo 則放在配套項目 FlashDreams。倉庫亦提供 post-training 樣本,圍繞 Cosmos2 SV-HDMap world model 微調,並提到 student-init、bidirectional teacher 與 self-forcing distillation 等訓練路線,但硬件門檻不低,官方列明最低為單個 8-GPU Ampere/Hopper 節點。

  • 可從單張真實畫面開始,生成連續多鏡頭影片
  • 輸入條件清晰,包括文字提示、HD map 與 trajectory poses
  • 重點場景是 closed-loop autonomous vehicle simulation
  • 相關模型與系統包括 Cosmos diffusion model、Cosmos2 SV-HDMap、FlashDreams、Alpamayo 1、AlpaSim、WAM
  • 論文初步結果指出,從 OmniDreams 後訓練出的 WAM 在 Physical AI Autonomous Vehicles NuRec 上表現不俗,且總參數量少於 VLA-based Alpamayo 1.5 的五分之一

整體來看,OmniDreams 不是一般開箱即用的消費級工具,而是面向自動駕駛研究、模擬平台與生成式 world model 開發流程的關鍵項目。對研究團隊、模擬系統工程師,或者想追蹤 NVIDIA 在 Physical AI 與 AV simulation 方向的人來說,這個項目很有參考價值。

GitHub: https://github.com/nv-tlabs/omni-dreams

項目: https://research.nvidia.com/labs/sil/projects/omnidreams-blog/

Categories: 開源, 世界模型, NVIDIA

MERIT:把音樂相似度拆成三條獨立線索

MERIT 將旋律、節奏、音色拆成三個獨立相似度分數,讓音樂檢索不再只看單一總分,支援更細緻的查詢方式。

MERIT architecture

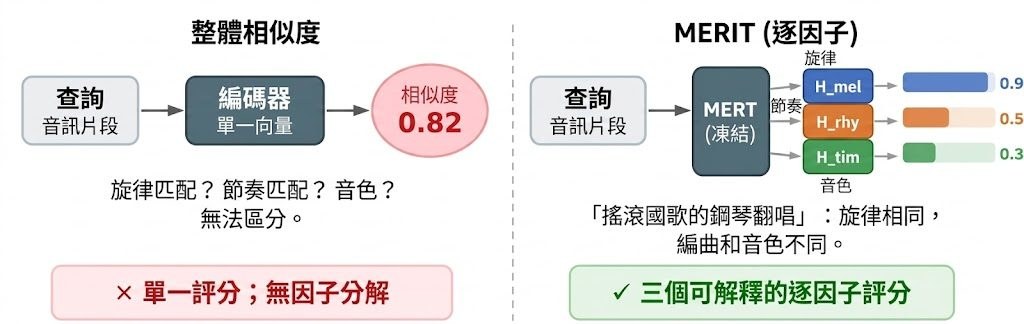
現有的音樂相似度模型大多只輸出一個籠統的總分,把旋律、節奏、音色混在一起計算,使用者很難說明「為何這兩首歌像」。MERIT(Multi-Factor Disentangled Music Similarity)由新加坡科技與設計大學的 AMAAI 實驗室推出,以凍結的 MERT backbone 為基礎,再訓練三個各約 11 MB 的輕量投影頭(projection heads),分別負責旋律(S_mel)、節奏(S_rhy)、音色(S_tim)。一段鋼琴翻唱搖滾歌曲的音檔,會在旋律分數偏高、節奏和音色分數偏低,差異即時可見。

這個項目解決的核心問題是音樂檢索的可解釋性。傳統 CLAP、MuLan 或 MERT 這類自監督音訊模型把多種特徵壓縮到同一向量,餘弦相似度難以拆解;MERIT 改用條件式音訊生成與音源分離技術,自動產生 296K 組「單一變因」三元組訓練資料,免去人工標註。三個頭在 held-out 測試中都達到 ≥99.6% 的三元組準確率,並在零樣本真實音訊探測中各自主導對應的感知維度。

重點摘要:

  • 把相似度拆成旋律、節奏、音色三條獨立訊號
  • 採用凍結 MERT-v1-330M 主幹,僅訓練小型投影頭
  • 透過生成式管線產生 296K 因子控制三元組,無需人工標註
  • 每個頭約 11 MB,總計約 33 MB,方便部署
  • 預訓練權重與資料集已發布於 HuggingFace

合適的場景包括音樂串流平台的進階推薦、音樂學研究中的跨版本比較,以及需要解釋「為何推薦這首」的場景。對一般使用者而言,把 S_mel 較高的曲目組成「同一旋律」歌單,就能體驗到差異。

運作流程相當直接:下載三個 .pt 投影頭,以 Wav2Vec2FeatureExtractor 讀入音檔,從 MERT 指定的第 3、4、5、6、23 層抽取特徵,分別送入三個頭即可得到三組 embedding,再以餘弦相似度比較。模型與資料集皆已開源,有興趣的開發者可從 HuggingFace 取得 amaai-lab/merit 與對應資料集。

GitHub: https://github.com/AMAAI-Lab/MERIT

Paper: https://arxiv.org/pdf/2605.27346

Categories: NVIDIA, OpenClaw, Dataset 數據集

Agent Skill 的安全盲點:當三套掃描器互相矛盾時

研究團隊發佈逾六萬筆 AI 代理技能的安全掃描數據,發現不同掃描器極少達成共識,揭示單一掃描器難以判斷技能是否安全。

隨着 AI 代理(AI agents)愈來愈普及,一種稱為「代理技能」(agent skills)的新興軟件層亦隨之興起。技能可以包含指令、工具調用模式、可執行腳本等內容,屬於代理與外部工具之間的執行層,與傳統軟件包有明顯差異。技能即使不含惡意程式碼,仍可能因為授予過大權限、隱藏遠端控制路徑或不安全地儲存憑證而構成風險。

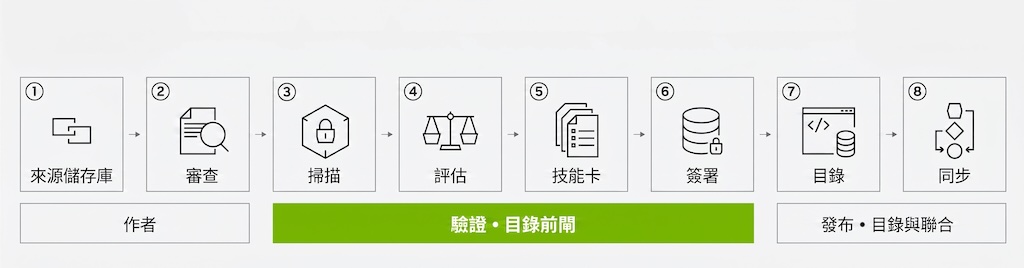
OpenClaw 基金會聯同 NVIDIA 發佈了名為 ClawHub Security Signals 的數據集,收錄了 67,453 個最新版本的公開 OpenClaw 技能。每筆紀錄包含已遮罩的 SKILL.md 內容、清理後的附帶檔案,以及三套掃描器的結果:VirusTotal、靜態啟發式分析,以及 NVIDIA 自行開發的 SkillSpector。研究團隊並非要估算惡意技能的普及率,而是聚焦於「掃描器之間的分歧」這個現象。

研究結果令人意外:三套掃描器極少對同一批技能發出警示。任何兩個掃描器的重疊率最高只有 10.4%,三者同時標記的技能僅佔 0.69%,而被單一掃描器標記的技能卻高達 81.9%。這種分歧並非隨機,而是呈現出明確的結構。SkillSpector 專門針對語意層面的代理風險,在 25,504 個可疑項目中有 75.3% 觸發警示,但在確認惡意的 206 個項目中只標記了 6.8%。相反地,在確認惡意的項目中,VirusTotal 標記了 72.8%,與附帶程式碼的惡意軟件證據吻合。

這項研究強調,AI 代理技能的安全審查需要多層次治理(layered governance),不能依賴單一掃描器作出封鎖或放行的決定。

以下是這項工作的重點摘要:

  • 規模龐大的安全數據集:收錄逾六萬個 OpenClaw 技能的最新版本,涵蓋三套不同掃描器的結果。
  • 聚焦於掃描器分歧:研究發現不同掃描器對同一批技能的判斷差異極大,重疊率偏低。
  • 不同掃描器各有所長:SkillSpector 擅長識別語意層面的代理風險,VirusTotal 則對附帶惡意程式碼的技能更敏感。
  • 支持分層治理理念:研究主張技能安全需要多層次、多工具的綜合判斷,而非單一指標。
  • 公開版本供社群使用:數據集以「銀標準」形式發佈,標籤來自自動判定而非人工標註,研究團隊歡迎社群在此基礎上開發更專門的技能安全分類模型。

這個項目最適合關注 AI 代理安全、軟件供應鏈防護及自動化安全掃描的研究人員與工程師。數據集已在 Hugging Face 上公開,研究團隊鼓勵社群進一步開發針對技能安全分類的模型。

Paper: https://arxiv.org/pdf/2606.01494

Categories: NVIDIA, OpenClaw, Dataset 數據集

contrastive-probing:拆解 VLM 空間判斷偏差的輕量診斷項目

這個項目不是再做一次答題測試,而是直接觀察 VLM 內部怎樣表示左右、高低與遠近。對想研究模型偏差的人很有參考價值。

Repository image for cheolhong0916/contrastive-probing

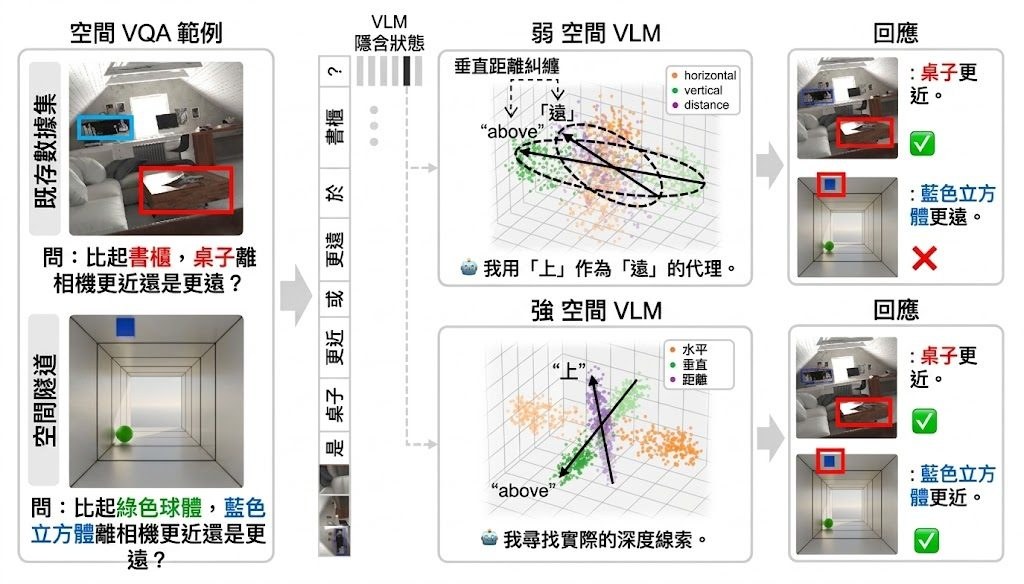
contrastive-probing 是一個用來檢查 Vision-Language Models(VLMs)內部空間表示的輕量項目,焦點不是模型答對幾多題,而是它腦內如何分開 left / right、above / below、far / close。它沿用論文《Why Far Looks Up: Probing Spatial Representation in Vision-Language Models》的 contrastive probing 方法,透過交換問題中的兩個物件,再比較 hidden states 差異,抽出 Δ vectors 作分析。

使用時,做法是把一張圖片配上一條原始空間問題,再生成一條交換 obj1 ↔ obj2 的對照問題,之後對同一個 VLM 跑兩次 forward,並在每層 transformer 擷取最後 token 的表示。這個流程可配合 🤗 transformers 載入的模型,然後輸出 Axis Coherence、6×6 Δ-similarity heatmap、2D/3D PCA 視覺化,以及 Vertical–Distance Entanglement Index(VD-EI)等結果。

這個項目解決的核心問題,是 benchmark accuracy 往往只告訴你模型有冇答中,卻未必揭示它是否用對了空間線索。論文與附帶說明指出,多個模型家族都出現 vertical-distance entanglement,也就是把畫面較高的位置誤當成較遠,反映自然照片常見的 perspective heuristic「higher in the image ⇒ farther away」。

  • 用最少對照設計觀察表示層,而不只看答題分數
  • 可比較不同 layer 的空間軸是否清晰分離
  • 能發現 vertical 與 distance 是否糾纏,幫助找出偏差來源
  • 適合分析 EmbSpatial-Bench、SpatialTunnel 這類空間推理資料

對研究者、模型分析人員,或者要檢查 multimodal assistant、robotics、embodied agents 背後空間推理可靠性的人,這個項目尤其有用。現有資料顯示,就算 benchmark 分數相近,不同 VLM 的內部表示也可能差很遠,而空間軸分得較清楚的模型,通常在不同測試上的穩健性會較好。

整體來看,這不是訓練新模型的項目,而是一套偏向診斷與解釋的工具。它的創新點在於用 minimal contrastive pairs 加上 representation-level analysis,把「模型為何會答對或答錯」拆成更具體的內部結構問題,對想深入理解 VLM 空間能力的人,價值比單看排行榜更高。

GitHub: https://github.com/cheolhong0916/contrastive-probing

項目: https://cheolhong0916.github.io/whyfarlooksup.github.io/

Categories: 開源, 視覺模型, 世界模型, 模型訓練, NVIDIA, 框架, 3D

AIQ 為代理工具加上深度研究能力

NVIDIA AI-Q把深度研究流程封裝成可重用技能,讓代理工具更易處理多來源分析。

Og image

不少代理工具本身已很擅長協調流程,例如管理對話、串接工具和執行程式碼;但一到需要整合多份文件、引用來源、或根據企業資料整理長篇分析,開發團隊往往要自行處理大量繁瑣工作。這篇內容介紹的 NVIDIA AI-Q,重點正是把這類深度研究能力封裝成可攜的項目技能,讓代理工具直接調用。

它解決的問題很明確:團隊不用再為每個項目重建檢索、規劃、整理、引用與評估流程。代理工具可把研究任務交給本機或託管的 AI-Q 伺服器,之後收回一份有結構、附引用的報告;而敏感資料亦可留在企業內部環境,對醫療、金融、政府及國防等重視資料管控的場景尤其重要。

上手方式亦相對直接。這個項目提供 SKILL.md 說明檔,以及一個輔助腳本去處理請求路由、提交工作、輪詢進度和取回結果。使用前需要 Python 3.10 或以上,並準備一個可連線的 AI-Q Blueprint 伺服器;預設會連到本機位址,也可透過環境變數改寫。

Give Codex a Deep Research Skill With NVIDIA AI-Q

重點可概括如下:
– 把深度研究流程包裝成代理工具可調用的技能
– 支援多來源資料整合,並輸出附引用的報告
– 減少每個項目重複搭建研究流程的工作
– 讓敏感資料可保留在企業內部環境
– 可配合 Claude Code、Codex 等通用代理工具使用

這個項目的創新之處,在於它不是只提供單一工具函式,而是把意圖分類、澄清問題、淺層研究、深度研究與評估整合成較高層的能力。換句話說,代理工具只需學會如何委派,便可利用完整研究管線,較適合想快速為現有代理系統加入研究能力的團隊。文中未見具體效能數字或基準測試,因此現階段較適合把它理解為一個工程整合與工作流程簡化方案。

模型列表:Claude Code、Codex

GitHub: https://github.com/NVIDIA-AI-Blueprints/aiq/tree/v2.1.0

項目: https://developer.nvidia.com/blog/add-a-specialized-deep-research-skill-to-agent-harnesses/

Categories: 開源, Agentic, NVIDIA, 框架

Aurora:把影片編輯指令講清楚的 AI 代理

Aurora 想處理影片編輯最麻煩的一步:把含糊要求轉成可執行流程。它把代理式理解與影片生成結合,方向幾幾清晰。

Repository image for yeates/Aurora

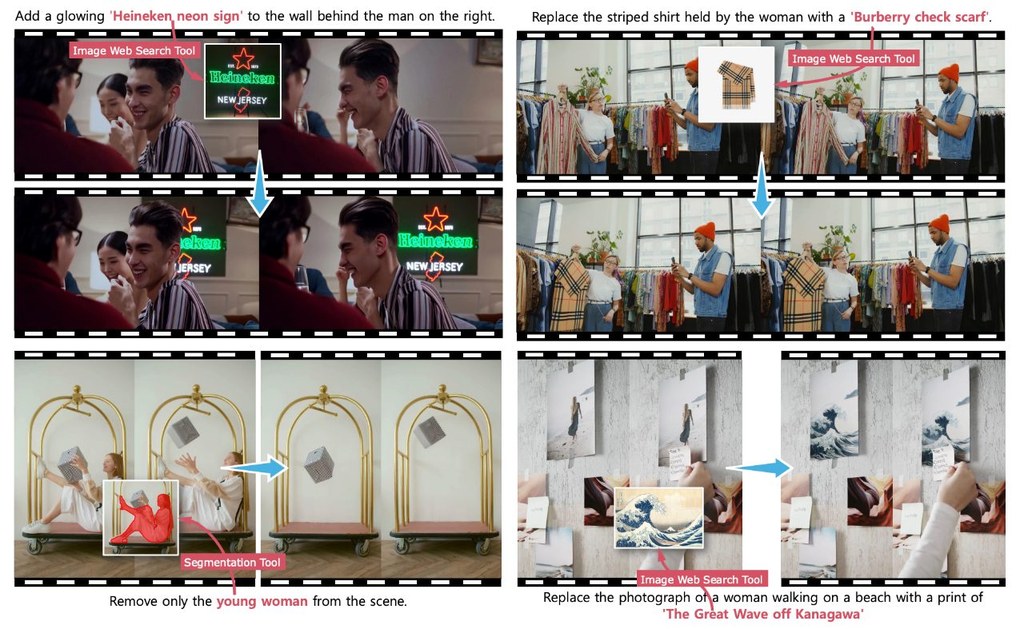
Aurora 是一個面向影片編輯的 AI 項目,重點不只是「生成畫面」,而是先理解你想改甚麼。它把使用者一句較口語、甚至有點含糊的要求,整理成較明確的編輯計劃,再交給影片模型處理,目標是減少「講唔清、改唔準」的情況。

這個項目想解決的核心問題,是影片編輯要求經常不完整。你可能只說想「換走背景」、「刪除路人」或「改成某種風格」,但未必提供參考圖,亦未必指出遮罩範圍;Aurora 會嘗試補回這些缺口,例如用圖像搜尋找參考,或用分割方式找出需要修改的位置。

它較有新意的地方,在於把多種影片編輯工作放進同一個框架,而不是每種效果各自一套模型。根據目前資料,這個項目支援替換、移除、風格轉換,以及根據參考內容插入元素,背後並結合了工具增強的視覺語言模型代理,以及統一的影片 diffusion transformer,也就是影片 DiT。

動手了解這個項目時,可先把它當成「會先幫你整理需求的影片編輯助手」。現階段儲存庫內容顯示官方實作仍在準備中,所以較適合先閱讀論文與項目頁,理解它如何把原始要求拆成指令、任務標籤、圖像搜尋查詢與遮罩描述四部分,再留意之後公開的程式。

  • 同一個項目框架處理多類影片編輯工作
  • 會先重寫使用者要求,再交由影片模型生成
  • 可補足缺少的參考圖與編輯區域資訊
  • 相關模型重點包括工具增強 VLM 代理與影片 DiT
  • 另有 AgentEdit-Bench,用來評估這類代理式影片編輯能力

對內容創作者、影像研究人員,或者關心人機協作編輯流程的人來說,Aurora 特別值得留意。它未必是即刻可用的成品,但從設計方向看,這個項目著重的不是單次炫技效果,而是令影片編輯指令變得更完整、更可執行。

GitHub: https://github.com/yeates/Aurora

Paper: https://arxiv.org/pdf/2605.18748

Categories: 開源, Agentic, NVIDIA, 框架, 中國

LongLive:長片段影片生成再快一步

LongLive 專注解決長影片生成的速度與記憶體壓力,重點放在更長、更連貫的輸出流程。它同時照顧訓練與推理效率,方向相當清晰。

LongLive2.0 logo

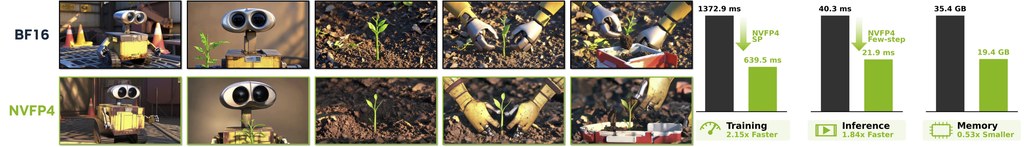
LongLive 係 NVIDIA NVLabs 針對長影片生成提出的基礎設施,核心目標唔係單純「整到片」,而係令模型喺處理長時間、多鏡頭內容時,冇咁易被記憶體同速度拖慢。由 1.0 強調即時互動式生成,到 2.0 加入 NVFP4 平行化設計,重點已經擴展到訓練、蒸餾同推理全流程。

實際使用時,較自然嘅路線係先睇示範頁同文件,了解佢點樣接收連續提示詞,再按需要選擇 BF16 或 NVFP4 模型版本。現有公開模型包括 LongLive-2.0-5B、LongLive-2.0-5B-NVFP4-S4,而較早期分支亦有 LongLive-1.3B,方便分別比較畫質、速度同硬件需求。

呢個專案最值得留意嘅地方,在於佢唔只優化生成結果,仲直接處理長影片常見樽頸,例如 KV cache 佔用、跨卡通訊、以及多鏡頭自回歸生成時嘅效率問題。資料顯示,2.0 版本支援多鏡頭或單鏡頭訓練、序列平行推理、非同步解碼,同時可用較低精度格式減少記憶體開銷;論文亦提到訓練與推理速度都有明顯提升,但實際表現仍要視乎 GPU 架構而定。

  • 支援長影片、多鏡頭連續生成,方向比一般短片生成更明確
  • 提供 BF16 同 NVFP4 版本,方便按硬件取捨
  • 針對訓練與推理一齊優化,唔係只顧其中一端
  • 包含序列平行、KV cache 量化、非同步解碼等工程設計
  • 適合研究人員、影片生成開發者,同埋需要評估部署效率嘅團隊

整體來講,LongLive 比較似一個面向進階影片生成工作流嘅「引擎室升級」,特別適合關注長片段敘事、互動式生成,或者想研究多鏡頭影片模型點樣落地嘅人。對一般讀者而言,最容易理解嘅價值就係:佢嘗試用更慳資源、更快嘅方式,令 AI 生成長影片唔再只停留喺概念展示。

GitHub: https://github.com/NVlabs/LongLive

Paper: https://arxiv.org/pdf/2605.18739

Categories: 開源, NVIDIA, 影像模型

Page 16 of 17
1 … 14 15 16 17