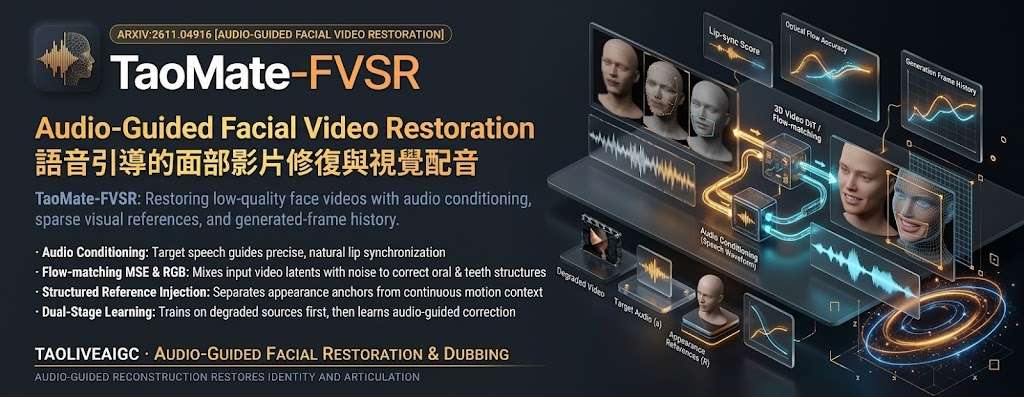
TaoMate-FVSR:用音訊與稀疏參考修復人臉影片

小臉在影片中容易失去細節,換上新配音時口形也可能對不上。TaoMate-FVSR 把音訊、參考畫面與生成歷史一併用於人臉修復,亦支援視覺配音。

favicon

影片中的人臉太小或細節模糊,單純放大未必能還原自然的面貌;換上新語音後,嘴形亦要配合音訊。TaoMate-FVSR 是一套人臉影片修復推理工具,利用音訊、稀疏的視覺參考和生成畫面歷史重建臉部,支援保留原聲修復,以及配合替換語音進行視覺配音。

它把臉部細節與口部動作放在同一個重建流程處理,並以來源影片保留場景結構,再由高質素參考提供外觀線索、目標音訊引導嘴部動態。相比先做超解像、再交給另一個配音模型的分段流程,這種聯合處理方式有機會減少修復結果與口形之間的不一致。
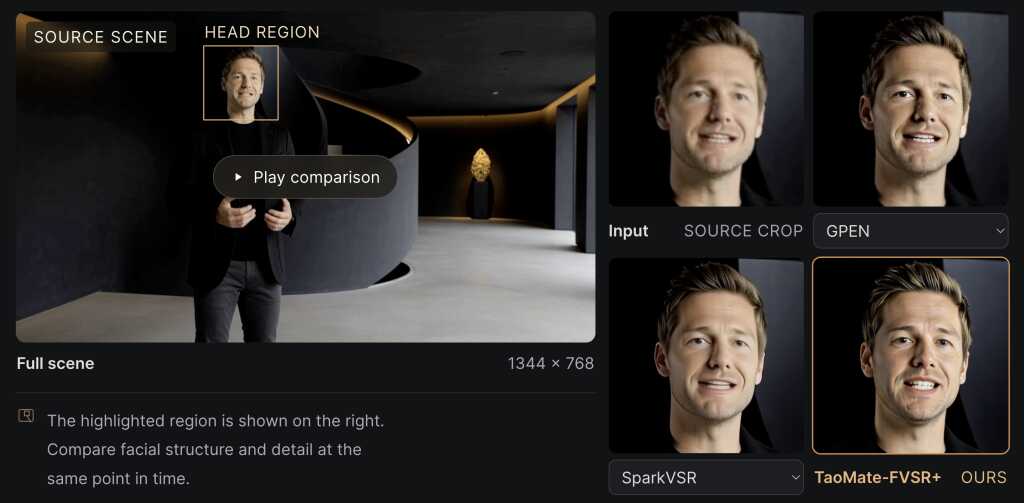
畫面可用 GPEN 處理首幀作參考,也可以提供自行編輯的首幀或完成的參考圖。推理流程會先以 DWPose 裁切人臉,再做修復、色彩與遮罩融合,最後貼回原影片;模型可按 1× 或 2× 尺寸運算,合成前會縮回 512×512,因此輸出場景維持原有尺寸。全場景比較也有助檢查修復臉部與原本畫面是否協調,但身體和背景不會一併提升解像度。

  • 支援原始音訊修復及替換語音配音。
  • 可用 GPEN、外部編輯首幀或完成的參考圖提供外觀線索。
  • 1× 與 2× 推理分別使用 512×512 與 1024×1024 處理尺寸。
  • 執行需要支援 BF16 的 NVIDIA CUDA GPU,以及 CUDA 版本相容的 PyTorch 2.6 或更新版本和 torchvision 0.21 或更新版本。

這套工具較適合需要修復 AI 生成影片人臉、製作配音版本,或比較局部臉部細節與完整場景效果的創作者及研究團隊。參考畫面質素和場景合成效果都會影響最後成果,正式製作前宜用自己的素材測試。
項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, NVIDIA, Video, Audio, 工具, Content Creator, 線上服務, 語音

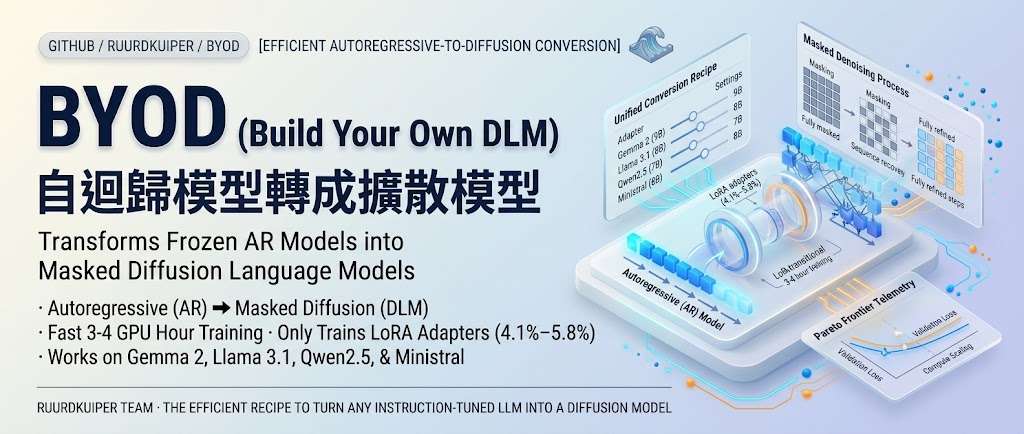
BYOD:用單張 GPU 將指令模型改造成雙向擴散模型

BYOD 讓你從 Colab Notebook 選擇指令模型並進行訓練,再透過互動介面觀察逐步去噪生成;但快速模式不會重現論文分數。

Repository image for RuurdKuiper/BYOD

BYOD 把指令模型轉成雙向遮罩擴散語言模型,讓模型生成文字時能逐步去噪,並在互動頁面即時查看生成變化。它是模型訓練工具,主要處理如何用單張 GPU 訓練這類模型;Colab Notebook 可選模型、啟動訓練及查看 loss 曲線,第 6 步會開啟可調整生成設定的推理介面。

使用方式分為 Colab 和本機兩條路徑:Notebook 會沿用 Colab 的 PyTorch、CUDA 套件,只在啟動推理介面時安裝 Gradio;本機訓練則需 NVIDIA GPU、Hugging Face 讀取權杖,並先接受受限模型的使用條款。本機推理網頁需安裝 .[demo] 套件。訓練資料會自動下載,手動中止時會保存 interrupted/,可載入該次結果繼續推理。

BYOD 以 LoRA 微調既有模型,而非從頭訓練;quick 模式採用較小模型和 rank-128 LoRA,適合先檢查流程,但不會重現論文分數。paper 模式使用 rank-1024 LoRA,原始訓練使用 96 GB 記憶體,對硬件要求高。兩種模式預設均訓練 25,000 次更新,訓練與驗證 loss 若出現 NaN 或無限值,程序會報錯並保留先前最佳 adapter。

  • Notebook 提供模型選擇、訓練和 loss 曲線檢視。
  • 推理介面可調整生成設定,並即時查看去噪過程;也支援載入中斷訓練的結果。
  • 可選 Llama、Gemma、Qwen 和 Ministral;各模型提供不同 quick 或 paper 配置,Ministral 只有 paper 配置。
  • 評估在每個 checkpoint 執行,輸出只保留 best/;本機訓練要求 NVIDIA GPU,quick 模式不等同論文設定。

研究者和模型工程團隊可用它比較不同指令模型經擴散式訓練後的生成過程,也可先透過託管示範體驗已訓練模型。若目標是復現論文結果,應採 paper 配置並準備高記憶體 GPU;低資源測試則可用 quick 模式確認訓練流程。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, NVIDIA, Gemini, 工具, LLaMa, Python, LoRA

GLOW-FM:單步提升低光影像質素

GLOW-FM 把低光影像增強壓縮至一次網絡運算,兼顧生成質感與推理效率,適合資源有限的影像處理場景。

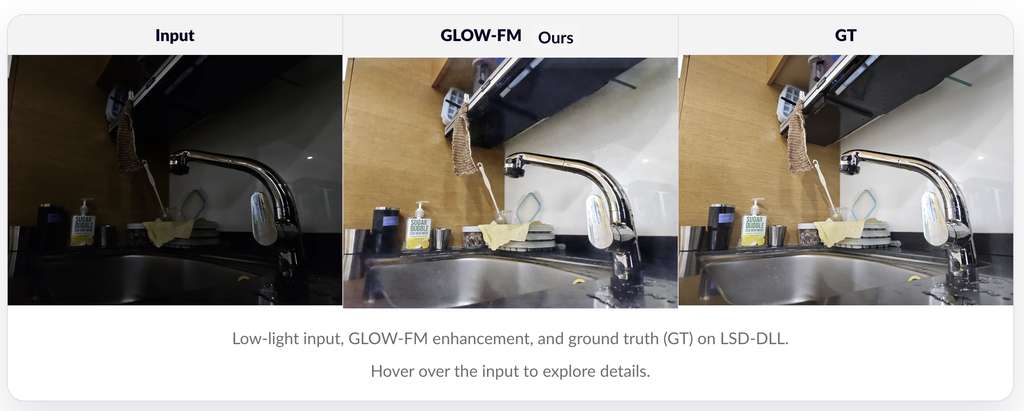
Low-light kitchen scene

低光相片往往同時缺乏細節和自然色彩,逐步生成雖然有助改善觀感,卻增加運算成本。GLOW-FM 是一個低光影像增強(Low-Light Image Enhancement, LLIE)模型項目,透過一次網絡評估恢復影像,處理高質素與低延遲之間的取捨。

項目把影像先映射到緊湊的 latent space,再由輕量 Tiny-VAE 和 Hourglass Diffusion Transformer(HDiT)合作完成修復。HDiT 以 Terminal Velocity Matching(TVM)訓練,推理時只需一步;GLOW-FM-S 的公開規模為 34 GFLOPs 及 9.1M 參數,對邊緣裝置或需要批量處理的工作流程較有吸引力。

  • 一次 function evaluation,避免傳統 diffusion 反覆採樣
  • 在 LSD-DLL 等資料集展示具競爭力的影像質素
  • TVM 專門用於低光增強,並與其他單步目標作比較
  • 跨資料集結果在比較方法中具較強泛化能力

GLOW-FM 延續曾於 NTIRE 2026 Low-Light Image Enhancement Challenge 取得第一名的 LFM-LLIE,但更集中處理效率與單步推理。儲存庫要求 Python 3.11 或 3.12,以及具 CUDA 支援的 PyTorch 環境;README 提供 setup.sh 和依賴安裝方向,但目前提供的資料未足以確認預訓練權重、完整推理指令或 CPU 執行方案。研究團隊、影像增強開發者,以及需要在 GPU 資源受限環境處理夜景相片的團隊,可先按其環境要求建立測試環境,再核對模型權重和推理流程。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, NVIDIA, Image, 影像處理, Python, 庫, Dataset 數據集

FrameForge「換場景、不換主角」統一三種影像生成

FrameForge 把 HunyuanVideo 1.5 的影片時間帶入影像生成,讓同一套模型處理主體生成、邊緣圖生圖和指令式編輯。

Repository image for Lyne1/FrameForge

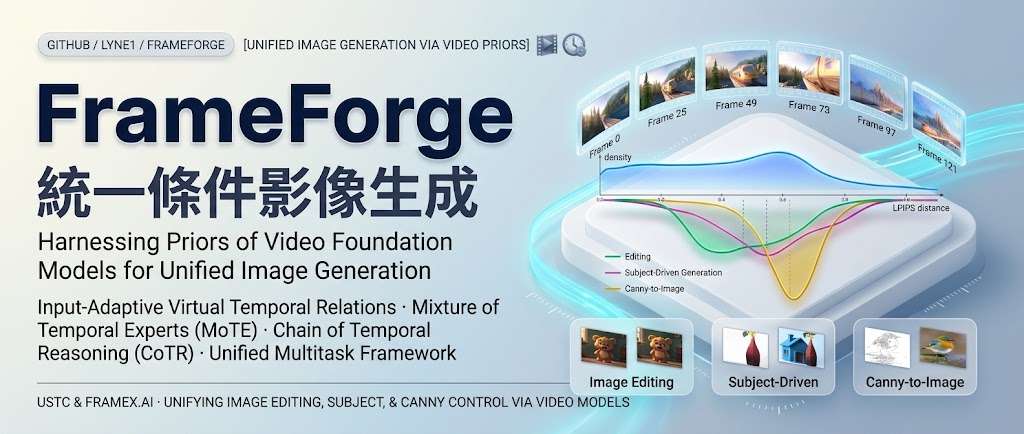
同一張參考圖可以用來保留主體、遵循 Canny 邊緣結構,或按照文字指令改變內容,但三種任務對「要保留多少、要改變多少」的要求並不相同。

FrameForge 是一個「給它一張參考圖,再用文字指示生成或修改圖片」的 AI 研究專案。它的特色是借用影片模型理解畫面變化的能力,來處理靜態圖片。

它用同一個模型處理三種工作:

功能 你提供什麼 可以做什麼
參考主體生成 一張人物、動物或物件的參考圖,加上文字描述 保留主體的辨識特徵,重新生成不同場景,例如把同一隻狗放到海灘上
邊緣圖轉圖片 一張 Canny 邊緣圖,也就是描出物件輪廓的線條圖,加上文字描述 依照既有輪廓、姿勢與構圖生成完整圖片
文字指令修圖 原始圖片,加上修改指令 改變動作、加入物件或轉換風格,例如「把貓的動作改成睡覺」,同時盡量保留其餘內容

這三種功能分別適合「保留是誰/是什麼」、「保留畫面結構」以及「修改指定內容」的需求;不是每次都從文字重新生一張毫無關聯的圖。

技術上有兩個重點:
– MoTE:動態選擇不同的虛擬時間間隔,對應不同程度的畫面變化。
– CoTR:加入一個潛在中間狀態,作為原圖轉換到目標圖的中間路徑。

官方已提供推論程式及模型下載方式,環境需要 Linux、Python 3.10 和支援 CUDA 的 GPU;公開流程以 512 × 512 輸入及輸出圖片、50 次去噪步驟運行,部分模型下載也需要先申請存取權。

注意「同一個模型整合三類圖片工作流程」,可作為評估自建圖像生成/編輯服務的 PoC 起點。官網目前提供的是研究結果與部署入口,不能直接視為已具備完整產品能力。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, NVIDIA, Stable Diffusion, Video, Image, 影像模型, Linux, Python, 庫, 中國, LoRA

RGB MoCap:把影片動作變成可編輯角色動畫

拍一段影片即可重建人體動作,再修正接觸點、套用角色並匯出動畫。

RGB MoCap workspace showing video tracking and a 3D motion preview

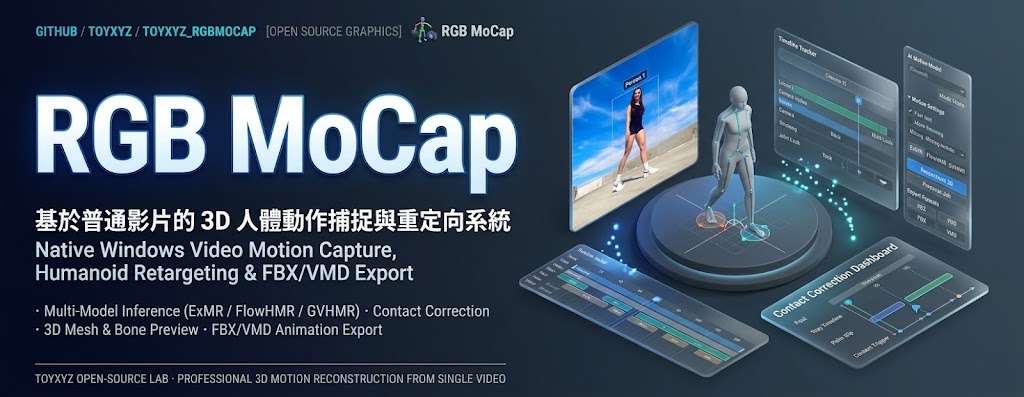
拍攝一段人物影片後,RGB MoCap 會重建人體動作,讓你在 3D 預覽中檢查身體網格與骨骼,再輸出可編輯的人體動畫。這個項目屬於本地運行的 Windows 動作捕捉工具,主要處理由普通影片取得角色動作、修正滑步,以及套用到不同角色格式的工作。

它不只追蹤身體,還提供腳掌和手掌接觸修正,接觸時間可以手動調整;動作可重新套用到 Mixamo FBX、VRM 和 PMX 人形角色,並輸出 FBX,亦可選擇是否連同網格一併匯出。多個 AI 模型的結果能分開保存,方便比較和重做。

安裝需要 Git for Windows、Blender、FFmpeg,以及 ExMR、FlowHMR、GVHMR 等模型運行環境;模型權重和註冊的人體檔案要在 Model Manager 另行準備,部分模型需要帳戶登記和手動下載。MAMMA 與 PromptHMR 屬於可選運行環境,另需 Visual Studio 2022 C++ Build Tools、Windows SDK 和 CUDA Toolkit 12.8;PEAR 則可用於 webcam 或影片中的單人即時身體及手指骨骼預覽。

  • AI 處理在本機完成,適合重視素材私隱的 Windows 使用者
  • 支援多人重建、動作骨骼預覽和 Multi Cam MoCap 工作流程
  • 接觸修正可減少滑步,但仍需人工檢查時間點和追蹤結果
  • 角色重定向涵蓋 Mixamo FBX、VRM、PMX,方便接入 3D 製作流程

提供安裝、更新、模型準備和恢復指引,也附有動作捕捉及角色重定向示例。適合視為可本地測試的製作工具,而不是已有完整性能保證的商用捕捉系統;動畫師、VRM/PMX 角色創作者,以及需要把影片動作帶入 Blender 的團隊會較容易受益。

GitHub

Categories: 開源, AI productions, 模型, NVIDIA, API, Video, 工具, Content Creator, 3D, 庫, 動畫, Dataset 數據集

h3-motion:沿路徑移動照片主體並重生成影片局部

沿路徑移動照片主體,或為影片局部加上遮罩再重新生成;h3-motion 透過自架 ComfyUI 串連影像理解與動畫模型。

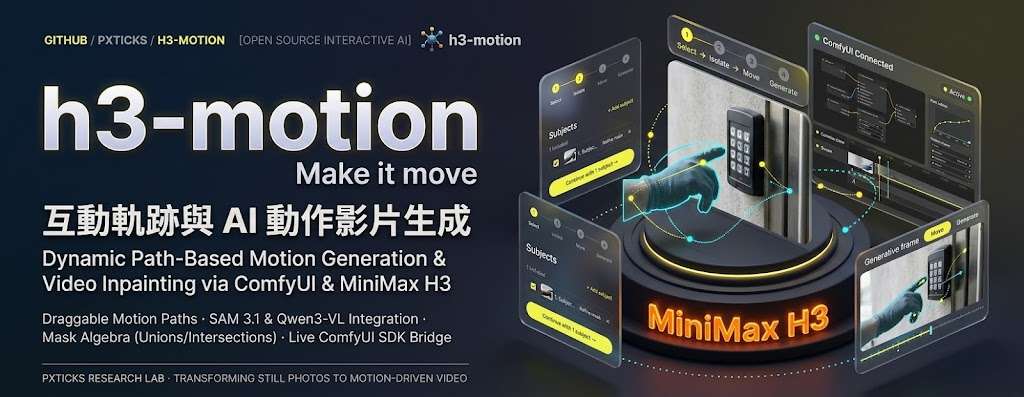
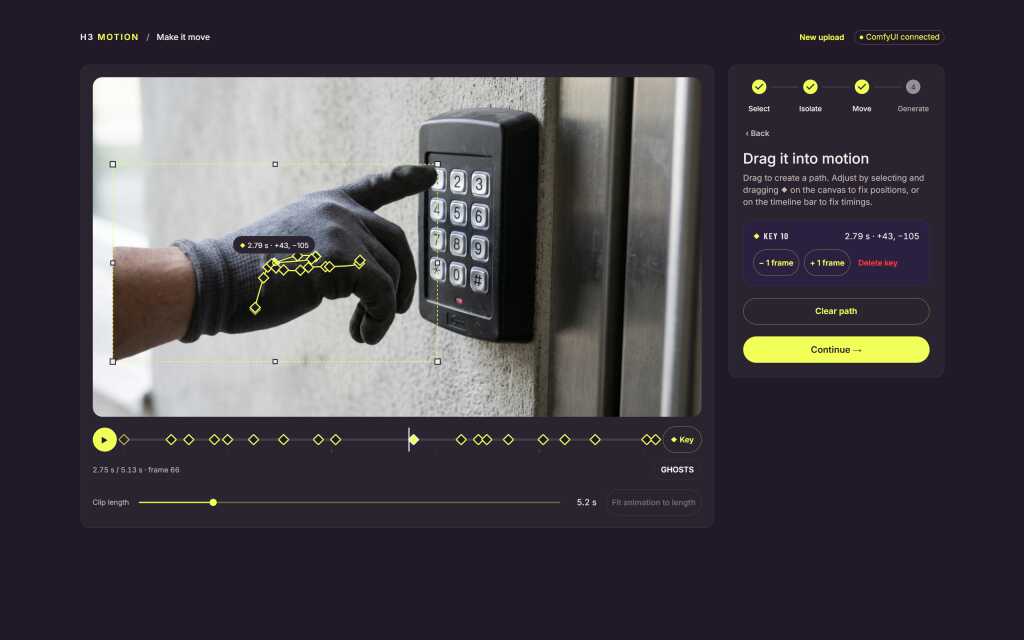
Select step: a gloved hand picked out with SAM 3.1

想沿路徑移動照片主體,或只重做影片局部,h3-motion 把兩種編輯流程整合在獨立 React app,透過 Comfy SDK 操作自架 ComfyUI。流程只用開放權重模型,不依賴 Comfy Router、合作夥伴節點或封閉 API。

照片流程以 SAM 3.1 選取主體,並可用點擊修整遮罩;Qwen3-VL 描述主體,Qwen Image 2.1 清除主體並補回背景。使用者設定路徑、大小或翻轉後,由 MiniMax H3 透過 Time-to-Move 生成動畫與聲音。

影片可用矩形或橢圓標出範圍,設定 keyframe 路徑或讓遮罩跟隨物件,並加入描述及可選參考圖。H3 重生成遮罩區域後,由 app 合成回原片;原有聲音可保留、參照或替換。

  • 照片:主體分割、背景清除,再沿路徑生成動畫。
  • 影片:局部遮罩、路徑或物件跟隨,並合成回來源影片。
  • 模型串連 SAM 3.1、Qwen3-VL、Qwen Image 2.1 與 MiniMax H3。

需要 NVIDIA 或 AMD GPU、近期 ComfyUI、ComfyUI-vlo 0.3.0 或更新版本,以及 Node.js 22.12 或更新版本;原生 Windows 尚未測試。文件未提供速度或畫質評測,較適合熟悉 ComfyUI、需要精細編輯影像局部的創作者。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, Qwen, NVIDIA, API, Video, Image, Audio, Content Creator, 動畫, MiniMax

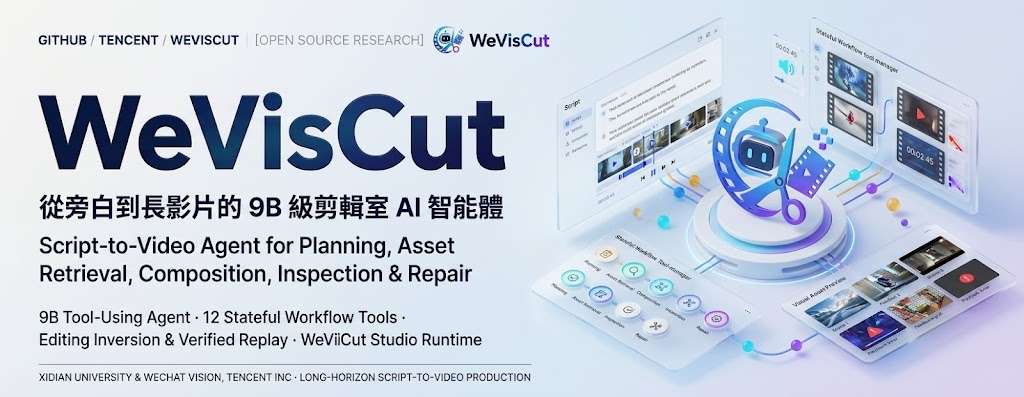
WeVisCut 單一 9B 模型自主剪出多分鐘知識影片

由文章或旁白稿生成多分鐘影片,WeVisCut 讓模型逐步選擇剪輯工具,並可在時間線上修改成片。運行 9B 模型約需 24 GB NVIDIA GPU。

WeVisCut

把知識文章或旁白稿變成多分鐘影片,通常要處理分段、鏡頭、配音、素材、字幕和配樂。WeVisCut 是一個長流程影片剪輯 Agent,由單一 9B 模型讀取剪輯狀態,每次呼叫一項工具,逐步完成製作;它處理的是長篇內容轉成可編輯成片的流程,而非只生成單一畫面或短片段。

模型不依照寫死的階段流程前進,而是按當前狀態決定下一步;防護規則只會拒絕不合法的操作,不會代替模型選擇。每次任務通常約有 12 次工具呼叫,涵蓋文章分段、鏡頭規劃、語音合成、素材檢索、動畫模板、配樂、檢查、修正及合成。檢查與反思本身也是工具,模型可按檢查結果修補未達要求的部分。

Studio 提供八條同步時間軌,成片完成後仍可手動編輯,也支援暫停與續做、聊天修改、單鏡頭重製及版本回退。這讓內容團隊能把它用作長篇解說影片的初剪與修改工作台;成片仍需要人手確認素材、旁白和敘事是否合適。要運行 bf16 9B 模型,項目列出的硬件需求約為 24 GB NVIDIA GPU;只開啟介面、不執行模型則不需 GPU。資料未提供完整安裝及素材服務設定流程,不能只憑這些資訊判定部署所需的全部硬件與外部服務。

評估使用 100 項保留任務,整體分數為 90.5;項目亦報告,每分鐘成功輸出的生成 token 數約比 Claude Opus 5 少 33 倍。這些數字反映項目設定下的測試結果,不足以單獨證明不同影片類型或工作環境都能得到同樣成效。訓練資料則由 3,750 個完成影片項目還原剪輯意圖,再經驗證重播整理出 134,771 個訓練例子;開放的資料建構流程可供研究長流程工具操作的團隊參考。

  • 輸入知識文章或旁白稿,輸出多分鐘剪輯影片。
  • 單一 9B policy 每次呼叫一項工具,按編輯狀態自行規劃後續動作。
  • Studio 保留可編輯時間線,支援逐鏡修改與版本回退。
  • bf16 9B 模型約需 24 GB NVIDIA GPU;純介面模式毋須 GPU。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, Agentic, AI productions, 模型, 模型訓練, NVIDIA, Video, 工具, 語音, Anthropic, 動畫

Open-H3-Regenerate-2K:把 MiniMax H3 影片提升至原生 2K

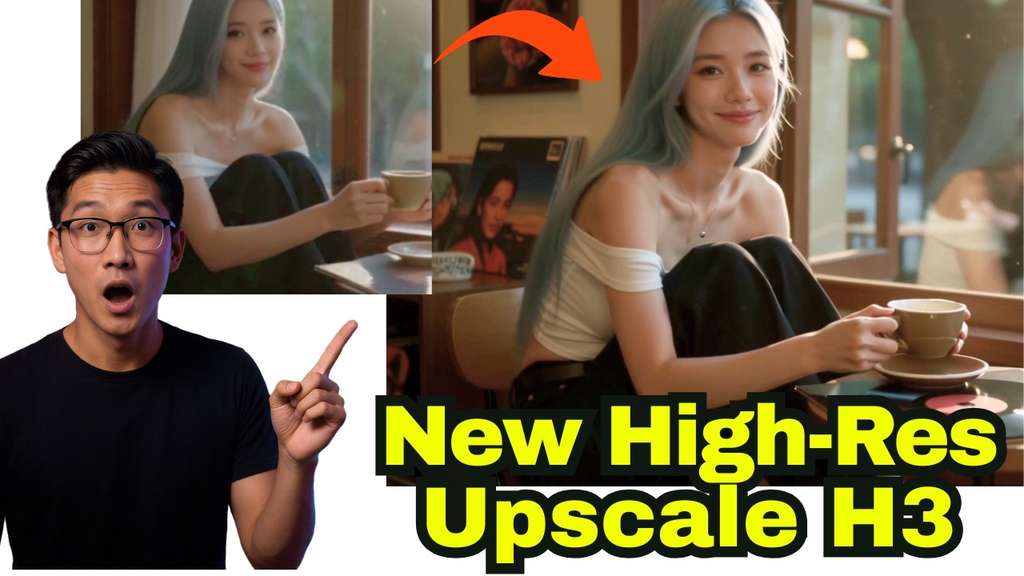
[YouTube 影片]NVIDIA 的 Open-H3-Regenerate-2K 可在 ComfyUI 將 480p MiniMax H3 草稿提升至 2K,並提供兩種測試方法。

Og image

將 480p 影片提升至 2K,往往要在畫面細節、運算成本與輸出穩定性之間取捨。NVIDIA Open-H3-Regenerate-2K 把這項流程帶入 ComfyUI,針對 MiniMax H3 產生的影片草稿進行高解像度重建,適合需要改善輸出尺寸而又想保留原有動態內容的影像工作流程。

影片示範以三個步驟完成處理,並測試兩種方法,相關檔案亦附有連結。不過,提供的原始資料沒有列出具體工作流程、模型檔案名稱、安裝方式或硬件要求,使用者仍需按影片內容及項目檔案確認 ComfyUI 節點、顯示卡記憶體和運算時間。

  • 將 480p MiniMax H3 草稿提升至原生 2K 影片
  • 以 ComfyUI 組合 NVIDIA Open-H3-Regenerate-2K 流程
  • 示範三步處理方式及兩種測試方法
  • 適合影片生成後的放大、修復及高解像度輸出
  • 硬件規格與安裝細節未在原始資料中提供

對內容創作者而言,這個項目可用於先以較低解像度製作草稿,再把選定結果交由高解像度流程處理,減少一開始便以 2K 生成所帶來的資源壓力。它較適合已經使用 ComfyUI、MiniMax H3 或 NVIDIA 影片模型工作流的使用者。

YouTube 影片介紹

Categories: ComfyUI, AI productions, 模型, NVIDIA, Video, Image, Content Creator, 安全, MiniMax

World-in-Context 讓世界模型即時切換視角

操控生成影片時,切換第一人稱、第三人稱與自由鏡頭,畫面仍要延續同一個世界。World-in-Context 以共享控制機制處理這項挑戰。

Alibaba Token Hub

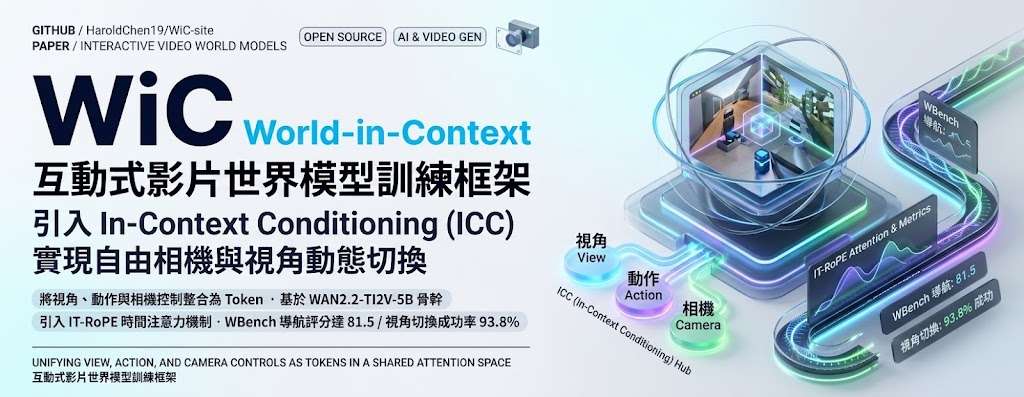
想在生成影片中移動鏡頭、改變觀看角度,甚至在第一人稱與第三人稱之間切換,畫面仍須保持連貫。World-in-Context(WiC)是為互動影片世界模型而設的訓練框架,目標是讓視角、動作和鏡頭控制在同一段影片中協同運作,而不是各自處理。

WiC 以 Wan2.2-TI2V-5B 作為基礎模型,透過 In-Context Conditioning(ICC)把視角、動作與鏡頭控制轉成共享注意力空間中的 tokens;Interaction-Transport RoPE(IT-RoPE)則把累積的控制變化納入時間注意力。這讓系統可支援自由鏡頭、第一人稱及第三人稱視角,也能在影片進行中切換,適合研究互動式場景生成、遊戲環境及長時間因果推演。

在 WBench 評測中,WiC 的導航平均分為 81.5,視角切換成功率為 93.8%。這些結果反映它能處理導航與鏡頭切換,但不能單憑分數判斷生成影片在所有場景都同樣穩定;GPU 記憶體需求亦會隨影片尺寸和設定改變。

目前程式碼、訓練程式及 WiC 權重仍在審核,尚未公開,因此現階段無法自行安裝並重現推理結果。計劃中的版本要求 Linux、Python 3.10,以及支援 BF16 的 NVIDIA GPU;預設生成設定為 832×480、81 幀、16 FPS 和 50 個採樣步驟,並預計提供 11 個包含起始圖片、提示詞與控制資料的範例。

  • 以 Wan2.2-TI2V-5B 為基礎,加入 WiC adapter。
  • 同一影片支援自由鏡頭、第一人稱與第三人稱視角。
  • WBench 導航平均分 81.5,視角切換成功率 93.8%。
  • 程式碼與權重尚未公開,現時未能重現結果。

對研究影片生成、虛擬環境導航或互動遊戲場景的團隊而言,WiC 提供一條把鏡頭與動作控制合併訓練的路線;但在公開程式碼和權重推出前,這些能力仍主要停留在研究成果與展示範例,還不能直接納入工作流程測試。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, AI productions, 模型, 世界模型, 模型訓練, NVIDIA, Video, Image, 提示詞, 框架, 3D, Linux, Python

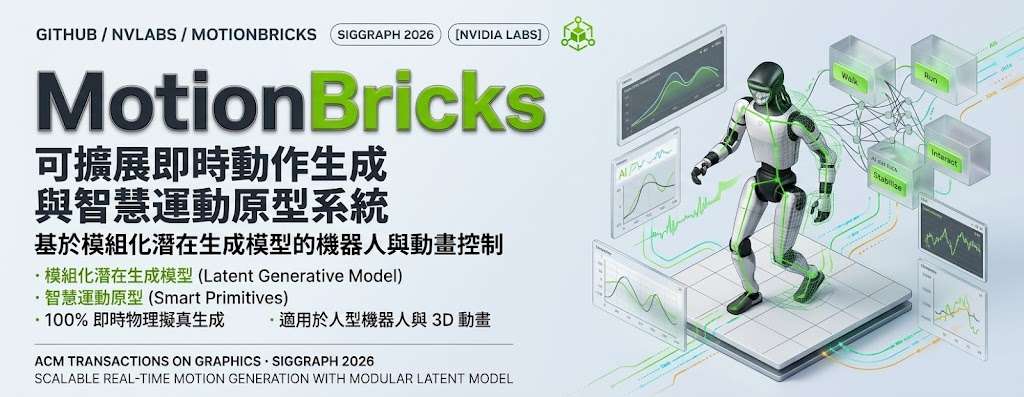
MotionBricks 讓動畫或機械人即時串接自然動作

只需提供角色最近的姿勢和目標姿勢,MotionBricks 就能生成中間動作,並把行走、跨越或坐下等行為組合成連貫場景。

MotionBricks animates characters and robots with one model

機械人或遊戲角色要由一個姿勢自然移動到另一個姿勢,MotionBricks 可以即時補出中間動作。這個模組化潛在生成模型(modular latent generative model)支援角色與機械人動畫,透過最近四個姿勢作為上下文,再以一至四個目標姿勢控制終點及抵達時的動作方式。

它提供 SOMA 人體模型和 Unitree G1 機械人的預訓練模型,並附有 Python 執行環境、動作示範及場景編輯器。使用者可在 Inbetweener 放置姿勢來生成動作,也可用 Scene Preview 測試角色在場景中行走、奔跑、跨越、躲避和坐下;編輯器則可製作 Smart Primitives,將導航與物件互動動作組合起來,無須為新行為重新訓練模型。

MotionBricks 的做法,是讓三個學習模組分工生成動作,再以 Smart Primitives 提供可組合的行為積木。研究團隊表示,模型涵蓋超過 35 萬段動作,並可用於新任務而無須微調或逐項標記;這有助遊戲動畫、機械人模擬及互動場景製作,但實際效果仍取決於目標姿勢和場景設定。

項目網站報告最高每秒 15,000 FPS、延遲 2 毫秒。執行環境依賴 NVIDIA GPU 和 TensorRT,示範曾在 Windows 及 Linux x86-64、配備 GeForce RTX 4090 的系統測試;首次載入模型與精度設定時,還要建立 TensorRT 執行計劃,因此這些數字不宜直接視為所有硬件上的保證。

  • 支援 SOMA 人體模型及 Unitree G1 預訓練模型,模型以 ONNX 提供,檢查點則放在 Hugging Face。
  • Python 執行環境以 Warp、Newton 和 TensorRT 串接多次生成,形成連續動作。
  • 附有 Inbetweener、Scene Preview,以及 Smart Primitives 和場景編輯器。
  • 儲存庫提供導覽教學;但執行需要 NVIDIA GPU,設定亦涉及 Git LFS、uv 和首次建立 TensorRT 計劃。

對需要快速製作可控角色動畫、驗證機械人動作或搭建互動場景的團隊,MotionBricks 提供由姿勢控制到行為組合的一套研究原型。它減少了手工編排動作轉場及為每個任務重新訓練的需要,但硬件門檻和場景設定工作仍需納入製作流程。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, NVIDIA, 教學, Linux, Python, 庫, 動畫, Dataset 數據集

Page 1 of 17
1 2 3 … 17