PermaVid 令影片修改後仍然連貫

PermaVid 想解決影片一改風格或場景後就前後不一致的老問題。它用分離式記憶設計,兼顧外觀變化與空間結構。

teaser

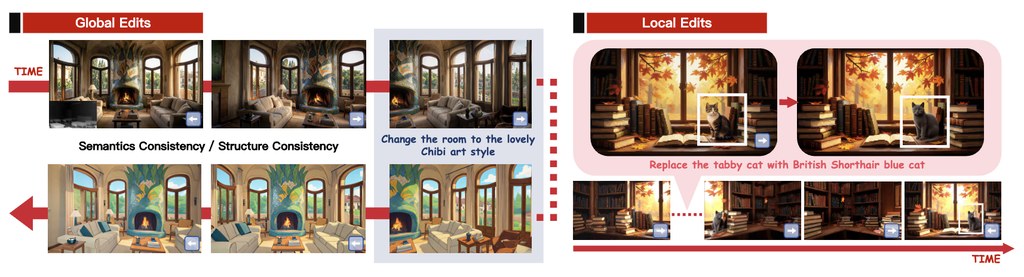
很多影片生成方法處理編輯任務時,會把過往畫面當成單一記憶來源;一旦做了 style、season、weather 或 time 這類修改,舊記憶就可能變成過時參考,之後生成的鏡頭容易出現人物變樣、場景走位錯亂,或者視角切換後對不上。PermaVid 提出的方向,是把「外觀語意」同「幾何結構」分開保存,避免一次編輯令全部上下文一齊失效。

這是一個影片生成框架,核心工作是讓 edited video 在跨時間、跨視角、跨多次修改之下,仍保持內容連貫。它使用 disentangled context memory:RGB context memory 負責記錄 semantic appearance,depth context memory 則保留 geometry-only structure,再配合 edit-aware memory update and retrieval,把新修改過的資訊逐步寫回記憶。

和一般只靠單一記憶庫或單一路徑條件控制的方法相比,PermaVid 的取捨很清楚:系統更複雜,也要同時處理 RGB 與 depth 兩種脈絡,但換來的是編輯之後的長期一致性。從儲存庫資訊看,項目亦提供 dataset、paper 及 demo,並依賴 Wan2.1-VACE-14B、Qwen-Image-Edit、Qwen3-VL-8B-Instruct 等模型,顯示它不是輕量玩具,而是偏研究型、多模組組合的完整流程。

  • 支援相機移動控制,例如 direction-frames-speed 這類格式
  • 編輯類型涵蓋 style、season、weather、time 等全局變化
  • 重點不只是生成單段片,而是修改之後仍維持後續片段一致
  • 需要較完整環境配置,包含 PyTorch、CUDA 與額外訓練/推理依賴

如果你是做 instruction-based video editing、reference video generation,或者想研究 Computer Vision 同多模態記憶如何影響長片段一致性,這個項目很有參考價值。現有資料提到它在長期 semantic 與 structural consistency 上明顯優於 state-of-the-art methods,但公開資訊未列出完整量化分數;較穩妥的理解,是它的亮點在方法設計與 benchmark 表現方向,而不是即裝即用的消費級工具。

GitHub: https://github.com/YS-IMTech/PermaVid
項目主頁: https://ys-imtech.github.io/projects/PermaVid/

Paper: https://arxiv.org/pdf/2606.16449

Categories: 開源, 香港中文大學, 阿里巴巴, 視覺模型, 視頻模型, Qwen, NVIDIA, Video, Image, 影像處理, 框架, 香港, 工具, Python, 庫, Dataset 數據集

SR-REAL 把空間推理拆成兩條路

SR-REAL 不是只靠文字推理,也加入 3D 定位再判斷。它想解決空間 VLM 遇到距離、方位、多步推理時常出錯的問題。

Repository image for jiyt17/SR-REAL

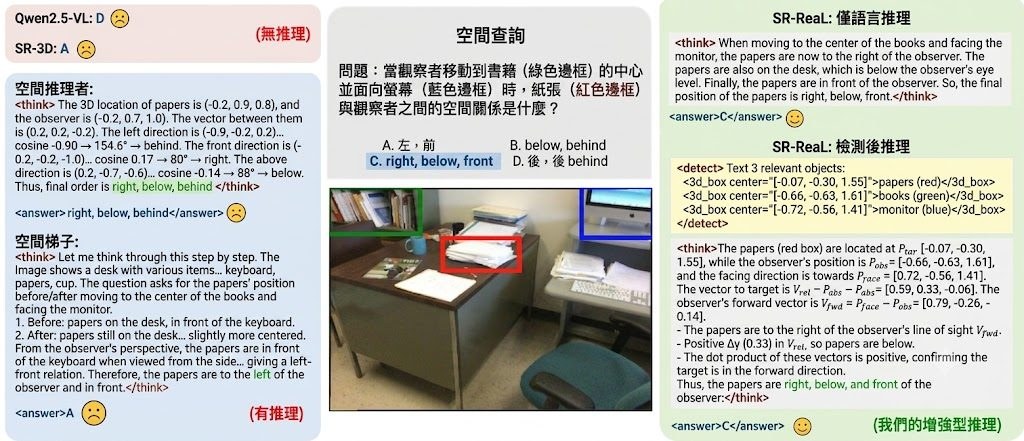
現有 spatial VLM 往往用單一路線回答空間問題,不是純文字 chain-of-thought,就是直接靠感知結果輸出答案;作者認為這種固定範式難以同時處理語意推理與精確幾何判斷。SR-REAL 提出的做法,是把空間推理分成 Language-Only Reasoning(LOR)與 Detect-Then-Reason(DTR)兩條互補路徑,前者逐步文字推理,後者先找 3D 幾何線索,再做明確幾何推斷。

這個項目屬於框架加訓練流程實作,核心是強化 spatial vision-language models 在複雜空間問答中的判斷能力。它不是單純新增資料集,而是從 cold-start supervised fine-tuning 到 reinforcement learning(RL)都重新安排,並加入 region-to-3D 介面,令模型可把 region tokens 連到 3D 座標、中心點或 bounding boxes。

SR-REAL 重點集中在資料準備與訓練前處理。流程上會先用 SPAR、EmbodiedScan 等來源整理物件對應與 3D 座標,再由 expert.py 生成推理鏈,配合 qwen3.py 抽取物件名稱,最後組成 DTR 指令微調資料;若不想自行重建,也可直接下載作者已整理好的 Hugging Face 數據。這表示它較適合有 Python、資料處理及多模態訓練基礎的研究團隊,而不是即裝即用的終端工具。

和同類做法相比,SR-REAL 不假設所有空間問題都應該用同一種 reasoning path。作者的取向很清楚:語意關係適合 LOR,涉及明確位置、距離、中心點、框選區域的題目則交給 DTR;代價是整個資料構建與訓練流程更複雜,對 grounding 資料品質亦更敏感。

  • 重點不在單一模型結構,而在 LOR + DTR 雙路徑推理設計
  • DTR 會先處理 region tokens 與 3D 幾何線索,再做空間判斷
  • 訓練分為 cold-start supervised fine-tuning 與 reinforcement learning(RL)兩段
  • 已提及 accuracy、format、detection rewards,顯示評測不只看答對與否,也看輸出格式及幾何對齊
  • 相關模型與資料來源包括 spatial VLM、SR-3D、Qwen3、SPAR、EmbodiedScan、SpatialRGPT、Omni3D、CA1M、OmniNOCS

SR-REAL 在多個 spatial benchmarks 有明顯提升,並強調單一 RL-trained model 可同時支援兩條路徑,且不用 per-task tuning 也能跨資料集泛化。不過儲存庫片段未完整列出詳細分數與對照表,因此較穩妥的判斷是:這是一個研究味很重、方法論清晰的項目,適合關注 spatial reasoning、3D grounding、multimodal instruction tuning 的團隊拿來重現與延伸。

GitHub: https://github.com/jiyt17/SR-REAL

項目主頁: https://sr-real.github.io/

Categories: 香港大學, Agentic, 模型, 多模態模型, 模型訓練, Qwen, Google, NVIDIA, OpenAI, DeepSeek, 框架, 香港, 工具, 3D, Python NLP, Python, 庫, 編程

JanusMesh 把雙提示變成 3D 視覺

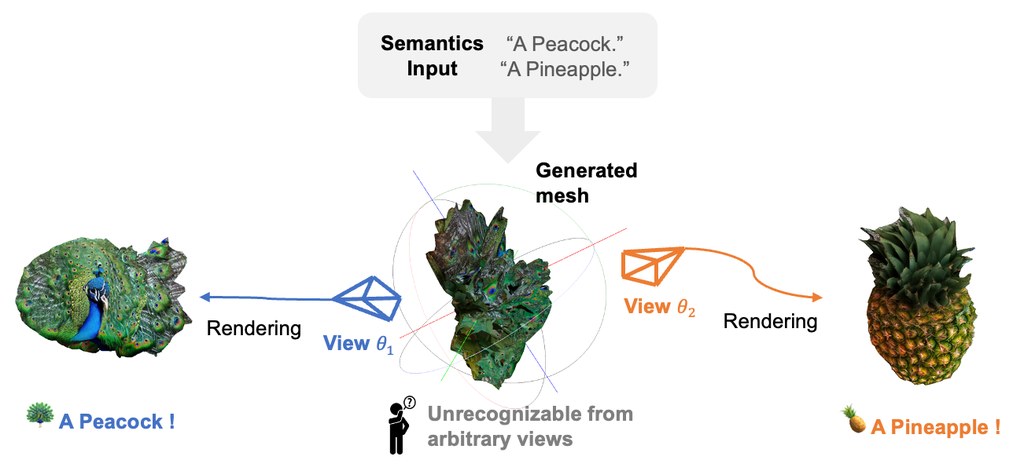
JanusMesh 用兩句文字生成同一個3D物件,從不同角度看出不同意思。它主打免訓練、速度快,亦針對舊方法的接縫與語意外漏問題。

Teaser

現有 3D visual illusions 做法,多數不是走 optimization-based methods,就是把兩個形體直接拼接。前者慢,還容易出現過飽和顏色;後者雖然直接,但會留下明顯幾何接縫,亦會有 semantic leakage。JanusMesh 提出的不是新訓練模型,而是一條 training-free pipeline,目標是把兩個文字提示融合成一個 3D mesh,並在指定視角各自呈現不同語意。

它的核心分成兩步:先用 cross-space dual-branch denoising,在 voxel 與 Signed Distance Field (SDF) 之間處理形體融合,再配合 CLIP 做 orientation alignment;之後再用 view-conditioned 2D diffusion 補貼圖與外觀。這種拆法的重點,不是單純把兩個物件疊上去,而是先解決幾何是否連貫,再處理不同視角看到的表面語意。

部署上,現有資訊顯示它較適合有 CUDA 環境的研究或圖像團隊,因為要安裝多個 CUDA extensions,例如 flash-attn、nvdiffrast、diff-gaussian-rasterization、pytorch3d。測試思路相當清晰:可先用 case 1 或 case 2 直接生成固定 voxel split 結果,再用 case 3 加入 CLIP pose search,比較視角對齊是否更穩定;另外也可調整 noise guidance、space control、t0 idx value 與 guided structure weight,觀察語意強度與形體穩定度之間的取捨。

JanusMesh 的表現頗有競爭力:生成時間約 3–5 分鐘,主打 geometric integrity、semantic recognizability、efficiency 都比同類方法好。不過它目前更像研究型工具,適合做 3D 內容展示、視覺實驗、生成式藝術或學術比較;若想要任意角度都自然,文中亦明言這類物件在非目標視角本來就可能難以辨認,這其實是 3D 視覺錯覺成立的一部分。

  • 項目類型:一個 training-free 的 3D 生成流程,解決雙語意 3D visual illusions 的幾何接縫、語意外漏與生成速度問題。
  • 最值得留意的差異:不是 per-shape optimization,也不是 direct concatenation,而是先做 cross-space 幾何融合,再做 view-conditioned 外觀細化。
  • 較適合的情境:3D 生成研究、視覺傳達、展覽內容、概念設計,以及想比較多種 3D illusion 範式的團隊。
  • 性能重點:論文聲稱 3–5 分鐘可完成,較傳統 SDS-Based Methods 快,亦減少 oversaturation 與 seams。
  • 相關模型/組件:CLIP、2D diffusion、voxel、Signed Distance Field (SDF)、flash-attn、nvdiffrast、diff-gaussian-rasterization、pytorch3d。

GitHub: https://github.com/siang1105/JanusMesh

項目: https://siang1105.github.io/JanusMesh.github.io/

Categories: 開源, 模型, 視覺模型, 模型訓練, NVIDIA, Image, 工具, IDE, 3D, Python

ENPIRE : NVIDIA 閉環系統訓練機械人自我改良

ENPIRE 把真實機械人訓練變成可反覆優化流程,讓 coding agents 直接參與改良策略。

NVIDIA

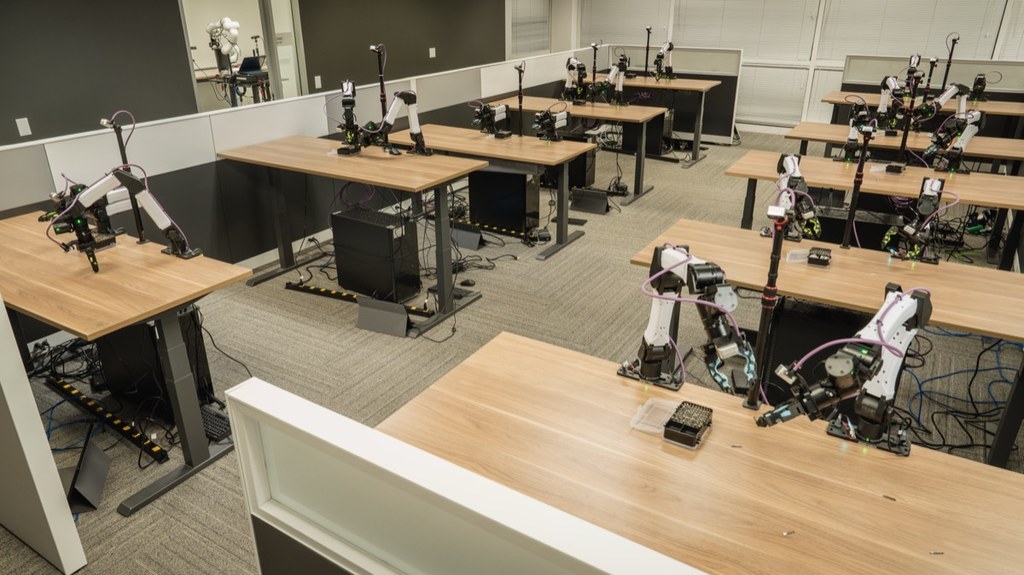
ENPIRE 是一個用於真實世界機械人策略自我改良的框架,重點不是單一模型,而是把「重設場景、執行策略、檢查結果、再改進」串成可重複閉環。它針對的問題很明確:靈巧操作任務一直很依賴人手監督與大量調參,令機械人研究難以擴展。

系統由四個模組組成:Environment(EN)負責自動重設與驗證、Policy Improvement(PI)負責發動策略改良、Rollout(R)負責在單機或多機械人上測試、Evolution(E)則讓 coding agents 分析紀錄、查閱文獻、調整訓練基建與演算法程式。與常見只在模擬器或純數碼環境做 agent 優化的方法相比,ENPIRE 把回饋迴路直接放到真實機械人上。

列出的案例包括 PushT、Pin Insertion、Tie Zip-tie 與 GPU Insertion,可見它瞄準的是需要精準操作的任務。按頁面描述,frontier coding agents 在這套流程下,可把部分真實操作任務推高至 99% 成功率,但不同任務、機械人配置與訓練設定之間仍可能有差異,閱讀時宜把它視為特定條件下的結果。

若想理解這個項目,可先從它的閉環結構入手,再看 Policy Improvement 支援哪些路線,例如 heuristic learning、tool calling、behavior cloning、offline RL 與 online RL。頁面亦提到 robot fleet scaling、simulation evaluation、auto evaluation 與 auto reset,反映這個項目不只關心模型表現,也在處理如何把測試與迭代流程自動化。

  • 核心價值:把真實機械人訓練流程標準化,減少人手介入
  • 主要差異:不是只生成策略,而是連同驗證、重設、改良一起自動執行
  • 適合讀者:機械人研究者、Agentic AI 開發者、關心自動化實驗流程的人
  • 已提方法:heuristic learning、tool calling、behavior cloning、offline RL、online RL

這項目較適合放在機械人學習、自主代理與真實世界實驗自動化的脈絡下理解。若你關心 Computer-use agents 或 coding agents 能否走出螢幕、直接管理物理系統的迭代流程,ENPIRE 提供了一個相當具體的方向。

項目: https://research.nvidia.com/labs/gear/enpire/

Categories: 開源, Agentic, 模型, 模型訓練, NVIDIA, Robotic, 框架, Vibe Coding, Clone, 編程

AdaVoMP 讓 3D 場景有可互動物理材質

AdaVoMP 會為 3D 物件補上物理材質資料,令模擬更真實,亦更高解像與省記憶體。

Og image

不少 3D 資產只有外形,欠缺 Young’s modulus(E)、Poisson’s ratio(ν)同 density(ρ)等物理資料,結果做模擬時只係「睇落似」,但受力、變形同碰撞未必可信。AdaVoMP 就係針對呢個缺口,為輸入 3D 物件預測高密度、空間可變的物理屬性場,令數碼世界更接近可互動、可模擬的狀態。

同前一代 VoMP v1 比,AdaVoMP 的重點唔止係更清晰,而係改用 sparse and adaptive voxel structure(SAV)同 sparse transformer encoder-decoder,將固定體素表示換成可自適應結構。頁面指出,它可生成高出 16^3 倍解析度的屬性場,亦支援 test-time 調整解析度,兼顧準確度、記憶體效率同細節保留。

AdaVoMP short video [ICML 26]

AdaVoMP 展示咗幾種直接可理解的用途,例如將 Gaussian Splat + mesh 場景轉成可互動世界、為純 mesh 或 gaussian splats 場景做較真實的物理模擬,以及配合 RoboLab 與 Isaac Sim 建立機械人測試環境。對做 robotics、simulation、數碼孿生,或者想將 NeRF、Gaussian Splat 資產變成可操作場景的人,呢類流程會特別有參考價值。

  • 補回 3D 資產常見缺失的物理材質資訊
  • 比 VoMP v1 提供更高解析度與可縮放輸出
  • 同時支援 mesh、Gaussian Splat 等不同表示
  • 可用於 Isaac Sim 機械人基準測試與互動場景建立

從頁面資料看,AdaVoMP 亦有同 NeRF2Physics、PUGS、Phys4DGen、Pixie、VoMP 及 Ground Truth 作視覺比較,重點放在 physics material fields 的品質。若要自行測試,查看 Code 同 Model/Data,再留意它在自己場景表示、模擬器同資產格式上的接入成本。

項目: https://research.nvidia.com/labs/sil/projects/adavomp/

Categories: 開源, 模型, NVIDIA, Robotic, 3D

RATs 用多代理玩出機械人技能庫

RATs 把機械人學習拆成先玩、後解題兩段流程,重點不是微調,而是靠 LLM 代理寫程式累積可重用技能。

RATs pipeline overview — click to play the video

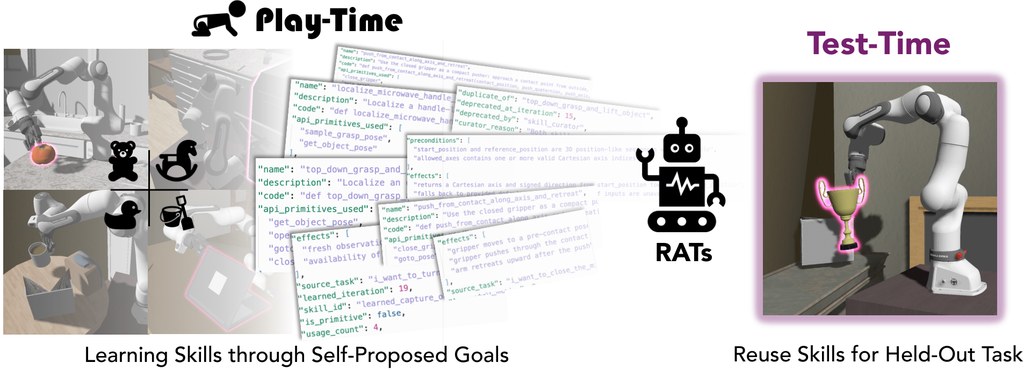
現有機械人代理很多時仍然沿用 task-driven 路線:先收到明確指令,再透過 Code-as-Policy 產生可執行程式來完成任務。RATs 則批評這種做法太依賴外部任務,令可重用技能只會在被要求時才出現,所以它提出一個多代理 Code-as-Policy 系統,先用 free-form play 自行發明練習目標,再把成功行為整理成技能庫。

這個項目屬於機械人學習框架,要解決的是機械人代理遇到新任務時,欠缺可直接調用的長期技能累積。RATs 分成 Play 與 Evaluation 兩段:前者由 proposer、planner、policy-writer、verifier、failure-diagnoser 幾個 LLM 代理協作,後者把已凍結的技能當成 planner context 重用,而且強調 no gradients、no RL,主要靠 structured natural-language feedback 與 code reuse 學習。

如果你想試這個項目,較適合把它當成研究型系統來跑 benchmark,而不是即裝即用小工具。環境要求包括 Python 3.10、CUDA-capable GPU,並牽涉 LIBERO-PRO、MolmoSpaces、Robosuite 及真實 Franka Panda 流程;比較合理的測試次序,是先看 Play 階段怎樣生成技能,再檢查 Evaluation 階段對 held-out tasks 有沒有改善。

它的創新點,在於把「玩」正式納入 lifelong robot skill learning:不是隨機探索,而是讓代理自己提出可學習任務、逐步驗證中間進度、失敗後再診斷重試,最後把成功執行蒸餾成 reusable skill library。這令技能可在跨環境情境重用,不一定綁死原本訓練場景。

論文給出的結果相當具體:在 LIBERO-PRO 與 MolmoSpaces,play-learned skills 相比 no play 與 random-play baselines 有提升,對 CaP-Agent0 分別高出 20.6 和 17.0 個百分點;把技能直接檢索進其他 inference-time Code-as-Policy agents 的 context,對 Robosuite 與真實世界 transfer 亦分別提升 8.9 和 8.8 點。相關模型與基線主要包括 CaP-X、CaP-Agent0,以及文中使用的 LLM agents 協作流程;若你關心 agentic robotics、技能重用與真機轉移,這個項目很值得細讀。

  • 類型定位:多代理機械人學習框架,核心是 Code-as-Policy 與技能庫重用
  • 方法重點:先 Play 自提任務學技能,再 Evaluation 把技能注入 planner context
  • 技術取向:不靠 gradients 或 RL,主要依賴自然語言回饋、程式修正與 code reuse
  • 適合場景:研究 embodied agents、robot skill library、cross-environment transfer 的團隊
  • 已提到的相關系統:CaP-X、CaP-Agent0、LIBERO-PRO、MolmoSpaces、Robosuite、Franka Panda

GitHub: https://github.com/Playful-RATs/rats

項目: https://playful-rats.github.io/

Categories: 開源, Agentic, AI productions, 模型, 模型訓練, NVIDIA, Robotic, 框架, 工具, Python NLP, Python, 庫, Skill 技能

Nemotron:NVIDIA 打造 Agentic AI 模型家族

Nemotron 不只是單一模型,而是一套面向 agentic AI 的開放模型與訓練資源。由邊緣裝置到資料中心,都有對應版本。

Watch the Nemotron Overview

Nemotron 是一個面向 agentic AI 的模型家族加開發資源項目,重點不是只放出權重,而是連 training recipes、deployment guides、資料準備與 use-case examples 一併提供,目標是縮短由研究到部署的距離。對想建立 AI agents 的團隊來說,這種整理方式比單獨下載模型更實用。

這個項目最實際的看法,是它把不同算力環境分得很清楚:Nano 針對 edge 和 PC,Super 主打單 GPU 高吞吐,Ultra 面向 multi-GPU datacenter applications。若你想先試概念,可由 Hugging Face 上的 Nemotron 模型開始,再按項目內的指引查看對應版本的訓練與部署資料。

創新點在於它不只講文字模型。Nemotron 3 Nano Omni 是 30B-A3B hybrid Mamba-Transformer MoE,原生支援 text、image、video、audio,定位為 agentic AI 的 multimodal perception sub-agent。這代表它較像多模態代理系統中的感知核心,而不只是一般聊天模型。

項目內容亦涵蓋 curate/、data prep/、sdg/ 和 translate/,即是連資料整理、Synthetic Data Generation (SDG) 與 corpus translation 都納入流程。這種由數據到模型再到部署的完整鏈條,對企業、研究團隊,以及想建立可重複流程的開發者尤其有吸引力。

  • 提供 Nemotron Nano、Super、Ultra 等級,對應不同硬件規模
  • 涵蓋 training recipes、deployment guides、資料處理與 SDG
  • Nemotron 3 Nano Omni 支援文字、影像、影片、音訊多模態輸入
  • 可配合 TensorRT-LLM 與 NIM microservices,部署彈性較高
  • 適合 agentic AI、Computer-use agents、企業內部 AI workflow 測試

如果你想找的是一個可直接抄答案的成品,Nemotron 未必是最快捷的選擇;但若你需要一套可追溯、可調整、可延伸的開放模型項目,它的結構相當完整。現有資料顯示它更偏向給認真做產品化或研究驗證的人使用,而不是單次玩票式體驗。

GitHub: https://github.com/NVIDIA-NeMo/Nemotron

Categories: Agentic, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Image, Audio, 工具, Anthropic, AGI

BadWorld:如何解決癱瘓視覺世界模型的未來推演

香港理工大學團隊提出無需標籤的對抗攻擊框架,揭露 Matrix-Game-2.0 與 Astra 等世界模型在單一擾動圖下即可能全面崩潰的結構性脆弱。

Chart

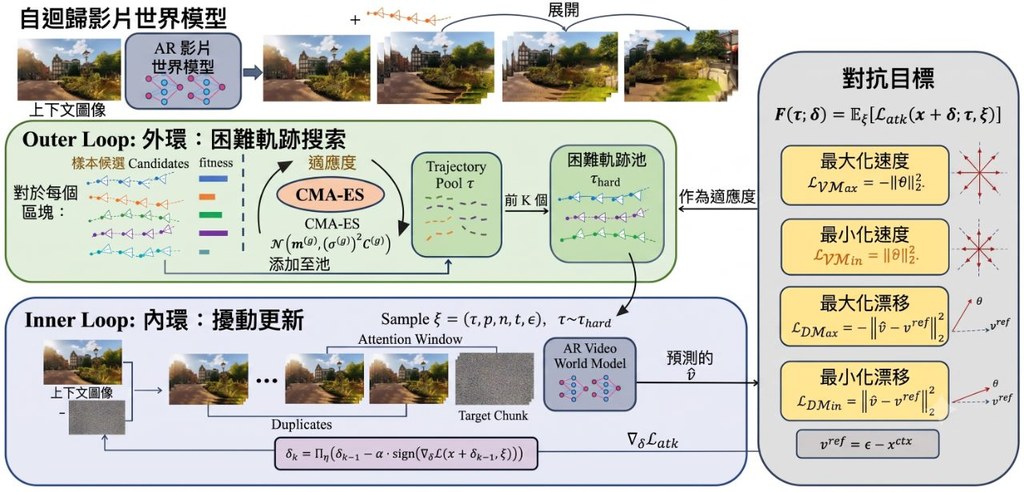
視覺世界模型(Visual World Models, VWMs)能從一張起始圖片,根據使用者動作序列合成出互動式的未來影片。現有做法多數沿用文字生成圖像或文字生成影片的對抗攻擊範式,但這類方法通常假設有固定的參考輸出或可取得的未來幀標籤。BadWorld 的作者指出,攻擊 VWMs 面對兩道根本限制:攻擊者根本拿不到真實的未來影片當作監督訊號,也無法預測使用者接下來會輸入什麼動作,因此傳統攻擊範式無法直接套用。

為此,團隊提出 BadWorld 框架,屬於一種安全研究工具,專門用來壓力測試自回歸式世界模型的時序穩健性。它繞過「需要未來監督」這道牆,採用自監督的速度擾動攻擊(self-supervised velocity attack),直接破壞模型早期的去噪動力學;同時,為了讓攻擊在未知動作下仍然有效,設計了軌跡自適應雙層優化(trajectory-adaptive bi-level optimization),主動挖掘困難的動作序列以鍛造「對動作無感」的擾動。

從測試結果來看,視覺上幾乎無法分辨的對抗圖片,能可靠觸發後續推演的災難性退化,出現去噪不完全、結構崩塌、控制訊號前後不一致等現象。這些發現對準備把世界模型應用於自動駕駛、機器人等安全關鍵場景的開發者是一記警鐘,同時也提供了一種可操作的隱私保護機制。

如果想自行驗證,可以針對 Matrix-Game-2.0 與 Astra 兩款開源世界模型測試。Matrix-Game-2.0 需約 32GB 顯示記憶體,Astra 則需 80GB,環境需要搭配 FlashAttention 與 NVIDIA Apex 等加速庫,並從 Hugging Face 下載預訓練權重。

  • 屬於安全研究工具,針對視覺世界模型做對抗壓力測試。
  • 突破傳統攻擊需「未來監督」的限制,採自監督速度擾動。
  • 透過軌跡自適應雙層優化,鍛造對未知動作仍有效的擾動。
  • 已在 Matrix-Game-2.0 與 Astra 上展示結構性崩潰。
  • 對自駕、機器人、遊戲模擬等安全關鍵部署具警示意義。

GitHub: https://github.com/LinghuiiShen/BadWorld

Paper: https://arxiv.org/pdf/2606.16519

Categories: 開源, 香港理工大學, 清華大學, 模型, 世界模型, 模型訓練, NVIDIA, Video, Image, 框架, 香港, 工具, 庫, 安全, 深度學習

BRDFusion:物理與生成模型合體,城市街景逆向渲染新框架

結合物理渲染與生成式擴散模型,把城市影片拆解為幾何、材質與 HDR 光源,支援夜景模擬與物件插入等編輯應用。

logo

現有的城市場景逆向渲染方法長期面臨兩難:基於物理的渲染(physically-based rendering)雖然能嚴格遵守光學物理,但在重建與渲染階段容易產生雜訊與破圖;生成式模型(generative models,例如 DiffusionRenderer)能產出逼真影像,卻難以精準控制光源,例如車燈這類局部照明往往被忽略。BRDFusion 正是針對這個 trade-off 而設計的混合框架。

這個項目屬於研究型框架,目標是把多視角城市影片分解為幾何(法線、深度)、材質(albedo、roughness、metallic)與 HDR 環境光源,並支援新視角重照明、夜景模擬與動態物件插入等下游應用。具體做法上,它先用物理模型取得明確且一致的場景屬性,再借助生成式先驗(generative priors)緩解優化過程中的歧義;前向渲染時,物理模型負責可控渲染,生成模型則負責去噪與修補瑕疵。

測試方面,作者提供預處理資料集與預訓練權重,研究人員可直接下載並透過 tools/run_pipeline.py 跑推理與評估;硬體需求偏高,建議使用 NVIDIA RTX A6000,RTX 4090 在記憶體允許下可執行部分階段,但 Gen. Render 階段可能突破 24 GB 限制。資料集與評估影片亦同步發佈於 Hugging Face,方便重現結果。

這個項目的創新之處在於把「物理一致性」與「生成式品質」放在同一條管線中互補,而非二選一。對從事自動駕駛模擬、遊戲或影視場景重建的研究團隊而言,這是一個值得關注的方向。

重點摘要

  • 混合範式:物理渲染負責可控性,生成模型負責修補瑕疵,突破單一方法的極限。
  • 完整分解:輸出幾何、材質與 HDR 光源,支援新視角、夜景與物件插入。
  • 高硬體需求:建議 RTX A6000,4090 僅能跑部分階段。
  • 完整開源資源:程式碼、預訓練權重、資料集與評估影片均已公開。
  • 適用場景:自動駕駛模擬、城市數位孿生、影視級場景編輯。

GitHub: https://github.com/shigon255/BRDFusion

Categories: 開源, 清華大學, 模型, 視覺模型, 模型訓練, NVIDIA, Stable Diffusion, Video, Image, 影像模型, 影像處理, 框架, 工具, Meta, 深度學習

RhymeFlow:加快影片生成的新路線

RhymeFlow 針對影片生成太慢的老問題,提出免訓練加速方法。它不只追求更快,亦嘗試保住畫面連貫度。

Repository image for Simon-Dcs/RhymeFlow

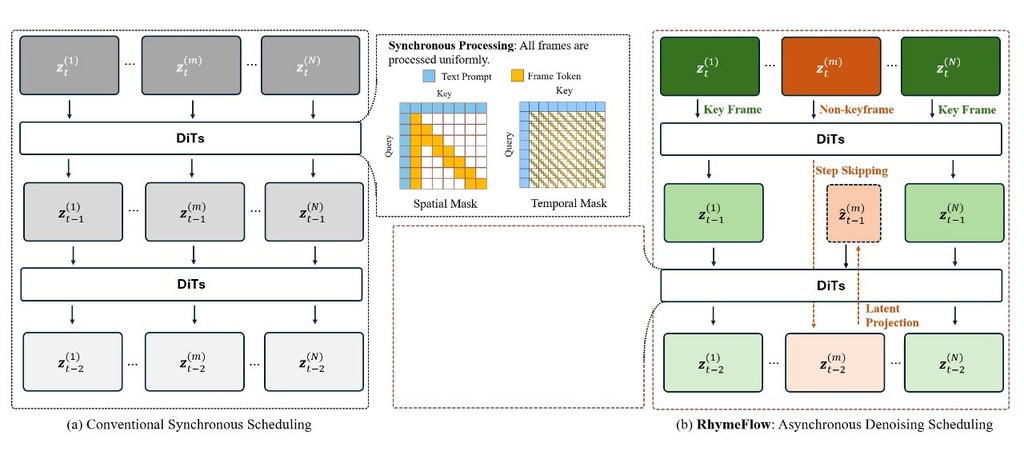
現時不少影片生成加速方法,主要仍沿用標準 diffusion pipeline:每一幀都要在所有 diffusion timesteps 完整做一次 dense denoising,再配合 sparse attention 或 KV-caching 減少單步計算。RhymeFlow 指出,這種固定範式忽略了相鄰影格內容與動作高度相關,令自然影片裡大量中間步驟其實屬於重複運算。

這是一個免訓練的影片生成加速框架,核心目標是替 DiT(Diffusion Transformers)影片模型減少推理延遲與運算成本。它將不同影格的 denoising trajectory 拆開處理:先找出主導語意變化的 keyframes,讓 keyframes 保持逐步去噪,非 keyframes 則逐步跳過部分步驟,再用 latent trajectory projection 補回時間一致性。

這個做法的創新,不在於單純把 attention 再稀疏化,而是直接挑戰「所有影格都要同步、密集去噪」的舊假設。論文描述,RhymeFlow 在現有 DiT-based video generation models 上,能同時取得更高 inference speed 與更好 visual quality;不過 GitHub 目前公開重點放在 Wan 2.1 adaptation,HunyuanVideo adaptation 仍在準備中。

如果你想試,較合理的切入點是把它當成 Wan 2.1 的加速實驗框架,比較 dense、svg、sap、rhyme、rhyme_sap 幾種方法輸出時間與畫面差異。環境要求偏高,文件列出 CUDA 12.4 / 12.8 與 PyTorch 2.5.1 / 2.6.0,亦牽涉 FlashInfer、flash-attn 和自訂 kernels,較適合已有 GPU 與 PyTorch 經驗的人。

  • 項目類型:training-free 影片生成加速框架,處理 DiT 影片模型推理太慢的問題
  • 方法重點:keyframes 做 dense denoising,非 keyframes 跳步處理,再用 latent trajectory projection 維持時序一致
  • 可比較方法:dense、svg、sap、rhyme、rhyme_sap
  • 相關模型:Wan 2.1 已有 adaptation,HunyuanVideo adaptation 尚未完整釋出
  • 適合場景:研究影片生成推理優化、比較不同加速策略、測試速度與畫質取捨

整體來看,RhymeFlow 的價值很明確:它不是改模型權重,也不是重新訓練,而是重排 denoising flow scheduling,從流程層面節省計算。對研究者與進階開發者而言,這類思路比單純堆硬件更有參考價值;對一般創作者來說,現階段門檻仍在部署與 GPU 環境。

GitHub: https://github.com/Simon-Dcs/RhymeFlow

Paper: https://arxiv.org/pdf/2606.06309

Categories: 開源, 清華大學, 騰訊, AI productions, 視頻模型, 模型訓練, NVIDIA, Video, 框架, Content Creator, Python, 深度學習

Page 15 of 17
1 … 13 14 15 16 17