EVA-Client 補上真實機械人部署斷層

訓練好嘅操作策略,去到真實機械人往往先開始出現混亂。EVA-Client想處理嘅,正正係部署、記錄同評測之間長期分散嘅那段流程。

EVA-Client Logo

研究團隊把模型訓練做得愈來愈完整,但一到真實機械人落地,常見情況仍然是靠零散 script、臨時橋接同各自為政嘅除錯流程撐住。EVA-Client屬於開源框架,集中處理已訓練操作策略喺真機部署、數據收集與評估之間嘅斷層,重點唔係再訓練一個新模型,而係令整個閉環更可重用。

它同一般只覆蓋單一步驟嘅工具唔同,將 transport、policy backend 同 inference strategy 放入同一套流程,支援 ROS1、ROS2、ZeroMQ 同 offline dataset,也能接 OpenPI、OpenPI-RTC、StarVLA、GR00T、mock、replay。作者明顯想修正「訓練框架成熟,但真機端仍然拼裝化」呢種既有範式,所以瀏覽器內直接整合 debug、部署、錄製、重播同比較,定位相當鮮明。

使用路徑方面,現有資料已交代可以用 .py config 串接機械人通訊、策略後端與推理策略,再透過介面喺 DEBUG、COLLECT、RESULT 分頁切換;不過完整安裝細節仍然要配合官方文件先夠穩陣。資料收集亦唔止錄影,還會保存 camera video、3D URDF scene、state charts、milestone scores,同步回放亦保留 QC PASS/FAIL 與每幀品質旗標,對做 dataset 整理同失敗分析幫助幾大。

  • 把部署、收數同評測放入同一個 browser workflow,減少真機迭代時來回切換工具
  • 支援多種 transport、backend 同 inference strategy,取向偏向兼容不同機械人與策略棧
  • 內建 live latency compensation、async strategy 同 replay,重點放喺真機穩定度而唔只係跑通
  • Teleop demos 與 model rollouts 共用同一套 on-disk layout,方便後續整理成 LeRobot v2.1 episodes

性能數字方面,現有資訊未見統一 benchmark 分數,較多是能力與流程層面的描述,所以暫時唔適合把它理解成用單一指標決勝負嘅項目。較受惠嘅會是做 VLA、VAM、WAM 或機械人操作研究嘅團隊,尤其要頻繁比較 checkpoint、遠端連 policy server、或者同時管理多款真機平台嘅場景;已列出可配合嘅相關模型與系統包括 OpenPI、OpenPI-RTC、StarVLA、GR00T,以及 LeRobot、VLA Foundry 呢類訓練側框架。
項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, NVIDIA, DeepSeek, Video, VLA, 3D, Dataset 數據集

LiveEdit:串流影片編輯走向即時化

LiveEdit 把文字指令變成串流影片編輯,重點放在速度與畫面穩定。它嘗試兼顧即時反應,以及背景與非編輯區域的保留。

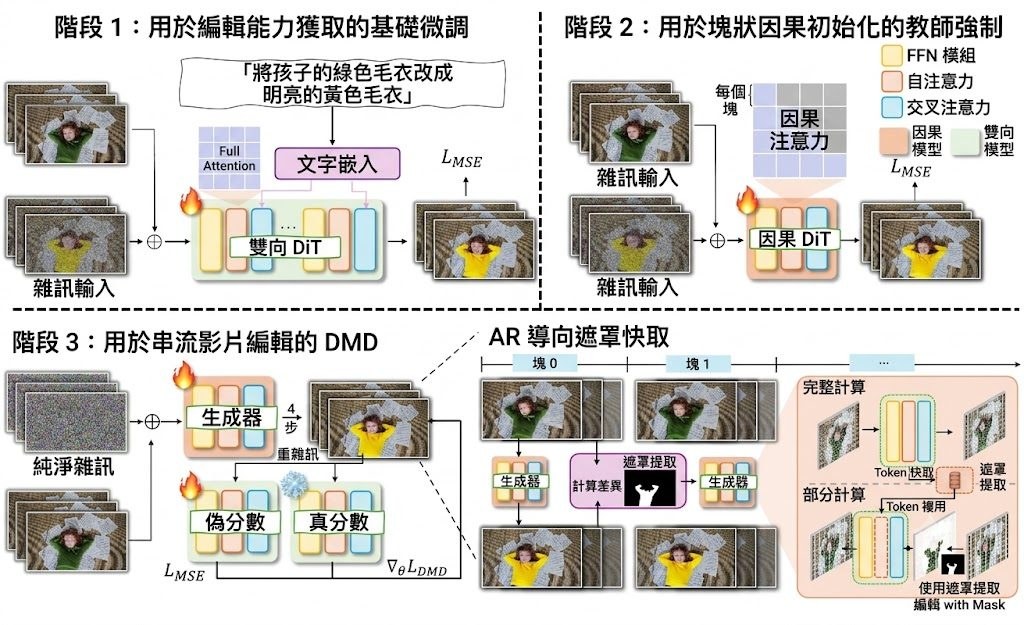
Image 1

LiveEdit 是一個 diffusion-based streaming video editing 系統,屬於影片編輯模型與方法項目。它的核心任務是根據來源影片加上文字指令,逐段完成 causal chunk-by-chunk editing,並盡量保留背景與沒有修改的區域。

這個項目不是追求離線影片慢慢算到最靚,而是針對接近即時的串流編輯。它建基於 Wan2.1 和 Self-Forcing codebase,並用 three-stage distillation,把雙向編輯 teacher 的能力轉移到串流 student,再配合 AR-oriented Mask Cache 減少重複運算,換來較低延遲。

部署與測試資訊算是完整,提供 inference scripts、training code、checkpoint instructions,也講明建議在 Linux 配合 NVIDIA GPUs 執行;單 GPU 可做 inference,多 GPU torchrun 主要用於訓練。輸入方式是準備一個 JSON,填入 source video 路徑和 instruction,然後配合已釋出的權重與 Wan2.1 base model 進行推理。

有一個相當關鍵的參考值:項目頁列出 12.66 FPS,並表示透過 4-step distilled diffusion generation 達成 real-time streaming inference。這個成績對互動式影片編輯很重要,不過公開資訊未見更完整的硬件條件、顯存需求或不同解析度下的比較,因此判斷效能時仍要保留一點。

  • 重點不是一般文字生片,而是保留原片內容的串流影片編輯
  • 主要技術包括 three-stage distillation、Causal DiT、AR-oriented Mask Cache
  • 已公開 inference 與 training 程式碼,也提供 Hugging Face checkpoint 指引
  • 已知較適合 Linux、NVIDIA GPU 環境,研究團隊或影像生成工程師較易受益
  • 相關模型與基礎包括 Wan2.1-T2V-1.3B、bidirectional editing teacher、streaming student

整體來看,LiveEdit 的價值在於把 streaming video editing 做得更接近可互動系統,而不只是展示級效果。它較適合研究即時影片編輯、互動內容製作、直播視覺處理或需要低延遲生成的團隊;一般用家若想直接在圖形介面一鍵開用,現有資料未提供管理後台整合、免手動設定流程,仍然比較像面向研究與開發者的項目。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 模型, 視覺模型, 視頻模型, NVIDIA, Video, 框架, Linux, 蘋果

WorldDirector 14B:可控影片世界模型點樣做長時記憶

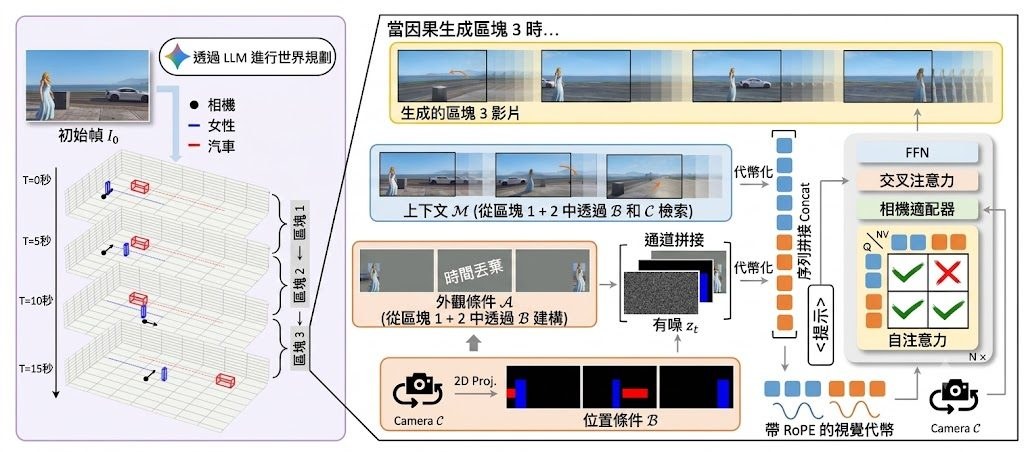
呢個項目想解決影片世界模型難以長時間記住物件身份與動作邏輯的問題。重點不在單純出片,而是把鏡頭、物件移動與一致性分開控制。

Repository image for pPetrichor/WorldDirector

WorldDirector 是一個影片世界模型框架,屬於研究原型兼開源推理項目。它的核心任務,是讓系統在生成長片段影片時,仍能記住動態物件的身份、位置變化與鏡頭運動,減少角色或物件一離開畫面就「變樣」或失去連續性的情況。

它的做法不是直接把所有事情交畀單一生成模型處理,而是先用 Large Language Model(LLM)規劃 3D 物件軌跡與相機路線,再把規劃投影成 2D 控制訊號交畀視覺生成模組。呢種拆分令項目的取向很清晰:先保住語意層面的動作因果,再處理畫面生成,因此比起只靠像素連續性的世界模型,更重視可控性、物件恆常性同長時段一致性。

目前已公開的是完整 inference code 同 WorldDirector-14B 權重,同時亦交代依賴 Torch 2.4.0、FlashAttention,以及 Hugging Face 下載模型的流程。換句話說,現階段較適合已有 GPU 環境、懂得整理 JSON 規劃輸入的人測試;它不是裝完即用的消費級工具,而較接近可重現論文結果的研究型項目。

項目展示的例子集中在人物、車輛、鏡頭切換與長時間事件編排,重點是物件暫時離開視野後再返回,外觀仍能維持穩定。公開資訊提到它支援 persistent dynamic object memory 同 unrestricted viewpoint exploration,但未見提供完整量化基準細節,因此現階段較適合把它理解為一個方向鮮明、控制力強的世界模型方案,而不是已全面驗證的通用產品。

  • 類型定位:影片世界模型框架,主打可控生成與長時記憶
  • 主要差異:把運動規劃同視覺生成拆開,先處理 3D 語意軌跡
  • 較適合情境:研究團隊、影片生成工作流、需要鏡頭與角色一致性的實驗
  • 部署理解:需先配置依賴、下載 WorldDirector-14B,並準備符合格式的 JSON 計劃輸入
  • 相關模型:WorldDirector-14B;流程中亦依賴 Large Language Model(LLM)參與動作與鏡頭規劃

整體來看,WorldDirector 最有價值的地方,在於它把「世界模擬」由單純畫面續寫,推進到可描述、可規劃、可回放的控制流程。對想研究影片 world model、角色一致性與可操控鏡頭生成的人來說,呢個項目值得留意;對只想快速出片的人,現有門檻仍然偏高。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, 世界模型, Google, NVIDIA, 3D, 蘋果

MrFlow:文字生成圖片提速新路線

MrFlow 用分階段取樣加速 flow-matching 圖像生成,重點是唔使重新訓練模型。它追求高倍提速,同時盡量守住畫面細節。

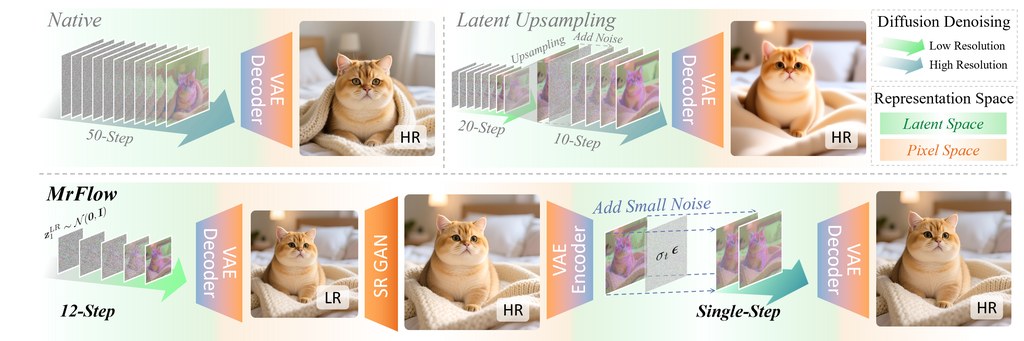
MrFlow framework

MrFlow 是一個訓練免除的圖像生成加速方法,屬於針對 flow-matching text-to-image diffusion models 的研究原型與實作。它要解決的問題很直接:高解析度出圖太慢,因此先在低解析度完成大部分生成,再用較短的高解析度修補流程補回細節。

現有多解析度加速方法,通常會在 latent space 做上採樣,或者只改動部分區域;作者認為這種固定範式容易帶來模糊感與 artifact。MrFlow 改用 pixel space 的 Real-ESRGAN 做超解析度,之後重新編碼、注入與 scheduler 一致的低強度雜訊,再做短步數 refinement,將昂貴的高解析度 denoising 成本,大幅轉移到較便宜的低解析度階段。

這個項目的取向相當務實,因為它不要求 finetuning、learned upsampler,亦唔需要 model-specific retraining 或 custom kernels,直接建立在 PyTorch、Diffusers 與既有 scheduler 控制之上。部署理解上,它比較像一條可插入現成模型流程的 sampling pipeline:先準備 Diffusers 相容環境、對應的預訓練模型權重,以及 Real-ESRGAN 的 x2 權重,再把 README 內示例腳本的 checkpoint 路徑換成本地設定即可。

效能數字是這個項目的核心賣點。資料指出,MrFlow 在 Qwen-Image 可做到超過 10x end-to-end speedup,論文亦提到相對加速前的 OneIG 差距可控制在 1% 以內;再配合 timestep-distilled models,例如 Pi-Flow 與 FLUX-schnell,整體加速可進一步去到 25x。這種設計也已展示可轉移到 Qwen-Image、FLUX.1-dev、FLUX.2 Klein 與 Z-Image family,代表它不是只綁死單一模型。

  • 類型定位:訓練免除的 staged sampling 加速方法,唔係新底模本身
  • 主要差異:避開 latent space 上採樣路線,改用 pixel space 超解析度加短程高解析度修補
  • 部署重點:依賴 PyTorch、Diffusers、Transformers、Real-ESRGAN,並需自行配置模型與權重路徑
  • 適合場景:要保留畫質、又想縮短生成時間的圖像生成團隊與研究人員
  • 相關模型:Qwen-Image、FLUX.1-dev、FLUX.2 Klein、Z-Image、Pi-Flow、FLUX-schnell

MrFlow 最適合放在已有文字生成圖片流程的項目之中,作為加速層而不是完整替代品。它的限制亦很清楚:仍然依賴外部超解析度模型與既有 backbone 品質,重點在於重新分配算力成本,未必等於所有提示詞、所有畫風都能無代價複製原本高解析度長步數生成的結果。

GitHub · Paper

Categories: 開源, Qwen, NVIDIA, Stable Diffusion, Image, txt2img, Python, 中國

AnyGroundBench 點出影片定位模型盲點

AnyGroundBench不是新模型,而是專門測試影片理解能力的 benchmark。它把專業場景放入同一套規則,直接揭示現有 VLMs 的適應落差。

Repository image for rinost081/AnyGroundBench

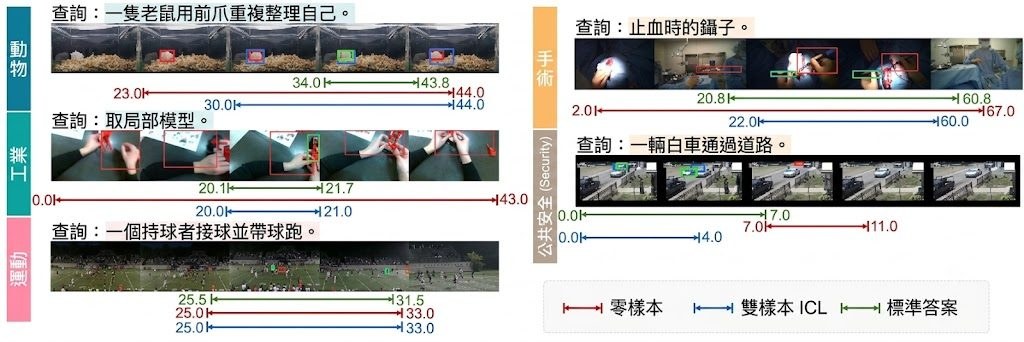
AnyGroundBench 是一個影片 grounding benchmark,也是面向專業領域的資料集與評測基準。它主要用來測試 Vision-Language Models(VLMs)在 animal、industry、sports、surgery、public security 幾類場景中,能否把文字描述準確對應到影片中的時間、位置,以及時空同時發生的事件。

現有做法多數停留在 general、daily-life benchmark 的 zero-shot 測試,重點是看模型有沒有通用理解力;作者認為這種範式無法反映專門場景,因為稀有視覺概念、複雜動作關係與領域術語,通常不會在通用資料裡被充分學到。AnyGroundBench 因而把評測重心轉去 domain adaptation,並加入 dedicated training subsets,令測試不再只問模型「有沒有見過」,而是進一步量度它「能不能適應新領域」。

這個項目的差異,在於它把 temporal、spatial、spatio-temporal annotations 用統一方式整理,並混合 newly captured videos 與 existing datasets。資料來源涵蓋 mouse、american_football、Animal-Kingdom、MECCANO、EgoSurgery 等,覆蓋面比單一領域 benchmark 廣,亦更接近研究團隊、產業分析、醫療影像研究與安全監測場景會遇到的資料分佈。

項目提供 Hugging Face dataset、project page:這不是即插即用應用程式,而是供研究與模型比較的 benchmark。部署重點不是介面安裝,而是按 domain 讀取整理後的資料,然後以 STVG、TVG、SVG 三類任務跑推理與評分;指標分別用 vIoU@0.3、tIoU@0.3、sIoU@0.3。

  • 類型屬於 benchmark / 資料集,目的是測量 VLMs 的 specialized-domain video grounding 能力
  • 舊範式以 zero-shot general benchmark 為主,新設計改為檢查 domain adaptation 與 In-Context Learning(ICL)是否真的有效
  • 評測涵蓋 temporal、spatial、spatio-temporal 三層,較容易看出模型究竟是看錯時間、找錯位置,還是兩邊都失準
  • 已評測 15 個 state-of-the-art VLMs,結果指出現有模型在 specialized domains 的 zero-shot 與 ICL 表現都不穩定

建議模型包括 GPT-4o、GPT-5.1、Gemini-2.5-Flash 等 proprietary VLMs;現有結果顯示,加入 2-shot ICL 雖然在部分 domain 有改善,但整體仍未解決 specialized-domain spatio-temporal reasoning 的缺口。對研究 VLM evaluation、video grounding、視覺模型遷移能力的團隊來說,這個項目最有價值的地方,是它把「通用測試看似可用」與「專業場景仍然失手」之間的差距量化出來。

項目主頁 · GitHub · Paper

Categories: 開源, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, OpenAI, Gemini, Video, 安全, Dataset 數據集

MemoBench 點樣測世界模型記憶力

MemoBench專門檢查世界生成模型會否在物件離鏡後再出現時「記錯樣」。它用V-D-R流程,把畫質、一致性與語意判斷拆開量度。

Repository image for MemoBench-Team/MemoBench

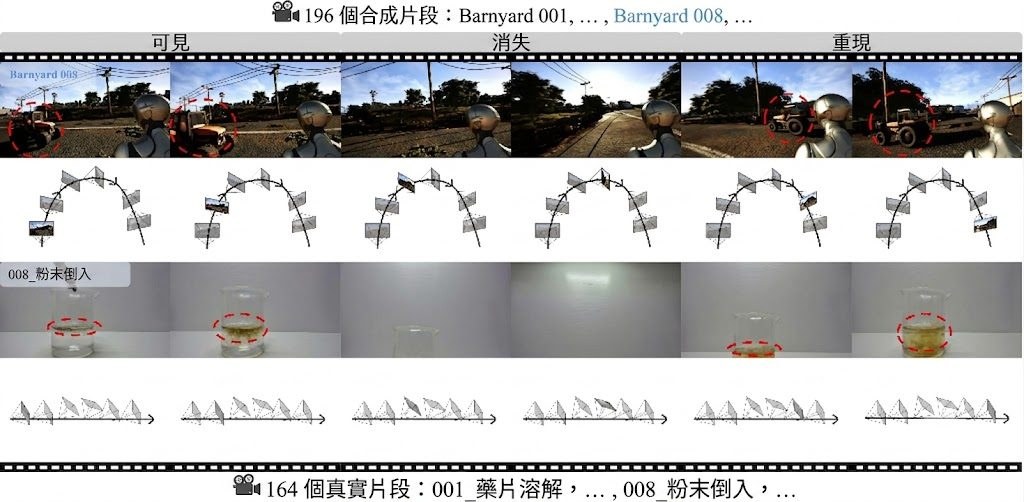
MemoBench 是一個 benchmark,屬於用來評測 world generation models 的數據集加評測工具組。它主要檢查模型在鏡頭移開再回來之後,能否把同一個物件的外觀、位置與狀態準確重建,而不是只生成一段看似流暢的影片。

現有影片生成或世界模型評測,很多時集中在畫質、動作流暢度,或者短時間一致性;作者認為這類範式未必能測到 visual memory。MemoBench 因此用 V-D-R (Visible → Disappeared → Reappear) 結構重組任務:先見到目標物件,再讓它離開視野,最後要求模型在重返視野時保持物件永久性與幾何一致性,這比單看首尾畫面更接近真正的記憶測試。

資料部分有 360 段片,分成 196 段 synthetic 與 164 段 real-world clips,並提供 V-D-R 邊界、GT camera poses、目標物件文字描述、VQA question banks 等配套。部署思路相當清楚:環境以 Linux、Python 3.11、CUDA GPU 為主,評測流程分成自動指標、Object Revisit Score (ORS),以及 VQA 三步,輸入格式是逐格 PNG 圖片;camera controllability 會用到 MapAnything,ORS 會用到 SAM-3。

它和同類 benchmark 的差異,不在於片段數量特別大,而在於把「物件消失後再出現」設成核心壓力測試,並同時覆蓋 synthetic 與真實場景。14 項指標亦不是只量畫面好不好看,還會看 temporal consistency、geometric fidelity、object permanence、camera controllability,以及 VQA-based reasoning,取向明顯偏向診斷模型缺口,而不是只做單一排行榜。

  • 適合比較 不同 world generation models 在長時序記憶上的穩定度
  • 測試材料完整,包含 phase 邊界、相機姿態、文字提示與 VQA 題庫
  • 評測角度較細,把低階畫質與高階語意一致性分開量度
  • 部署門檻不算低,需要 Linux、CUDA GPU,亦依賴 MapAnything 與 SAM-3

相關模型方面,官方內容提到已基準測試 8 個模型,但這份儲存庫摘要未列出完整名稱,因此較穩妥的理解是:MemoBench 重點不是提供新模型,而是提供一套可重覆的記憶一致性測試基準。對研究 world modeling、影片生成、camera-controlled generation 的團隊尤其有參考價值,因為它能幫你分辨模型是「畫得靚」,還是真正記得之前見過什麼。

項目主頁 · GitHub · Paper

Categories: Google, NVIDIA, Image, 框架, Linux, Python

SimFoundry:單段影片變機械人模擬場景

這是 NVIDIA 的 real-to-sim 項目,可把真實場景影片自動轉成可互動模擬環境。它主打機械人策略訓練、評測與 sim-to-real 遷移。

Digital twin and cousins of the wooden drawer organizer

這是一個由 NVIDIA Research 推出的 robot learning 項目。它的主要用途是把單一真實場景的圖片或影片,自動轉成可供機械人策略訓練與評估的互動式 simulation environment,減少真實世界收集數據與反覆測試的成本。

SimFoundry 的核心做法是建立 modular and automated 的 zero-shot real-to-sim pipeline,從單一影像或影片生成 sim-ready digital twins,並支援 object、scene 與 task editing。除了重建原場景,系統亦可自動產生多種 digital cousins,讓同一個任務在不同物件配置、場景條件或操作要求下擴展訓練資料,提升策略泛化能力。

和常見要大量人工建模、手動調參或依賴多視角掃描的做法相比,這個項目強調以較低輸入門檻快速建立可用模擬場景。頁面亦提到 hybrid scene 表示方式,結合 3D Gaussian Splat 背景與 textured object meshes,重點不只在視覺重建,而是要讓場景可直接用於 policy learning and evaluation。

重點摘要:
– 以單一 image 或 video 建立 real-to-sim 場景
– 可生成 sim-ready digital twins,並編輯 object、scene、task
– digital cousins 有助擴充訓練變化,改善 sim-to-real 泛化
– 在 7 個 manipulation tasks、5 個 policies 上,simulation evaluation 與真實表現高度相關
– object、scene、task cousins 分別帶來平均 17%、21%、50% 任務成功率提升

評測結果顯示,SimFoundry 在 7 項 manipulation tasks 與 5 個 policies 上,simulation evaluation 對真實世界表現具有很強預測力,mean Pearson correlation 為 0.928,mean maximum ranking violation 為 0.018;用於評估真實策略時,頁面亦列出 mean Pearson correlation 0.911。文中提及的策略包括 DreamZero、Gr00t N1.7、π 0.5,顯示這個項目適合用於機械人操作研究、policy benchmarking,以及想以較低成本建立可重複測試流程的團隊。

項目主頁 · Paper

Categories: 模型訓練, NVIDIA, Video, Robotic, 3D

PhysisForcing 提升機械人世界模擬可靠性

這是一個強化影片生成物理一致性的訓練框架,用來改善機械人操作模擬的可信度。

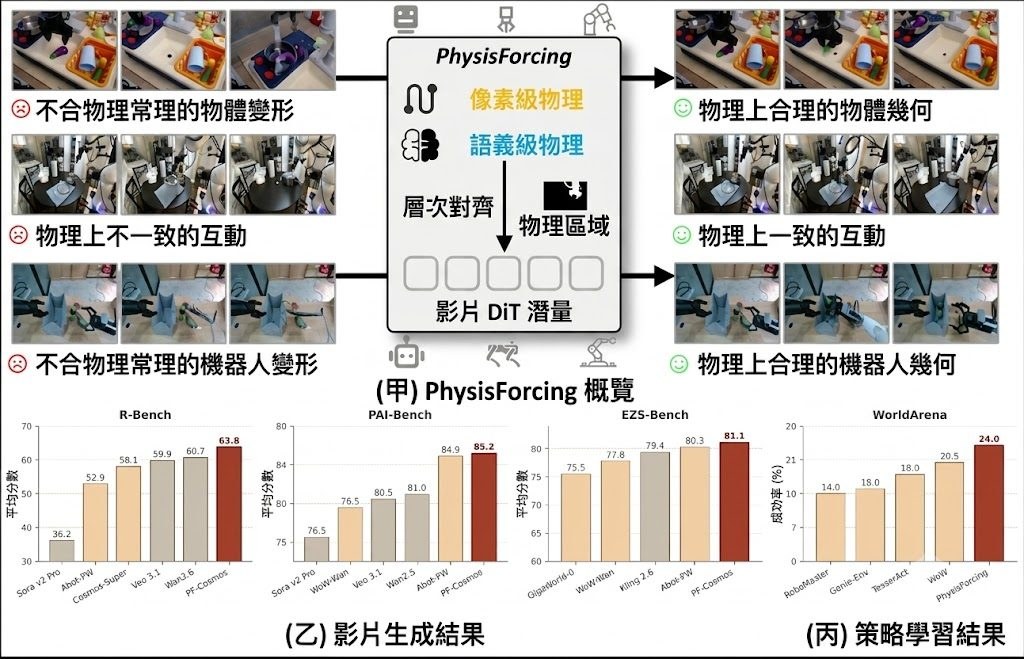
Teaser Figure

這是一個用於機械人操作的世界模擬訓練框架,名為 PhysisForcing。它主要解決影片生成模型在模擬抓取、推動與物件互動時,常出現動作軌跡不連續、物件變形和互動不合物理規律的問題。

PhysisForcing 的做法不是單靠生成更像真的畫面,而是把訓練重點放在與物理相關的區域,並同時加入像素層與語意層兩種約束。像素層的 trajectory alignment loss 會用參考點軌跡監督 DiT features,語意層的 relational alignment loss 則利用凍結的影片理解編碼器,對齊區域之間的互動關係,令機械臂與物件之間的時空關聯更穩定。

和一般通用影片生成模型,或只針對機械人資料做微調的方法相比,這個框架更集中處理「物理合理性」而非單純畫面觀感。它可套用在標準 diffusion video backbones 之上,已展示於 Wan2.2-I2V-A14B 與 Cosmos3-Nano 這兩個基礎模型。

  • 核心重點是分層物理對齊:同時改善運動一致性與互動關係一致性
  • 適合用於 embodied world simulation、robotic manipulation 與下游動作規劃
  • 在 R-Bench、PAI-Bench、EZS-Bench 都較強基線有提升
  • R-Bench 上,Wan2.2-I2V-A14B 提升 +22.3%,Cosmos3-Nano 提升 +9.2%
  • 納入 WorldArena action-planner protocol 後,closed-loop success rate 由 16.0% 升至 24.0%

這項工作對需要用影片模型做機械人訓練、模擬驗證或策略學習的人較有參考價值,因為它不只改善生成片段的外觀,亦提升作為 world model 的可用性。現有資料顯示,物理對齊後的影片表徵亦能帶動下游 policy success,說明這類方法不只是視覺修飾,而是直接影響機械人操作結果。

項目主頁 · Paper

Categories: 開源, 北京大學, 模型, 視頻模型, 世界模型, 模型訓練, NVIDIA, Video, Robotic, 框架

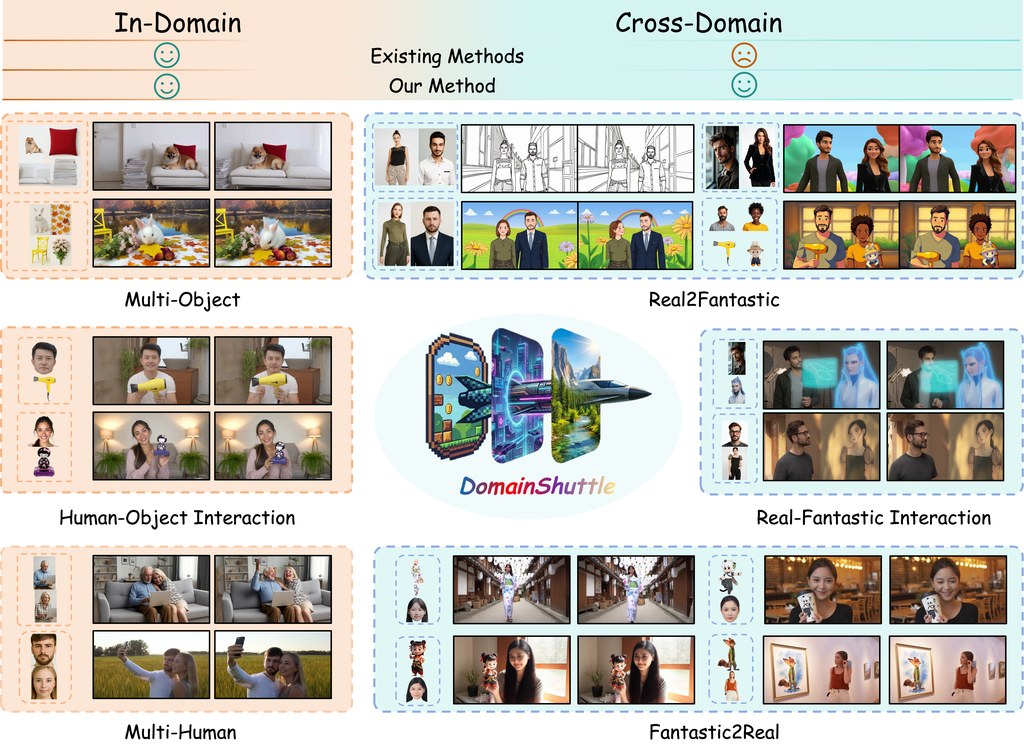
DomainShuttle 開源:把主角穿梭到任何風格的影片

香港科技大學 C4G 團隊發表 DomainShuttle,以 14B 參數規模實作跨域主體一致性影片生成,並釋出權重與推理代碼。

teaser

DomainShuttle 是一個以 Wan2.2-T2V-A14B 為基底的 subject-driven text-to-video(主體驅動文字轉影片)框架,目標是讓用戶提供一張參考圖後,能在不同視覺風格與場景中維持同一角色的身份一致性。過去的 subject-driven 方法多在 in-domain(與訓練資料同域)下能保留主體細節,但一旦跨域到風格差異大的場景,主體往往走樣或失去身份特徵;DomainShuttle 把參考特徵與影片特徵解耦,並引入 domain attribute 建模與 intrinsic subject representation,試圖兼顧 in-domain fidelity 與 cross-domain editability。

開發團隊來自香港科技大學 C4G 實驗室,作者群包括 Nan Chen、Yiyang Cai、Rongchang Xie、Junwen Pan、Cheng Chen、Weinan Jia、Zhuowei Chen、Wen Zhou(項目負責人)、Zhenbang Sun 以及通訊作者 Wenhan Luo。等貢獻作者共同發表技術報告,並同時釋出 14B 規模的非官方權重與推理代碼。

先以 conda 建立 Python 3.10 環境並安裝 PyTorch 2.5.1(CUDA 12.4),接著執行 build_env_conda.sh。模型準備分兩步:先用 huggingface-cli 下載 Wan-AI 的 Wan2.2-T2V-A14B 作為基底模型,再下載 CNcreator0331/DomainShuttle_weight,最後將 VAE、configuration.json 等檔案移入指定的 ./models/Diffusion_Transformers/Wan2.2-DomainShuttle-A14B/ 目錄。原始資料未提供完整推論指令片段,相關細節需參考技術報告與項目頁面的後續說明。

從示範結果看,DomainShuttle 能在寫實人物、動漫風、Ghibli 風、3D 動畫風等不同域之間切換,同時保留臉部與服飾特徵,跨域 personalisation 效果明顯。適合短片創作、角色 IP 化、廣告分鏡與動畫預覽等需要「同一角色穿梭多場景」的團隊。需注意目前釋出的是非官方實作,且依賴 14B 規模的基座模型,部署對顯存要求較高。

重點摘要:

  • 類型:subject-driven text-to-video 框架,建基於 Wan2.2-T2V-A14B
  • 開發團隊:香港科技大學 C4G 實驗室,Wen Luo 為通訊作者
  • 核心設計:解耦參考與影片特徵、加入 domain attribute 與 intrinsic subject representation
  • 與同類差異:強調 cross-domain editability,補足過往方法跨域走樣的缺陷
  • 資源:已釋出 14B 權重、技術報告與推理代碼,需 CUDA 12.4 環境

GitHub: https://github.com/HKUST-C4G/DomainShuttle

項目主頁: https://cn-makers.github.io/DomainShuttle/

模型: https://huggingface.co/CNcreator0331/DomainShuttle_weight

Categories: 開源, 香港科技大學, 模型, 視覺模型, 視頻模型, NVIDIA, Stable Diffusion, Video, 框架, 香港, Content Creator, IDE, 3D, Python NLP, Python, 動畫

Unlimited-OCR:長文件 OCR 新取向

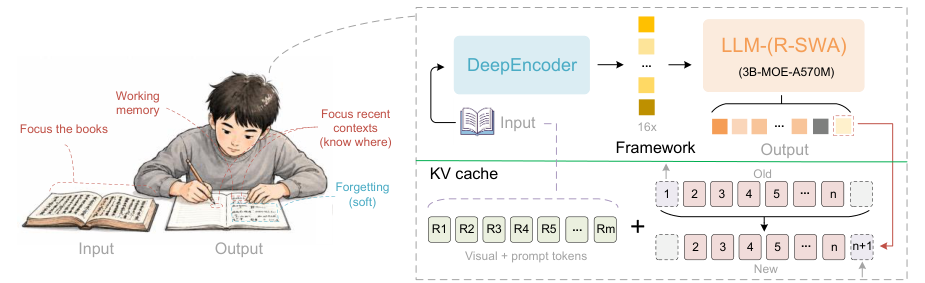
這是一個主打長篇文件解析的 OCR 模型項目。它針對多頁、長輸出內容時速度與記憶體壓力變大的問題作出調整。

Baidu Inc.

Unlimited-OCR 是一個 OCR 視覺文字辨識模型項目,也可視為一個針對長文件解析而改造的研究原型。它主要用來把圖片或 PDF 內的大量文字與版面內容一次過轉成可輸出的解析結果,重點是處理多頁文件時盡量減少記憶體負擔。

現有 end-to-end OCR 做法以 DeepSeek-OCR 為代表,會用 large language model(LLM)作 decoder,優點是能借助語言先驗提升辨識效果,但輸出一長,KV cache 會一路累積,令顯存需求上升、生成愈來愈慢。Unlimited-OCR 的做法是保留高壓縮 encoder,再把 decoder 的 attention 層改成 Reference Sliding Window Attention(R-SWA),讓每個 token 持續關注 reference tokens 與有限長度的前文,目標是把 KV cache 維持在常數規模。

這個取向最值得留意的地方,不是單純追求單頁最高精度,而是把「one-shot long-horizon parsing」放在核心位置。跟一般 full attention 比,它犧牲的是傳統全域注意力形式,換來多頁文件在 32K 長度下仍可做單次 forward pass;跟 vanilla SWA 比,它又保留 visual tokens 作為穩定參照,避免狀態傳遞後愈來愈模糊。

部署路線相當明確:項目提供 Hugging Face Transformers 推理方式,測試環境寫明需 NVIDIA GPU,並以 Python 3.12.3、CUDA 12.9 為基礎;單張圖片可在 gundam 與 base 兩種設定中選擇,多頁與 PDF 則使用 base 配置。想先了解效果,也可直接看 Hugging Face Spaces demo 或 ModelScope 版本,再決定是否自行落地。

  • 類型定位:OCR 模型/研究原型,解決長文件、多頁解析時記憶體與速度惡化問題
  • 核心差異:以 Reference Sliding Window Attention(R-SWA)取代 decoder 全部 attention layers
  • 適合情境:長 PDF、批量文件數碼化、需要版面解析與長輸出的團隊
  • 相關模型:DeepSeek-OCR、Unlimited-OCR;文中亦提到 R-SWA 可延伸到 ASR、translation
  • 限制判斷:目前公開資訊主力放在推理與方法設計,具體評測數字仍要回看 arXiv 論文原文才適合作更細比較

對需要處理保單、報表、掃描檔、書籍或多頁行政文件的團隊,這個項目的吸引力會比一般單頁 OCR 更高。若你的工作重點是短文字截圖、手機快拍辨識,Unlimited-OCR 的優勢未必完全發揮,但對長輸出穩定性與部署在 GPU 環境的可行性,它展示了一條很清楚的改良路線。

GitHub: https://github.com/baidu/Unlimited-OCR

Paper: https://arxiv.org/pdf/2606.23050

Categories: 開源, 模型, 視覺模型, NVIDIA, DeepSeek, Image, Python NLP, Python, Meta, 百度

Page 14 of 17
1 … 12 13 14 15 16 17