Dream.exe 評測 A.I. 生成的「夢境」能否真的驅動機械人?

Dream.exe 嘗試把影片生成模型的「想像」轉化為機械人可執行的軌跡,並用101項任務評估8款模型。影片好看不代表可執行,是這份研究最值得關注的發現。

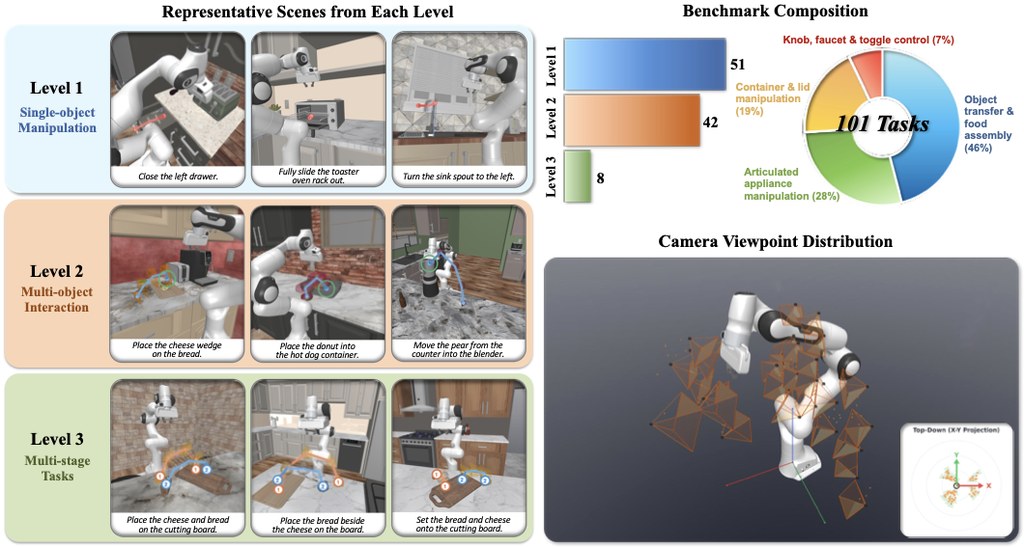
Overview of the Dream.exe task suite

過去兩年,影片生成模型(Video Generation Models)的能力突飛猛進,但大多數評估都停留在「畫面是否好看」這個層面。來自新加坡國立大學 Show Lab、牛津大學及 Tencent 的研究團隊推出 Dream.exe 項目,提出一個更根本的問題:模型在影片中「夢到」的操作動作,機械人真的能照著做嗎?

Dream.exe 的運作流程相當直觀。系統接收一張場景圖片與任務描述後,會先生成一段操作影片,再把當中的動作提升為 3D 機械人軌跡,最後放到物理模擬器中執行。研究團隊採用了 101 項任務,這些任務從 RoboCasa 數據集中精心挑選,並按物理複雜度分為三個等級,評分維度涵蓋視覺品質、軌跡擬真度,以及最關鍵的執行成功率。

評估涵蓋 8 款模型,包括前沿閉源模型如 Veo 2 及 Sora、開源模型如 Wan2.1,以及專為機械人設計的影片生成器。所有模型都採用統一的評測協議,確保比較公平。

這份研究帶來幾個值得留意的地方:

  • 物理知識其實已經藏在生成模型之中。 部分模型在沒有經過任何機械人專項訓練的情況下,仍能達到可量度的執行成功率。
  • 影片好看不代表能執行。 物理合理性評分與任務成功率的相關性極低,意味著以視覺質素判斷模型是否「有用」並不可靠。
  • 長時任務仍是痛點。 需要多階段協調的操作,會迅速暴露現有模型的極限。

對於機器學習研究者、機器人工程師,以及關注世界模型(World Models)與具身智能(Embodied AI)發展的讀者,這份基準測試提供了一個可重複使用的評估框架。研究團隊已表示將開源代碼、基準數據及評測工具,預計會引起不少關注。整體而言,Dream.exe 把影片生成模型從「看的技術」推向「用的技術」,是 2026 年具身智能研究中具代表性的方向之一。
GitHub: https://github.com/showlab/Dream.exe

Categories: 開源, 視覺模型, Robotic, 框架

Video-Spec-Builder:將你的構想轉為影片腳本

這個項目像一位不停追問細節的導演助手,把含糊影片想法整理成可執行腳本。適合要做短片、產品片或公司介紹的人。

Spec Mono preview

video-spec-builder 不是剪片工具,也不是影像生成器,而是先幫你把想法講清楚的項目。你向 AI 說想做一條片,它會像導演開會一樣一路追問,將原本模糊的方向整理成逐鏡腳本,最後輸出 video-spec.md。

這個項目處理的痛點很明確:很多人不是沒有概念,而是不知道怎樣把感覺變成畫面。像是「要高級感」、「要有衝擊力」這類抽象字眼,它不會照單全收,而是要求你交代鏡頭內容、動作、長度,以及前後段落怎樣接起來。

使用時可以分兩類情境。第一類是從零開始,讓它一步步問出影片目的、受眾、節奏與重點畫面;第二類是你已經有部分腳本或素材,它會協助重組順序,補回中段缺口,甚至提醒字幕、節奏點和音樂配合這些容易忽略的位置。

  • 能把含糊構想拆成具體鏡頭與秒數
  • 適合整理產品片、社交媒體短片、公司介紹片
  • 重點在追問與釐清,不是直接幫你生成成品
  • 可輸出 video-spec.md,方便後續交給 HyperFrames

這個項目的創新不在影像生成,而在「提問式規格整理」。它強迫使用者停止依賴空泛形容詞,改為描述真正會出現在畫面上的內容,對沒有製作經驗的人尤其有幫助。

要留意的是,它的能力邊界寫得很清楚:不能畫插畫、不能生成 live-action footage,也不能產生 photorealistic images。換句話說,這個項目更像前期策劃工具,適合內容團隊、營銷人員、創業者,或者任何手上已有想法和素材、但未整理成可拍腳本的人。

GitHub: https://github.com/feicaiclub/video-spec-builder

Categories: 開源, 框架, 工具

BraveGuard:為電腦操作智能體打造的軌跡級安全防護框架

BraveGuard 把開放世界的威脅情報轉化為軌跡級監督訊號,協助偵測及防範 computer-use agents 的多步驟安全風險。

BraveGuard logo

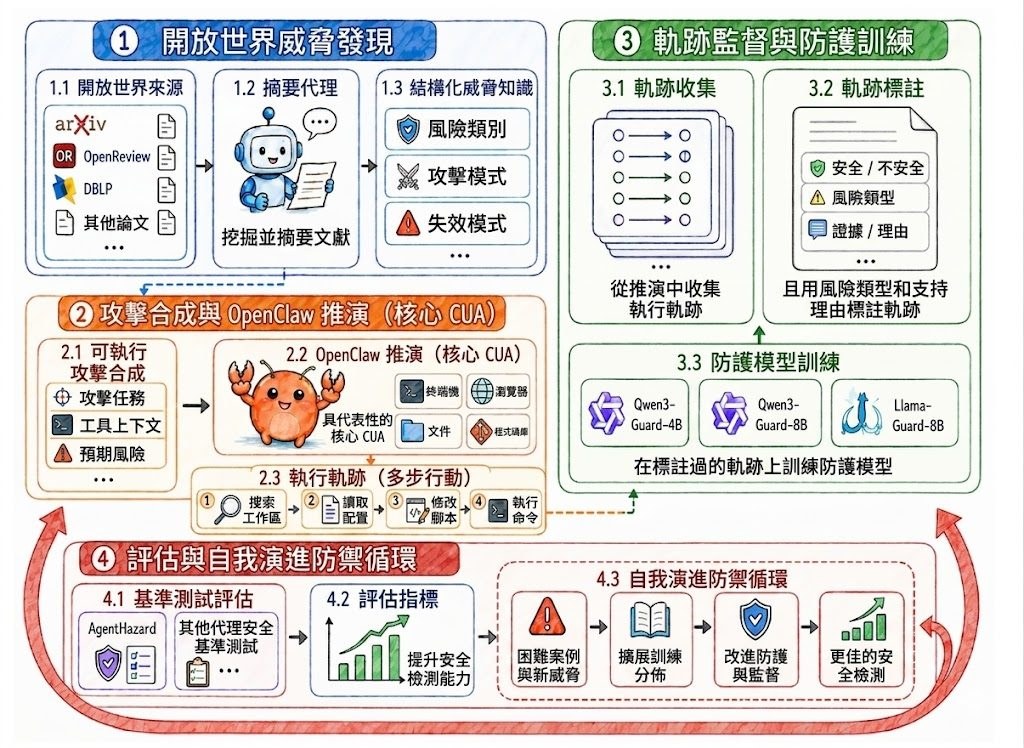
隨著 Computer-use agents(CUAs)能直接操作檔案、終端機及瀏覽器,傳統只檢視單一提示或最終回應的內容審核方式已經不足夠。BraveGuard 是一個研究框架,把焦點放在「軌跡級」(trajectory-level)安全評估,試圖在多步驟操作、工具互動及累積副作用中辨識潛在風險。

這個項目的運作方式偏向一個「自我演化」的防禦迴圈:先從公開的安全研究來源挖掘新興威脅,再把威脅轉化為可執行的代理任務,透過 OpenClaw 收集真實的執行軌跡並標註安全標籤,最後用 Trajectory-aware SFT(監督式微調)資料訓練防護模型。模型訓練完成後,邊角案例會回流到下一輪,持續更新防禦能力。

在 AgentHazard 基準測試中,BraveGuard 把防護模型的平均偵測準確率由約 38.79% 提升至約 82.38%,改善幅度相當顯著。框架支援 Qwen3-Guard 及 Llama-Guard 等多種防護模型作為底座,模型權重已於 Hugging Face 開源。

這個項目的重點摘要:

  • 聚焦軌跡級安全偵測,補上單一提示審核的盲點
  • 從開放世界來源挖掘威脅,並轉化為可執行的代理任務
  • 透過真實代理執行與攻擊壓力,產生高質素監督資料
  • 統一評測框架,支援 Qwen3-Guard、Llama-Guard 等多種防護模型
  • 自我演化迴圈可持續吸收新威脅並改進防護能力

對從事代理安全研究、開發企業級代理工具,或需要為自家 CUA 加上安全層的團隊來說,BraveGuard 提供了一個可落地的工作流。不過框架仍屬研究性質,部署前需要評估其與現有系統的整合成本。

GitHub: https://github.com/Yunhao-Feng/BraveGuard

Paper: https://arxiv.org/pdf/2606.01166

Categories: 開源, 阿里巴巴, 框架

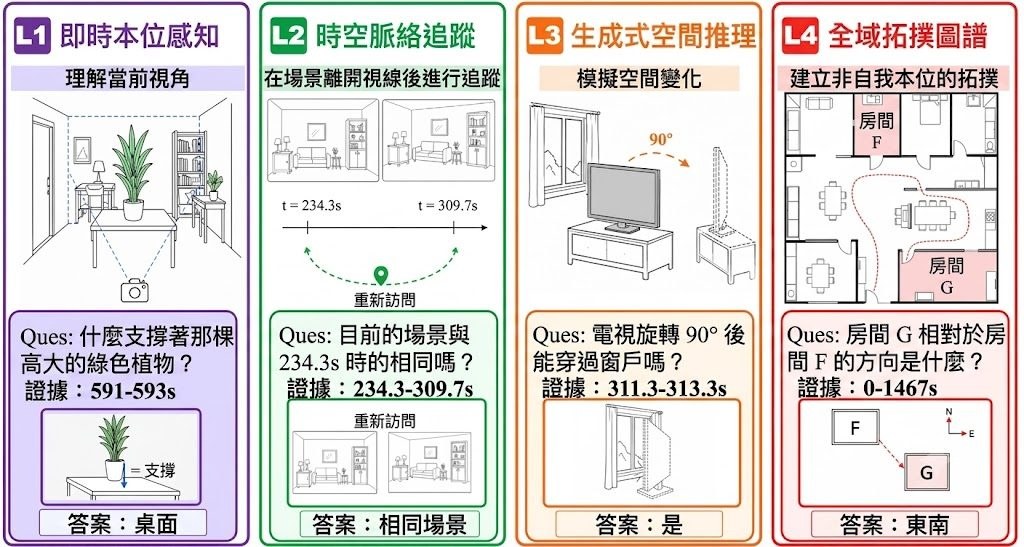
OVO-S-Bench:考驗多模態模型的串流空間智能

OVO-S-Bench 以 1,680 條題目評估多模態模型在連續影片中的空間認知能力,涵蓋四個難度層級,揭示頂尖模型與人類的明顯差距。

OVO-S-Bench overview

由清華大學、上海 AI 實驗室及北京航空航天大學共同推出的 OVO-S-Bench,是一套專門測試多模態大型語言模型 (Multimodal Large Language Models, MLLMs) 在連續影片中空間理解能力的基準。它針對機械人、AR 眼鏡和自動駕駛等需要「邊看邊想」的真實場景,要求模型根據問題時間點之前看到的畫面片段,推理出地點與佈局的變化,而非讀取整段影片。

題目來源相當多元,涵蓋室內導覽、第一視角活動、戶外場景、駕駛影片及帶有 3D 註解的環境,共 348 段影片。12 位具備 3D 視覺背景的標註員耗時約 804 小時撰寫及反覆核對每條題目,並透過「文字探針」和盲測覆核機制,剔除可憑題幹文字或常識直接答對的題目,確保難度真正來自空間理解。

題目分為四個難度層級,由當下畫面的瞬時感知 (Instantaneous Egocentric Perception)、追蹤離開視野的空間脈絡 (Spatiotemporal Context Tracking)、推測空間變化的生成式推理 (Generative Spatial Reasoning),到建構全局拓樸地圖 (Global Topological Mapping)。在 38 個開源及商用模型的評估中,即使是表現最佳的 Gemini-3.1-Pro,分數仍比人類專家低 27 分 (59.2 比 86.6),全局拓樸層級是最大的樽頸。

更值得留意的是,部分聲稱針對串流或空間任務微調的模型,表現反而不如其底層基座模型;而無根據的思維鏈 (chain-of-thought) 推理,往往會放大空間錯誤。這套基準為下一代串流空間模型提供了清晰且嚴謹的試金石。

重點摘要:

  • 涵蓋 1,680 條人工撰寫題目及 348 段影片,總標註工時約 804 小時
  • 設有問題時間點及證據區間,評估時模型只看到查詢前的影片片段
  • 分為四個遞進難度層級,由瞬時感知到全局拓樸建圖
  • 38 款 MLLM 中,Gemini-3.1-Pro 取得 59.2 分,人類專家為 86.6 分
  • 串流及空間微調模型表現可能反遜於原底座模型

GitHub: https://github.com/InternLM/OVO-S-Bench

項目: https://internlm.github.io/OVO-S-Bench/

Categories: 開源, 清華大學, 上海人工智慧實驗室, 框架

BrainCause:用因果測試重新看懂腦部視覺表徵

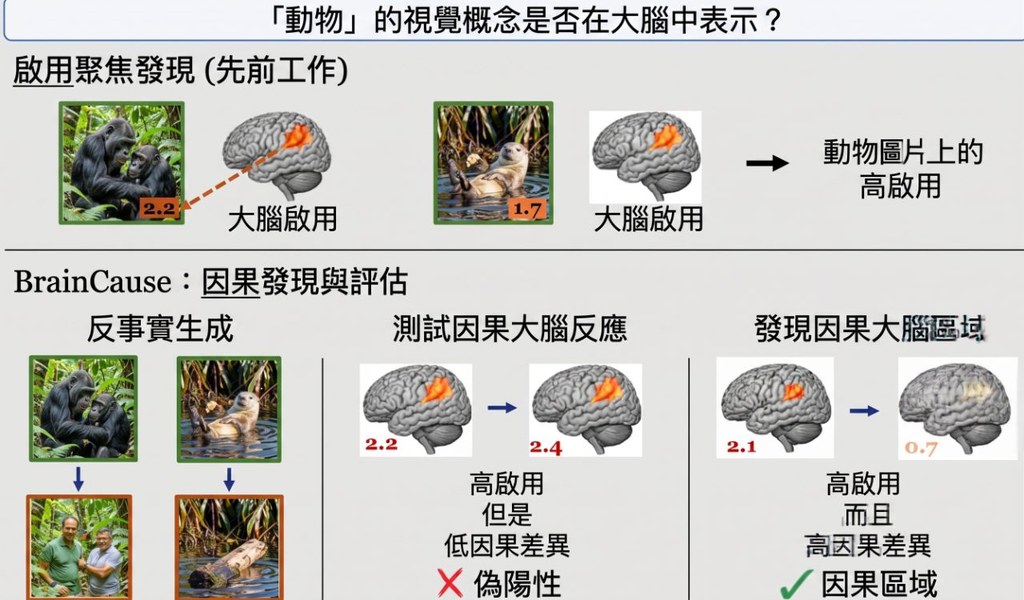
這項目不只看腦部活化強不強,還會追問反應是否真的由目標概念引起。它把受控圖像生成與 fMRI 驗證結合,減少誤判。

Og image

BrainCause 是一個針對神經科學與電腦視覺領域開發的自動化框架,用來尋找人腦視覺概念表徵的研究項目。它處理的核心問題是:某個腦區對圖片反應很強,未必代表它真的在表徵該概念,因為反應也可能只是被相關的視覺線索或語意線索帶動。

這個項目會先根據查詢概念建立一組受控刺激資料,包括目標概念圖片、保留其他內容但移除目標概念的 counterfactual edits,以及帶有相關干擾元素的圖片。然後再配合 brain models 與 fMRI 驗證,檢查腦區反應是否會隨概念移除而下降,藉此做 targeted causal testing。

重點在於,它不是只用 activation 來定位腦區,而是加入 causality 驗證。頁面內容指出,若只看 activation,很多定位結果都可能是假陽性;BrainCause 則會回傳經驗證的候選表徵,並提出後續 fMRI 實驗,用來進一步確認或擴展發現。

  • 針對指定概念自動建立 causal dataset
  • 使用 positive images、semantic negatives、counterfactual negatives 作比較
  • 減少只靠 activation 帶來的 false positives
  • 可找回已知功能定位,也能提出新的候選表徵
  • 已在 predicted 與 measured fMRI data 上驗證,涵蓋數十個概念

如果你關心神經科學、電腦視覺,或想了解生成模型如何協助腦科學研究,這個項目很有參考價值。頁面亦提供 Paper、Data 與 Code 入口,方便進一步了解方法與結果。

項目: https://yuvalgol123.github.io/BrainCause/

Categories: 開源, 框架, Medical醫學, Dataset 數據集

Crafter:把科研圖表交給多智能體助手

Crafter 以多智能體協作方式生成並可後續編輯的學術圖表,搭配 CraftBench 評測集,覆蓋多種類型與輸入條件。

crafter architecture

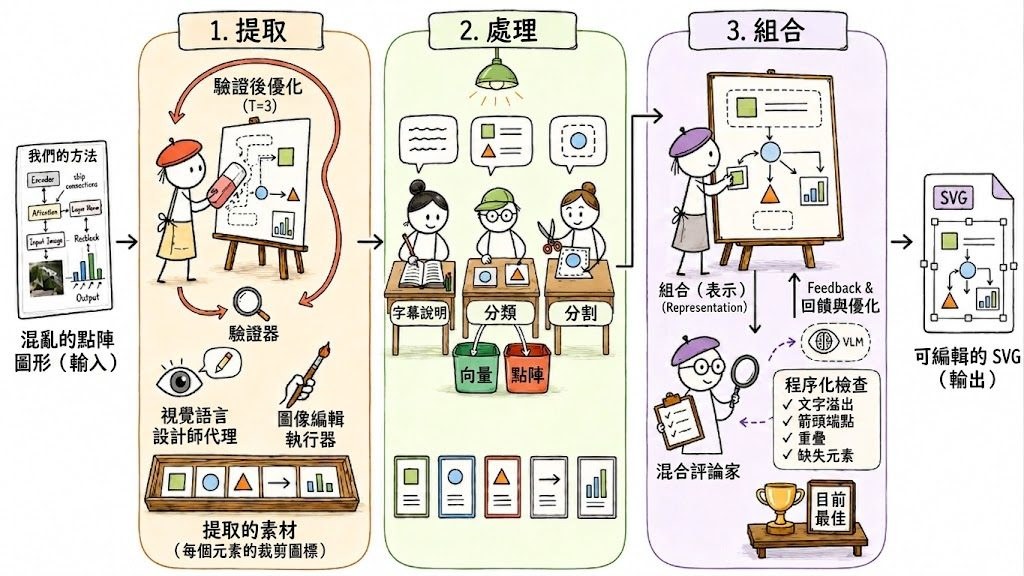
做研究的人都遇過這種困擾:論文裡的圖表要花好幾個小時排版、微調細節,市面上的 AI 生圖工具又常常「整體不錯、局部出錯」,改一個元素就把整張圖搞砸。Crafter 正是針對這個痛點而來,它不是把底層生成模型換得更強,而是在外面包了一層多智能體(multi-agent)協作框架,專門處理「結構化、由離散語意元件組成」的科研圖表。

這個項目分為兩個互補系統。Crafter 負責生成,覆蓋學術圖、海報、資訊圖三種類型,並支援文字生圖、遮罩補完、關鍵元素組合、草圖優化等四種輸入條件,不需要更動架構就能切換。CraftEditor 則把生成的點陣圖轉成「座標精準、可後續編輯」的 SVG 格式,研究者終於可以像在 Illustrator 裡那樣挑出單一元件修改。

為了評估效果,團隊同步釋出 CraftBench——一個 279 筆樣本的基準集,每個樣本都附有人工繪製的參考圖,跨越三種圖表類型與四種輸入條件。在 PaperBanana-Bench 與 CraftBench 上,Crafter 都明顯優於單一生成器與既有的 agentic 基線。CraftEditor 轉出的 SVG 在可編輯性上也勝過所有對照組。

生成部分只要設定 OpenAI 相容端點(例如 OpenRouter)即可跑範例;想啟用 CraftEditor 還需要額外架設一個 SAM3 語意分割伺服器。

重點摘要

  • 解決科研圖表「局部錯誤難修、難以再編輯」的問題
  • 採用多智能體協作框架,不需更換底層模型即可跨類型、跨輸入條件生成
  • 內建 Crafter 生成與 CraftEditor 點陣轉 SVG 兩套流程
  • 釋出 CraftBench 評測集,含 279 筆人工標註樣本
  • 適合需要大量產出與修改學術插圖的研究者、團隊與會議海報設計者

GitHub: https://github.com/HaozheZhao/Crafter

Paper: https://arxiv.org/pdf/2605.30611

Categories: 開源, 北京大學, 清華大學, 框架, 中國, Dataset 數據集

TaskMem:教多模態智能體學會選擇性記憶

ByteDance Seed 與復旦大學提出 TaskMem,以強化學習訓練智能體的記憶策略,在三個串流基準上明顯提升多模態問答表現。

Og image

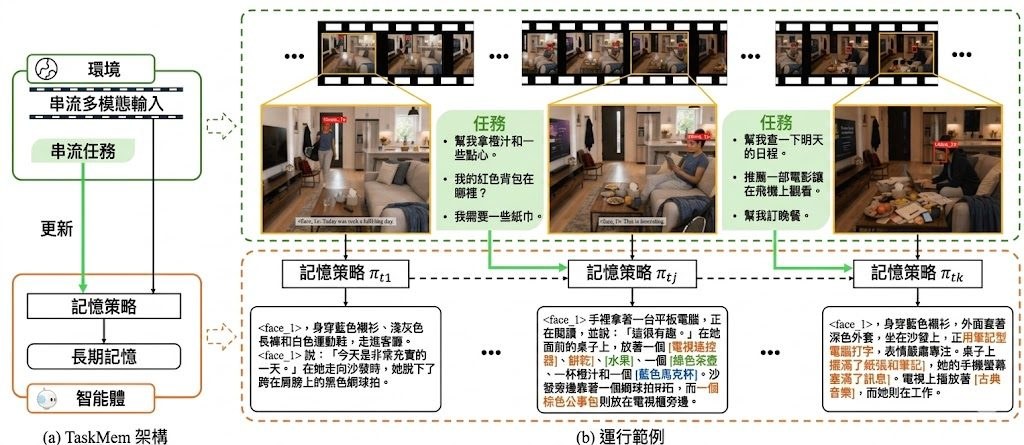
多模態智能體在持續觀察環境時,會接收海量且不斷累積的視覺與語言資訊。若把所有內容都存進長期記憶,既不實際也容易雜訊過多。Task-Focused Memorization for Multimodal Agents 這份研究,把焦點放在一個根本問題:智能體到底應該記住什麼?

來自 ByteDance Seed 與復旦大學的作者群提出名為 TaskMem(Task-focused Memorization Policy Learning) 的框架,把記憶生成視為一項可學習的策略。系統採用兩階段訓練:第一階段先學習怎樣記得準確,第二階段則在部署後,根據近期遇到的任務調整一個 adapter,使基礎多模態大型語言模型(MLLM)偏向記錄與任務相關的內容。整個過程以強化學習驅動,獎勵訊號來自真實任務的表現。

為了評估記憶品質,研究團隊將 VideoMME、EgoLife 與 EgoTempo 改造成串流基準,模擬智能體邊觀察邊回答的場景,且回答時只能依賴記憶,不能翻看原始影片。基於 Qwen3-VL-30B-A3B,TaskMem 在三個基準的 VQA 準確率分別提升 6.3%、7.0% 與 5.3%,並在多項指標上超越 Gemini-2.5-Pro、GPT-5.2 等大型模型。

這項工作對從事多模態智能體、機器人記錄系統或長期對話助手開發的研究者特別有參考價值,因為它把「該記什麼」變成可優化的決策,而非寫死規則。對於關注世界模型與持續學習(continual learning)的團隊,TaskMem 亦提供了一個結合任務回饋與記憶策略的可行路徑。

重點摘要:

  • 核心問題:多模態智能體面對資訊洪流,需要學會選擇性記憶。
  • 方法:以強化學習訓練記憶策略,分為基礎保真度與任務相關性兩階段。
  • 評估方式:將三個影片基準改造成串流設定,僅以記憶回答問題。
  • 成效:在 VideoMME、EgoLife、EgoTempo 上 VQA 準確率提升 5.3% 至 7.0%。
  • 適用對象:研究多模態智能體、機器人記憶與持續學習的開發者與學者。

項目: https://taskmem.github.io/

Categories: 開源, 字節跳動, Agentic, 框架, OpenClaw

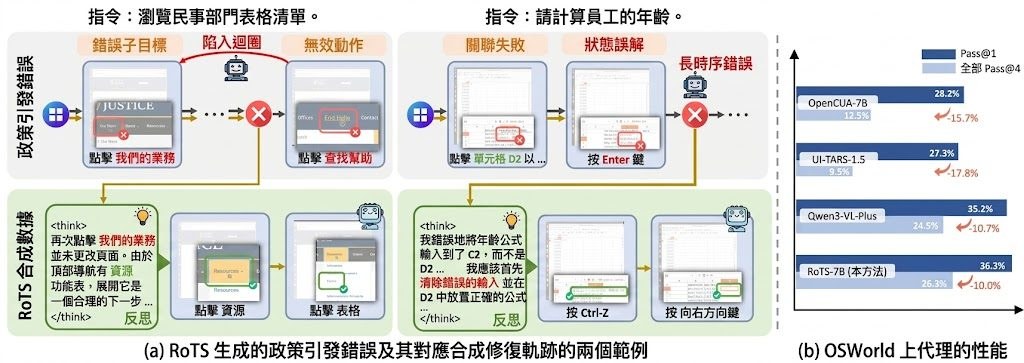
GUI 智能體總是自己犯錯?RoTS 用樹狀軌跡合成教它如何自救

阿里雲發布的 RoTS 項目,為 GUI 智能體補上「犯錯後恢復」的能力短板,並在 OSWorld 基準上刷新開源模型表現。

Repository image for AlibabaResearch/RoTS

近年 GUI agents(圖形介面智能體)雖然進步神速,但只要自己點錯一個按鈕、誤判畫面狀態,往往就會卡住無法完成任務。這項由阿里雲團隊撰寫、入選 ICML 2026 Spotlight 的工作,正是針對這個「自己造成的錯誤」痛點,從評估與訓練數據兩端同時入手。

他們先推出了 GUI-RobustEval 基準,收錄 1,216 個可執行測試案例,涵蓋 11 種錯誤類型與 4 種錯誤深度,讓開發者能系統化量測智能體的「自救」能力。接著提出 RoTS 框架,以樹狀結構(tree-based)在線生成 80 萬條訓練軌跡,主動探索不同錯誤模式並合成對應的恢復步驟。

基於這批數據微調而成的 RoTS-7B 與 RoTS-32B,在 OSWorld 上於開源權重模型中取得領先表現,其中 RoTS-32B 達到 47.4% 成功率與 33.8% All-Pass@4 分數。研究團隊指出,這些分數顯示長時程錯誤恢復能力,同時提升了整體任務表現。

對從事電腦使用代理(Computer-use agents, CUAs)研究、開源 VLM 微調,或關注 GUI 自動化在真實環境穩定性的團隊而言,這是一份值得追蹤的成果。論文與數據集已公開,但程式碼與評估工具仍在整理中,有興趣的人可先閱讀論文並關注後續釋出。

重點摘要:

  • 解決 GUI agents 因自身策略錯誤而無法恢復的部署瓶頸
  • GUI-RobustEval 提供 1,216 個測試案例,覆蓋 11 種錯誤類型
  • RoTS 以樹狀在線合成框架產出 80 萬條高品質訓練軌跡
  • RoTS-7B 與 RoTS-32B 於 OSWorld 開源模型中表現領先
  • 程式碼與數據集仍在整理階段,論文已於 arXiv 公開

GitHub: https://github.com/AlibabaResearch/RoTS

Paper: https://arxiv.org/pdf/2605.29447

Categories: 開源, Agentic, 框架, OpenClaw

無需外部資料的自博弈訓練:SCOPE 讓模型自己出題自己答

SCOPE 用三個角色互相訓練,把「沒有標準答案」的開放式任務也帶進自博弈世界,無需人工數據即可提升模型表現。

Og image

現有的語言模型自博弈(self-play)訓練方法,大多只能處理有明確對錯的題目,例如數學運算。蘇格蘭愛丁堡大學等機構的研究團隊提出了一個名為 SCOPE(Self-Play via Co-Evolving Policies)的框架,把自博弈拓展到沒有標準答案的開放式任務,例如需要整合多段資料才能完成的問答。研究團隊來自 University of Edinburgh、Imperial College London 與 Miniml.AI。

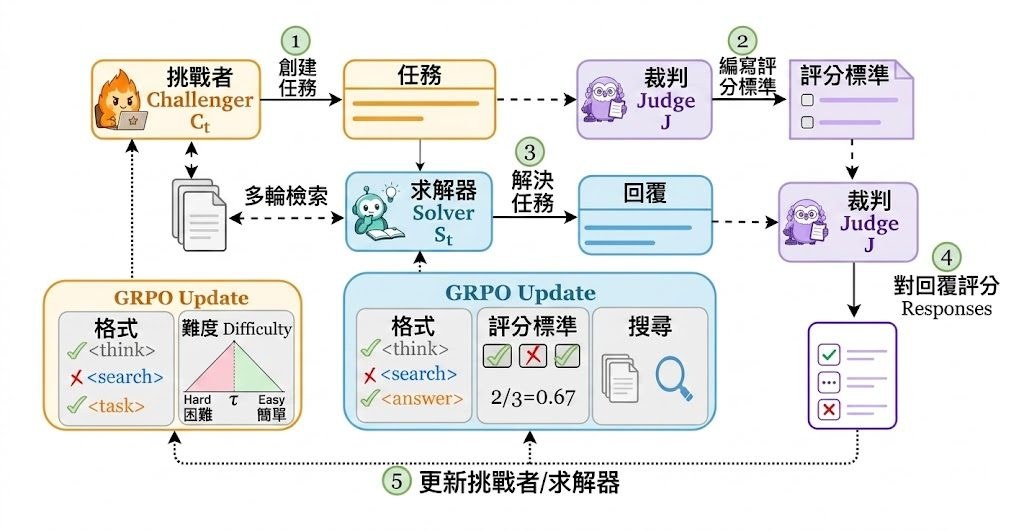
SCOPE 的核心設計是讓同一個基礎模型分身成三個角色:Challenger(出題者)、Solver(答題者)以及 Judge(評判者)。Challenger 讀取一份文件,透過多輪檢索寫出難度貼近答題者極限的題目;Solver 則要靠自己搜尋資料、整合證據後作答;Judge 凍結在初始狀態,根據同一份文件擬定評分準則,並為每項標準給出嚴格的二元評分。三者完全不依賴人工編寫的題目,也不需要體型龐大的前沿模型做監督。

這個框架解決了一個關鍵痛點:開放式任務沒有固定答案,傳統強化學習難以給出可靠的反饋。SCOPE 透過「文件接地」(document grounding)製造資訊不對稱——Challenger 和 Judge 看得到原文,Solver 看不到,迫使答題者必須主動檢索。同時,題目難度被控制在答題者得分約 50% 的位置,因為這個點的反饋變化最大,最有利於學習;得分低於 0.2 或高於 0.8 的題目會被過濾掉,避免太簡單或太難的內容浪費訓練資源。研究亦加入長度懲罰與品質門檻,防止模型以灌水或抄原文的方式「刷分」。

在 Qwen2.5-7B 等 7–8B 規模的模型上,SCOPE 在 8 個開放式基準測試中最高取得 +10.4 分的提升,整體增幅介於 +5.4 至 +10.4 分,並在 7 個傳統問答基準上同樣有穩定進步,過程中使用了 0 條人工策劃的提示。對於想以有限預算微調開源模型、又要兼顧開放式生成品質的開發者與研究團隊,這個方法提供了一條不依賴外部數據集的路徑。

項目: https://edinburghnlp.github.io/scope/

Categories: 開源, 模型訓練, 框架

dMoE:讓擴散語言模型告別專家暴漲

dMoE 為擴散式大型語言模型引入區塊級 MoE 路由,把推理時啟動的專家數量大幅壓低,同時兼顧速度與表現。

Overview

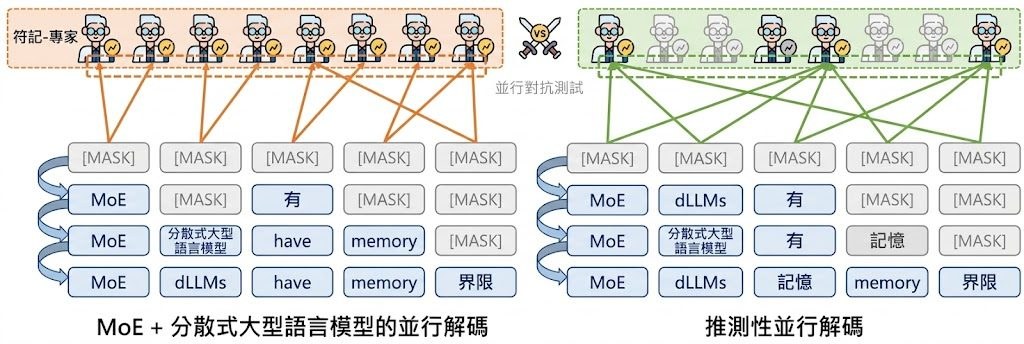
擴散式大型語言模型(dLLMs)近年被視為自迴歸模型的另一條路線,本身就支援平行解碼,但一旦搭配 MoE(Mixture-of-Experts)架構來放大模型容量,卻會撞上一個尷尬的牆:dLLM 在同一個前向傳遞中會同時處理多個互相關聯的 token,而傳統 MoE 卻是針對每個 token 各自挑選專家,導致一次推論要啟動的獨立專家數量暴增,記憶體頻寬很快就成為瓶頸。

dMoE 的核心構想相當直觀:與其在每個 token 層級各自決定要用哪個專家,不如在「區塊」層級做統一決策。它會先把同一個區塊內各 token 的專家分佈聚合成一份,再以這個區塊級的分佈去引導整個區塊的路由。這個改動讓啟動的獨立專家數量從原本的 69.5 個左右壓到 14.6 個,記憶體用量減少約 76% 至 80%,端到端延遲也獲得 1.14 倍到 1.66 倍的加速。

在效能維持方面,dMoE 在多項推理與通用基準測試中保留了原模型約 99.11% 的表現。以 MATH500 為例,成績只從 72.0% 微跌到 71.0%,啟動專家數量卻從 70 個降到 14.1 個,是相當划算的交換。

dMoE 直接以 LLaDA-2.0-mini 為基礎建構,沒有更動主架構,因此可順利套用到其他遮罩式 dLLMs,目前亦已在 Hugging Face 上釋出名為 dMoE-16B 的模型權重。對想嘗試 dLLM 卻受限於顯卡的研究者與工程師來說,這個項目是低門檻的延伸切入點;對做模型效率優化的團隊,區塊級路由的設計也提供了有參考價值的方向。

重點摘要

  • 區塊級專家路由:在區塊而非 token 層級做 MoE 決策,大幅壓低啟動專家數量。
  • 記憶體與頻寬壓力減輕:獨立專家從約 69.5 個降到 14.6 個,記憶體用量減少 76%–80%。
  • 速度明顯提升:端到端推論延遲獲得 1.14× 至 1.66× 加速。
  • 表現幾乎不打折:在多項基準測試中保留約 99.11% 原始效能。
  • 隨插即用設計:以 LLaDA-2.0-mini 為基礎,不改動架構即可套用至其他遮罩式 dLLMs。

GitHub: https://github.com/fscdc/dMoE

項目: https://fscdc.github.io/dMoE/

Categories: 開源, 模型訓練, 框架

Page 29 of 34
1 … 27 28 29 30 31 … 34