OmniRetrieval:整合多種知識來源的檢索項目

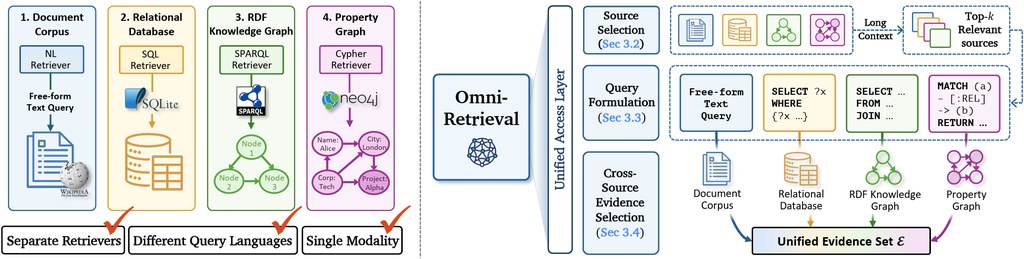
OmniRetrieval 把自然語言問題分派到不同資料來源,再整合成單一證據集。對要跨文字、資料庫與圖譜查詢的人很有參考價值。

OmniRetrieval overview

OmniRetrieval 想處理的,是資料散落在不同系統時的查詢麻煩。一般檢索工具多數只懂一種來源,但這個項目會先理解自然語言問題,再挑選合適知識來源,為各來源生成對應查詢,最後合併結果。

使用這個項目時,核心流程分成 route、generate、execute、select 四步:先選來源,再寫出來源原生查詢,之後執行,最後從多份結果中挑出較合適的證據。對非研究用途讀者來說,可把它理解成一個「跨系統問答協調層」,放在文字語料、SQL、SPARQL、Cypher 之上。

它的重點不在把所有資料硬轉成同一格式,而是保留各種來源原本的表達能力。這種做法能保住關聯式資料庫的 schema、RDF knowledge graph 的 ontology,以及 property graph 的圖結構查詢能力,避免統一格式後反而損失資訊。

  • 支援四類來源:free-form text、SQL、SPARQL、Cypher
  • 基準涵蓋 13 個資料集、309 個 distinct knowledge bases
  • 可量度 source selection accuracy,以及 query formulation 的 exact match 與 token-level F1
  • 提供 LLM provider 選擇,文中可見 openai 與本地 vllm 設定
  • 相關資料集包括 BEIR、Spider、BIRD、LC-QuAD 2.0、QALD-10、SimpleQuestions、Text2Cypher

表現方面,來源資料指出 OmniRetrieval 在跨來源基準上超越 single-source baselines,但不同模型、資料預處理和外部執行環境都會影響結果。從項目結構看,它較適合研究 heterogeneous knowledge retrieval、企業內多資料源問答,或想測試 Large Language Model 如何生成 SQL、SPARQL、Cypher 的開發者。至於模型,項目至少提到 openai 預設骨幹與可本地運行的 vllm,示例亦出現 Qwen/Qwen3.5-4B。
GitHub: https://github.com/JinheonBaek/OmniRetrieval

Categories: 開源, Agentic, 框架

CollectionLoRA:把多個效果 LoRA 濃縮成一個

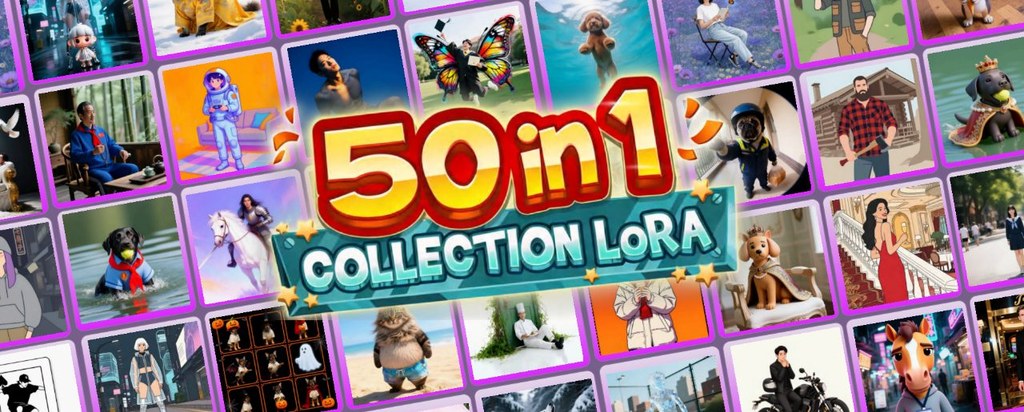
把 50 甚至 180 個效果 LoRA 集中到單一 LoRA,減少部署成本,也降低多重 adapter 疊加帶來的干擾。

Repository image for Qwen-Applications/CollectionLoRA

CollectionLoRA 是一個針對 LoRA 管理成本而設的項目,核心做法是用 multi-teacher on-policy distillation,將多個效果 LoRAs 的概念,以及 few-step generation 能力,一次過蒸餾進單一 LoRA。對一般使用者來說,意思就是原本要為不同效果切換或串接多個 adapter,現在有機會改用一個整合版本處理,流程會更簡潔。

使用這個項目時,重點不是由零開始訓練,而是先按項目提供的 ckpt/ 結構放好權重,之後以 50_in_1/ 作推理用途。倉庫亦提供公開的 training and inference code,而 data/manga_tone/ 內有起步用的 teacher LoRA 和示範訓練資產,方便了解整個資料與模型配置方式。

它解決的問題相當明確:當效果 LoRA 數量愈來愈多,部署、切換與疊加都會變得麻煩,配合 acceleration modules 時,還可能出現互相干擾。CollectionLoRA 嘗試把「多效果」與「少步數生成」合併到同一個 LoRA,這比單純收藏大量 LoRA 更像是重新整理整個工作流。

項目公開的重點包括幾個方向:
– 可把 50→1,甚至 180→1 的效果教師整合到單一 LoRA
– 在 EffectBench 上,文中稱其於 8 NFE 下可取得較高 VSA 與較低 BCR
– 支援 zero-shot 的 A ⊕ B 組合效果,推理時可配對兩個已訓練教師,無需額外訓練
– 已開放 training and inference code,但 model weights 仍標示為未全面開放

這個項目較適合會接觸生成效果控制、需要管理大量 LoRA 的研究者與開發者,也適合想減少部署複雜度的團隊。若你關心的是把多種風格或效果整合成較易分發的模型形式,CollectionLoRA 展示的方向很有參考價值;不過現階段公開資訊主要集中在框架、指標與示範資產,完整權重供應情況仍要留意項目後續更新。

GitHub: https://github.com/Qwen-Applications/CollectionLoRA

Categories: 開源, 阿里巴巴, 視覺模型, 影像模型, 影像處理, 框架

UI-KOBE:幫手機代理先認路再操作

UI-KOBE 先探索 Android App,再建立畫面狀態圖。之後交給代理使用,導航會更穩定。

Repository image for YuxiangChai/UI-KOBE

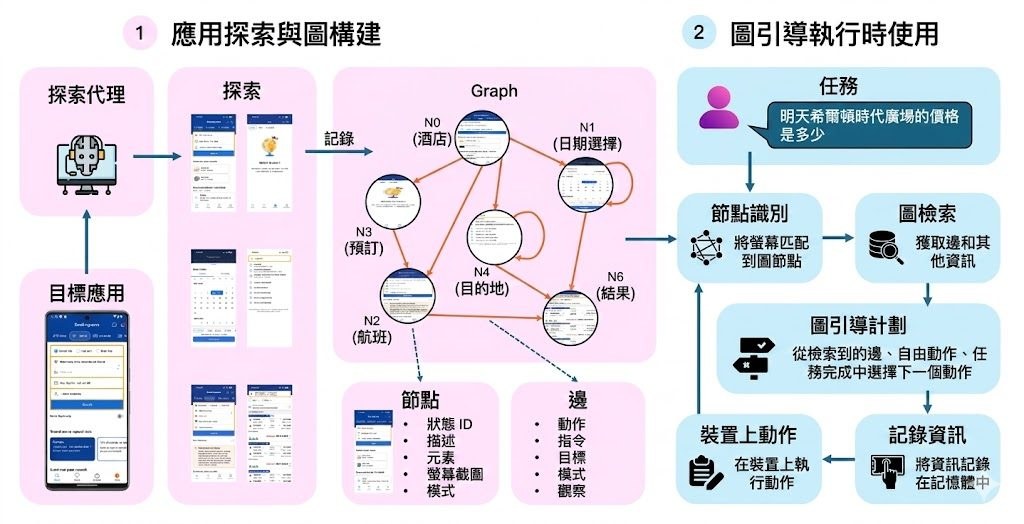
UI-KOBE 是一個面向手機圖形介面代理的項目,核心做法是先探索 Android app,再把畫面與操作路徑整理成狀態轉移圖。對非研究背景的讀者來說,可以把它理解成先替代理畫好地圖,之後代理就不用每一步都盲撞。

動手使用這個項目,需要先備好 Python 3.10、uv、Android SDK、adb、emulator,以及已安裝目標 app 的 Android Virtual Device,另外還要提供 VLM 服務憑證。它依賴 AITK,並可把產生的圖拿去配合 AITK 或 Android World 使用,所以較適合已經有 Android 自動化或代理測試流程的人。

這個項目解決的問題很明確:手機代理在 app 內工作時,容易因畫面變化、按鈕位置或流程分支而迷路。UI-KOBE 會先開啟 app、觀察畫面、選擇探索動作,再記錄結果;每個 app 狀態成為圖節點,能把狀態改變的操作變成邊,之後執行階段可先匹配當前畫面,再從附近路徑選下一步,必要時也可用 free-form fallback action 補位。

  • 先建立 UI knowledge graph,再交給下游代理導航
  • 可接到 AITK 與 Android World 代理流程
  • 依靠 state-transition graphs 減少盲目點擊與重複探索
  • 內含 explore、audit_graph、plot_graph 等腳本,方便檢查圖內容

從設計看,UI-KOBE 的創新點不在單一模型,而在把探索與執行拆成兩段:先累積 app 結構知識,再於 runtime 重用。儲存庫亦提到 UI-KOBE v2 runtime 會載入圖、比對當前畫面節點,再根據圖邊決策;這種做法在多步驟 app 任務中,理論上比純即時決策更穩。

就用途而言,這個項目很適合研究 Computer-use agents(CUAs)、mobile GUI agents、Android 任務代理。

GitHub: https://github.com/YuxiangChai/UI-KOBE

Categories: 開源, 香港中文大學, Agentic, 框架

AsyncTool 點樣測試代理多工工具能力

AsyncTool聚焦代理在多任務下等待 Function Calling 回應時,能否繼續推進其他工作。它更像一套壓力測試,而不只是一般工具調用示範。

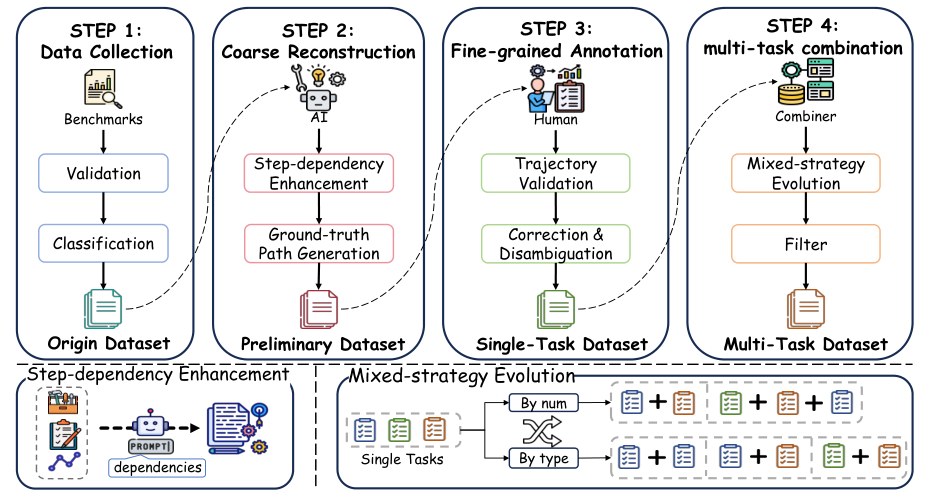
Dataset construction pipeline

AsyncTool 是一個基準測試項目,重點不在教模型怎樣調用工具,而是檢查它在多個任務同時進行、而 Function Calling 回應又有延遲時,會否亂了節奏。一般工具使用測試多數假設結果即時返回,但這個項目刻意加入等待時間,看看代理能否先處理其他不相依的步驟。

AsyncTool 主要是透過儲存庫內的 runner 與評估腳本,將模型接到模擬工具環境,再比較它在同步與非同步情境下的表現。同時可配合 OpenRouter API 的 deepseek/deepseek-chat-v3.1:free,亦可接本地 vLLM endpoint 上的 Qwen/Qwen2.5-7B-Instruct,對想測試不同部署方式的人算是方便。

AsyncTool 把「等工具結果時應否轉做別的事」變成可量化問題。它不單看工具有沒有調對,還會檢查代理是否記得任務狀態、能否遵守步驟依賴、何時切換任務,以及最後能否完整完成整個流程。

  • 核心焦點是 asynchronous tool calling,不是假設工具即時回應
  • 評分分成 step-level、sub-task-level、task-level 三層
  • 會觀察 task switching 時機,而非只計切換次數
  • 內含 benchmark data、tool executors、evaluation scripts

項目顯示不少模型在同步設定下尚可,但遇上非同步延遲後,成功率會明顯下跌。這反映問題未必在於模型不懂用工具,而是它未必擅長長時間追蹤依賴關係和維持多項目狀態。

這項目適合研究 LLM-based agents、agentic workflow、工具調用編排的人,也適合想替自家代理流程做壓力測試的團隊。若你關心的不是單一步驟答對,而是代理在繁忙環境下能否穩定完成工作,AsyncTool 的測試角度相當有參考價值。

項目由中國科學技術大學及多倫多大學合作

GitHub: https://github.com/StoKou/repo-asynctool

Categories: 開源, Agentic, 框架, 中國

CNS 點樣改良擴散取樣效率

這項目用更聰明的雜訊分配方式,提升 diffusion models 生成影像的品質。重點是不改模型訓練,只替換取樣器。

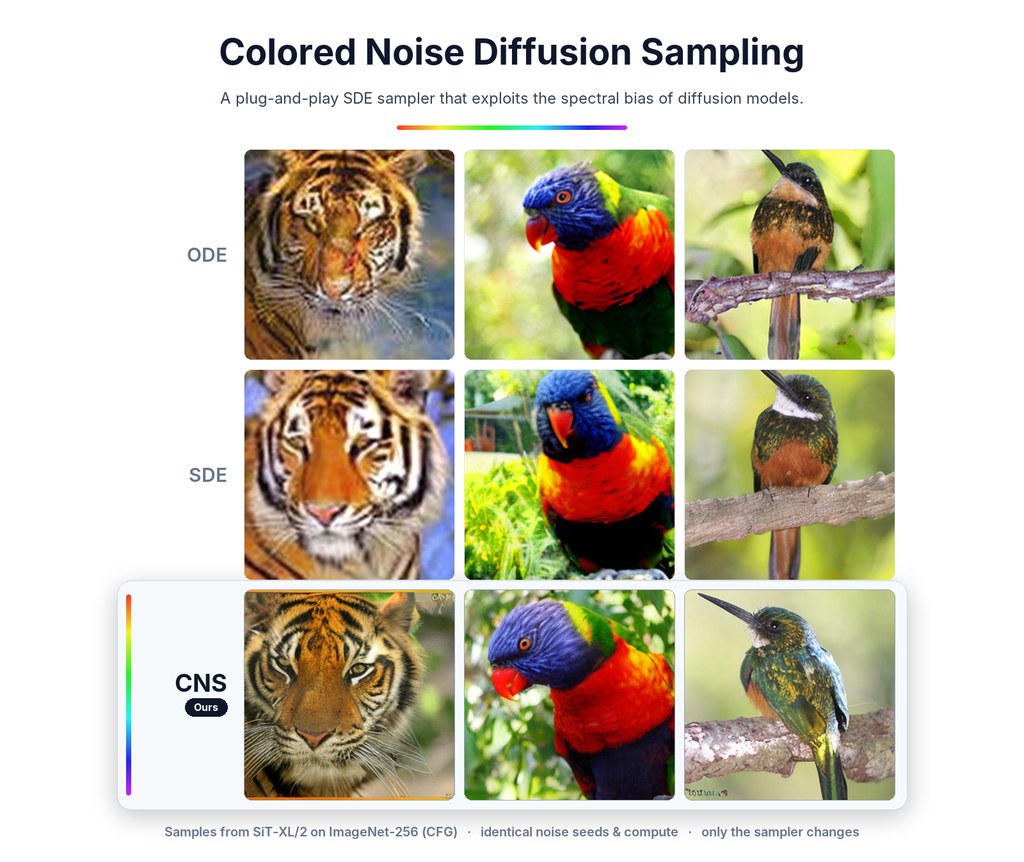
CNS teaser

Colored Noise Sampling(CNS),核心想法是按影像頻率分配雜訊,而不是每一步都加入同樣的 white noise。對非研究背景讀者來說,可以把它理解成:模型早段已經大致砌好輪廓,就不必再把力氣花在這些部分,反而集中補足仍未成形的細節。

它要解決的問題很明確:傳統 Stochastic Differential Equations(SDE)取樣器會平均地把隨機能量灑向所有頻段,但 diffusion models 本身有 spectral bias,低頻結構較早完成,高頻細節較後才逐步補上。CNS 會利用預先計算好的 gamma matrix,判斷每個頻段在不同時間步的完成程度,再把雜訊導向仍然欠缺結構的部分。

這個設計吸引之處,在於它屬於 training-free,而且是 plug-and-play sampler substitution。換句話說,不用重新訓練原有模型,不用增加步數,主要改動只在 noise injection;對已經有生成流程的人,這比重建整個項目方便得多。

  • 保留原模型與原取樣步數,只改取樣時的雜訊策略
  • 依靠 gamma matrix 做頻率感知的動態分配
  • 支援多種架構,文件提到 SiT、JiT、FLUX
  • 在 ImageNet-256 的 FID 結果有明顯改善,尤其 unguided 設定較突出

項目提供了較具體數字:SiT-XL/2 的 unguided FID 由 8.26 降到 6.27,JiT-B/16 由 32.39 降到 26.69,JiT-H/16 由 11.88 降到 8.31;使用 Classifier-Free Guidance 時也有一致改善。這些結果顯示,CNS 並非單靠理論包裝,而是在多個模型上都有可量化的收益。

這項目較適合已經在研究或測試 diffusion models 生成品質的人,例如想比較 ODE 與 SDE 取樣差異、希望在不改訓練成本下提升輸出表現的開發者。若你只想快速理解概念,重點就是:CNS 不是換模型,而是把每一步加入的隨機能量分配得更精準。

GitHub: https://github.com/hadardavidson/colored-noise-sampling

Categories: 開源, 影像處理, 框架

Context-CoT 先讀資料後再推理

項目用合成推理資料,強化模型讀長文再作答。重點是減少忽略上下文的錯誤。

Hero image preview

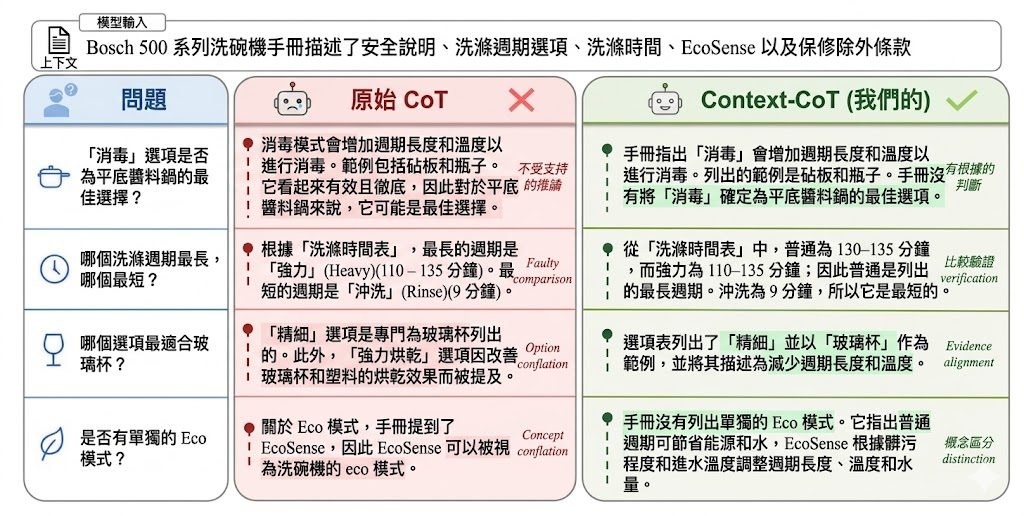
Context-CoT 係一個用來提升大型語言模型「讀完新資料再推理」能力的項目。論文指出,現有模型處理依賴上下文的任務時表現偏弱,在 CL-Bench 上,GPT-5.1 約為 23.7%,開源模型多數只有 13% 至 15%。

這樣就可以解決模型經常只靠原有記憶答題,未能從長篇材料抽取重點再應用。對法律文件、工業排錯或研究資料整理這類工作,這個方向相當實際。

  • 先把長上下文整理成與任務相關的中間資訊,再展開推理。
  • 產生推理資料時盡量隱藏答案與評分規則,減少資料洩漏。
  • 按目標模型的輸出習慣挑選推理路徑,提升微調效率。
  • 實驗指向可明顯減少忽略上下文的錯誤。

你可把它理解為一套「資料合成加微調」流程:先準備長文本任務,再用三段方法生成高質推理資料,最後拿去微調開源模型。這較適合已有模型訓練流程的團隊或研究者。

論文並未展示完整版本、模型名單與全部分數,所以現階段較適合視為有潛力的訓練方法,而非即插即用工具。文中明確提到的模型包括 GPT-5.1,其餘開源模型名稱在現有內容未完整列出。

Paper: https://arxiv.org/pdf/2605.25354v1

Categories: 北京大學, 清華大學, 框架, 中國

MobileGym:手機操作測試搬到瀏覽器

項目把手機操作測試搬到瀏覽器,重點是可重設、可驗證、又能大規模並行。對研究手機 GUI 代理的人來說,方向相當清晰。

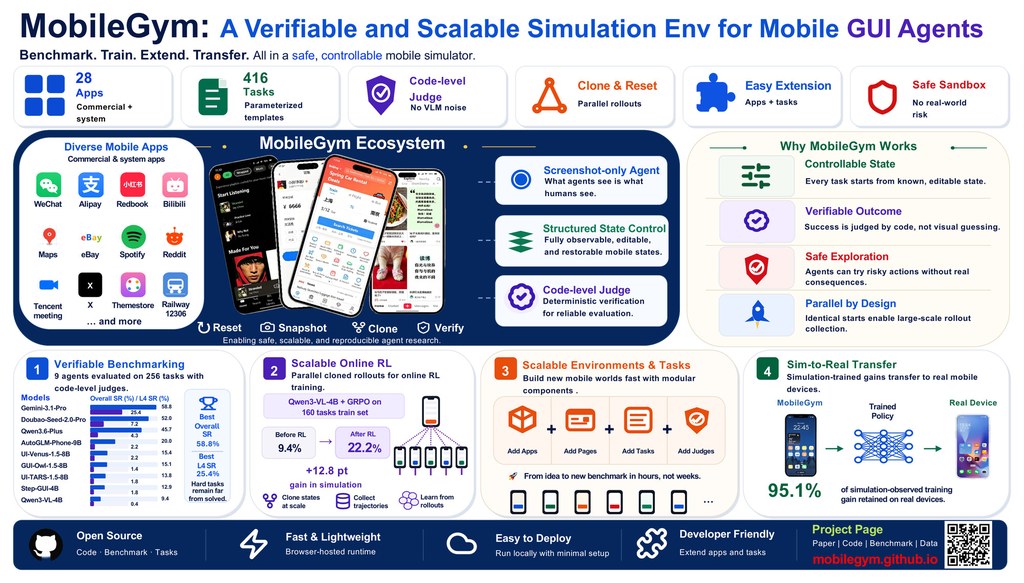
MobileGym — Program Mobile Worlds. Train GUI Agents. Verify by State. A verifiable and highly parallel simulation platfo

MobileGym 是一個放在瀏覽器內運行的手機模擬環境,重點不是做出一部「像真手機」,而是讓研究者可以穩定測試手機操作代理。它針對真機與模擬器常見的難題,例如狀態難以重現、評分不穩、成本高,提供一套較可控的做法。

使用相當直接:先開啟模擬環境,再把代理接上去執行任務,之後用內建評分函式檢查有沒有完成目標。這個項目提供 28 個模擬 app、416 個任務模板,也支援把整個環境狀態存成 JSON,方便重設、比較與重跑同一組測試。

MobileGym 在「結果驗證」不靠模糊文字比對,也不依賴視覺模型做人手味很重的判斷,而是直接檢查結構化狀態。這代表系統不止能知道任務是否成功,還能發現副作用,例如錯誤追蹤了某個帳戶,或誤發訊息,這類情況在真機流程往往較難完整看見。

  • 支援 256 個並行實例,同一台伺服器可同時跑大量測試
  • 每個實例約 400 MB 記憶體,冷啟動約 3 秒
  • 評分為可程式化且具決定性,官方稱可達亞毫秒級
  • 已展示模擬到真機的轉移效果,保留約 95.1% 的訓練增益

性能數字是這個項目的另一個賣點:官方資料指 256 個任務的完整評估可在約 6 分鐘完成,而且 CPU 佔用不高。對需要反覆訓練、比較不同策略或模型的人,例如 Qwen3-VL-4B 搭配 GRPO 這類流程,這種可並行、可重現的設計比單靠真機測試更實際。

整體來看,MobileGym 適合做手機 GUI 代理研究、評測流程設計,以及強化學習訓練驗證。它未必取代真機,但作為前期迭代與大規模評估平台,定位十分明確;尤其當你重視可重現性、成本控制,以及能否清楚知道代理到底做對了甚麼、又做錯了甚麼,這個項目值得留意。

GitHub: https://github.com/Purewhiter/mobilegym

Categories: 開源, 香港中文大學, 北京大學, 框架

AIQ 為代理工具加上深度研究能力

NVIDIA AI-Q把深度研究流程封裝成可重用技能,讓代理工具更易處理多來源分析。

Og image

不少代理工具本身已很擅長協調流程,例如管理對話、串接工具和執行程式碼;但一到需要整合多份文件、引用來源、或根據企業資料整理長篇分析,開發團隊往往要自行處理大量繁瑣工作。這篇內容介紹的 NVIDIA AI-Q,重點正是把這類深度研究能力封裝成可攜的項目技能,讓代理工具直接調用。

它解決的問題很明確:團隊不用再為每個項目重建檢索、規劃、整理、引用與評估流程。代理工具可把研究任務交給本機或託管的 AI-Q 伺服器,之後收回一份有結構、附引用的報告;而敏感資料亦可留在企業內部環境,對醫療、金融、政府及國防等重視資料管控的場景尤其重要。

上手方式亦相對直接。這個項目提供 SKILL.md 說明檔,以及一個輔助腳本去處理請求路由、提交工作、輪詢進度和取回結果。使用前需要 Python 3.10 或以上,並準備一個可連線的 AI-Q Blueprint 伺服器;預設會連到本機位址,也可透過環境變數改寫。

Give Codex a Deep Research Skill With NVIDIA AI-Q

重點可概括如下:
– 把深度研究流程包裝成代理工具可調用的技能
– 支援多來源資料整合,並輸出附引用的報告
– 減少每個項目重複搭建研究流程的工作
– 讓敏感資料可保留在企業內部環境
– 可配合 Claude Code、Codex 等通用代理工具使用

這個項目的創新之處,在於它不是只提供單一工具函式,而是把意圖分類、澄清問題、淺層研究、深度研究與評估整合成較高層的能力。換句話說,代理工具只需學會如何委派,便可利用完整研究管線,較適合想快速為現有代理系統加入研究能力的團隊。文中未見具體效能數字或基準測試,因此現階段較適合把它理解為一個工程整合與工作流程簡化方案。

模型列表:Claude Code、Codex

GitHub: https://github.com/NVIDIA-AI-Blueprints/aiq/tree/v2.1.0

項目: https://developer.nvidia.com/blog/add-a-specialized-deep-research-skill-to-agent-harnesses/

Categories: 開源, Agentic, NVIDIA, 框架

SpaceDG 評測:模糊影像下的空間推理

SpaceDG把「影像變差後,模型仲識唔識睇位」變成可量化問題。呢個項目特別適合關注多模態模型穩定性的人。

logo

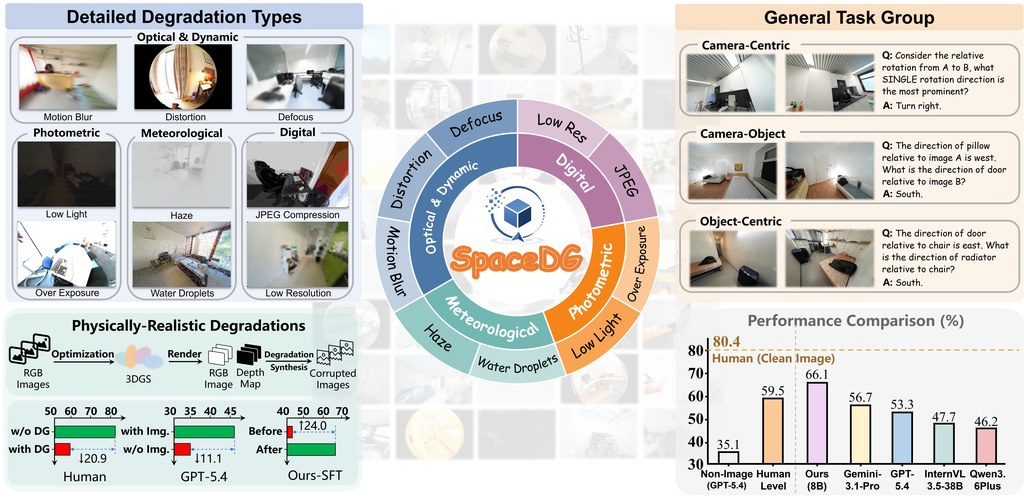
SpaceDG是一個圍繞空間理解而設的評測項目,重點不在「清晰圖片答得幾好」,而是進一步檢查圖片出現模糊、低光、壓縮失真、天氣干擾或鏡頭變形之後,模型仲能否判斷方向、位置同物件關係。這點很貼近真實環境,因為不少現場影像本來就未必完美。

動手方式相當清楚:先按項目提供的 EASI 流程準備環境,再下載 SpaceDG-Bench 數據,之後便可把自己的多模態模型放入同一套評測框架比較表現。對研究或產品測試來說,這比單看一般 VQA 分數更有參考價值,因為它專門檢查模型在「睇得唔清楚」時會點樣失準。

這個項目的特別之處,在於它不是隨便加噪聲,而是把九種影像退化效果納入 3D Gaussian Splatting 渲染流程,令退化更接近物理成因。公開資料顯示,整體數據規模約有 100 萬組問答,覆蓋接近 1,000 個室內場景,另有人工驗證的 SpaceDG-Bench,包含 1,102 條問題、11類推理任務與超過 1 萬個 VQA 例子。

  • 已評測 25 個開源及閉源模型,覆蓋面算廣
  • 影像退化會普遍拉低空間推理表現,人類亦同樣受影響
  • 退化監督微調可同時改善乾淨與受干擾圖片的表現
  • 物件計數等細節感知,似乎比部分幾何推理更易受影響
  • 文中提到的相關模型包括 GPT-5.4、Gemini-3.1-Pro、Qwen3.6Plus、InternVL 3.5-38B 及作者的 8B 版本

整體來看,SpaceDG最適合做模型評估、穩健性研究,以及需要處理監控、機械人、室內導航等場景的團隊。若你關心的不只是模型「最好情況」有幾叻,而是它在普通甚至較差畫面下是否仍可靠,這個項目相當值得留意;至於個別分數與完整設定,仍建議配合論文與基準頁面一併閱讀。

GitHub: https://github.com/Visionary-Laboratory/SpaceDG

Paper: https://arxiv.org/pdf/2605.22536

Categories: 開源, 上海人工智慧實驗室, 框架

Pi-Bench 點評:測試主動型助手夠唔夠醒

Pi-Bench唔係教你做助手,而係用嚟檢驗助手有幾主動。它特別重視長流程、多輪互動同隱藏需求。

Pi-Bench Overview

OpenClaw 等個人助理代理的興起凸顯了大型語言模型在支援使用者日常生活和工作方面日益增長的潛力。這些環境中的一個核心挑戰是主動協助,因為使用者通常從未明確說明的請求開始,而未說明重要的需求、限製或偏好。

Pi-Bench 不是一般聊天問答,而是評測檢查個人助手型代理在長流程工作中,能否及早察覺用戶未講出口的需要。這類情境很常見,因為不少人一開始只會講大方向,細節、限制同偏好往往在後續對話才慢慢浮現。

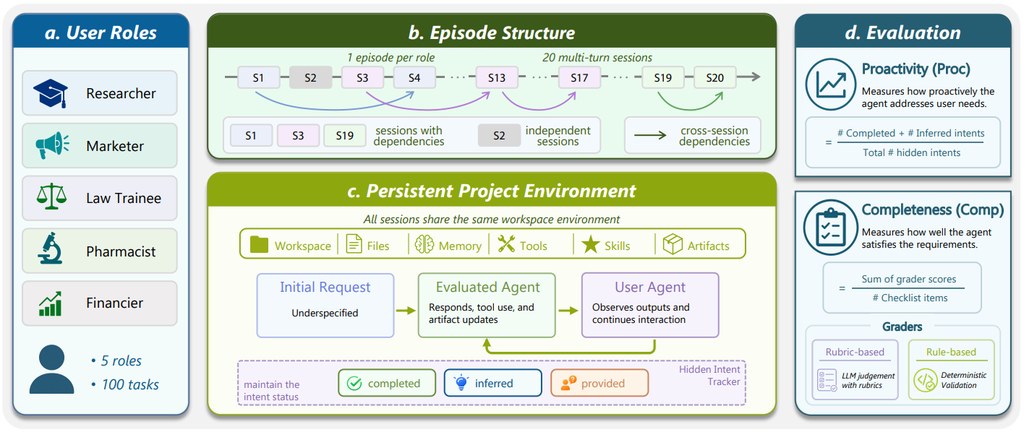
這個項目收錄了 100 個多輪任務,涵蓋 researcher、marketer、pharmacist、law trainee、financier 五類角色,並且把任務放進可持續保存的工作空間,模擬跨時段處理事情的情況。相比只測短回合回答的基準,它更接近「一路做、一路補需求」的助手工作模式。

Pi-Bench 的特別之處,在於它同時看兩件事:助手夠不夠主動,以及最後交付是否完整。前者會看系統能否提早推斷隱藏意圖,或主動追問關鍵資訊;後者則檢查輸出是否符合清單要求。README 提到評分包含隱藏意圖判斷與 checklist 驗證,而且審核分歧低於 4%,顯示評估設計有一定穩定性。

對研究代理系統、評估 LLM 助手,或者想比較 OpenClaw、Nanobot、Claude Code 一類模型/系統表現的人,這個項目幾有參考價值。使用時重點不是「跑出高分」本身,而是觀察模型在哪些回合漏問、忘記前文,或者只懂被動完成指令。

  • 針對長流程、多輪互動,不只測單次回答
  • 納入隱藏需求、跨任務依賴與跨 session 延續性
  • 以主動性與完整度兩條線一齊評估
  • 包含 5 種角色、100 個任務,場景較立體
  • 適合比較個人助手型代理,而非純文字問答模型

整體來說,Pi-Bench 最有價值的地方,是把「助手是否主動幫到手」拆成可觀察、可比較的評測問題。它未必直接提升模型能力,但很適合作為檢查工具,幫團隊看清楚一個助手究竟只是跟指令做事,還是真正懂得提前補位。

GitHub: https://github.com/Simplified-Reasoning/Pi-Bench

項目: https://simplified-reasoning.github.io/Pi-Bench/

Categories: 開源, 香港中文大學, 框架, 中國, Dataset 數據集

Page 31 of 34
1 … 29 30 31 32 33 34