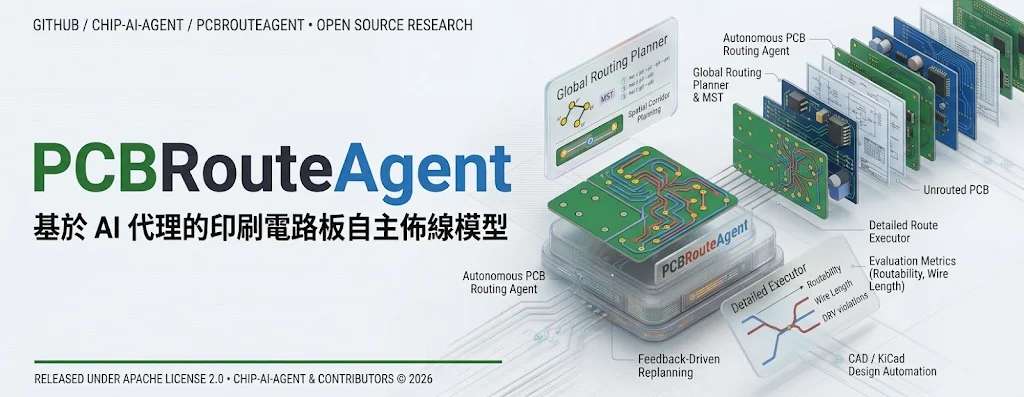
PCBRouteAgent:讓 AI 規劃並修正電路板佈線

PCBRouteAgent 把全板佈線規劃交給多模態代理,再以 KiCad 原生路由器執行並回報失敗原因。它在 247 塊電路板上的測試,也揭示連線完成不等於設計規則全數過關。

Overview of PCBRouteAgent

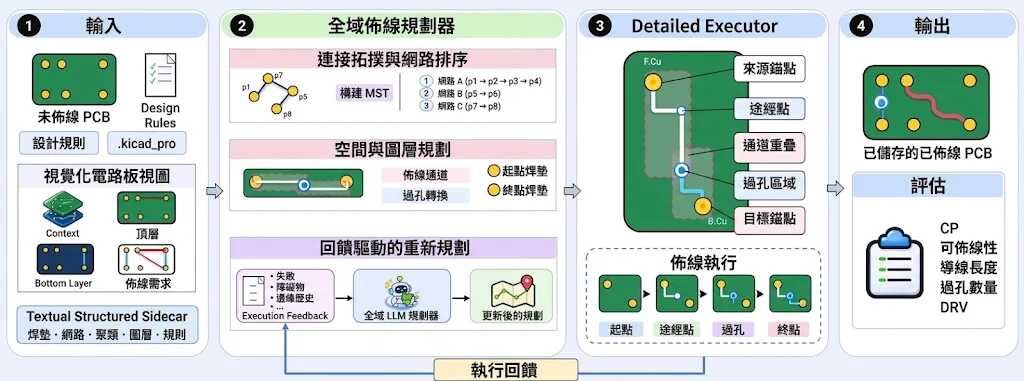
PCB 佈線不只是把焊盤連起來,還要避免走線互相阻擋,並符合間距、線寬等設計規則。PCBRouteAgent 是一個多模態代理框架,讓大型語言模型(LLM)負責安排連線順序、路徑和層次,再由 KiCad 的原生推擠式路由器(push-and-shove router)處理具體走線;遇到障礙時,執行結果會回傳給規劃器,供它調整策略。

這種分工讓代理不必單靠模型逐段猜測幾何路徑,也保留全板層級的規劃能力。項目以 PCBWorld 的 247 塊電路板測試,使用 PCBWorld 官方評測器檢查連線是否完成,以及 KiCad 是否回報設計規則錯誤;電氣連通完整仍不足以代表所有訊號限制都已符合,案例亦顯示前段走線可能堵住後續連線。
• Opus 版本在 D2、D3-A、D3-B、D3-C 的 clean pass 分別為 100%、94.9%、100% 和 40%,不同測試集的落差明顯。
• 使用相同 Haiku 模型骨幹比較時,框架提升完成度,整體模型呼叫約減少 131 倍,API 成本約低 4.3 倍。
• 測試以固定元件位置、網表及設計規則的 KiCad 電路板為輸入,輸出仍是 KiCad 格式的已佈線電路板。

這套流程適合研究 PCB 自動化、評估模型代理能力,或需要批次比較佈線結果的工程團隊;但 D3-C 的 clean pass 仍只有 40%,不能把代理輸出的完整連線直接當成符合工程要求的成品。
項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 多模態模型, API, 框架, Anthropic

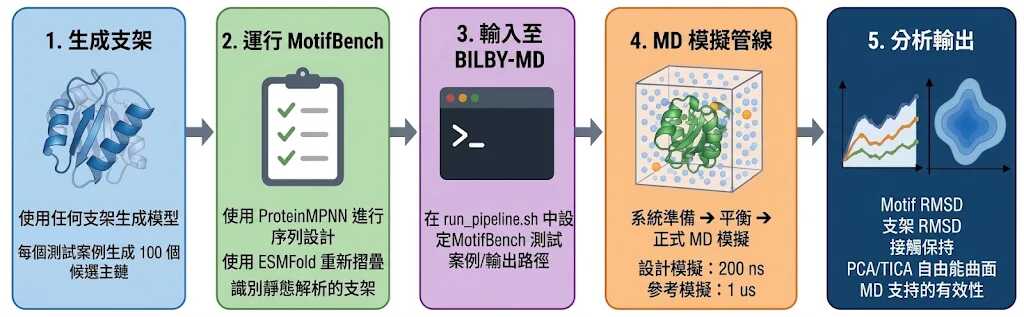
BILBY-MD:把蛋白質結構放入動力學驗證

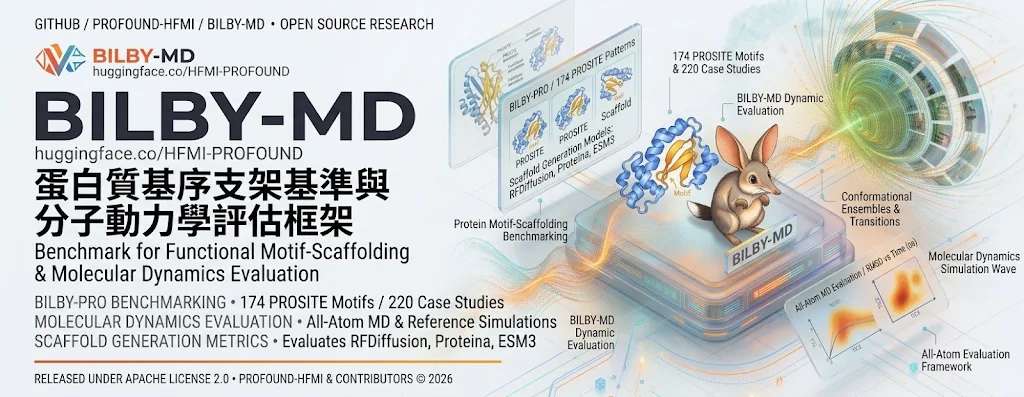
蛋白質設計模型交出穩定結構,未必代表 motif 在運動中仍然可靠。BILBY-MD 以分子動力學補上這一步。

BILBY-md workflow

蛋白質是由一串氨基酸摺疊而成的微型機器。其中真正負責「幹活」(比如咬住病毒、催化化學反應)的關鍵核心區域,叫做「基序」

過去 AI 的兩大痛點,題目又少又偏心:以前大家都只拿少數幾題、人工精心挑選過的基序來考 AI,根本看不出 AI 的真實全面實力。為了徹底解決上面兩個盲點,作者直接推出了兩套工具:

BILBY-PRO(超大規模的標準試卷庫):
不再人工挑偏門題目,直接從權威資料庫(PROSITE)系統性撈出 174 類、共 220 道真實有功能的結構基序大考題,全面普查各家 AI。結果令 RFDiffusion 和 Proteina 變成「答題王」:能解開的題目最多、覆蓋率最高。

BILBY-MD(動態全原子模擬裁判):
這就是前面提到的 BILBY-MD!它是一套「全原子分子動力學(MD)模擬考評框架」。

它不再只看靜態模型,而是把 AI 設計出來的蛋白質直接丟進模擬水溶液中「實測運轉一陣子」,看它在分子震盪動態下,那個關鍵基序是不是還能穩穩固定、結構會不會垮掉,用最嚴苛的動態標準給 AI 打分數。

項目主頁 · GitHub · 數據集

Categories: 開源, 模型, DeepSeek, 框架, 軟件, Dataset 數據集

EvoWorld:讓鏡頭外世界持續演化並保留因果變化

EvoWorld 將 VLM 推理與視覺渲染結合,處理影片中離開視野的物件如何繼續變化,並在鏡頭返回時保留合理反應。

EvoWorld logo

鏡頭轉開後,世界唔應該停唔轉。EvoWorld 是一套生成式影片系統,專門處理「Out-of-Sight World Evolution」(鏡頭外世界演化):物件離開畫面後仍會參與事件,等鏡頭再次回到同一人物或場景,變化亦要延續落去。

LTX-2.5 負責輸出影片:EvoWorld 作為 visual renderer,將條件轉成 896 × 512、24 fps 影片。

EvoWorld 負責「鏡頭外發生咗乜」:透過視覺語言模型做推理,再配合影片生成器,令鏡頭移開後嘅事件仍然可以發展;鏡頭返轉頭時,呈現合理嘅事件結果,而唔係只還原之前見到嘅畫面。

  • 支援事件觸發的世界演化,可由用戶指定中途發生的事件。
  • 重現原本的人物與場景,維持身份及整體連續性。
  • 渲染鏡頭外動態與因果反應,而不只是重播舊有畫面。
  • EvoWorld-Data 提供約 12,000 段影片,涵蓋 65 種事件、63 種場景及 14 種反應類型。
  • EvoWorld-Bench 設有 120 個測試案例,評估事件、重訪與反應的完整流程。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視覺模型, 多模態模型, Gemini, Video, 提示詞, 框架, Linux, Python, LTX, Dataset 數據集

Arete-27B:後訓練調整政治敏感議題

模型怎樣回答政治問題,也可以透過訓練改變。Nous Research 嘗試強化西方價值觀,但未證明偏差已消除。

Og image

Nous Research (Hermes Agent 開發團隊) 針對模型回答政治敏感問題時的拒答、迴避與敘事立場,推出 Arete-27B。這個模型以阿里巴巴的 Qwen3.8-27B 為基礎,透過後訓練強化團隊所稱的「西方價值觀」。

團隊表示,曾觀察到原模型以中國共產黨(Chinese Communist Party,CCP)的框架作答。其做法是調整模型權重中的行為,而非只在對話中加入提示詞;這代表改變價值取向,不等於令模型變得中立。

  • 以 803 條提示詞、七個價值類別量度變化。
  • 列出模型權重 Arete-27B。
  • 列出評測 Propaganda_Eval 與訓練數據 arete-data-pairs。

「中國開源模型的意識形態偏見層,其實非常薄,而且是在最後階段才被強行貼上去的(The bias layer is shallow. It is applied late, it is applied thin)。」

只要 5,000 萬 tokens 的精準數據,就能把原廠花大代價做的政治對齊剝離得一乾二淨。

這對整個開源世界來說是個極具象徵意義的信號:只要權重是開源的(Open-weight),價值觀的主導權就永遠在使用者手裡。

項目主頁 · 模型

Categories: 開源, 阿里巴巴, Agentic, 模型, 模型訓練, Qwen, 提示詞, 框架, 中國, Dataset 數據集

Embodied Agent Arena:測試十款 VLM 的任務能力

十款前沿視覺語言模型接受 1,000 個具身任務測試,結果顯示,能生成可執行動作,不代表能完成多步操作或精細接觸任務。

logo transparent

要判斷視覺語言模型(Vision-Language Models,VLMs)能否勝任機械人通用操作,不能只看它有沒有成功發出動作。Embodied Agent Arena 是一個具身代理評測項目,以共同測試流程比較十款模型在五類能力上的表現,涵蓋 1,000 個案例,並把幾何理解、空間推理和視覺定位納入評測。

項目把任務理解、推理和動作選擇交由模型處理,再以同一套精簡評測框架測試不同模型。測試資料整合 32 個既有來源,另加入 168 個案例的 GeoProbe 幾何基準;相比只看機械人互動任務,這種安排能同時檢視模型理解空間資訊的能力,以及能力能否轉化為實際任務成果。

結果反映,單一指標容易掩蓋任務是否真正完成。Gemini 4 Argon 的 3D 路徑誤差最低,為 0.310 米,但 56 條路徑中只有 24 條符合全部限制;Manipulation 成功率最高的 Opus 5.5 亦只有 47.8%。CALVIN 測試中,100 個序列有 60 個完成第一個目標,完成全部五個目標的只有 9 個;在五項 ManiSkill 診斷任務中,Opus 5.5 能完成拾取、放置和堆疊,卻未能完成插入插銷或充電器。

  • 同一批 157 項 Planning 任務中,至少有一款模型完成 142 項;仍有 15 項十款模型全部失敗。
  • Astra 的 31 項失敗任務耗用 55.5% token;失敗任務平均耗用的 token 是成功任務的 5.1 倍。
  • CALVIN 有 65 個序列曾遇到執行錯誤;其中 62 個後來能無錯執行程式碼,但只有 3 個最終完成序列。
  • Case Atlas 收錄 181 個涵蓋五類能力的案例,提供十款模型的紀錄;缺少影片的項目會使用共用任務場景,API 中斷則標記為失敗嘗試。

這些結果適合用來比較模型在哪些環節失手,亦提醒研究團隊不要把路徑精度、程式碼執行成功或單一步驟操作,直接當成完整任務能力。項目提供線上結果、案例影片、資料集及程式碼。

項目主頁 · GitHub · 數據集

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, AI productions, 世界模型, Qwen, DeepSeek, Gemini, API, VLA, Robotic, 框架, 香港, Anthropic, Dataset 數據集

CoworkOS:2D/3D 網頁任務統一工作流

複雜項目往往要跨多日推進,也需要人手覆核和中途調整。CoworkOS 讓 AI 代理接手分工與持續監察,並保留進度、記錄及待審核成果。

CoworkOS: geometric wordmark, fixed OS frame and illustrated desktop workspace

從研究、文件到 CAD 和 Blender,CoworkOS 讓人與 AI 代理在同一工作空間協作,處理需要多步推進、跨日跟進的工作。它屬於開源 AI 協作執行框架,目標是把任務由規劃、分工一路帶到可檢查的成果;長時間運行的 Jobs 會保留狀態和日誌,遇到等待或中斷後仍可接續處理。

代理工作分成三層:Main Agent 制定計劃、分派任務及檢查成果;Coordinator Runtime 負責派送子任務並追蹤進度;可選用的 Subagents 則執行範圍明確的工作。模型負責決定任務策略,執行環境則維持協調、回饋和工作連續性,避免把多代理協作的管理全交由模型自行處理。

CoworkOS 把 CLI、搜尋、檔案和 MCP 接到文件編輯器、簡報、CAD 與 Blender 等工具,人和代理可以共同修改文件、模型及場景。階層式工作空間和語意記憶用來延續項目脈絡;候選修改會保留版本資訊,讓人先檢查再整合。這種做法適合需要覆核、追蹤及中途改方向的團隊,但可用工具和模型服務的實際配合仍會影響工作流程。

研究團隊也可用同一套機制建立長期監察迴圈,例如分析模型失誤、改善訓練資料、執行訓練及驗證結果。配套研究報告記錄了 Qwen3.6-35B-A3B 經五輪後訓練後,在八個基準的平均分由 33.19 升至 42.95;這是特定實驗結果,各任務仍有升跌,不能直接視為其他模型或工作流程的保證。

  • Jobs 保留長時間任務的狀態與日誌,方便中斷後繼續監察。
  • Main Agent、Coordinator Runtime 和 Subagents 分別負責規劃、協調與執行。
  • 人與代理可共同處理文件、簡報、CAD 模型及 Blender 場景。
  • 候選修改可先經人手檢查,再整合到項目成果。

CoworkOS 面向使用 macOS 的研究人員及需要多工具協作的團隊,支援 Apple Silicon,並要求 macOS 14 或以上及 Node.js 22.19.0 或以上。儲存庫資料提及可透過 npm 安裝,亦提供文件、展示及即時示範連結,開始部署前,仍需查閱項目文件確認模型服務與工作空間的配置方式。

項目主頁 · GitHub

Categories: 開源, 北京大學, Agentic, MCP, 模型, 模型訓練, Qwen, 框架, 工具, Mac, 庫, 中國, 蘋果, Dataset 數據集

CUA-Master:把教學影片變成電腦操作訓練資料

教學影片可以變成代理的操作練習,但仍要接駁沙盒。CUA-Master 串起任務挖掘、驗證與訓練資料製作。

com

把軟件教學影片轉成可驗證的操作任務,CUA-Master 這套框架協助團隊訓練電腦操作代理(Computer-use agents,CUAs)。它會按模型弱點補充任務,讓資料建構與模型改進互相帶動。

框架結合字幕語意與畫面變化重建操作軌跡,再抽取可重用的能力單元,控制新任務涉及的能力及應用程式數量。沙盒執行失敗後,可按回饋回復快照重試;已驗證軌跡可轉成 ms-swift 格式的監督式微調(Supervised Fine-Tuning,SFT)資料。

準備測試需要安裝依賴及接駁服務:

  • 以可編輯模式安裝,加入 seeding、annotator、collection、dev 依賴。
  • 複製 .env.example 為 .env,填入 API 金鑰及沙盒服務端點。
  • 經 provider 介面接駁自己的沙盒後端,再按範例設定搜尋影片資料、下載選定影片;命令支援 –help。

官方公布 CUA-Master-27B 在 OSWorld Verified 得分為 80.2,在 OSWorld 2.0 為 36.9,兩者不可直接當成同一尺度比較。項目較適合有沙盒及訓練資源的代理研究團隊;提供的快速開始內容未完整展示後續流程,尚不足以照抄完成整條訓練流程。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, AI productions, 模型, 模型訓練, API, Video, 框架, 教學, 軟件

NorthCUA:讓桌面與網頁任務留下可查證成果

交給 AI 的桌面任務,可以連同操作過程與成果一起檢查。NorthCUA 容許自選模型,但接入仍有能力要求。

NorthCUA

讓 AI 操作桌面與網頁後,還能檢查最終檔案或軟件狀態,NorthCUA 把這一步納入開源執行框架 Harness。它串連操作、畫面資訊、工作筆記與結果檢查,讓長任務保留中間進度。

框架建基於 NexAU,不綁定單一模型,但接入的視覺模型須支援結構化工具呼叫。NorthCUA 模型系列則基於 Qwen3.5,提供 Nano、Mini、Pro 三種規模;框架與模型應分開理解。

  • 可先試免金鑰的本機教學,再接入模型執行任務。
  • docs/first-run.md;所附節錄未提供完整安裝步驟。
  • 支援可恢復的批次執行,並保留過程記錄供檢查。

項目公布 Pro 在 OSWorld-Verified 得分為 88.6%,測試涵蓋 361 個任務、上限 100 步,排除 8 個 Google Drive 任務。參考模型的操作介面與結果彙整方式不同,不能直接視為同條件比較。

需要追查操作失敗原因、驗證交付成果的自動化團隊較容易受益;具體任務能否完成,仍要接入模型後測試。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, Qwen, 框架, 教學, 軟件, 工具

REA:讓機械人執行動作時不必等待 AI 思考

機械人控制常要在慢速推理與即時動作之間取捨,REA 透過路由與復原機制,讓執行中的控制政策不必停下來等候大腦回應。

Og image

機械人執行動作時,若每一步都要等 AI 完成較慢的推理,控制就可能停頓。REA(Routed Embodied Agent Runtime)是為具身智能代理設計的執行框架,讓負責推理的「大腦」與快速控制的「小腦」非同步協作,並在需要時路由任務或復原執行流程。

這種安排適合需要連續動作、同時又要處理複雜指令的機械人工作流。REA 可協調 VLA(Vision-Language-Action)模型與程式控制政策,讓系統按任務選用不同控制方式;推理延遲不會直接令正在執行的控制政策停下來。

評測結果包括:在 3,000 個 LIBERO-Pro 測試回合中取得 95.9%,控制步數減少 25%;在 RoboTwin 2.0 中,結合 VLA 與程式政策取得 86%。頁面亦稱,REA 在 BEHAVIOR-1K 與真實 Unitree G1 測試中解決的回合數最多,但沒有提供這兩項測試的具體數字。

  • 推理與快速控制非同步進行,執行中的政策毋須等待大腦回應。
  • 透過路由與復原機制,協調不同類型的控制政策。
  • RoboTwin 2.0 評測結合 VLA 與程式政策,結果為 86%。
  • 項目頁需啟用 JavaScript 才能查看互動圖表;提供的內容沒有安裝或下載步驟。

REA 適合研究機械人長流程任務、異質控制政策協作,以及推理延遲如何影響動作連續性的團隊。現有內容提供多項基準測試結果,但未列出各項實驗設定與比較基線,閱讀數字時仍需留意這些資訊限制。

項目主頁 · 模型

Categories: Agentic, 模型, 視覺模型, 多模態模型, VLA, Robotic, 框架, Discord

System 1+2:AGI 也要先估互動價值再花算力

多想幾步、多試幾次,都有成本。研究構想讓 AI 先估計哪些互動有價值,再投入資源執行。

Hero image preview

AI 代理搜尋資料、執行程式或讓機械人試走一步,都要付出成本,卻未必帶來有用結果。清華大學團隊提出 System-1/System-2 協同設計構想,希望在執行前先篩選值得投入的互動。

成本較低的 System-1 按預期價值排列互動的優先次序,再由成本較高的 System-2 執行較困難的工作。這個構想把資源分配提前,讓增加推理、訓練或探索次數之前,多一道價值判斷。

它涵蓋的場景包括:

  • 語言模型推理:判斷哪些推理步驟值得繼續投入。
  • AI 代理:篩選搜尋、程式執行及應用程式介面(Application Programming Interface,API)呼叫。
  • 機械人與強化學習(Reinforcement Learning,RL):優先探索可能提供學習訊號的經驗。

對互動成本高、數據取得慢的研究與開發工作,這個構想提供了分配預算的思路。不過,所提供節錄未交代價值預測器的具體實作或量化結果,仍未能判斷它能節省多少成本,以及會否錯過有用的探索。

項目主頁 · Paper

Categories: 清華大學, Agentic, 模型, 模型訓練, API, World-Action Model, Robotic, 框架, 軟件, 編程, AGI, 強化學習

Page 1 of 34
1 2 3 … 34