EgoMemo 讓助手懂得幾時先開口

唔少助手識回應,真正難的是判斷應否打擾你。EgoMemo把連續第一身影片整理成可檢索記憶,嘗試把主動提醒變成可評測的能力。

Repository image for SitongGong/EgoMemo

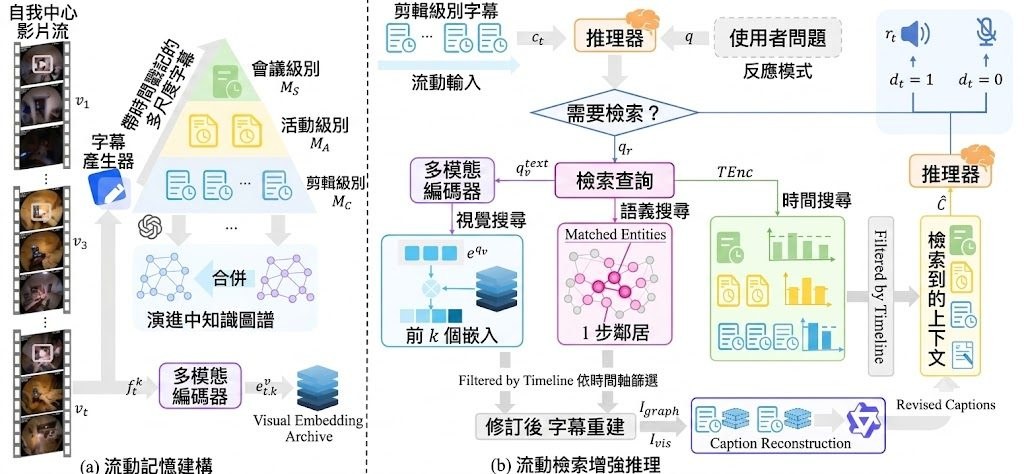
助手最難處理的,不是看見了甚麼,而是判斷幾時該出聲、幾時應該保持安靜。EgoMemo對準的正是這個空位:它屬於一個面向連續第一身影片的記憶增強代理系統,同時附上 benchmark,目標是讓系統根據累積情境主動提供服務,而不只是等人發問或對每個事件都作反應。

現有做法多數落在兩個範式:reactive,只會被問到先答;semi-proactive,偵測到預先定義事件就回應。作者認為這兩類方法都欠缺對使用者歷史、當前活動與介入時機的判斷,所以用 EgoServe 重新定義問題,把主動協助視為 context-dependent decision problem,再由 EgoMemo用 three-level temporal memory graph、semantic knowledge graph 同 visual embedding archives 做 retrieval-augmented reasoning。

這個 GitHub 項目不止放出模型思路,亦包含 memory-graph construction + retrieval pipeline、evaluation suite、dataset annotation 與 streaming demo。理解部署方式並不複雜:先準備 Python 3.10 環境與 .env 內的 API keys、資料路徑,再下載 EgoServe 註釋及對應來源影片,之後按不同資料集分開執行 processing 與 retrieval 兩階段,前者建立記憶圖,後者生成 proactive-service response。

  • EgoServe 收錄超過 3,000 個 service instances,橫跨 4 個 temporal memory horizons 與 10 類服務
  • EgoMemo 採用 training-free 設計,重點放在記憶組織與檢索,而不是再訓練一個大模型
  • 項目同時支援 EgoLife、HoloAssist、CaptainCook4D、EyeWo / ESTP-Bench、OVO-Bench 等資料來源
  • retrieval 可切換 caption retrieval、visual retrieval 等設定,方便做 ablation

EgoMemo 不是追求單次問答表現,而是補上長時間情境累積後的判斷能力。受益最大的是做 egocentric AI、智能助理、穿戴式裝置或多模態 Agentic 項目的研究團隊;限制也同樣直接,整個流程依賴外部影片資料、API keys 與多階段處理,重點更接近研究基線與評測框架,而未算一個即裝即用的消費級產品。相關模型與組件方面,儲存庫示例已出現 QwenVL 3 8B Instruct、GPT-5、Gemini 等作為 caption 或 response 端選項。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Embedding, 多模態模型, 模型訓練, OpenAI, Gemini, API, KnowledgeGraph, Python, Dataset 數據集

MOSS-Transcribe-Diarize:多人長音訊一站式轉錄

錄音一長、講者一多,整理內容最怕時間碼亂、人物又對唔上。MOSS-Transcribe-Diarize 把轉錄同分辨講者合併處理,明顯是想減少後期整理工序。

OpenMOSS Logo

會議、訪談、podcast 呢類長音訊,最麻煩唔係單純變成文字,而係要一路保留時間碼、一路分清楚邊個講緊。MOSS-Transcribe-Diarize 屬於音訊理解模型,集中處理長篇多人語音轉錄同 speaker diarization,輸出已經連同時間戳同講者標籤,例如 [S01]、[S02],比起先做 ASR 再另外接 diarization,流程更完整。

呢個項目的取向相當鮮明:它唔係把幾個系統串連,而係用 end-to-end 方式一次過完成 transcription、speaker diarization、timestamps,連 acoustic event awareness 都納入同一模型。好處係輸出格式更統一,段落對位較自然;代價則是你要接受它的整體輸出設計,而唔係自由替換其中一段模組。

目前公開的是 MOSS-Transcribe-Diarize 0.9B,定位為開源 SOTA 模型;另有更強的 MOSS-Transcribe-Diarize Pro,但會以 API 形式提供。部署路線算清楚,倉庫已列出 Python 用法、自訂 prompt 與 hotwords、用 vLLM 或 SGLang Omni 提供服務,亦有 Subtitle Web App,表示它不只適合研究測試,也可朝內容整理、字幕製作同語音工作流整合發展。

  • 把 ASR 與 speaker diarization 合併,減少多階段對齊誤差
  • 直接輸出帶時間戳的文字流,適合字幕、會議紀錄、訪談整理
  • 支援長篇、多講者、較混亂的真實錄音場景
  • 0.9B 已開源,Pro 版本主打更高整體表現並將經 API 提供

受惠最大的會係做會議紀錄、媒體轉寫、客服通話分析同教育內容整理的團隊,因為他們最在意的往往不是單句辨識,而是整段內容可否穩定交付。現有資料提到它屬於 SOTA 等級,也有獨立 Evaluation 章節,但未見完整數字細節一併列出;能夠確認的是,相關模型目前包括 MOSS-Transcribe-Diarize 0.9BMOSS-Transcribe-Diarize Pro,前者著重開源可用性,後者走更高性能與 API 存取路線。

GitHub · 模型

Categories: 開源, 模型, API, Python, 語音

Qwen3.6 全新的動態 NVFP4 量化器

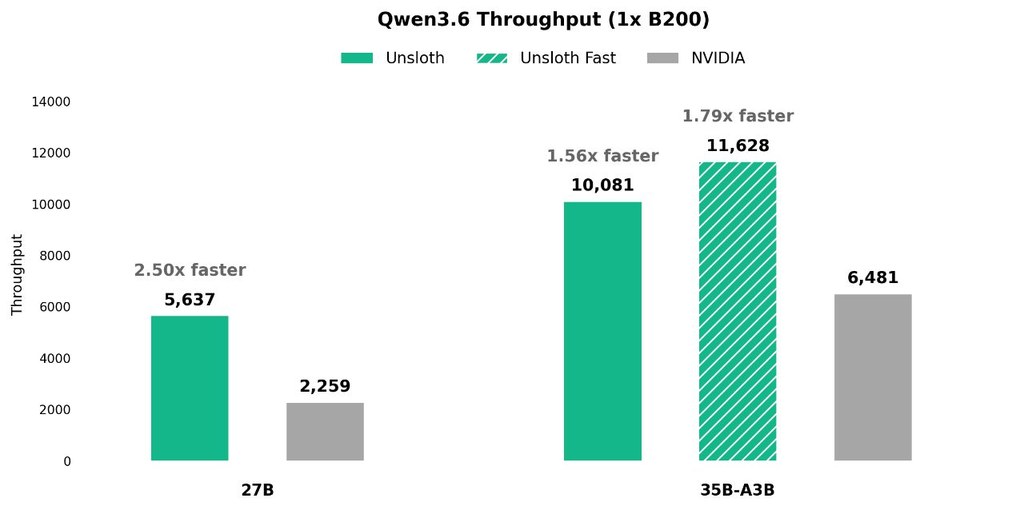
運行速度比其他 NVFP4 量化器快約 2.5 倍,效能更佳,檔案大小也相近。在24GB 記憶體上,Qwen3.6-27B NVFP4 的運行速度提升 2.5 倍;在32GB 顯存上,Qwen3.6-35B-A3B 的運行速度提升 1.7 倍。

Og image

想喺自己電腦上跑到規模較大的多模態模型,最大卡位通常唔係功能,而係記憶體同速度。Qwen3.6 屬於阿里巴巴的新一代多模態 hybrid-thinking 模型系列,重點在於用相對可控的硬件需求,處理 agentic coding、vision 同 chat 等工作。

現有資料提到兩個主力型號:Qwen3.6-27B 同 35B-A3B。前者可在約 18GB 記憶體配置下運行,後者約需 22GB 至 23GB 左右,並支援 256K context 及 201 種語言。對想喺本地做長內容理解、跨語言對話,或者配合工具調用工作流的人來說,這個取向幾實用。

相比只講「可量化、可本地跑」的常見做法,Unsloth 這邊更著重點樣揀到速度與準確度較平衡的版本。Qwen3.6 GGUFs 採用 Unsloth Dynamic 2.0,會按真實使用資料做 calibration,並把重要 layers upcast;另外新推出的 NVFP4 quants 主打在 GPU 上帶來約 2.5 倍更快速度,MTP 則標示可把 inference 再加快 1.4 至 2.2 倍,同時不犧牲準確度。

  • 適合本地部署多模態模型,兼顧編碼、視覺與對話
  • 27B、35B-A3B 記憶體需求相對克制,較易在個人設備起步
  • GGUF 格式配合 Unsloth Dynamic 2.0,重點是量化後仍保持可用表現
  • NVFP4 與 MTP 主要改善推理速度,幫助減少等待時間

使用上仍有幾點要留意:總可用記憶體最好高於下載的量化模型大小,否則雖然可經 llama.cpp 用 SSD/HDD offloading 繼續運行,但推理會慢得多;文件亦明確提醒不要使用 CUDA 13.2,以免輸出異常。整體來看,這不是單純把 Qwen3.6 搬到本地,而是把「跑得動、跑得快、精度仍可接受」這幾個取捨整理得更清楚。

所引用的模型列表:Qwen3.6-27B、Qwen3.6-35B-A3B。

項目主頁 · 模型

Categories: 開源, 阿里巴巴, Agentic, MCP, 模型, 多模態模型, Qwen, NVIDIA, API, 教學, Medical醫學, Python, 編程, OpenClaw, Anthropic

DrugGen-2:把疾病上下文拉進分子生成流程

你可以在指定疾病與蛋白靶點後,讓模型直接吐出候選藥物分子。DrugGen-2 補上了以往只針對靶點或通用性質做生成的盲區。

Logo

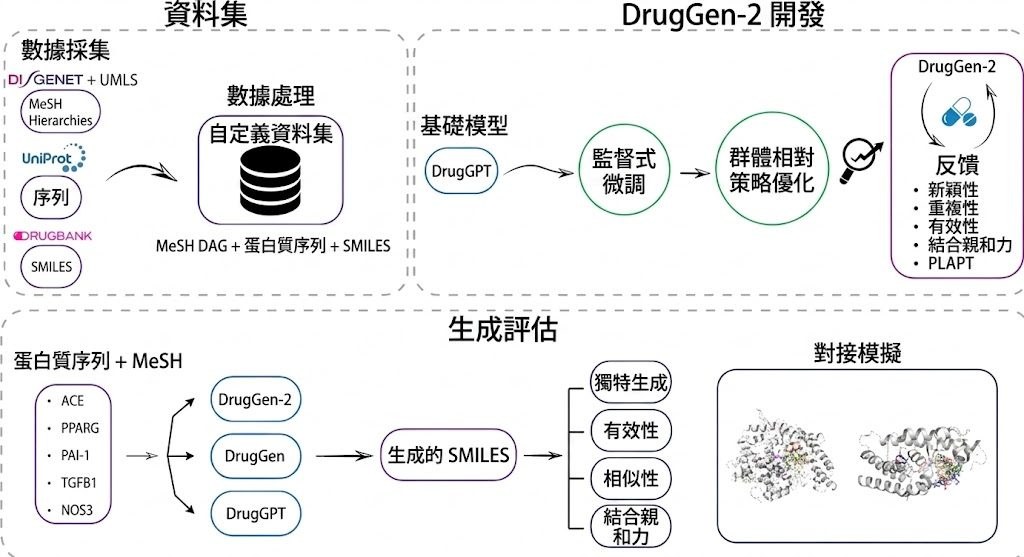
很多老牌分子生成模型只盯着單一蛋白靶點或通用化學性質做條件生成,往往忽略了同一個靶點在不同疾病背景下行為可能完全不同。DrugGen-2 正是針對這個落差而來,它是一個用 MeSH DAG(疾病本體層級結構)加上蛋白序列做條件輸入的語言模型,輸出端直接給出 SMILES 結構,既支援 de novo 設計,也能用於藥物再利用篩選。

這個項目屬於開源模型與訓練框架的混合體,背後以 liyuesen/druggpt 為基底,先做 Supervised Fine-Tuning(SFT),再用 Group Relative Policy Optimization(GRPO)做強化學習微調,整個流程跑在 Hugging Face transformers 與 TRL 上。作者認為舊做法把疾病與靶點切割看待,於是提出以疾病為錨點重新組織資料的 framing,這也是它和同類工具最大的差異點。

對做計算化學、藥物篩選前期探索或想快速做假說驗證的研究團隊來說,這類輸入比直接丟一個蛋白 ID 更貼近真實用藥情境。要部署的話只要 clone 倉庫、安裝 requirements,再透過 Python API 或 CLI 餵入疾病名稱、MeSH ID 與 Uniprot 序列即可生成候選分子,預訓練權重已放在 Hugging Face 上方便取用。

不過要留意,模型表現仍受限於 alimotahharynia/approved_disease_target_drug 訓練集的覆蓋範圍,對冷門疾病或新興靶點的泛化能力尚未有公開 benchmark 直接驗證。它比較適合作為初期探索與假說排序的輔助,而非取代濕實驗驗證的工具。

項目主頁 · GitHub · Paper

Categories: 開源, 模型訓練, API, Clone, Medical醫學, Python, Dataset 數據集

UniClawBench 點樣測主動式代理

要比較主動式 AI agents,單看單輪答題已經唔夠。UniClawBench把工具操作、瀏覽器、檔案同 GUI 流程放入同一個閉環評測。

UniClawBench

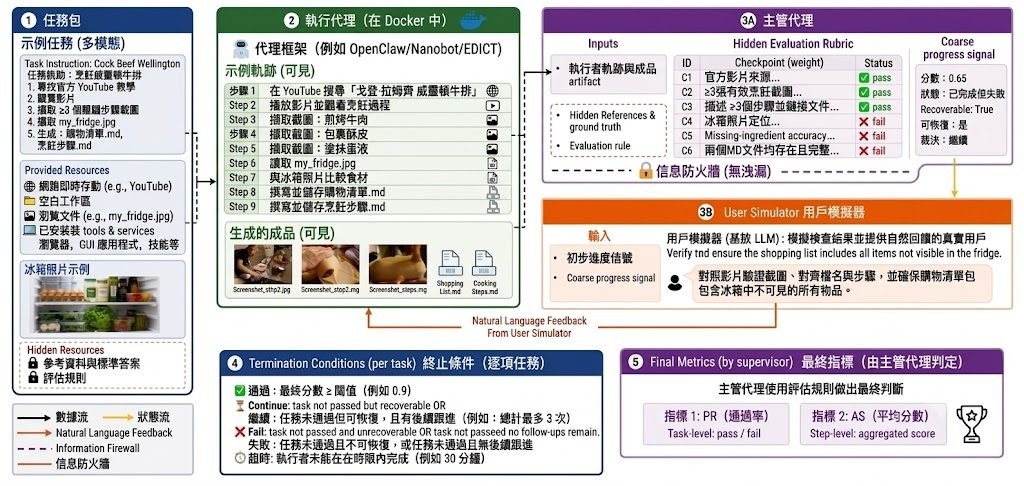
比起只問模型識唔識答,UniClawBench更在意代理能否一路做、一路修正,直到完成整個工作流。它屬於benchmark 項目,針對 proactive AI agents 在真實工具、瀏覽器、檔案處理與桌面 GUI 任務中的完成能力,補足傳統單步評測難以反映連續操作表現的缺口。

現有做法常把 agent evaluation 壓縮成靜態問答、固定軌跡重播,或者只看最後答案;作者明確改用 three-role closed-loop evaluation framework,將 executor、hidden answer supervisor 同 public user simulator 分開。呢個設計的重點,是同時檢查代理點樣行動、途中有冇偏離、收到回饋後能否繼續修正,而唔係只計一次輸出啱唔啱。

公開版本提供 400 個雙語任務,英文與中文各 200 個,覆蓋 Skill Usage、Exploration、Long Context、Multimodal、Cross Platform 五類能力。部署思路亦算清晰:倉庫已放入 packaged task resources、Docker-based runtimes、distributed dispatch scripts,同埋可檢視 leaderboard、trace、artifacts 與 timeline 的 WebUI;要跑測試,核心其實是先填好 executor、Codex provider 同 API keys 相關設定檔,再用它的執行環境批次評估。

  • 用 three-role 閉環評測取代一次性答題
  • 任務同時涉及 browser、files、GUI apps 與其他工具
  • 400 個雙語任務,較易檢查跨語言穩定性
  • WebUI 可回看 traces、artifacts 同示範流程

從補充資料看,作者想指出的取向幾鮮明:framework choice 對能力表現的影響,往往比 model choice 更大,而 long-context 與 multimodal 仍是主要瓶頸。相關模型與組合亦有列出,例如 GPT-5.4、Claude Opus-4.8、Kimi-2.6,並配合 OpenClaw、EDICT、Nanobot 等框架比較;對研究 agent system、企業內部自動化流程,或者想建立較完整評測流水線的團隊,這個項目的參考價值高過單純看排行榜。

項目主頁 · GitHub · Paper

Categories: 開源, 香港大學, Agentic, 多模態模型, OpenAI, API, 框架, OpenClaw, Anthropic, Dataset 數據集, Skill 技能

Vidu S1 把即時互動影片拉近一步

對住數碼角色直接開聲指揮,畫面仲可以一路生成一路改,Vidu S1瞄準的正是這種近乎通話式的影片互動。它未必是最通用的影片模型,但在即時控制這件事上明顯有自己路線。

Vidu S1 Experience Preview

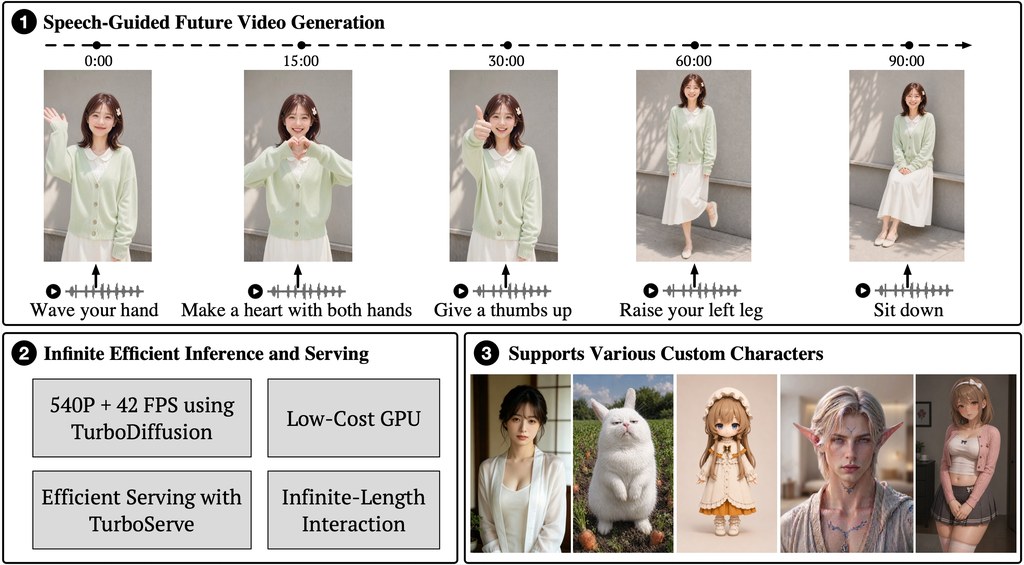
比起先寫好提示詞再等片段輸出,Vidu S1更接近一種可對話的視頻模型:你一邊講,數碼角色一邊跟住反應,處理的是「影片生成能否即時被人打斷、改向、持續延長」這個卡位。項目把重心放在 voice-controlled digital characters,而不是一次過產出完整短片,定位很清楚是互動內容而非傳統文生影片。

現有做法多數仍是 prompt-driven、片段式生成,用戶先提交指令,再等待固定長度輸出;作者主張這種範式難以支援 live interaction。Vidu S1改用 real-time speech control 與 infinite-length real-time interactive generation,讓角色在生成途中持續接受 spoken instructions,方向上更接近直播角色、虛擬主播和即時陪伴互動,而不是 cinematic clip 製作。

  • 支援以語音即時控制角色動作,重點在連續互動而非單次出片
  • 可自訂角色形象與 voice tones,涵蓋真人、二次元、寵物等 avatar
  • 官方資料提到 540p、最高 42 FPS,並可在 consumer GPUs 運行
  • 除了網頁體驗,也提供 API 文件,較適合接入互動產品流程

現有公開資訊較偏向服務化體驗:可先在 Vidu Stream 網頁建立角色、選擇或 clone 聲線,再開啟麥克風與鏡頭進行 live call;團隊要接入自家產品,則更可能經 API 而非直接本地完整重建。GitHub 儲存庫目前公開了論文、說明文件與入口,但未見完整本地訓練或推理流程,較像展示能力與提供接入方式的研究/產品型開源項目。

取捨也很明顯:它強調流暢、低延遲、可長時間互動,代表優先次序未必是最高解析度或最複雜鏡頭語言。受益最大的會是做虛擬主播、互動陪伴、角色扮演、品牌數字人和即時內容演示的團隊;要做電影感分鏡、長敘事剪輯或高度後期控制,現階段未必是它最強的一面。相關模型則包括 Vidu S1 本身,以及同一服務脈絡下的 Vidu Stream 互動入口。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, 數字人, 視覺模型, 多模態模型, 視頻模型, API, Clone, 語音, Dataset 數據集

IdeasHaveGenomes:用血統追蹤科研點子

研究提案寫得像樣,未必代表模型真正明白想法點樣演化。IdeasHaveGenomes把重點放在「點子血統」,專門測試 AI 能否追蹤繼承、變化同重組。

Ideas Have Genomes overview

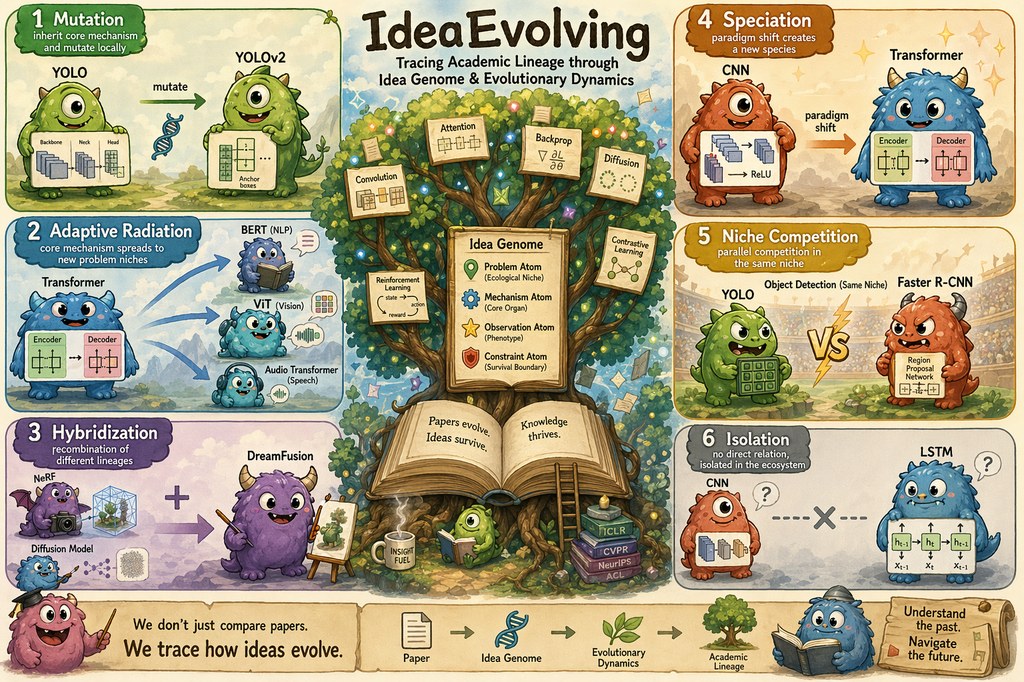
只會搵相似論文,已經唔足夠判斷 AI scientist 是否真係理解研究想法。IdeasHaveGenomes 把科學點子當成有 lineage 的對象去看,屬於 benchmark/數據集類型的項目,針對的正是 Auto Research 入面最難驗證的一環:模型能否講清楚一個 idea 由邊度嚟、點樣修補舊限制,最後點解值得延伸。

現有做法好多時集中在 related paper retrieval、proposal writing,或者用開放式生成結果做人手印象分。作者認為呢種範式捉唔到 inheritance tracing 同 evolutionary reasoning,所以提出 IdeaGene-Bench(IG-Bench),把任務分成封閉式測試 IG-Exam,同埋用 Population-Evolution Score(PES)評分的 IG-Arena,前者問理解是否精準,後者先看生成內容有冇 lineage 根據。

項目的可取之處,在於它唔只問「像不像新點子」,而係追問 Heredity、Variation、Selection 有冇成立。資料規模亦算完整,包括 1,961 條 golden lineage traces、1,085 個 Idea Genome objects、920 筆 GenomeDiff records,覆蓋 10 個 scientific domains;IG-Exam 進一步拆成 42 類 task、1,029 個 closed-form instances,適合做可重覆比較。

  • IG-Exam 主要測 abstraction、inheritance tracing、evolutionary reasoning、lineage verification
  • IG-Arena 針對開放式提案生成,用 PES 檢查血統延續與變化是否合理
  • 項目可用 OpenAI-compatible API 跑 smoke test 或完整評測,不一定綁死單一模型
  • 現有結果反映難度高,最佳 IG-Exam exact accuracy 只有 27.3%,最佳 T4 verification 為 17.4%
  • 榜單涵蓋 GPT、Claude、Qwen、Gemini、DeepSeek,以及 AI Scientist v2、Codex、Claude Code 等系統

部署理解上,這不是拿來直接替代研究助手的成品工具,而是用來測試模型或 agent workflow 是否真的具備「科研點子血統推理」能力。較適合做 AI scientist、research agent、proposal generation pipeline 的團隊評測基準;想比較不同模型、judge 組合,或者檢查生成提案有冇沿住正確 lineage 發展,這個項目比一般文字基準更有辨識度。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Qwen, 微軟, OpenAI, DeepSeek, Gemini, API, 框架, Anthropic, 中國, Dataset 數據集

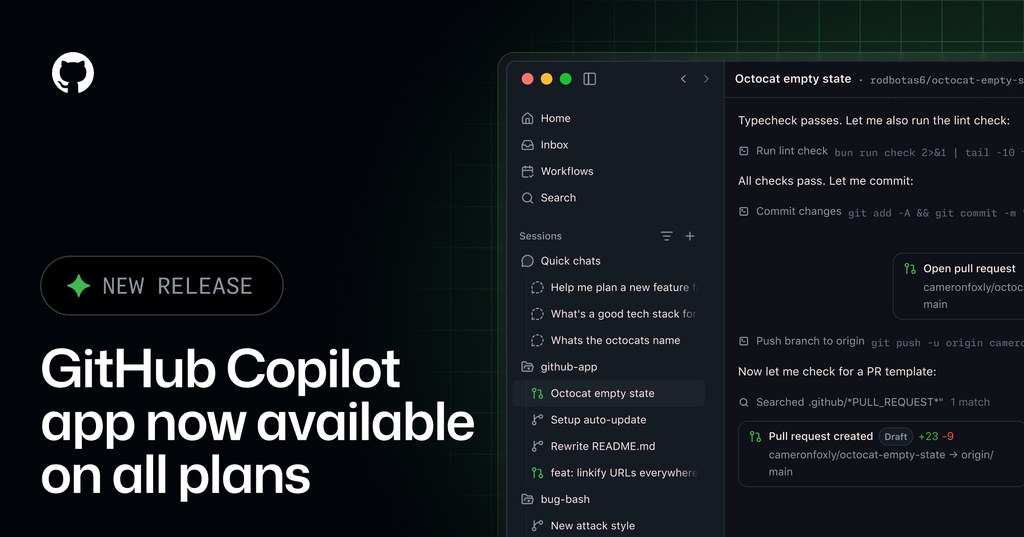
GitHub Copilot 桌面 app 全面開放

而家唔止付費用戶先可用 GitHub Copilot app,連 Free 同教育方案都可以直接開跑。你可以把它理解成將 agent-driven development 帶到桌面的入口。

Og image

寫程式想快啲進入 agent-driven development,而家門檻低咗好多。GitHub Copilot app 已經開放畀所有 Copilot 方案使用,涵蓋 Copilot Free 同 GitHub Education,並且支援 macOS、Windows 同 Linux,等開發者可以直接由桌面開始工作。

對一般開發者而言,重點唔只係「多一個 app」,而係登入 GitHub 帳戶後,幾下點擊就可以開 session,將 Copilot 由編輯器內的輔助,延伸到更完整的桌面互動流程。呢個變化對想集中用單一入口管理開發節奏、快速試 agent 工作方式的人會更有吸引力。

另一個取向幾清楚:就算冇訂閱 Copilot 方案,仍然可以用 bring your own key(BYOK)接上自己嘅 model provider 跑 session。即係話,GitHub 將入口開放得更闊,一邊照顧現有 Copilot 用戶,一邊容許偏好自選模型供應商嘅團隊或個人保留彈性。

  • 所有 Copilot 方案都可使用,包括 Copilot Free 同 GitHub Education
  • 支援 macOS、Windows、Linux 三個桌面平台
  • 可用 GitHub 帳戶直接登入並快速開始 session
  • 冇 Copilot 訂閱亦可透過 BYOK 連接自有 model provider
  • Business 或 Enterprise 方案需由管理員啟用 Copilot CLI 政策設定

對團隊環境來講,Business 同 Enterprise 用戶仲要留意權限設定:組織或企業管理員需要先在 policy settings 啟用 Copilot CLI,先可以存取 GitHub Copilot app。呢點反映出 GitHub 既想擴大可用範圍,同時亦保留企業管理所需的控管方式。

項目主頁

Categories: Agentic, 微軟, API, Mac, Linux, 編程

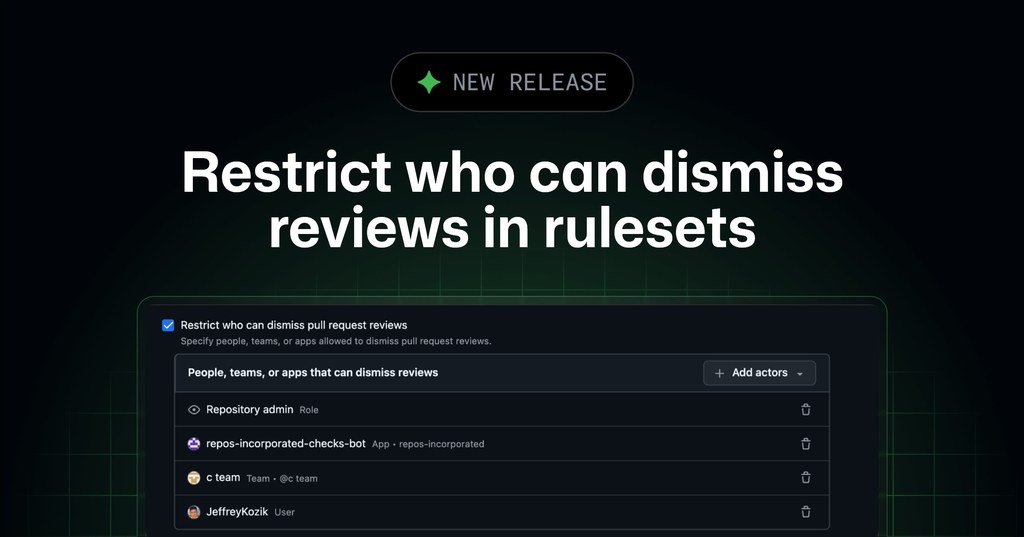
GitHub 規則集新增審核撤銷權限控制

團隊而家可以直接限制邊啲人有權撤銷 pull request 審核。對需要嚴格合併流程嘅項目,呢個更新可減少誤操作同權限過闊帶來嘅風險。

Og image

當團隊依賴 pull request 審核去把關程式碼質素時,最怕唔係冇人批核,而係批核已經完成後,任何唔合適嘅人都可以把審核撤銷。GitHub 今次更新屬於 repository rulesets 功能強化,處理嘅正正係合併前權限邊界唔夠細緻呢個問題。

新設定放入 Require a pull request before merging 規則之中,管理者可以直接指定邊啲 users、teams 同 apps 能夠 dismiss reviews。對比以往較寬鬆或者分散嘅管控方式,呢種做法將審核撤銷權限收返去規則集內統一管理,分支保護流程會更清晰。

重點整理:
– 可限制特定 users、teams、apps 撤銷 pull request reviews
– 設定位置已整合到 repository rulesets 既有審核規則內
– 可透過 UI、REST API 同 GraphQL 配置
– 功能已經 generally available,適用於 github.com 上嘅 repository rulesets

呢個更新最適合有多人協作、需要明確審批責任,或者要配合內部治理要求嘅開發團隊。Rulesets 本身已經係 GitHub 建議用來保護 branches 嘅方式,而家再加上審核撤銷限制,等項目喺合併前多一層可追蹤、可控嘅流程保護。

使用上做法唔複雜,只要打開 repository-level ruleset,啟用 Require a pull request before merging,再選擇 Restrict who can dismiss reviews 就可以。呢類更新唔係花巧功能,而係直接改善日常協作入面最常見嘅權限管理細節。

項目主頁

Categories: 開源, 微軟, API, 教學, 軟件, 安全

OmniRoute:免費 AI 路由閘道值唔值得用

想用 Claude Code、Codex 或 Cursor,又唔想被單一供應商限額綁死,OmniRoute 提供咗一條幾務實的路。它把免費模型池、備援切換同壓縮節省 token 放埋一齊。

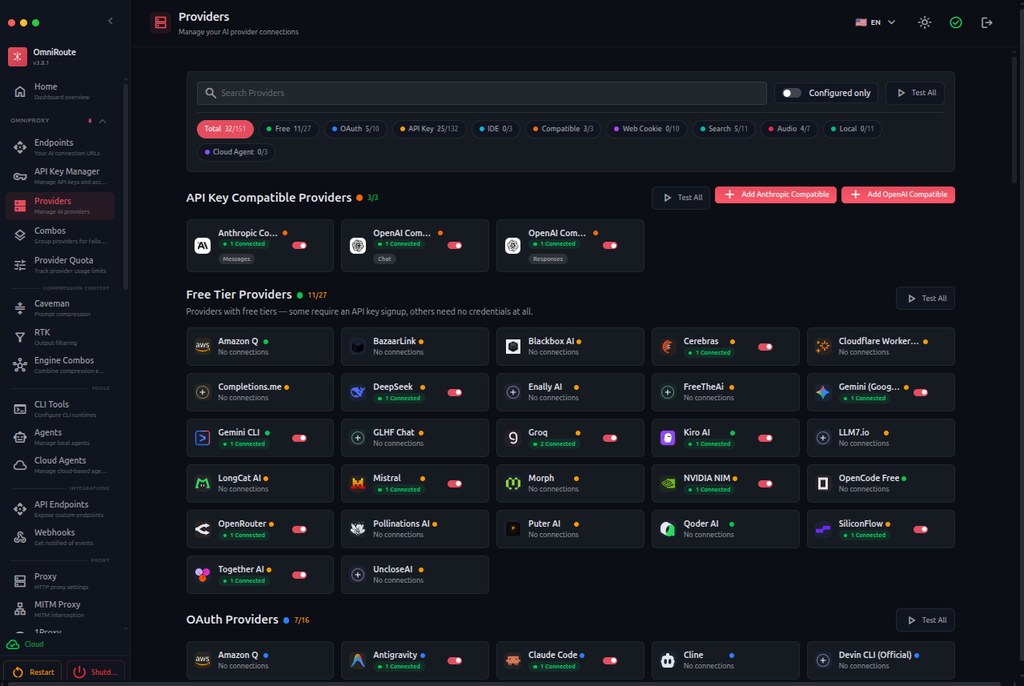
OmniRoute Dashboard

寫程式最怕做到一半先撞到配額上限,或者工具只綁死某一個模型。OmniRoute 把自己放在 AI gateway 呢個位置,直接處理多個 AI coding 工具同多個模型供應商之間的路由問題,重點唔係再造一個聊天介面,而係幫你維持請求可用、控制成本,並用 auto-fallback 減少中斷。

同類做法通常會主打單一 API 聚合,OmniRoute 的取向明顯更偏向「免費額度整合 + 路由策略 + 壓縮節流」。它聲稱可接到 237 個 providers,當中 90+ 提供 free tiers,並以 RTK + Caveman compression 把 token 消耗壓低 15% 至 95%。呢個方向的好處係對長提示、程式碼上下文同重複輸出較有幫助,但壓縮始終係取捨,所以它加咗 inflation guard,遇到壓縮後反而變長,就會送回原文。

OmniRoute + OpenCode: 100% Free AI Coding Setup, Free AI Gateway
New FREE Unlimited AI Coder | OmniRoute

你可以把它理解成放在 Claude Code、Codex、Cursor、Cline、Copilot、Antigravity 後面的中介層。部署後,工具經同一個 endpoint 出請求,再由 OmniRoute 分配到 Claude、GPT、Gemini 及其他供應商;README 也提到每個模型會列出本月已用與剩餘額度,並標示 provider terms,這點對團隊控管比較有用。

幾個值得留意的重點:
– 定位屬於工具 / 閘道型軟件,解決的是多模型切換、免費額度整合同配額中斷
– 支援 Claude Code、Codex、Cursor、Cline、Copilot、Antigravity,適合多工具並行的開發流程
– 以 documented free tokens/month 作招徠,現有資料提到穩定約 1.6B,首月可到 2.1B
– 內建 17 routing strategies,並加入 auto-fallback,減少單一 provider 失效帶來的停頓
– 壓縮模組已針對 German、French、Japanese、Chinese,以及 Gradle、.NET 輸出做過強化

受益最大的一般會係重度依賴 AI 編碼助手的個人開發者、細團隊,同想把成本壓到最低的實驗性項目。要留意的是,免費池本身受各 provider 條款影響,OmniRoute 雖然強調統計方式較透明,但效能與穩定性仍然建基於外部服務;它較像一個把資源調度做得更聰明的控制層,而唔係保證品質一致的模型平台。

GitHub

Categories: 開源, 微軟, Gemini, API, Vibe Coding, 工具, IDE, 編程, Anthropic

Page 6 of 9
1 4 5 6 7 8 9