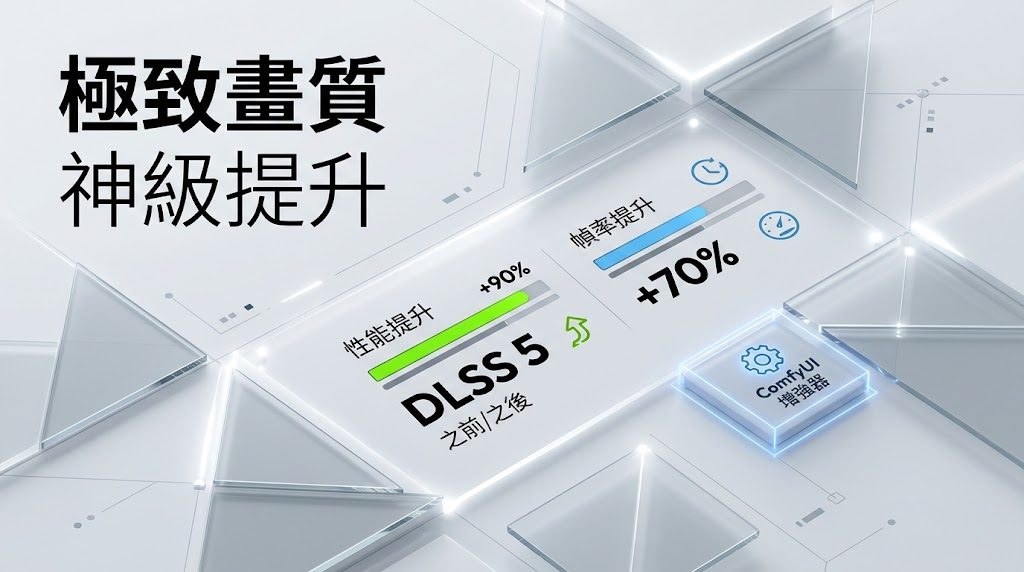
幾個重要限制:nr intensity 鎖死喺 1.0,1.0、1.5、2.0 嘅輸出 bit identical;skin structure strength 必須開啟 automatic mask 先有效,閂咗之後所有皮膚參數都唔再產生變化;nr preset 喺任何數值下都係 bit identical。只有 local structure strength 同 local tone strength 係全程範圍真正可調。預設、J、K 幾個 dlss model preset 嘅源幀 detail energy 大約喺 0.56x 左右,呢個唔係銳化工具想要嘅走向,反映嘅係材質重建比邊緣強化重要嘅設計取向。
本地配音、廣東話與各地方言內容創作、Podcast 或短影片自動化產出,以及需要快速原型不同聲線的產品團隊,都比較容易受惠。程式碼以 PyTorch 開源,模型已上架 Hugging Face 與 ModelScope,可透過 Python API 呼叫,亦提供 Instruct API 處理聲線設計與編輯。
重點摘要:
多語言零樣本克隆:覆蓋 24 種語言及 21 種中文方言,包括粵語、四川話、上海話、福建話等。
統一語音生成框架:把克隆、聲線設計、語音編輯整合在同一模型內,避免切換多套工具。
純文字聲線設計:以自然語言描述性別、年齡、情緒等特徵即可合成全新聲音,無需參考音頻。
自由形式語音編輯:支援語義層改寫(插入、刪除、替換)及聲學層調整(語速、音量、音調)。
開源易取用:PyTorch 實作、Apache 2.0 授權,模型於 Hugging Face 與 ModelScope 提供下載。