NeuraDock Agent:把 7 通道 EEG 變成可用狀態訊號

這不是一般腦波展示工具,而是把7通道EEG整理成可供應用程式使用的即時狀態。它重點不在生成炫技介面,而在穩定解析、質量把關與本地處理。

Repository image for Neuradock/eeg-workstation-agent

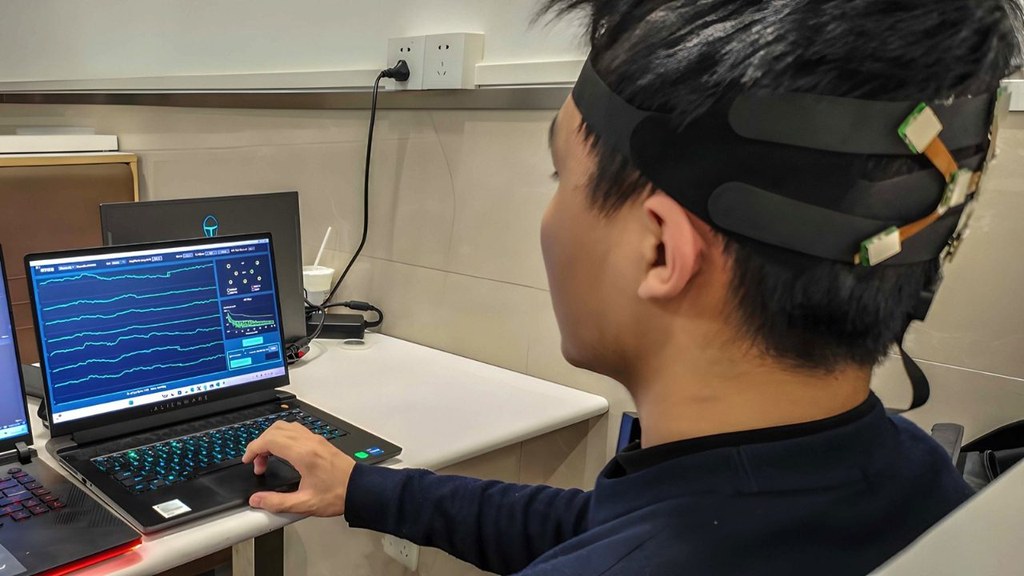
NeuraDock/eeg-workstation-agent 是一個本地優先的 Python 工具項目,也可視為面向應用整合的 EEG agent。它主要將 NeuraDock EEG Workstation 的 7 通道腦電訊號,轉成經過質量檢查的 visual cognitive-load 狀態,讓介面、XR、車載 HMI 或互動系統可以即時讀取,而不必直接處理原始 EEG。

現有不少 EEG 流程會把重心放在原始波形顯示、離線分析,或讓開發者自行拼接 preprocessing、quality control 與特徵提取;作者在技術文件中明確反對讓通用 LLM 直接對感測結果作自由解讀的做法。這個項目的取向,是把 deterministic local EEG engine 與 hardware-aware language layer 分開:前者負責解析、前處理、spectral workflows 與 machine-readable artifacts,後者只接收 allowlisted summary 與 versioned context pack,避免模型對 7-channel EEG 說出超出量測邊界的結論。

NeuraDock EEG Agent Workflow

部署路線算清晰。儲存庫列出 Python 版本範圍、支援 Windows、macOS、Linux,亦提供無硬件 synthetic replay,所以就算未買 NeuraDock EEG Workstation,也可以先啟動本地 dashboard 與 API,檢查 GET /api/status 會輸出哪些欄位;真正連接裝置時,Agent 會經 TCP 收流、做 online preprocessing,再輸出如 visual_load_indexalpha_peak_hzalpha_suppression_from_baselinequality.status 等狀態。示例資料要到另一個資料儲存庫下載,這裡沒有直接附上人類 EEG 數據,反映作者對資料安全與分發邊界相當保守。

和同類做法相比,它的差異不在「能否分析 EEG」,而在於它刻意收窄可宣稱的範圍。這套工具聚焦 posterior Alpha dynamics、within-subject Rest/Task visual cognitive-load comparison,以及 quality-gated adaptation,並清楚說明它不是 medical device,亦不能直接診斷 attention、fatigue、impairment 或跨個體比較表現。這種取捨令它的野心比一些泛用腦機介面平台細,但換來較可控的輸出與較低的誤讀風險。

  • 定位明確:屬於本地執行的 EEG 分析工具項目,重點是把 7 通道訊號轉成應用可讀狀態。
  • 測試門檻較低:有 synthetic replay,未接硬件都可以先驗證 dashboard、API 與流程。
  • 邊界控制做得細:LLM 不接觸 raw EEG 與 dense time-series arrays,只接收精簡指標與受控上下文。
  • 適合即時互動場景:視覺搜尋、adaptive vehicle HMI、cognitive load game 都是直接示範。
  • 資料解讀有限制:結果偏向個體內比較,不適合把不同人的 workload 分數直接放在同一把尺上。

性能描述方面,技術報告提供了幾個辨識度很高的訊號。其一,12 份錄音在十次 numerical repetitions 下得到相同 structured results,完整 Rest/Task 執行在三次重跑下亦產生相同 result、report 與 figure hashes,說明 deterministic pipeline 不是口號。其二,作者做了 request-capture 與 failure-injection experiments,檢查資料邊界與本地 artifacts 在 HTTP、格式錯誤及連線失敗下是否仍能保留。其三,boundary-awareness benchmark 涵蓋 ordinary 與 adversarial questions,並結合 qwen3.7-max 和 kimi-k2.6 生成輸出;這部分重點不是比較哪個模型最聰明,而是檢查語言層有沒有超越硬件與工作流容許的解釋範圍。

相關模型與組件方面,README 沒有把核心 EEG 推理包裝成 foundation model,而是以 reviewed workflows 為中心;可見的外部模型主要是 optional LLM mode 會用到的 LLM,例如 qwen3.7-max、kimi-k2.6。適合受益的人,包括做 HCI、XR、遊戲互動、復健訓練、工業監測與研究原型的團隊;他們想要的通常不是一套醫療級診斷系統,而是一個可以穩定輸出、容易接入前端或控制邏輯、又盡量把資料留在本機的腦訊號工具鏈。
項目主頁 · GitHub · Paper

Categories: Agentic, Qwen, API, 框架, Medical醫學, Mac, Linux, Python

ReMMDBench-Agent 驗證多模態假資訊

這是一組重現論文結果的研究代碼,集中比較三種多模態 misinformation detection agent 系統。重點不只看分數,亦看證據如何被拆解、檢索與重用。

Repository image for DANG-ai/ReMMDBench-Agent

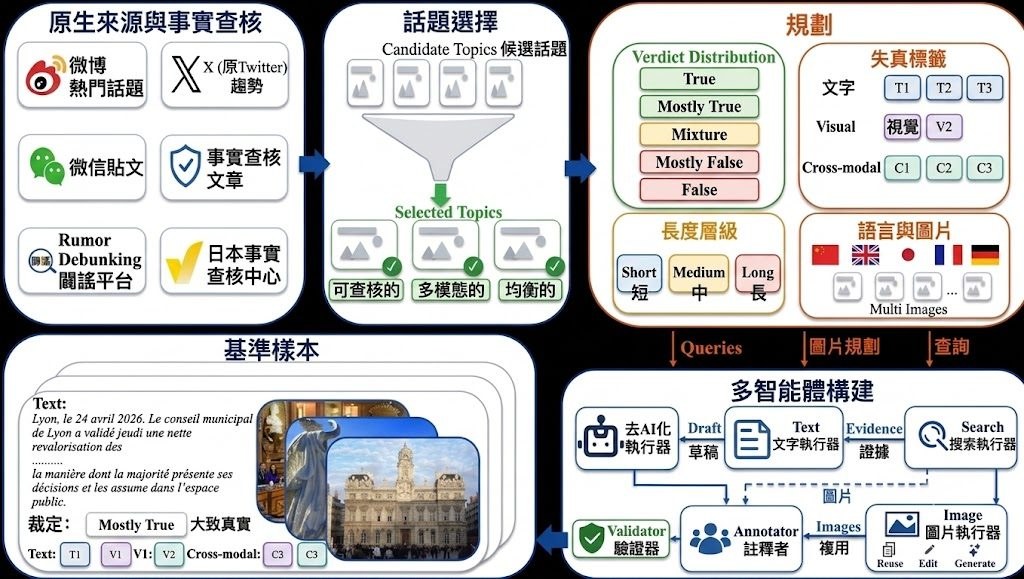
開發團隊來自上海交通大學、上海人工智慧實驗室、清華大學、中南大學,以及中國電子科技集團第十五研究所,核心作者把 ReMMDBench 同 ReMMD-Agent 一起公開,方向很明確:用較接近真實網絡帖文的方式,檢查圖文混合內容中的 misinformation。這個 GitHub 項目屬於研究原型加評測代碼集合,主要用來重現三個 multimodal misinformation detection agent 系統在 ReMMDBench 上的結果,並比較它們怎樣做判斷。

現有做法常把多模態假資訊檢測收窄成單圖、二分類,或者一次過把整段文字與圖片丟給模型判斷;作者認為這種 fixed-pass 判斷方式難以處理長敘事、多張圖片、跨語言與部分真實內容。這個項目因此提出一套以 ReMMDBench 為核心的 agentic 驗證路線:Baseline 1 是 3-stage MMD-Agent,Baseline 2 是 MCTS-based 5-verdict + 8-taxonomy agent,而主系統 ReMMD-Agent 則用 atomic decomposition、RAG(Retrieval-Augmented Generation)與 multi-expert judge,把結論建立在可追蹤的證據狀態上。

跟同類方法相比,ReMMD-Agent 的取向不是只追求一次答中,而是先把帖文拆成 atomic claims、image observations、text-image bindings,再檢索 multimodal evidence,之後重用 persistent memory,減少重複工具呼叫。這種設計的取捨很清楚:流程更長、配置更多,但換來較好的可解釋性,也更適合處理 five-way L1 veracity labels、8 個 L2 distortion labels,以及 multilingual multi-image 場景。

安裝與測試思路也相當具體。三個子項目各自有 requirements.txt、設定檔與啟動腳本;要先把資料根目錄指向 ReMMDBench,再在 .yaml.env 內填入模型端點與金鑰佔位內容,之後可先用 mmd-agent/test_qwen.py 這類健康檢查確認後端可回應,再跑各自的 evaluation scripts。倉庫已附上 Qwen-family 後端的保存結果與 artifacts,包含 Qwen 4B、9B、27B,亦明確標示 temperature = 0.0、LLM caching 與預建 RAG index,方便重現 headline numbers,而不必由零開始建立整套流程。

  • 主系統:ReMMD-Agent,核心結構是 atomic decomposition + RAG + multi-expert judge
  • 對照系統:3-stage MMD-Agent 與 MCTS-based t2-agent,方便看不同 agent 設計的取捨
  • 資料與標註:ReMMDBench 有 500 samples、2,756 images、5-way L1 與 8 類 L2 標籤
  • 相關模型:Qwen-family 4B / 9B / 27B;首頁亦提到 GPT-5.2 曾用於 leaderboard
  • 較適合的情境:研究團隊、事實查核流程設計者、多語內容審核與 agent benchmark 比較

性能方面,倉庫重點是重現論文中三套系統在 500-sample ReMMDBench 的結果,而不是提供一個即裝即用的線上服務。它較適合拿來做 benchmark 驗證、分析不同 agent pipeline 的表現,或者研究 evidence reuse 對多模態判斷有幾大幫助;要直接放進產品,仍要自行補回資料接入、服務封裝與更穩定的推理基建。

GitHub: https://github.com/DANG-ai/ReMMDBench-Agent

項目主頁: https://dang-ai.github.io/ReMMD/

Categories: 清華大學, 上海人工智慧實驗室, Agentic, RAG, 視覺模型, 多模態模型, Qwen, API, Image, 框架, 工具, 線上服務, Python, , 安全, 深度學習, 中國

Google AI Studio’s Interactions API

Interactions API 讓開發者用同一介面連接 Gemini 模型與 agents。它重點解決多種互動方式分散、整合複雜的問題。

Og image

Gemini Interactions API 是實驗性 API,可讓開發人員使用 Gemini 模型建構生成式 AI 應用程式。Gemini 是 Google 最強大的模型,打從設計之初就具有多模態的特質。可歸納內容,完美解讀、操作及結合語言、圖片、音訊、影片和程式碼等不同類型的資訊。您可以使用 Gemini API 處理各種用途,例如:跨文字和圖片進行推論、生成內容、對話式代理程式、摘要和分類系統等。

這是一個供開發者使用的 API,屬於 Google AI Studio 的 Interactions API。它的主要用途,是用一個統一介面去操作 Gemini models 與 agents,方便把模型回應、工具呼叫和代理人流程放在同一套工作流內處理。

和一般逐步拼接多個端點的做法相比,較值得留意的是它主打「統一」:同時面向模型和 agents,減少來回切換不同介面的負擔。這對要做多步驟互動、工具協調、或需要把 AI 行為包成穩定流程的團隊會更實用。

  • 統一處理 Gemini models 與 agents
  • 適合原型、整合與工作流測試
  • 方便把模型回應與工具呼叫串接
  • 較適合開發者與 agent 應用場景

項目主頁: blog.google

Categories: Agentic, AI productions, 模型, Google, OpenAI, Gemini, API, 軟件, 工具, 編程

dots.tts:支持廣東話的連續式語音合成

dots.tts 係一個 2B 參數 TTS 項目,主打直接由文字生成自然語音。它同時強調聲線模仿、情感表達同多語言表現。

dots.tts

dots.tts 是一個文字轉語音(Text-to-Speech, TTS)模型,主要用來將輸入文字轉成自然語音,並兼顧聲線模仿同情緒表達。它採用全連續、端到端的自回歸(Autoregressive, AR)設計,整條流程都唔用離散 token,這點同不少傳統 TTS 做法有明顯分別。

項目提供本地模型目錄或 Hugging Face repo id 載入方式,亦有 CLI、Python API 同 Gradio 網頁示範可試。用 --prompt-audio 配合 --prompt-text 可以做延續式 cloning;只給 --prompt-audio 時則走 x-vector-only cloning;而 --language 可幫多語言或 code-switching 文字鎖定語言標籤。

这开源TTS 太狠了:3 秒复刻音色+情绪迁移,还能实时朗读!

它的取向偏向高保真同穩定生成,而唔係只追求速度。官方數據顯示,dots.tts 在 Seed-TTS-Eval 取得較佳平均表現,zh / en / zh-hard 的 WER 分別係 0.94% / 1.30% / 6.60%,MiniMax multilingual benchmark 亦有 83.9 的平均 speaker similarity,反映它在聲音相似度同多語言能力上都有競爭力。

較適合做語音產品原型、配音流程、虛擬人聲、以及需要少量參考音去複製語氣嘅團隊。要留意參考音大約 10 秒較合適,而且 --prompt-text 必須同參考錄音內容一致,否則穩定性會下降。

  • 2B 參數、全連續 AR TTS,核心目標係文字轉自然語音
  • 支援 voice cloning、多語言同情感表達
  • 提供 CLI、Python API、Web Demo,方便測試同部署
  • 評測上在 Seed-TTS-Eval 同 MiniMax multilingual 都有強勢成績
  • 相關模型包括 dots.tts-base、dots.tts-soar、dots.tts-mf

GitHub: https://github.com/rednote-hilab/dots.tts

模型: https://huggingface.co/collections/rednote-hilab/dotstts

Categories: 開源, 文字轉語音, 模型, API, Audio, Clone, Python NLP, Python, 語音

SkillHarness:幫 CUA 學得更安全

一篇聚焦 Computer-Use Agents 安全技能學習的研究原型。它針對動態介面與 prompt injections,重做技能學習與重用方式。

Repository image for YurunChen/SkillHarness

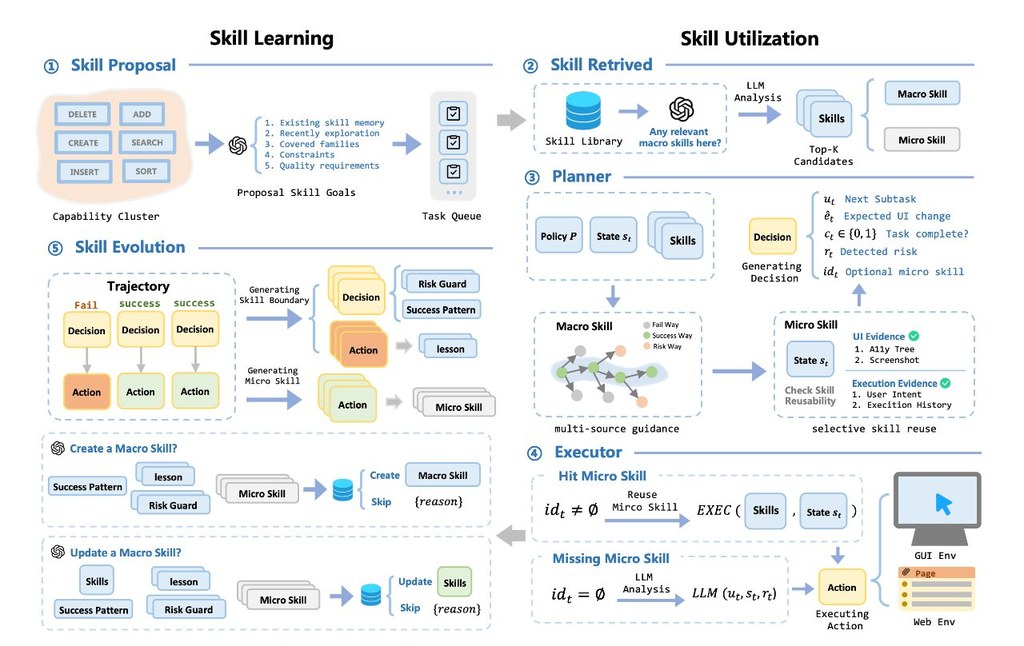
這是一個研究原型,現時 GitHub 儲存庫主要提供 SkillHarness 論文 PDF。它要解決的是 Computer-Use Agents(CUAs)在動態電腦介面中學習與重用技能時,容易受 prompt injections、彈窗與環境變化影響,令已學到的技能變得危險或不穩定。

現有做法多數沿用「從成功軌跡抽取可重用技能」這個範式,常見表達形式包括函式或 API,但作者認為這類方法預設環境是 static and safe。SkillHarness 改用 safety-constrained interaction process 去看待技能的學習與使用,核心不是多學幾個技能,而是先判斷哪些技能在當下情境仍然安全。

論文提出兩個辨識度很高的設計:一是 skill boundary,用 multi-source supervision signals 從互動軌跡中找出 safe skills;二是 selective skill reuse,按當前情境拆解任務,只啟動部分技能,而不是整包照搬。這種取向的代價,是系統設計會比單純收集成功軌跡更複雜,但換來的是在動態環境下更穩定的行為。

現有儲存庫未附程式碼,所以暫時不能直接部署或重跑實驗;較合理的理解方式,是先把它當成一套 CUA 安全技能框架來讀。若之後作者釋出實作,最需要觀察的會是它怎樣接入代理的軌跡資料、怎樣建立 safety constraints,以及能否在 OSWorld 一類電腦操作基準以外維持效果。

  • 類型屬於框架/研究論文項目,重點在安全技能學習,不是即裝即用工具
  • 主要批評舊方法依賴 static and safe environment 假設,放到動態場景會學到不安全技能
  • 論文聲稱 learned skills 的 unsafe rate 降低 57.1%,並提升動態環境下的 execution stability
  • 較適合研究 Computer-Use Agents、代理安全、桌面自動化與長流程任務的團隊留意
  • 相關脈絡模型與方法包括 Computer-Use Agents(CUAs)、Voyager、ASI,以及以函式/API 形式封裝技能的路線

GitHub: https://github.com/YurunChen/SkillHarness

Paper: https://arxiv.org/pdf/2606.20636

Categories: 開源, Agentic, 模型, API, 框架, 工具, , 安全, Skill 技能

MCompassRAG 把 RAG 檢索變得更準更省

MCompassRAG用主題訊號補強檢索,重點是推理階段不用再叫 LLM。它想解決段落級 RAG 容易撈錯資料的老問題。

alt Method

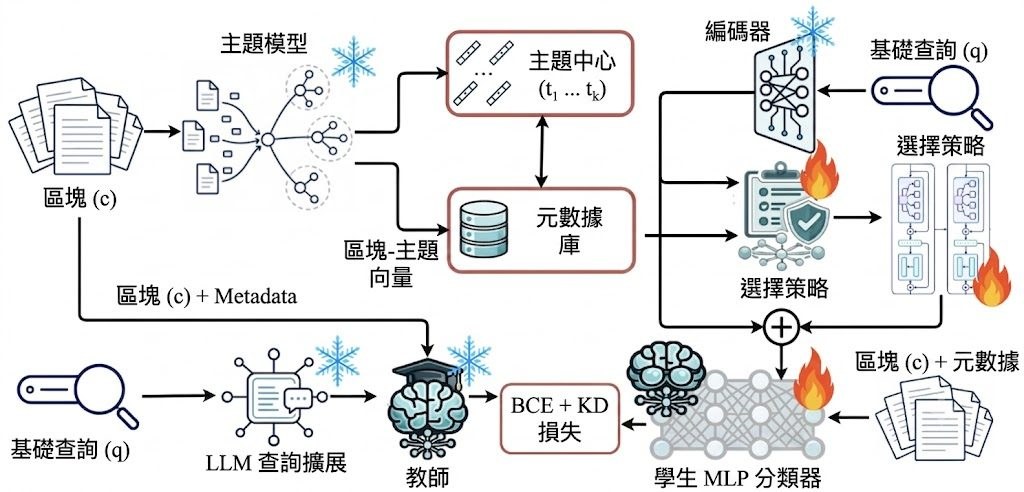
現時不少 RAG 會用 dense retrieval,直接把查詢同文本 chunk 的 embedding 拿去比對;當 chunk 切得較粗、語料又雜,語意接近未必等於真正答到問題。MCompassRAG 屬於檢索框架,做法是替段落加入 topic metadata,再用 LLM teacher 離線產生判斷訊號,蒸餾成一個輕量 retriever,修正「只靠 chunk embedding 排名」這種固定範式的偏差。

它的取向幾清楚:把較重的判斷放在訓練前期,推理階段只保留 metadata bank、embedding lookup 同小型 scorer,所以標明可做到 zero LLM calls at inference。這個取捨很適合想保留檢索速度,但又嫌傳統向量檢索太粗糙的團隊;代價是前處理較長,要先訓練 topic model,再生成 distillation data。

項目流程分成幾步:先準備語料、訓練 topic model、生成蒸餾資料、建立 metadata index,再訓練 retriever。環境上要 Python 3.10+、PyTorch 2.x、Transformers 4.51+,而且建議有 CUDA GPU;OpenRouter API key 只在 Step 2 — Generate distillation data 需要,之後檢索本身不依賴 LLM 連線。

可留意的重點有幾個:
– 不只重排結果,而是把 topic signal 放進 retriever embedding space 一齊學習
– 支援可插拔 topic model backend,現成有 CEMTM、ETM、CWTM、SoftLTM
– 推理成本貼近 embedding model latency,較適合高頻查詢場景
– 比起純 dense retrieval,更著重 paragraph-level evidence quality

作者強調它會在 complex retrieval benchmarks 提升 evidence quality 同效率,但目前倉庫內容較像 research implementation,未見非常完整的產品化基準表。較受惠的會是做知識庫問答、文件搜尋、企業內部檢索的團隊,尤其當資料主題分散、段落切分又未必夠細時,MCompassRAG 的 topic compass 概念比單純換一個 embedding model 更有分析價值。

GitHub: https://github.com/AmirAbaskohi/MCompassRAG

項目主頁: https://huggingface.co/papers/2606.18508

Paper: https://arxiv.org/pdf/2606.18508

Categories: 開源, RAG, Embedding, 模型訓練, API, 框架, Python NLP,

Dataset:EgoCS-400K 補足遊戲世界模型數據缺口

這是一個為 World Models 準備的大型第一身遊戲數據集,重點是把影片、操作、狀態與文字描述對齊。

EgoCS-400K dataset overview

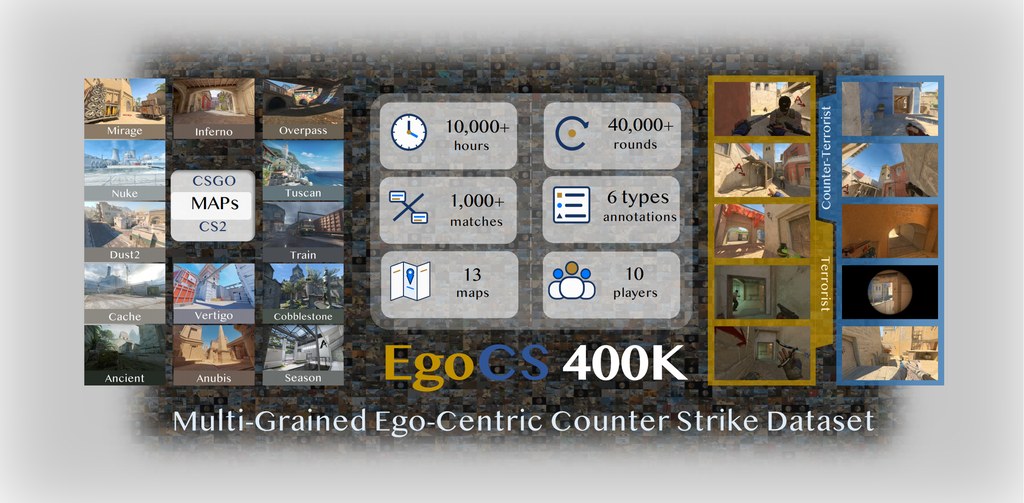
現有做法多數依賴 captioned videos、機械人數據,或模擬器軌跡來訓練 World Models,但前者缺少可執行動作與可靠狀態,後者又常受成本、場景規模或真人互動不足限制。EgoCS-400K 就是針對這個缺口而設的 Dataset 數據集,用公開的 Counter-Strike / CS2 demo 重建第一身視角,將影片、控制輸入、遊戲狀態與語言描述同步整理。

這個項目最核心的價值,不只是「有很多影片」,而是把 replay-grounded 資料做到 tick-level telemetry 對齊。資料同時包含 keyboard/mouse inputs、atomic actions、protected action chains、DP-based temporal segments,以及 multi-grained video-language captions,令模型不只看到畫面,還能追蹤玩家當下做了甚麼、為何畫面會變。

官方資料顯示,它涵蓋超過 400,000 段 first-person videos、10,000 小時以上 gameplay、1,000 多場比賽、40,000 rounds、13 張地圖,規模相當大。它支援的任務亦很明確,包括 action-conditioned future prediction、state- and event-aware scene rollout、replay-grounded captioning,以及 agent egocentric action understanding。

想了解內容,可先用公開 viewer 直接查看樣本,再按需要處理影片;若要生成 VLM captions,才需要 API key。較適合研究 World Models、Gaming Agent、Computer-use agents(CUAs)相鄰方向、影片理解,或想研究人類決策與視角變化如何連動的開發者。

  • 類型屬於 Dataset 數據集,主要解決互動式 World Models 缺乏高質素「影片-動作-狀態-語言」對齊資料的問題
  • 舊範式依賴 web video、robotics data 或 simulator traces,各自欠缺狀態、規模或真人軌跡
  • 辨識度最高的設計,是 replay-grounded、tick-level telemetry 與多粒度標註放在同一條時間線
  • 適合做未來畫面預測、事件感知生成、第一身動作理解與 captioning 研究
  • 相關方向與模型包括 World Models、vision-language-action models、video generation models、Gaming Agent

如果你只想找一般遊戲影片數據,EgoCS-400K 可能顯得偏研究型;但若你在意動作如何驅動畫面與事件,這個項目的資料結構明顯比普通影片庫更有分析價值。它未必直接等於完整訓練方案,但作為高對齊、高時間解析度的基礎數據,定位相當清晰。

GitHub: https://github.com/EgoCS-400K/Dataset

Paper: https://arxiv.org/pdf/2606.18180

Categories: 開源, 香港城市大學, Agentic, 多模態模型, 世界模型, 模型訓練, API, Video, Robotic, IDE, , 動畫, Dataset 數據集

Ponytail:幫 AI Agent 減少大量的程式碼

Ponytail 是給 AI Agent 用的規則型工具,重點不是炫技,而是逼模型先刪繁就簡。它特別適合想減少過度工程化的人。

Ponytail, the lazy senior dev

Ponytail 是一個針對 AI Agent 的工具型項目,核心作用不是取代模型,而是替模型加上一套固定判斷規則,令它在寫程式前先問自己:這段東西是否真的需要存在、標準函式庫能否處理、平台本身有沒有現成功能。它想解決的問題很直接,就是不少 AI Agent 會把簡單任務寫得太重,順手加框架、包裝層、額外抽象,最後程式碼變多、回應變慢,成本也上升。

這個項目已相當成熟。它把「少寫不是偷懶,而是保留必要部分」變成一條清晰階梯:先跳過不需要的東西,再優先用 stdlib、原生平台功能、已安裝依賴,最後才自己寫最少可行實作。這種設計對 AI Agent 特別有效,因為模型常見問題不是完全不懂,而是太願意補很多你未必需要的東西。Ponytail 等於把資深工程師那種「先刪再寫」的習慣,包成可重複套用的規則。

如果你想試它,先找幾類容易被模型寫得過火的小任務,例如日期輸入、debounce、rate limiter、簡單驗證或 CSV 處理。倉庫資料顯示,它支援 Claude Code、Codex、GitHub Copilot CLI、Gemini CLI、OpenCode、OpenClaw 等多種環境,亦即它不是綁死單一平台,而是瞄準「那些 AI Agent」的日常編碼流程。對於經常要用 Agent 產生前端小功能、工具腳本、日常後端邏輯的人,這類規則比再換一個新模型更實際。

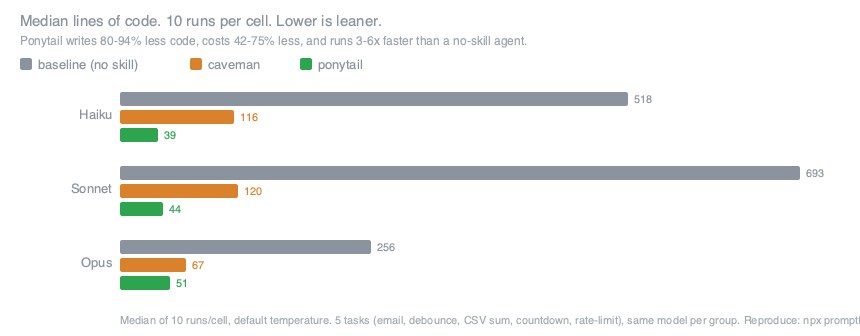
在 Claude API 的基準測試中,官方列出每項任務程式碼可減少 80% 至 94%,延遲快 3 至 6 倍,成本下降 42% 至 75%。不過這些結果有清楚前提,只能代表特定模型與提示方式下的中位數表現,並非所有模型都一定受惠;倉庫亦明言像 GPT-5.5 這類較簡潔的推理模型,規則注入與思考步驟本身可能抵消節省效果。這種寫法反而增加可信度,因為它沒有把 benchmark 包裝成放諸四海皆準的勝利宣言。

  • 重點不是生成更多程式,而是限制 AI Agent 只寫任務真正需要的部分
  • 支援多個 Agent 宿主,包括 Claude Code、Codex、Gemini CLI、OpenClaw 等
  • 提供 /ponytail-review/ponytail-audit/ponytail-debt 等指令,方便檢查過度工程化
  • benchmark 數據亮眼,但倉庫已提醒不同模型、提示長度與回合數會影響結果
  • 適合經常叫 AI Agent 寫工具碼、介面小功能、重複邏輯的人

Ponytail 的創新在於它把工程判斷流程產品化,讓 AI Agent 先經過一道「有沒有更省、更原生、更少依賴」的篩選。這令它比較像一個行為約束層,而不是新模型或框架。相關模型與環境方面,倉庫內容直接提到 Claude 的 Haiku、Sonnet、Opus,也提到 GPT-5.5,並覆蓋 Codex、Gemini CLI、Antigravity CLI、GitHub Copilot CLI 等代理工具鏈。若你想要的不是更花巧的生成能力,而是更穩定地避免 AI Agent 過度設計,這個項目有很明確的價值;若你的工作本身需要大量自訂架構與長鏈依賴,它未必會永遠選出你最喜歡的答案,但至少會迫使模型先證明「為何需要寫那麼多」。

GitHub: https://github.com/DietrichGebert/ponytail

Categories: 開源, Agentic, AI productions, 模型, 微軟, OpenAI, Gemini, API, 框架, 工具, IDE, , OpenClaw, Anthropic, Skill 技能

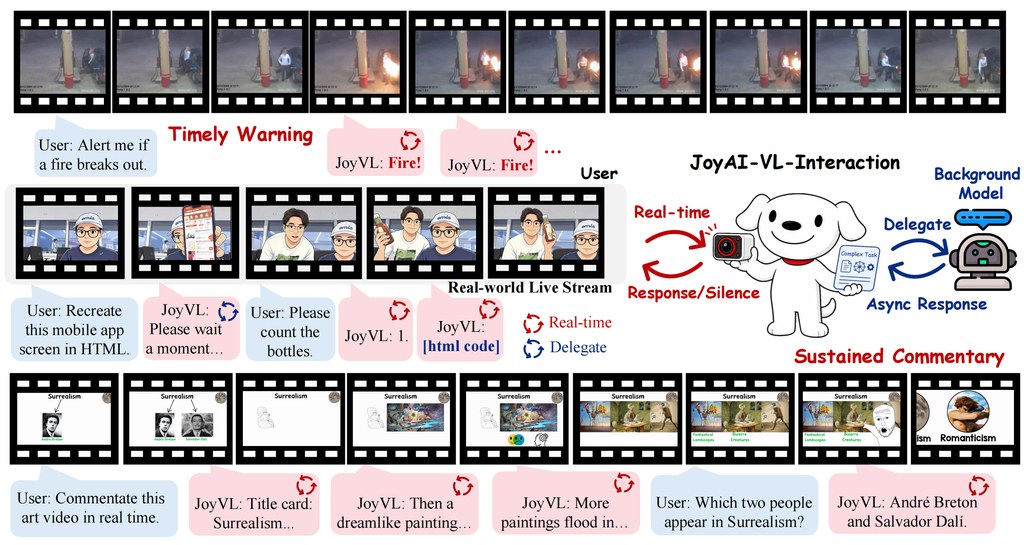
JoyAI-VL-Interaction 把影像助手變主動

這不是等你發問的聊天模型,而是持續看畫面、自己判斷何時出聲的互動項目。

JoyAI-VL-Interaction overview

現時多數視覺語言模型仍然沿用 turn-based 問答範式:用戶問一句,模型答一句;就算放進視像通話或直播介面,底層仍是被動回應。JoyAI-VL-Interaction 直接挑戰這個做法,改成持續觀看、按秒判斷要沉默、回應,還是把難題交給背景模型處理,目標是把 VLM 從「被問先答」推向即時互動。

這是一個多模態模型可部署系統項目,想解決的不是普通問答,而是「畫面中的關鍵一刻不會等人發問」這個問題。技術報告提到它是 8B vision-first 模型,支援 real-time video-language interaction,並配合 time-aligned interaction data、training recipe 與完整系統,重點放在時間感、主動觸發與持續在線。

如果你想理解它是否適合自己,最容易的測試場景是把 webcam、直播畫面或監控串流接入,觀察它會否在有事件時主動開口,而不是每次都等指令。這種模式較適合直播助理、居家提醒、遠端看護、商務示範,甚至要一邊看影像一邊調用 API 或 agent 的流程。

  • 核心改動是由問答式互動,轉向 watch-and-do 式互動
  • 模型每秒自行決定沉默、回應或 delegation
  • 系統可接駁 ASR、TTS、memory、API 與其他 agent
  • 報告稱可長時間處理連續影片,延遲維持在 sub-second
  • 人工評分比較中,對 Doubao 與 Gemini 的質量與時機掌握都有明顯優勢

創新位不只在模型本身,也在整個開放堆疊一起釋出:模型、數據、訓練方法與部署系統放在同一個項目脈絡,方便研究者與開發者沿原路線延伸。相關模型與組件包括背景大模型、API、agent,以及文中對比的 Doubao、Gemini;若完整開源內容如期提供,這個項目會對即時多模態互動研究有相當高參考價值。

GitHub: https://github.com/jd-opensource/JoyAI-VL-Interaction

項目:https://joyai-vl-video-future-academy-jd.github.io/JoyAI-VL-Interaction/

Categories: 開源, 字節跳動, 文字轉語音, Agentic, AI productions, 模型, 多模態模型, 視頻模型, 模型訓練, OpenAI, Gemini, API, Video, Image, 工具, IDE, 語音

MiniMax Mavis:多 Agent 協作處理長任務

MiniMax 將 Agent 升級為 Mavis,主打多 Agent 團隊協作。它瞄準長時間、步驟多、需要覆核的工作流程。

Og image

MiniMax 把原有 Agent 升級並命名為 Mavis,重點是加入 Agent Teams,讓多個 Agent 在桌面版同時運行,並以不同角色分工合作。這個方向主要處理單一 Agent 面對長任務時容易同時做執行者與裁判、資料整理與事實核對混在一起的問題。

過去把一個複雜要求直接交給單一 AI assistant,回覆速度可以很快,但當內容需要最新資料、來源整理、格式輸出與結果驗證時,流程便容易失焦。Agent Team 的做法是把任務拆成前台與後台、有驗收、有記憶的工作流;用戶仍然只需輸入一個要求,系統再判斷是否拆解、哪些角色可並行、哪些結果需要覆核。

對一般用戶而言,這項目最易理解的用法,是把它視為一個可分工的 AI 工作團隊。若你要處理長篇內容整理、跨格式輸出,或需要連續跟進的知識工作,Mavis 會比單一 Agent 更合適;如果只是一次性的小任務,官方亦暗示未必需要動用 Agent Team。

  • 支援多個 Agent 並行,適合長時間與複雜任務
  • 可建立不同角色分工,提升整理、驗證與交付流程
  • 用戶只需提供一次指令,系統會自行判斷是否拆解任務
  • 整合 TokenPlan 與 Agent Plan,CLI、API、Agent 共用訂閱與 credits

另一個更新是把 TokenPlan 與 Agent Plan 合併成單一訂閱,涵蓋 CLI、API、Agent,以及 M2.7、music、video、voice 等能力,credits 亦可共享。對已同時訂閱兩個計劃的用戶,官方表示會補送一個月會籍。這次內容未見具體跑分或量化基準,重點更偏向產品工作流與使用體驗的重整。

項目: https://www.minimax.io/blog/minimax-agent-team-long-running-1779893953

Categories: Agentic, AI productions, API, Video, 工具, 線上服務, IDE, MiniMax

Page 8 of 9
1 6 7 8 9