PaperPilot:把文獻搜尋變成可修改流程

找相關研究唔一定只靠一條關鍵字。PaperPilot把文獻搜尋拆成可檢查、可改寫的流程,令多輪互動真係會改變搜尋策略。

PaperPilot logo

做研究時,最麻煩往往唔係「搵唔到論文」,而係第一輪結果未必貼近你真正想追嘅方向。PaperPilot屬於開源框架,同時亦帶有已訓練代理模型,用 workflow induction 處理多輪學術文獻搜尋:它會圍繞 anchor paper 同查詢,先建立一個 typed DAG,再用澄清問題同後續回應去改動搜尋流程本身,而唔係只係喺原句後面再加條件。

呢個定位同一般固定 pipeline,或者只靠語言模型隱式推理嘅搜尋代理,好唔一樣。作者認為舊範式嘅問題,在於搜尋策略難以控制、難以檢查,亦唔容易根據人嘅偏好逐步修正;PaperPilot就把 keyword search、citation expansion、filtering、scoring、reranking、evidence extraction 組成可執行流程,每一步改動都可以保留,令結果更可追溯。

公開資料已經提供 live demo,亦有 FastAPI 後端、Streamlit 介面、evaluation scripts 同 tests,可理解成一套可部署、可觀察、可重跑嘅研究工具鏈。不過 initial release 未包含 web/ React front-end,同 training_infra/ 亦未完整開放;README 片段亦未見完整安裝流程,現階段較適合先用 demo、閱讀論文,再按儲存庫結構自行部署 backend 與本地介面。

  • 多輪互動唔止改 query,仲會直接編輯 typed DAG workflow
  • 約 50 個 typed operators,覆蓋檢索、集合操作、排序同證據抽取
  • 每次執行會保存流程、逐輪修改、時間與成本,方便重現結果
  • PaperPilot-9B 以 workflow imitation 加 preference optimization 訓練而成
  • 指標上較 base Qwen3.5-9B toolset agent 提升 Hit@5、MRR、nDCG@10,並把 workflow execution errors 由 9.5% 降到 0%

相關模型方面,核心比較對象係 base Qwen3.5-9B toolset agent,而實作後端就標明支援 OpenAI、Together、Anthropic 同 OpenAI-compatible endpoint。呢種設計對研究員、需要做系統性文獻整理嘅學生,或者想把檢索流程納入團隊知識管理嘅人都幾有價值;取捨在於它追求可控與可審核,流程會比單次對話搜尋更重,亦更依賴使用者願意逐輪提供清晰反饋。
項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Qwen, API, Dataset 數據集

LlamaIndex legal-kb:用代理工具重新定義法律文件檢索

LlamaIndex 開源 legal-kb 參考應用,將 Index v2 檢索封裝成 retrieve、find、read、grep 四種工具,供代理靈活查詢法律文件。

Og image

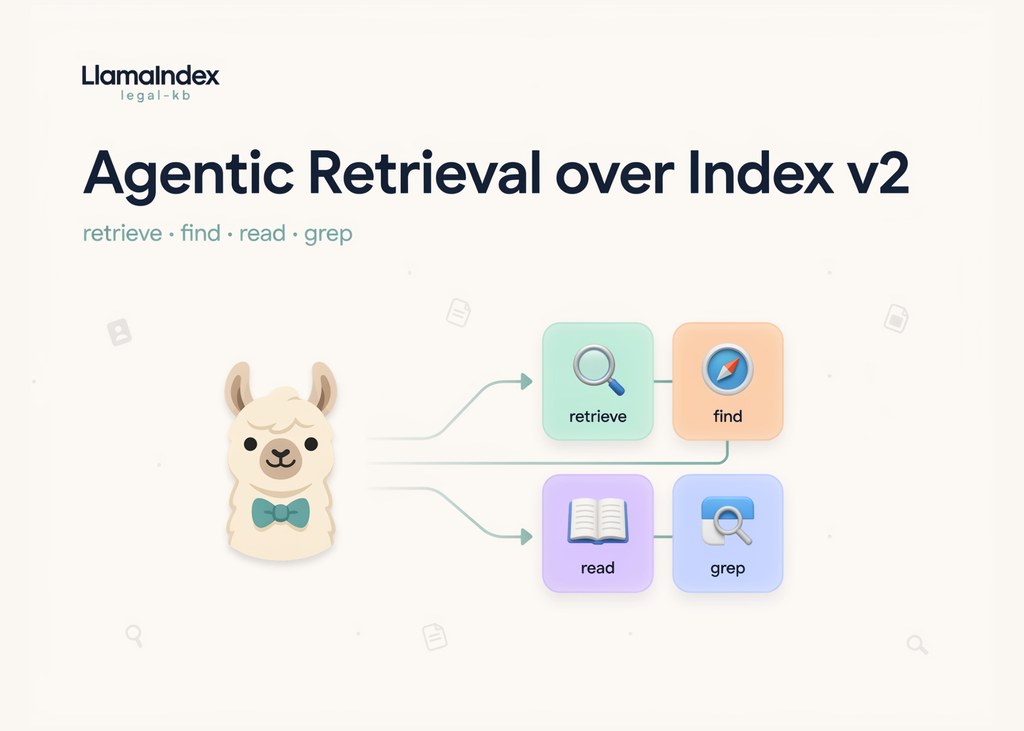
legal-kb 是 LlamaIndex 在 GitHub 上發佈的開源參考應用,定位為法律文件知識庫,並非函式庫。它採用 LlamaIndex Index v2(LlamaParse Platform)作為底層索引引擎,示範一種稱為 Retrieval Harness 的代理式檢索模式,讓 AI 代理以工具呼叫方式查詢文件。

與傳統單次嵌入搜尋不同,這個項目讓代理在每次提問時,能像工程師操作檔案系統那樣,自行組合多種檢索方式。系統提供四個工具:retrieve 執行混合語意搜尋並可選擇重新排序;findFiles 依檔名或子字串搜尋文件;readFile 讀取指定檔案的原始內容;grepFile 用正則表達式在檔案內搜尋特定模式。四個工具都對應 Index v2 的檢索 API。

運作流程是用戶登入後建立項目,上傳文件會自動在背景解析並建立 LlamaCloud Index v2,每個項目對應一個託管索引。聊天代理在對話中即時查詢該索引,由代理決定呼叫哪些工具、依照什麼順序執行,逐步收斂到答案。

由於工具設計貼近通用檔案操作,開發者可以將 Retrieval Harness 接入自己的代理,處理大量且持續更新的文件集合。法律研究、合規審查、文件審計等工作流會較受惠。

重點摘要:
– 開源參考應用,示範 Retrieval Harness 代理檢索模式
– 四個工具:retrieve(混合語意搜尋)、findFiles(檔名搜尋)、readFile(讀取檔案)、grepFile(正則搜尋)
– 每個項目自動對應 LlamaCloud Index v2 託管索引
– 文件上傳後於背景自動解析與索引
– 工具通用,可接入自訂代理處理大型動態文件庫

項目主頁

Categories: 開源, Agentic, Embedding, API,

TasteGap:量度人類與 LLM 的 Research Taste

這是一套研究構思評測工具,用來比較人類與 LLM 想法分佈有幾唔同。它唔係只看新穎度,而是追蹤研究口味偏向。

Repository image for ziyuuc/TasteGap

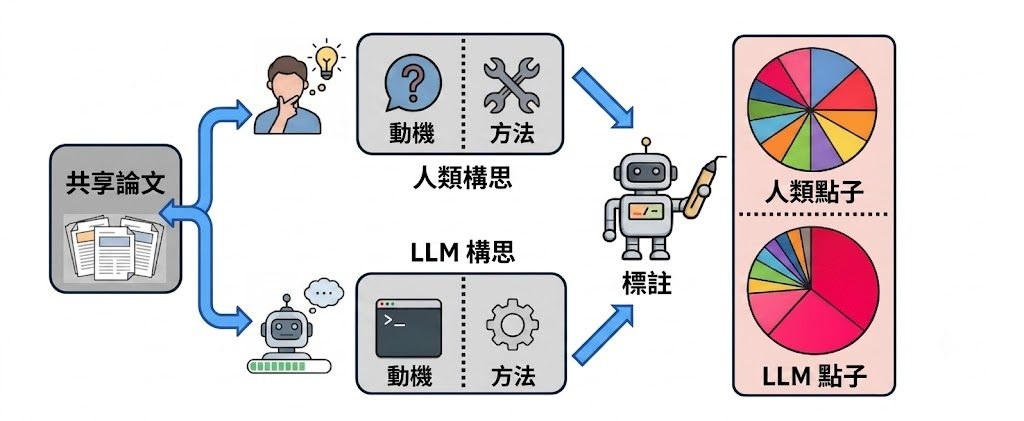
TasteGap 是一個研究評測工具與研究原型,核心工作是比較人類研究者與 Large Language Models(LLMs)生成研究構思之間的差距。它並非處理單篇提案好唔好,而是同一批文獻背景下,人類與模型會傾向提出邊類動機、邊類方法,從而量度所謂 research taste。

現有做法多數用 novelty、feasibility 或專家偏好去評分單個 idea,作者認為呢種固定範式只能判斷「像不像好主意」,但未必見到分佈偏差。TasteGap 改用 shared literature context:先從高質論文反推一組可能啟發該論文的 related works,再要求 LLM 從相同材料生成新 idea,之後用 two-axis research-taste taxonomy,分別標註 motivation 同 method,對比 human ideas 與 LLM ideas 的整體分佈。

GitHub 儲存庫目前提供 evaluation code,而唔係完整訓練框架。安裝理解上相當直接:準備 Python 依賴、設定 config.json 內的 generation 與 labeling 模型、填入 OpenAI 或兼容 API 端點,再用 JSONL 輸入跑 generate_ideas.pylabel_research_taste.py;要重現完整資料,則需另外下載 Hugging Face 上的 IdeaSeed。輸入記錄包含 paper title、URL、domain、related works,以及人類參考 proposal 的 motivation 同 method,代表這個項目設計重點是可重跑比較,而唔係單次展示結果。

作者提出的主要判斷幾清楚:不同 LLM 生成的 idea sets 都出現一致 distributional gap。LLM ideas 較集中在 bridge-like opportunities 同 synthesis methods,人類論文參考分佈就覆蓋更廣,表示模型可以提出合理點子,但研究取向仍然較窄,亦有系統性偏移。

  • 不是一般 brainstorming 工具,而是用來量度 ideation 分佈差異的評測項目
  • 保留 human ideation 與 LLM ideation 在相同文獻脈絡下的可比較性
  • 研究口味以 motivation 與 method 兩條軸線標註,分析角度比單純打分更細
  • GitHub 內容偏向生成與標註流程,完整資料需配合 IdeaSeed dataset
  • 適合做 AI for science、LLM ideation、科研流程研究的團隊作內部基準

TasteGap 沒有綁定相關模型,只要求在 generationlabeling 填入可用模型,並支援 OpenAI-compatible endpoint。這種設計方便團隊橫向比較不同 LLM,但現階段儲存庫未提供完整效能表或基準腳本整理頁,因此不算是交付即用型產品。

GitHub · Paper

Categories: 開源, 模型, OpenAI, Gemini, API, 工具, Python, Anthropic, Dataset 數據集


拆解 AI Agent Loop 核心運作

用最簡單控制流程,講清 AI Agent 點樣反覆調用模型與工具。

Og image

這是一段介紹 AI Agent 底層控制流程的教學影片。它主要用來解釋主流 Agent 為何能連續思考、調用工具並完成任務,核心其實是一個簡化版 while 迴圈。

內容重點不是堆砌框架名詞,而是把 Agent Loop 拆成幾個基本步驟:先問模型、按模型要求執行工具、把結果回填,再繼續詢問模型,直到模型不再要求工具。這種講法有助非技術讀者理解,很多看似複雜的 AI Agent,底層控制流未必複雜。

它要處理的問題,是怎樣讓語言模型由一次性回答,變成可逐步執行任務的系統。相比只靠單輪提示詞的做法,Agent Loop 多了狀態延續、工具調用與停止條件,因此更適合查資料、操作 API、分步完成工作等情境。

  • 核心概念:Agent Loop 可視為模型與工具之間的反覆回合
  • 主要流程:模型決定下一步,系統執行工具,再把結果交回模型
  • 關鍵價值:把複雜 Agent 拆成可理解、可實作的最小控制單位
  • 適用情境:想學 AI Agent、工具調用、任務自動化流程的人最受用

這類內容特別適合剛接觸 Agentic 系統、MCP、工具代理或自動化工作流的讀者,也適合寫程式的人建立正確心智模型。單靠目前提供的資料,未見具體效能數字、基準測試或完整程式實作細節,因此較適合視為概念導讀,而不是完整技術文件。

項目主頁

Categories: Agentic, MCP, Google, API, 框架, 安全

discrete_diffusion_RRG:離散擴散模型點樣寫胸肺 X 光報告

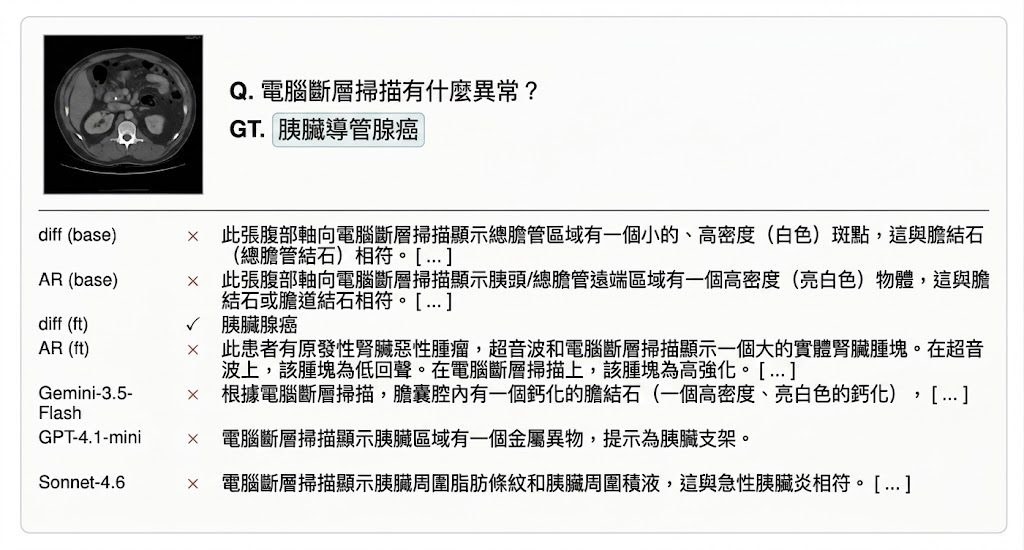
這是一個醫學影像語言模型微調與評測項目,重點是比較 DiffusionGemma 與自回歸基線。它也示範任何順序補全文本在放射報告草稿中的價值。

Repository image for mxvp/discrete_diffusion_RRG

這是一個醫學影像語言模型微調與評測項目,核心是把 image-conditioned discrete-diffusion language model 與 autoregressive baseline 放在同一家族骨幹下直接比較。它主要處理 chest X-ray VQA 與放射報告補全,目標不是單純生成文字,而是讓模型根據 X 光影像回答問題,或在已知部分句子的情況下補寫其餘內容。

項目的設計重點在於控制變因:DiffusionGemma 與 Gemma-4-26B 使用相近的 backbone family、vision tower、資料與 LoRA 配方,令比較更集中於生成方式本身。diffusion 路線把報告當成可逐步去噪的 decoder canvas,autoregressive 則沿用 next-token 順序生成;前者的優勢是可以做 any-order infill,用雙向脈絡補空位,後者則較接近現時多數 VLM 的常見做法。

部署與測試門檻不算低。模型權重透過 Hugging Face IDs 載入,設定檔要接駁本地 JSON 資料索引;倉庫也提供 synthetic: {n: 16} 這種小型 smoke test,適合先確認流程有沒有跑通。硬件要求比較明確,diffusion backbone 需要支援 bf16 的 GPU,而且記憶體大約要 80 GB,這已經把它定位成研究團隊或具備高階 GPU 環境的醫療 AI 項目。

效能表現有幾個值得留意的點。支援內容提到 Discrete Diffusion Language Models 在醫療 VQA 上可追平,甚至略勝同系 autoregression,解碼速度亦可達 3.5 至 4.4 倍;不過目前較完整的準確度重心仍放在 VQA,而報告生成部分主要展示互動式 infill 能力,未算是完整臨床報告生成系統。語義評分還可接 LLM judge,但這部分需要額外 API 金鑰,也表示結果解讀仍有一定研究性質。

  • 類型上,它較接近研究原型加評測程式碼,不是即裝即用的臨床軟件。
  • 主要資料來源包括 VQA-RAD、SLAKE、VQA-Med 與 MIMIC-CXR。
  • 相關模型包括 DiffusionGemma-26BGemma-4-26B,並以 LoRA 方式微調。
  • any-order infill 是最有辨識度的能力,適合先固定部分報告內容,再由模型補全其餘位置。
  • 適合需要比較生成範式、研究 radiology report drafting,或想驗證 discrete diffusion 在醫療場景表現的團隊。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, Google, Gemini, API, Image, Medical醫學, Dataset 數據集

PAW:把英文編譯成本地函數

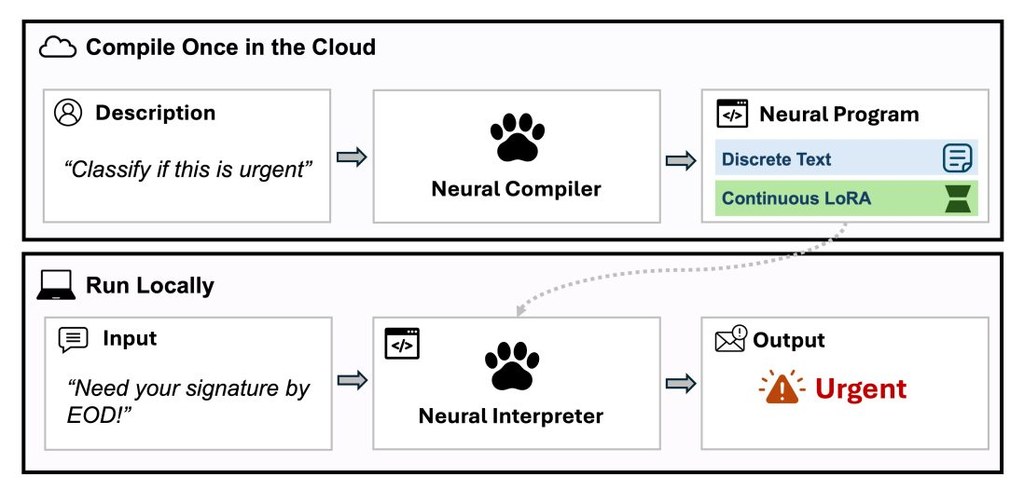
PAW(programasweights-python) 不是一般 LLM 封裝,而是把文字需求變成可離線執行的小型神經函數。它瞄準規則難寫、又不想長期依賴 API 的文字處理工作。

Repository image for programasweights/programasweights-python

PAW(programasweights-python)是一個 Python 工具兼研究原型,屬於把「自然語言」規格編譯成小型神經函數的項目。它要解決的是一類很難用正則表達式或硬編碼規則寫穩定的工作,例如修復壞掉的 JSON、模糊搜尋、分類、抽取欄位,以及把文字意圖對應到正確操作。

現有做法通常有兩條路:一條是手寫規則,遇到錯字、格式飄移同邊界情況就容易失準;另一條是把每次輸入都送去 LLM API,換來較高彈性,但會帶來網絡依賴、成本同重現性問題。Program-as-Weights(PAW)提出的做法,是先用一個 compiler 把英文描述編譯成可重用的神經程式,之後每次呼叫都在本機執行,定位由「每次都問模型」改成「先造好工具再反覆用」。

安裝路線相當直接:Python 端可透過套件取得預編譯函數,亦可自行 compile;瀏覽器端則有 @programasweights/web,但只限用 paw-4b-gpt2 這條較細的 runtime。部署取捨也寫得清楚,paw-4b-qwen3-0.6b 準確度較高,程式體積約 22 MB,本地推理約 0.05 至 0.5 秒;paw-4b-gpt2 準確度較低,但程式只有約 5 MB,支援 WebAssembly,較適合前端或輕量分發。

項目的技術定位:作者把這類問題稱為 fuzzy-function programming,並釋出 FuzzyBench 這個 10M examples 數據集,用 4B compiler 為 frozen interpreter 產生 parameter-efficient adapters。文中指出,0.6B Qwen3 interpreter 執行 PAW 程式時,效果可接近直接 prompting Qwen3-32B,同時把推理記憶體壓到約五十分之一,並在 MacBook M3 達到 30 tokens/s;這些數字有助理解它不是單純包裝模型,而是在成本、可重用性與離線能力之間重新分配。

  • 核心價值:把一次性的自然語言需求,轉成可重複呼叫的本地函數
  • 適合情境:日誌分流、格式修復、文字分類、資料抽取、意圖路由
  • 主要取捨:比直接調用大型 API 更可控、可離線,但編譯器與 runtime 選型會影響準確度與體積
  • 相關模型paw-4b-qwen3-0.6bpaw-4b-gpt2,論文亦以 Qwen3-32B 作對照
  • 受益團隊:重視本地執行、穩定輸出、低成本重複推理的開發團隊會較易受惠

這個項目最適合放在「規則太脆弱、API 又太重」的中間地帶。它未必取代通用 LLM,但對一批固定任務而言,先編譯、後離線執行的方式更像真正可落地的工程工具。

項目主頁 · GitHub · Paper

Categories: 開源, Qwen, API, Python, 編程, Dataset 數據集

AgenticDataBench:數據代理基準點樣睇

這是一個評測 data agents 的 benchmark。它用真實任務同技能標註,檢查模型是否真係識做數據工作。

example

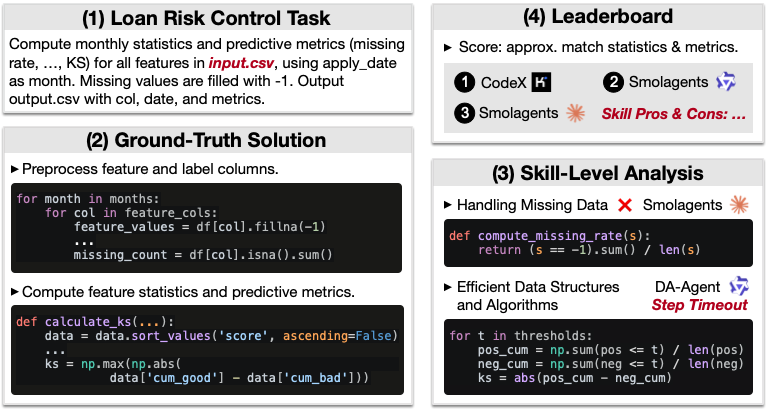
AgenticDataBench 是一個用來評測 data agents 的 benchmark,而唔係直接幫人做分析的模型或應用。它要解決的是:LLM-based data agents 能否穩定完成 data science workflow,並且用可比較、可重現的方式量度表現。

現有做法多數只用零散任務、單一資料集,或者只看最終答案,較難知道代理究竟卡在哪個步驟。這個項目改用 344 個任務、15 個領域,再配合細緻的 skill labels 同 ground-truth,將問題拆成可重用的 data science skills,例如缺失值處理一類操作模式,令評測唔只得總分,仲可以見到技能層面的強弱。

部署同理解方式都幾直接:資料集可由 HuggingFace 下載後放入 testbed/datasets/,任務、gold 標註同結果目錄已經分開,另外保留咗 98 個 private test tasks 維持 leaderboard 的可信度。README 亦提到需要設定 API keys,反映它主要係一個開放測試台,方便用不同 agent harness 跑同一批任務,而唔係單機即開即用的終端工具。

同類 benchmark 相比,它的取向唔係追求最少題目下的快速排行,而係強調真實性、技能覆蓋率同冗餘控制。項目一方面收錄真實 B2B fintech use cases,另一方面用 skill-aligned hierarchical clustering 同系統化生成流程補足缺少真實任務的領域,這種做法的代價是建置與維護較重,但換來更完整的比較基線。

  • 覆蓋 15 個領域,包含真實 B2B fintech 任務
  • 提供 tasks、ground-truth、skills 同 results 結構化內容
  • 支援比較不同 agent harness,如 Smolagents、DA-Agent、Claude Code、CodeX
  • 已列出 Qwen3.5-397B-A17B、Kimi-K2.5、Claude Sonnet 4.6 的初步實驗

這個項目最適合做 data agent 研發、模型選型同內部驗證的團隊,也適合研究人員用來檢查代理在哪類 data skills 失分。性能資訊目前以 leaderboard 結果為主,重點不只是 accuracy,仲包括 skill-level insight;相關模型至少包括 Qwen3.5-397B-A17B、Kimi-K2.5 同 Claude Sonnet 4.6。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, Agentic, Qwen, API, Anthropic, Dataset 數據集, Skill 技能

Graph-GRPO:教模型先畫知識圖再作答

這是一個訓練語言模型的開源項目,重點是先整理知識圖,再輸出答案。它想改善純文字推理難以追蹤思路的問題。

Repository image for lamm-mit/graph-preflexor-grpo

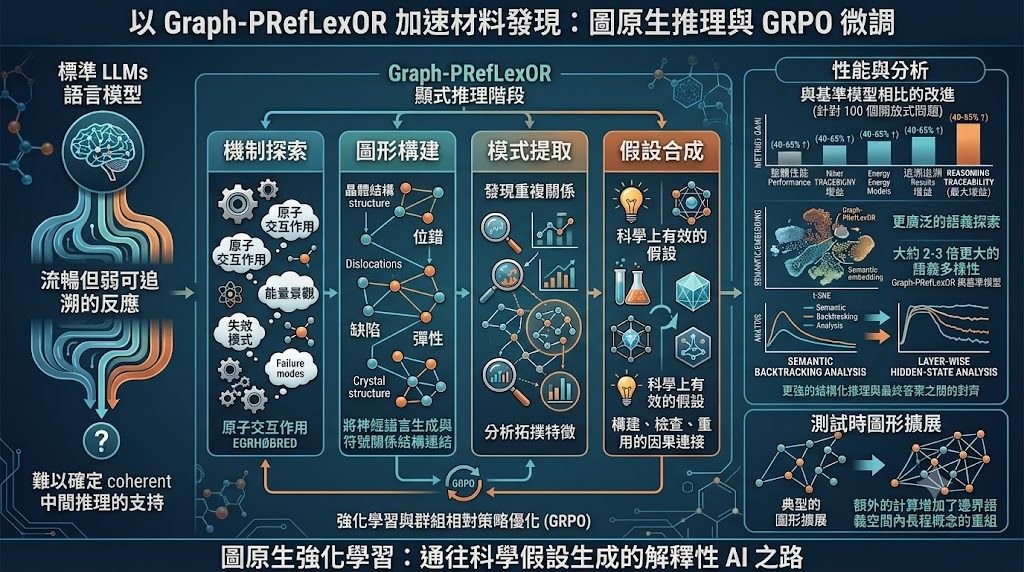
這是一個用來訓練語言模型的推理項目,核心屬於模型訓練流程兼研究原型。它要解決的問題,是模型回答問題時往往只輸出文字結論,推理結構難以檢查;Graph-GRPO 先要求模型把概念、關係與規律整理成 knowledge graph,再整合成答案。

現有做法多數依賴 chain-of-thought 或一般文字式 reasoning,把中間思路寫成自然語言。作者認為這種範式雖然靈活,但節點、因果、約束與抽象規律不易固定表示,因此提出 graph-native 的訓練方式:先用 ORPO(Odds Ratio Preference Optimization)或 SFT(Supervised Fine-Tuning)學格式,再用 Graph-GRPO 做強化學習,直接獎勵正確性、格式完整度與 graph utility。

項目的設計相當明確:節點類型限制為 entity、attribute、process、event、outcome、law、claim,關係亦只保留 12 種 verbs,並用 Pydantic 做結構化解析與 schema validation。這種取向的好處是輸出較易驗證,甚至能自動修補無效 graph;代價是表達自由度較低,未必適合非常開放、需要細膩語氣或鬆散聯想的回應。

部署與理解方式也算清楚,整個流程分成資料生成、run_orpo_graph 或 SFT 訓練,再進入 run_grpo_graph 強化階段,並以 LoRA 疊加在基礎模型上。README 亦提到可透過 OpenAI-compatible endpoint 驅動 ideation engine,把多輪生成的 graph_json 累積成可擴展知識圖,用於創意探索、問題延伸與比較不同前沿模型的表現。

  • 適合想研究可追蹤推理、結構化回答與可驗證中間步驟的團隊
  • 已釋出相關模型,基礎模型包括 Qwen-8B 與 Llama-3.2-3B-Instruct
  • 獎勵設計公開列出 correctness、format、graph utility 三部分權重
  • 亮點不在單純答得快,而在於把 reasoning 過程轉成可檢查的 graph object

在目前提供的內容中的性能不算完整,較明確的是訓練路徑、輸出結構與後續 ideation 用途,而 supporting context 另提到這條路線也延伸到 scientific hypothesis generation。整體來看,這個項目較適合研究型開發者、做 Agentic workflow 的團隊,以及想把 LLM 回答過程由黑盒文字轉成結構化證據鏈的人使用。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 模型訓練, Qwen, OpenAI, API, KnowledgeGraph, LLaMa, Anthropic, Meta, Dataset 數據集

AgentChord:多代理系統優化框架解析

AgentChord 用 GBC 追蹤多代理系統入面邊個步驟出錯。它不止幫你搭建流程,亦著重後續優化與觀察。

logo

AgentChord 是一個用來建立、執行同優化 multi-agent systems (MAS) 的開源框架。它想解決的不只是「點樣串起多個代理」,而是多代理流程出錯時,究竟應該由哪個代理、哪一步互動負責。

現有做法多數靠 coarse-grained feedback,例如只看整體任務成功與否,之後再回頭調 prompt 或改流程;作者認為這種範式難以做 fine-grained credit assignment,所以提出 Gradient-Based Connections (GBC),將 MAS 視為 computational graph,並用 token level 的梯度連接權重追蹤下游結果受哪些代理輸出影響。AgentChord 就是這套方法的實作框架,重點不是單純編排代理,而是讓優化有可追蹤依據。

從現有資料來看,這個項目部署思路算清楚:先準備 Astral UV、設定 LiteLLM 的 .env,再用 examples 內的示例理解環境、模型與 agent system 的組合方式。它支援用 ModelConfig 設定本地或 API 模型,例如 LlamaModelopenai/gpt-4o-mini,亦可加入 quantization、generation 參數,以及 connection_strategygradient_strategy 這類同 GBC 直接相關的設定。

同類框架很多集中在代理角色分工、工具調用或工作流編排,AgentChord 的取向明顯更偏研究與優化:一方面接上 WandB 監察過程,另一方面用 GBC 視覺化連接與 attribution。代價是它未必是最輕量的 MAS 起步工具,較適合想比較不同代理結構、提示設計與責任歸因效果的研究團隊,而不是只求快速做一個對話流程。

內容指出,GBC 在 MultiWOZ 與 τ-bench 上帶來比強力 single-agent 與 multi-agent baselines 更好的表現,而且 attribution quality 愈高,後續 optimization effectiveness 亦愈好。

你需要先定義環境,再逐步組裝 BaseAgentSystemGBCAgentParallelBlock 等元件。

  • 項目類型:偏研究導向的 MAS 框架,核心在於 GBC 優化與責任歸因
  • 主要差異:不是只做代理編排,而是把多代理互動建成可反向追蹤的圖結構
  • 可配模型:透過 LiteLLM 連接多種 API 模型,亦可配置本地 LlamaModel
  • 較受用情境:多代理實驗、prompt 優化、流程診斷、學術評測
  • 限制:README 提供的是框架級指引,完整 benchmark 重現與細節仍要結合論文理解

相關模型方面,已明確出現的包括 LlamaModelopenai/gpt-4o-mini;框架本身經 LiteLLM 設計,理論上重點在於兼容多供應商模型,而不是綁定單一模型家族。整體來看,AgentChord 最有價值的地方,在於它把「多代理為何失敗」這個通常很模糊的問題,盡量變成可以分析、視覺化同優化的工程問題。

GitHub · Paper

Categories: Agentic, API, 框架

Page 7 of 9
1 5 6 7 8 9