awesome-agentic-world-model:由 World Model 走向可互動的 Agent-Centric World Proxy

這份開源索引把世界建模重新連接到代理人的規劃、學習與驗證流程,亦清楚標出目前仍未解決的取捨。

Repository image for worldbench/awesome-agentic-world-model

需要持續試錯的 AI agent,未必每次都要真的操作環境;有時預測未來狀態、渲染視角、模擬執行結果,甚至取回技能或驗證計劃,已足以支援下一步決策。這個項目屬於開源研究索引與分類框架,實際處理的是如何整理 Agentic world modeling 相關工作,讓讀者按代理人需要的資訊尋找合適方法。

它不會像可直接下載的模型或部署服務般產生結果,價值在於把傳統被動預測下一個物理狀態的 World Model,延伸為面向代理人的 Agent-Centric World Proxy。相比只回答「下一刻會發生甚麼」,World Proxy 也可以回答「這個計劃能否執行」、「應取回哪段經驗」或「下一步應觀察甚麼」,但不同研究的成熟度和驗證方式仍然不一致。

分類採用兩條軸線:六種 Proxy functions 包括 Dynamics、Spatial、Execution、Memory / Experience、Skill 及 Reward / Verification;三個 empowerment levels 則分為 L1 inference-time guidance、L2 training-time optimization,以及 L3 Agent-Proxy co-evolution。這個關係有助分辨模型是在決策時提供提示、訓練時改善能力,還是與 agent 一同持續演化。

  • 用途:按功能及能力層級尋找研究工作
  • 內容:整理模型、論文、arXiv ID、發表場合與年份
  • 維護:接受新增項目、分類修正及連結更正
  • 限制:本身沒有推理 API、安裝流程或統一性能基準

它適合研究人員、建立 agent pipeline 的工程團隊,以及需要比較 Dynamics、Memory 或 Verification 方法的人;但若目標是立即部署系統,仍須自行選擇並安裝清單內的個別模型或工具。

項目目前更像一張持續更新的研究地圖,而非完成度一致的 benchmark。它的優點是提供共同語言,將 world modeling 從單一狀態預測重新放回規劃、學習和互動成本的脈絡;限制則是清單依賴社群維護,分類邊界仍會隨 Agentic world modeling 發展而變動。
項目主頁 · GitHub

Categories: 開源, Agentic, 世界模型, 模型訓練, API, Dataset 數據集, Skill 技能

Canvas UI 把互動介面搬上 WebGL 畫布

想為網站加上流體、玻璃或粒子效果,又不想犧牲可點擊與可選取內容,Canvas UI 正在試一條幾少見的路。

Canvas UI

網站想做得更有動感,最麻煩往往唔係效果本身,而係效果一蓋上去,文字選取、連結點擊同原本互動就容易受影響。canvas-ui 針對的正是這個位置:它屬於開源 UI 元件庫,用 html-in-canvas 同 WebGL 把流體模擬、shader effects 同 3D scenes 疊加到現有介面之上,重點是盡量保留 live DOM 的互動性。

它吸引人的地方,不止是畫面夠華麗,而是部署方式相對直接。元件可在 React、Solid、Preact、Vue、Svelte 同 vanilla TypeScript 使用,官方提供 Docs、Components 同 Playground,亦支援透過 shadcn CLI 拉入完整原始碼,代碼會直接落到你的項目,之後可自行改 props、樣式甚至拆開重寫,唔需要長期綁死某個套件版本。

取捨同樣寫得很清楚。依賴 live HTML redraw 的元件,要用到實驗性 HTML-in-canvas API,現時主要在 Chrome 配合 flag 才能完整啟用;去到其他瀏覽器,內容會退回一般 HTML 顯示,而部分效果仍可作為純 WebGL overlay 繼續運作。換句話說,它比較適合重視前端體驗、願意接受瀏覽器能力分層的品牌網站、作品展示頁,或者想在既有介面上加入視覺層次的互動項目。

  • 提供約 33 個元件,涵蓋 Blaze、Liquid Glass、Particle Reveal、VHS 等效果
  • 同一套元件邏輯對應多個前端框架,方便跨技術棧重用
  • 以 GPU 上的 WebGL 動畫為核心,減少主執行緒長時間負擔
  • 可配合 shadcn MCP server,讓支援 MCP 的 assistant 直接查閱與安裝元件

運行策略:能用 WebGL 的效果盡量放到 GPU,瀏覽器不支援完整能力時再優雅降級。這令 canvas-ui 比一般只做靜態裝飾的元件庫更進取,但也代表它未必適合每一個企業後台或追求一致瀏覽器表現的介面;放在重視體驗展示的 UI/UX 項目,價值會更明顯。

項目主頁 · GitHub

Categories: 開源, MCP, API, 3D, UI/UX

Montara 本地優先影片工作台

想用同一套時間軸管理生成、剪接同輸出影片,Montara 提供咗一條幾務實嘅路。它唔靠單一雲端服務,先確保你能穩定產出真正可播放嘅 MP4。

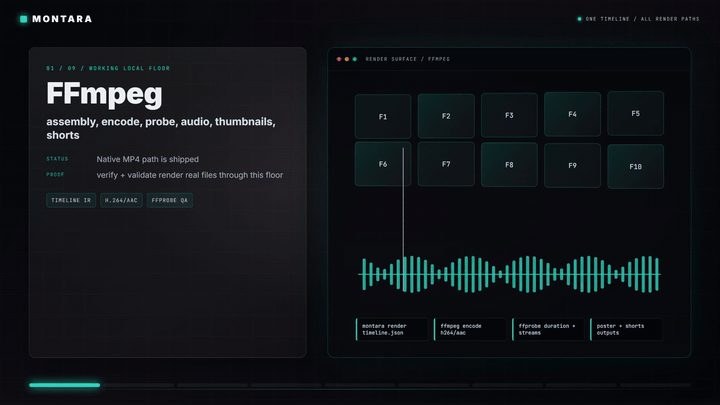
Montara engine matrix demo preview

做影片流程最麻煩,往往唔係生成一段畫面,而係素材、剪接決定、旁白、輸出格式同後續修改散落喺唔同工具。

Montara 就係朝住呢個痛點而來:一個本地優先嘅開源影片製作工具/框架,用 Timeline IR 做唯一時間軸來源,將規劃、編輯、渲染同交接串返埋。

它吸引嘅地方,在於先處理「冇雲端都要交到片」呢個現實限制。就算零 API keys,仍可經 FFmpeg 走本地 fallback 輸出可觀看 MP4,連字幕卡、語音路徑同部分媒體都預留咗本地方案;有裝 Remotion 就做 native smoke,冇裝亦會退回 FFmpeg,呢種設計比起只展示理想雲端流程嘅項目踏實得多。

同類做法常見係綁死某個生成服務或者某款剪片介面,Montara 反而把 provider 放成可插拔層,會建立 request、做 redaction、支援 dry-run 同 live-audit,但付費雲端呼叫要明確開啟。代價亦好清楚:它而家最成熟嘅係時間軸驗證、編輯操作、渲染路徑、editor bridge 匯入匯出,同埋真實 MP4 渲染與 post-render QA;README 亦講明長片規模仍屬 roadmap,唔係所有電影級工作流都已全面驗證。

  • Timeline IR 把場景計劃、剪接決定、匯入 editor cut 同生成素材收斂成一份 JSON
  • 本地路線完整,FFmpeg 係通用底線,部分 video/image/speech/music 有 fallback
  • 可匯出 EDL、OTIO、FCPXML,方便轉去 Premiere、Resolve、Final Cut 繼續做
  • provider 機制重視審計與可驗證性,適合要保留流程紀錄嘅團隊 較受惠嘅會係想把 AI 生成同傳統後期接埋嘅內容團隊、要保留本地控制權嘅創作者,或者打算讓 agent 參與影片流水線嘅開發者。

Montara 已經唔止係 demo 級拼裝,因為它把「可編輯來源」、「真實渲染結果」同「可交畀剪輯軟件接手」放埋同一條線;不過想追求高度成熟嘅長篇製作,仍要留意目前覆蓋範圍主要集中喺已測試嘅 renderer 同橋接能力。

GitHub

Categories: 開源, Agentic, API, Video, 影像處理, 框架, LTX

CodeNib 把代碼庫上下文交到 Coding Agent 手上

CodeNib 讓 Coding Agent 直接取用帶引用的代碼庫上下文,減少翻找檔案和拼湊脈絡的時間。它把同一份倉庫整理成多個視圖,再按需要供應給工具和介面。

CodeNib

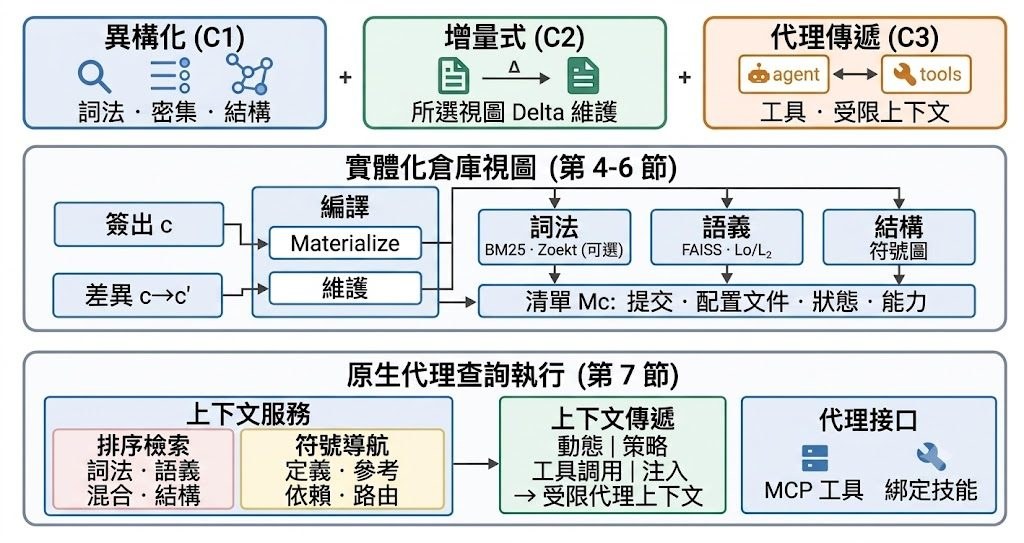
CodeNib 核心處理 Coding Agent 在大型項目裡最常卡住的問題:資料太散、脈絡太長、引用不清。它把倉庫編譯成 lexical、semantic、structural 同 static-navigation 多個視圖,再經 MCP、LSP-shaped providers、Python 或 HTTP API 交出去,讓工具直接拿到有來源位置的證據。

這個設計不只是做索引,而係重視增量更新同可追溯性。倉庫變動後,只會修補受影響的視圖;不適合保留的轉換才會重建。每個 view 都有獨立 manifest,記錄來源、狀態、能力同 artifact 位置,方便確認目前供緊咩上下文。

  • 主要解決 Coding Agent 讀懂倉庫時的上下文供應問題
  • 以 MCP 為核心接口,兼容 agent-native 工作流
  • Wiki、Ask view、Dependency Map 都係同一 runtime 的檢視層
  • 依賴 SCIP symbol resolution 生成 dependency map,唔靠模型猜測
  • 回答會附 file 同 line citation,方便核對

同類做法常見只係把檔案切片再丟入檢索,CodeNib 則把 lexical、dense、graph 同導航視圖放到同一個編譯流程裡。Docs 提到 live demo 支援 Python、C/C++、Go、Rust 同 TypeScript,亦展示咗一個針對 codebase 的實用取向,而唔係停留喺概念層面。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, API, Vibe Coding, Python, 編程

Octafuse Gateway:幫 Agent 管好多模型入口

Octafuse 團隊做的不只是轉發層,而係把模型、工具同配額管理收埋到同一個入口。對要同時接多個 AI 服務嘅團隊,呢種集中控制會直接省下不少營運工序。

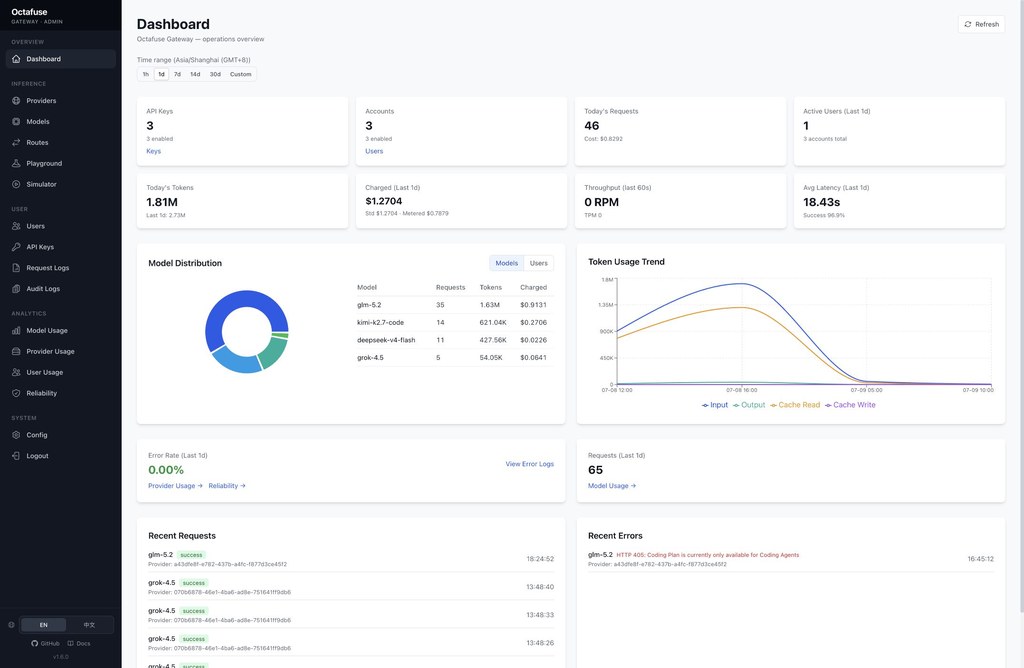
Octafuse Gateway 运营概览

Octafuse 團隊把重點放在 Agent 工作流,而唔係只做一個轉發請求的薄層。Octafuse Gateway 屬於可自託管開源 AI gateway,處理的是多供應商模型、圖像、語音轉寫同 Agent Tools 分散管理的問題,特別適合已經有多組 API Key、不同模型來源,甚至自建服務要一齊協調的團隊。

它最有價值的地方,在於把「接得通」進一步做成「管得住」。同類項目常見重點是模型代理與相容 API,Octafuse Gateway 另外加強了路由、故障轉移、預算、審計、三賬本計費,同埋公開能力目錄,令 Agent 可以透過統一入口發現同調用資源,而管理者亦可以追蹤成本與用量。

部署方向,支援 Cloudflare Workers + D1,以及 Docker 配合 Postgres / MySQL 自託管;Node.js 20+ 亦是明確要求。原始資料未展示完整安裝步驟,但有 operator 文件、Admin 管理界面、Playground 同 Simulator,反映它不是只給開發者讀 API 文件,亦有一套管理與聯調介面可用。

  • 兼容 OpenAI Chat Completions、Anthropic Messages、Gemini、OpenAI Images 與 OpenAI Audio Transcriptions API
  • 可集中管理 Provider API Key、RPM / TPM、並發、熔斷狀態與剩餘容量調度
  • 內置 Provider 與模型導入模板,減少逐個端點手動維護
  • 提供 /v1/tools/* 接入 Agent Tools,現有 web-search、web-fetch、web-deep-search
  • 有 Playground、Simulator、審計與成本觀察能力,方便排查路由與計費設定

它強調的是可靠調度與營運控制,而非單一模型跑分。對需要向內部團隊、客戶或不同項目發放獨立 API Key 的環境,這種以資源治理為核心的取向,比單純聚合模型端點更完整,但相對也代表配置面會更廣,較適合已有多模型、多使用者或多成本中心需求的團隊。

GitHub

Categories: 開源, Agentic, OpenAI, Gemini, API, 框架, Anthropic

MiniMax H3 頂級高清影片生成

MiniMax H3 提供咗一套較完整的影片生成 API。它重點不只是出片,仲包括參考生成同影片編輯控制。

Og image

做影片內容時,最麻煩往往不只是「生成一段片」,而係點樣令角色、鏡頭起承轉合同參考素材保持一致。MiniMax H3 屬於多模態影片模型,處理的正正係呢類控制力需求:除咗 Text-to-Video,亦支援以首幀、尾幀、參考圖片、參考影片同音訊去引導生成結果。

對內容團隊、短片創作者同需要自動化出片流程的開發者而言,呢個項目的吸引力在於輸入方式夠彈性。你可以由一段 prompt 起步,也可以加入第一張或最後一張畫面去約束開場與收尾;當需要保留人物、動作、鏡頭風格、聲線或剪接節奏,則可改用 Reference Generation。

MiniMax Just Dropped a "Seedance Killer" with a Twist
  • 支援 Text-to-Video、First/Last-Frame Image-to-Video、Reference Generation
  • 統一理解 text、image、video、audio,多種素材可混合輸入
  • 輸出最高為 2K,片長 4 至 15 秒,只接受整數秒
  • 參考輸入上限包括最多 9 張圖片、3 段影片、3 段音訊,混合檔案總數上限 12

規格上,MiniMax H3 支援常見長闊比,圖片、影片與音訊都有清晰的格式及大小限制,例如影片可用 H.264/AVC、H.265/HEVC,圖片可用 JPG、PNG、WEBP,音訊則支援 WAV、MP3。音訊不能單獨提交,必須配合圖片或影片一齊使用;而較大的素材更建議用 URL 方式傳入,避免 API request body 超出 64 MB。

現有資料集中在能力範圍、輸入限制同 API 使用方向,能夠幫你快速判斷適唔適合接入工作流。

項目主頁

Categories: MCP, 多模態模型, 視頻模型, API, Video, Image, Audio, 語音, MiniMax

DeepSeek-V4-Flash 公測版重點更新

DeepSeek 把 V4-Flash 推上正式版 API 公測,焦點唔止係模型名稱更新,而係 Agent 工作流明顯變得更能打。對寫碼、自動化同工具調用有需求的人,呢次變更值得留意。

Og image

想用同一個 API 入口處理寫碼、自動化操作同工具調用,2026-07-31 呢次更新最值得留意。DeepSeek-V4-Flash 正式版已經開放 API 公測,調用方式維持不變,只要把模型名稱設為 deepseek-v4-flash,就可以切換到最新版本,對現有接入項目來講改動相對少。

今次更新的重點唔係介面改版,而係 Agent 能力明顯加強。官方列出的 Terminal Bench 2.1、NL2Repo、Cybergym、DeepSWE、Toolathlon verified 同 Automation Bench (Public) 等基準分數,都指向同一件事:V4-Flash 針對 Coding Agent、終端操作、工具使用同全棧開發場景做咗強化,而且公開測試成績已經高過 V4-Pro-Preview。

技術上,DeepSeek-V4-Flash-0731 的模型結構、尺寸都同 DeepSeek-V4-Flash-Preview 一致,更新集中在後訓練,意味住提升主要來自調整模型行為,而唔係換咗一個更大架構。它同時原生支援 Responses API 格式,亦有針對 Codex 做適配,對已經圍繞 API 建立 Agent 工作流的團隊會更易接入。

幾個重點可以直接整理如下:
deepseek-v4-flash 已可直接使用正式版 API 公測
– API 調用方式不變,現有項目遷移成本較低
– Agent 能力是今次更新核心,涵蓋 coding、terminal 同 tool use
– Responses API 已原生支援,並針對 Codex 做咗適配
– 今次只更新 V4-Flash API,DeepSeek-V4-Pro API 以及 APP/WEB 端模型未有改動

使用上亦要留意邊界。現有資料有提供模型名、相容格式同基準測試結果,但未見更完整的安裝步驟、下載方式或者端到端接入流程;另外,官方亦講明今次並未更新 DeepSeek-V4-Pro API。對想盡快把 Agent 能力接入現有產品的人,V4-Flash 呢次公測比較像一次低改動、偏向工作流升級的更新。

項目主頁

Categories: Agentic, 模型, DeepSeek, API, Vibe Coding, 工具, 編程

Ollama 3.25 把開源模型帶回你部機

想喺自己電腦跑開源大模型,又唔想先砌一大堆環境,Ollama 正正係針對呢個卡位。它將模型執行、管理同串接應用壓縮成一條較順手的路。

Repository image for ollama/ollama

想將開源模型放返本地處理,又要兼顧聊天、程式整合同 agent 工作流,Ollama 幾乎係目前最直接的一條路。它屬於模型執行與管理工具,核心作用係將本地大語言模型的下載、啟動、呼叫同整合收斂到同一套介面,令 Mac、Windows、Linux 甚至 Docker 部署都比較一致。

它吸引人的地方不只是可以對話,而係可以直接接去 Claude Code、OpenClaw、Codex、Copilot 等現有工具鏈。換句話說,Ollama 唔係只提供一個聊天殼,而係充當本地模型服務層;你可以用 CLI 跑模型、經 REST API 調用,亦可以配合 ollama-python、ollama-js,或者再接 Open WebUI、LibreChat、Lobe Chat、NextChat、Perplexica 呢類前端與應用。

同類做法入面,Ollama 的取向好清楚:它唔著重花巧介面,而係先處理「點樣穩定喺本地把模型跑起來,再供其他程式使用」呢件事。背後支援 llama.cpp,意味住它承接咗本地推理生態的成熟基礎;代價亦存在,本地效能仍然受你部機的記憶體、GPU 與模型大小限制,追求大型模型或高併發時,就未必有雲端服務咁輕鬆。

  • 安裝路徑完整,覆蓋 macOS、Windows、Linux 同 Docker,理解上可以當成一個本地 AI 服務。
  • 既可直接 run 模型聊天,亦可透過 REST API、Python、JavaScript 接入現有項目。
  • 跟 Claude Code、OpenClaw、Codex、Copilot 等整合,適合做本地 agent 與開發工作流。
  • 配合 Open WebUI、LibreChat、Lobe Chat、NextChat 等,可快速補上可視化操作層。

較受惠的一群,會係想保留資料喺本地的開發者、需要快速測試開源模型的團隊,以及想把 AI 能力嵌入內部工具的人。就產品定位而言,Ollama 最有價值的地方,係將「本地跑模型」由零散步驟變成可重用的基礎設施。

項目主頁 · GitHub

Categories: 開源, Agentic, API, Mac, Linux, Ollama, Python

OpenWorker – Andrew Ng 開發桌面 AI 龍蝦

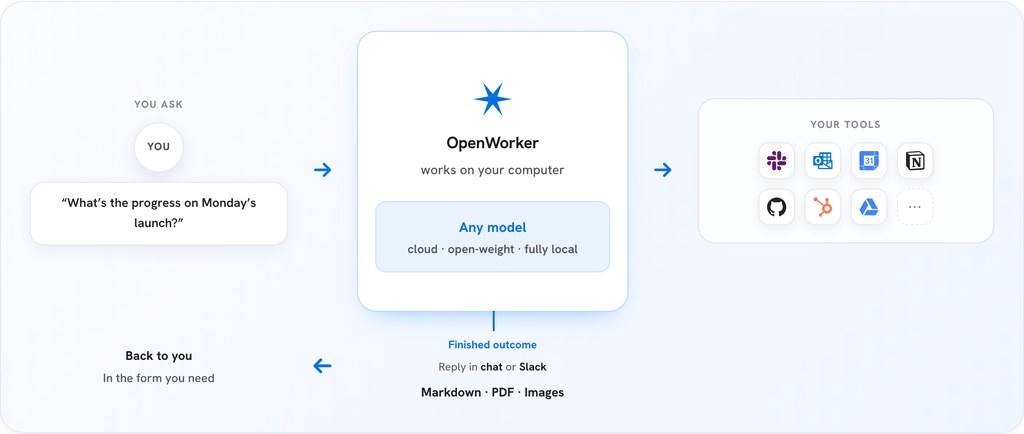
OpenWorker 係一個開源嘅桌面 AI 同事,由 Andrew Ng 團隊開發,強調本地執行、帶自己嘅模型 API key,並且會產出真正嘅成品而唔止係聊天回覆。

How OpenWorker works

對好多打工仔嚟講,最大嘅困擾唔係 AI 唔夠聰明,而係佢只識得「答問題」而唔識得「做完件事」。OpenWorker 嘅切入點正正喺呢度:佢定位係一個會跑喺你電腦上面嘅 AI 同事,可以幫你整理 calendar、寫 follow-up email、甚至自動出一份 customer brief,最後畀你一份可以直接開嚟用嘅文件,唔係一串對話。

OpenWorker 由 Andrew Ng(吳恩達)相關團隊推出,引擎建基於佢哋自己開發嘅 Python 開源庫 aisuite,呢個庫提供統一嘅 chat-completions API 以及支援工具調用(tool calling)、MCP 等功能。簡單講,OpenWorker 唔係從零寫起嘅 wrapper,而係將 aisuite 包成一個真正面向桌面用戶嘅應用,並且喺原本 aisuite 倉庫入面開發咗一段時間之後,先搬出嚟獨立成 repo。

目前支援 macOS(Apple Silicon)以及 Windows 10/11,用家可以貼上自己嘅 API key 去用 OpenAI、Anthropic、Google Gemini、DeepSeek、Kimi、Qwen、Mistral 等模型,亦可以經 Ollama 完全本地跑開源模型。所有嘢都喺本機行,只有用家授權嘅 model call 或者連接工具先會接觸到網絡。對於注重私隱或者公司政策唔畀數據出 cloud 嘅人,呢個係一個幾實際嘅選擇。

OPENWORKER: The Free AI Desktop Agent That Isn't Locked to One Model

佢亦內建 25+ 個整合,包括 GitHub、Slack、Jira、Notion、Linear、HubSpot、Outlook、Gmail、Google Calendar 等,亦支援任何可以經 MCP(Model Context Protocol)接駁到嘅工具。最令筆者欣賞嘅係佢嘅審批機制:寫訊息、發送郵件、執行 shell 指令呢類「對外有影響」嘅動作,全部都要先經你確認先至會執行,唔會自己靜靜雞撳掣。

以下係幾個用家會比較關心嘅重點:

  • 定位係桌面 AI 同事,目標係交到「成品」而唔止係聊天回覆,例如 HTML brief、Markdown 報告、排好嘅 calendar 更新等。
  • 完全開源、MIT 授權,由 Andrew Ng 團隊開發,引擎建基於佢哋嘅 aisuite 開源庫。
  • 模型自選,支援多間主流 cloud provider,亦可以經 Ollama 完全本地執行開源模型。
  • 重視私隱,對話、token、API key 都儲喺本機 secret store,唔需要登入亦可以用。
  • MCP + 審批機制,所有對外動作(發訊息、執行指令)都會先問過你先做,減低「AI 自行撳掣」嘅風險。

如果你係一個人或者小型團隊,想搵一個可以幫你「跑手」而唔係淨係「傾偈」嘅 AI 工具,又唔想將公司敏感資料送去閉源服務,OpenWorker 算係一個值得試嘅選擇。佢而家仲喺 open beta,官方表示會自動更新、不斷執吓啲 bugs,畀用家提交 issue。適合想認真將 AI 融入日常工作流、對私隱同可控性有要求嘅人。

項目主頁 · GitHub

Categories: 開源, MCP, Qwen, Google, OpenAI, DeepSeek, Gemini, API, 工具, Mac, Ollama, Python, Anthropic, 蘋果, Kimi

TrajLoc 把路線描述對準衛星圖

單張街景未必足夠判斷位置,TrajLoc改為沿住整段路線做比對。影片、文字敘述,甚至兩者一齊用,都可以指向同一塊衛星瓦片。

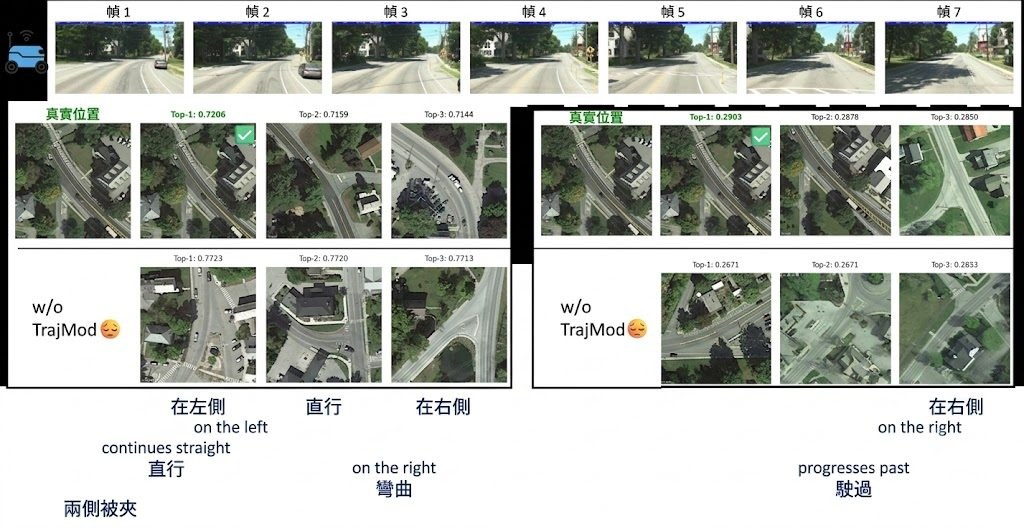
A trajectory can be queried as dense video or as abstract language — both retrieve the same satellite tile.

只靠一張街景相去配對衛星圖,遇到轉彎、路口相似、視角受限時好容易失手;TrajLoc改為追蹤整段移動路線,將街景影片、自然語言路線描述,或者兩者結合後對應到帶地理標記的衛星瓦片。它屬於跨視角 geo-localization 模型連同 benchmark 項目,處理的是「把連續路徑準確放回地圖」這個問題。

現有 cross-view 資料多數停留在 single-image、video-only 或 text-only 範式,作者認為這樣會拆散同一條路線入面本來互相補強的時序線索與語意線索,因此一併推出 SeqGeo-VL。呢個 benchmark 收錄 38,863 組對齊的 video-text-satellite triplets,並有 91.8% human verification pass rate,重點不是再加大資料量,而是把 sequential 同 linguistic 兩種證據放入同一任務。

TrajLoc沒有另起一套龐大時序架構,而是由 pretrained CLIP ViT-L/14 延伸成 video、text 同 satellite encoders,再用 co-training curriculum 將三種查詢模式放入同一個表示空間。作者另外加入 TrajMod,將路線幾何資訊 tau={(Δx_i, Δy_i, θ_i)} 轉成 FiLM 的 scale/shift 參數,直接調節 query embedding;做法比單靠提示詞更明確,亦保留 frozen encoders 的可重用性。

  • 支援 video、plain language、video+text 三種查詢方式
  • SeqGeo-VL 是首個同時包含 sequential 與 linguistic cross-view benchmark
  • TrajMod 只用 waypoint offsets 與 headings,不靠 map 或 POI metadata
  • 項目提供 agent-ready tool interface、persistent Python API 同 JSON CLI

從示範與說明看,TrajLoc的定位很清楚:它不是通用多模態聊天模型,而是給 spatial reasoning、戶外機械人、導航研究同 multimodal agents 調用的專門工具。225 ms 的示例檢索速度對互動式流程有吸引力,但目前公開資訊主要集中在 benchmark 與檢索能力,部署前仍要留意資料覆蓋範圍、地區泛化,以及自己的工作流是否真有影片或路線文本可供查詢。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, Embedding, 多模態模型, 模型訓練, Qwen, API, Video, Image, Python, Dataset 數據集

Page 4 of 9
1 2 3 4 5 6 9