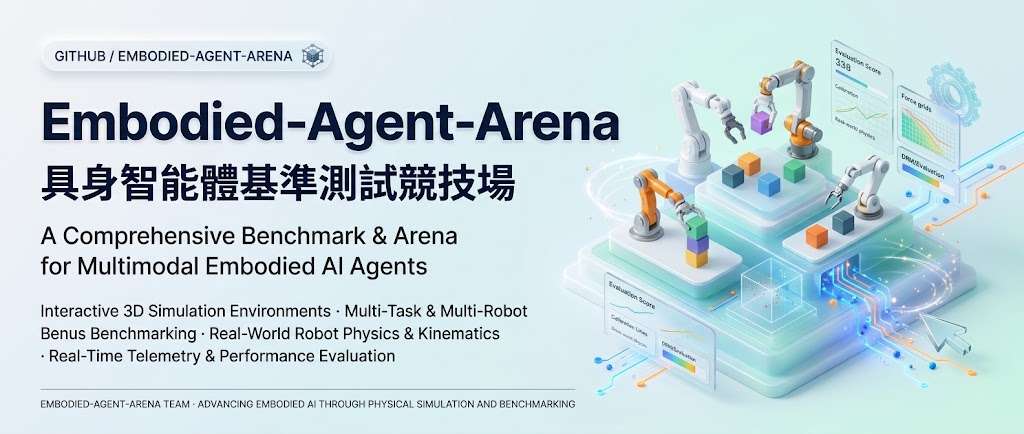
Embodied Agent Arena:測試十款 VLM 的任務能力

十款前沿視覺語言模型接受 1,000 個具身任務測試,結果顯示,能生成可執行動作,不代表能完成多步操作或精細接觸任務。

logo transparent

要判斷視覺語言模型(Vision-Language Models,VLMs)能否勝任機械人通用操作,不能只看它有沒有成功發出動作。Embodied Agent Arena 是一個具身代理評測項目,以共同測試流程比較十款模型在五類能力上的表現,涵蓋 1,000 個案例,並把幾何理解、空間推理和視覺定位納入評測。

項目把任務理解、推理和動作選擇交由模型處理,再以同一套精簡評測框架測試不同模型。測試資料整合 32 個既有來源,另加入 168 個案例的 GeoProbe 幾何基準;相比只看機械人互動任務,這種安排能同時檢視模型理解空間資訊的能力,以及能力能否轉化為實際任務成果。

結果反映,單一指標容易掩蓋任務是否真正完成。Gemini 4 Argon 的 3D 路徑誤差最低,為 0.310 米,但 56 條路徑中只有 24 條符合全部限制;Manipulation 成功率最高的 Opus 5.5 亦只有 47.8%。CALVIN 測試中,100 個序列有 60 個完成第一個目標,完成全部五個目標的只有 9 個;在五項 ManiSkill 診斷任務中,Opus 5.5 能完成拾取、放置和堆疊,卻未能完成插入插銷或充電器。

  • 同一批 157 項 Planning 任務中,至少有一款模型完成 142 項;仍有 15 項十款模型全部失敗。
  • Astra 的 31 項失敗任務耗用 55.5% token;失敗任務平均耗用的 token 是成功任務的 5.1 倍。
  • CALVIN 有 65 個序列曾遇到執行錯誤;其中 62 個後來能無錯執行程式碼,但只有 3 個最終完成序列。
  • Case Atlas 收錄 181 個涵蓋五類能力的案例,提供十款模型的紀錄;缺少影片的項目會使用共用任務場景,API 中斷則標記為失敗嘗試。

這些結果適合用來比較模型在哪些環節失手,亦提醒研究團隊不要把路徑精度、程式碼執行成功或單一步驟操作,直接當成完整任務能力。項目提供線上結果、案例影片、資料集及程式碼。
項目主頁 · GitHub · 數據集

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, AI productions, 世界模型, Qwen, DeepSeek, Gemini, API, VLA, Robotic, 框架, 香港, Anthropic, Dataset 數據集

Phone Harness MCP:AI 直接操作雲端上的手機模擬器

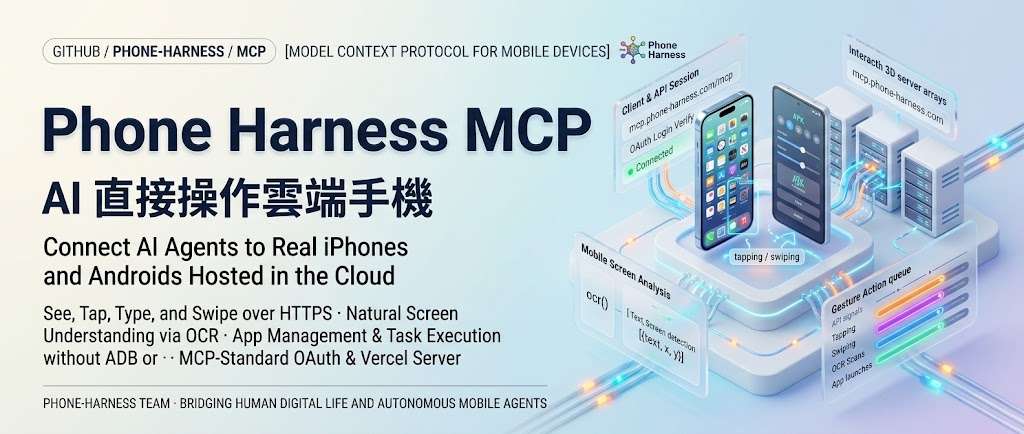
要測試手機 App,AI 代理可以直接查看 iPhone 或 Android 模擬器畫面,再進行點按、輸入和滑動。Phone Harness MCP 讓這些操作透過 MCP 連接器交給代理執行。

Repository image for phone-harness/mcp

測試手機 App 或重現操作流程時,AI 代理可以透過 Phone Harness MCP 查看手機畫面、點按、輸入文字、滑動及開啟 App。它屬於 MCP 工具,將雲端專用 iPhone 或 Android 模擬器接到 Claude、Cursor、ChatGPT、Codex 等 MCP client,讓代理直接操作裝置。

連接方式是把 Phone Harness 加入支援自訂連接器的 MCP client,使用服務網址登入;連線採用 Streamable HTTP,OAuth 要求 phone:drive 權限,也可用 API key 作 Bearer token。項目聲稱毋須 Mac、adb 或裝置配對,但這代表操作依賴雲端裝置,並非連接使用者手上的手機。

和需要本機裝置、開發環境及配對程序的測試流程相比,Phone Harness 把裝置控制交由雲端服務處理,減少本機準備工作;代價是要登入並授予手機操作權限,亦須視乎服務提供的裝置與連線狀態。項目提供 Claude、Cursor、ChatGPT 和 VS Code 的連接方法,但未提供效能數據或完整的裝置供應、費用及可用性細節。

適合需要讓 AI 代理測試 App、執行手機操作流程,或在不同 MCP client 中驗證代理能力的開發者和測試團隊。連接前可先確認團隊帳戶是否支援自訂 MCP server;ChatGPT 網頁版的自訂連接器只供 Business、Enterprise 和 Edu 工作區使用,Pro 帳戶則只支援讀取及擷取工具,不能用來操作手機。

  • 支援雲端專用 iPhone 和 Android 模擬器。
  • 代理可查看畫面、點按、輸入、滑動及開啟 App。
  • 透過 MCP 連接器和服務網址登入,不需本機 Mac 或 adb。
  • OAuth 要求 phone:drive 權限,亦可使用 API key 作 Bearer token。
  • ChatGPT Pro 帳戶不能透過自訂 server 驅動手機。

GitHub

Categories: 開源, MCP, OpenAI, API, 工具, IDE, Mac, Anthropic

CUA-Master:把教學影片變成電腦操作訓練資料

教學影片可以變成代理的操作練習,但仍要接駁沙盒。CUA-Master 串起任務挖掘、驗證與訓練資料製作。

com

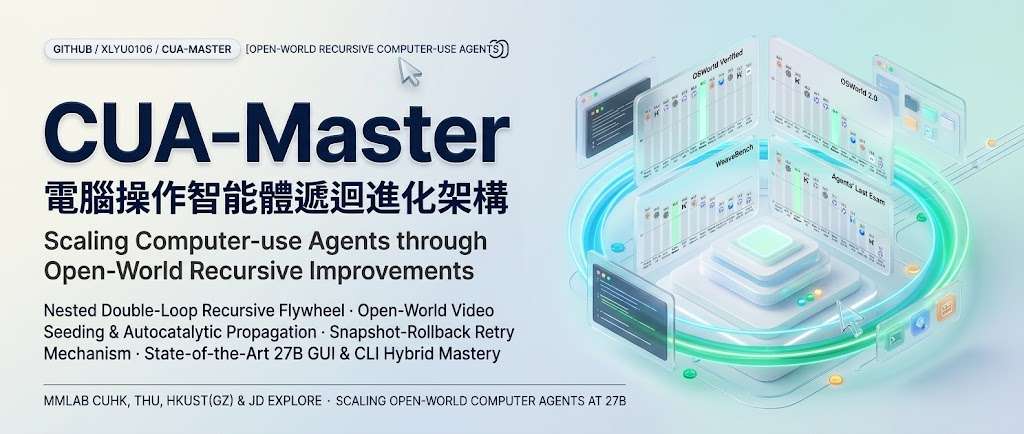
把軟件教學影片轉成可驗證的操作任務,CUA-Master 這套框架協助團隊訓練電腦操作代理(Computer-use agents,CUAs)。它會按模型弱點補充任務,讓資料建構與模型改進互相帶動。

框架結合字幕語意與畫面變化重建操作軌跡,再抽取可重用的能力單元,控制新任務涉及的能力及應用程式數量。沙盒執行失敗後,可按回饋回復快照重試;已驗證軌跡可轉成 ms-swift 格式的監督式微調(Supervised Fine-Tuning,SFT)資料。

準備測試需要安裝依賴及接駁服務:

  • 以可編輯模式安裝,加入 seeding、annotator、collection、dev 依賴。
  • 複製 .env.example 為 .env,填入 API 金鑰及沙盒服務端點。
  • 經 provider 介面接駁自己的沙盒後端,再按範例設定搜尋影片資料、下載選定影片;命令支援 –help。

官方公布 CUA-Master-27B 在 OSWorld Verified 得分為 80.2,在 OSWorld 2.0 為 36.9,兩者不可直接當成同一尺度比較。項目較適合有沙盒及訓練資源的代理研究團隊;提供的快速開始內容未完整展示後續流程,尚不足以照抄完成整條訓練流程。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, AI productions, 模型, 模型訓練, API, Video, 框架, 教學, 軟件

ReGap-Bench:視覺與推理分開評測

模型看見物件,不代表能逐步追蹤它們。ReGap-Bench 用可配對的視覺參照,測出多模態推理究竟卡在哪裏。

Teaser

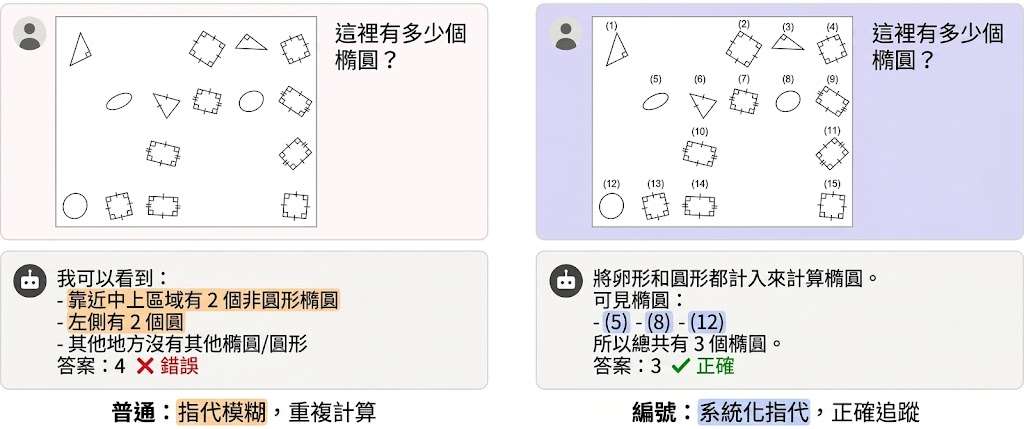
模型明明看見圖中所有物件,數數時卻會重複計算;ReGap-Bench 是一個針對 multimodal large language models(MLLMs)的資料集與評測項目,專門檢查語言推理能否正確對應視覺中的物件、區域和位置,並將問題命名為 reference gap。

它把同一場景、問題和答案固定,只更換額外參照,形成 paired reference-intervention benchmark。編號讓物件可以被索引,陰影標示有界區域,網格線則協助定位、追蹤邊界和比較位移;參照是否配合任務,會直接影響推理結果。

  • 涵蓋 shape counting、angle ranking、size ranking、clock ranking 和 transformation prediction 五項任務
  • 共 200 個場景及 3,400 張圖片,設有 plain、numbering、shading 和 grid 條件
  • task-matched references 可令所有受測模型在所有任務提升,最高達 25%
  • mismatched references 幫助有限,甚至會令表現下降

測試可用 OpenAI、Google Gemini API,亦可透過 vLLM 執行 Qwen3.5;後者需要 GPU,API 模型則只需設定相應金鑰。Python 3.10 環境和 requirements 已列明,輸出會保存到 outputs,方便比較同一模型在不同參照條件下的差異。

ReGap-Bench 的價值不在於再加一個總分,而是把視覺感知和語言推理之間的接合問題單獨拉出來。結果支持一個務實判斷:改善模型未必只靠更強的視覺編碼器,為任務建立合適的外部視覺參照,也可能成為不需重新訓練的 visual skill;不過參照錯配會反過來干擾模型,因此它更適合研究團隊、MLLM 評測人員和需要分析多步視覺推理失誤的開發者。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, 模型, 多模態模型, 模型訓練, Qwen, Google, OpenAI, Gemini, API, Image, Python, Dataset 數據集, Skill 技能

System 1+2:AGI 也要先估互動價值再花算力

多想幾步、多試幾次,都有成本。研究構想讓 AI 先估計哪些互動有價值,再投入資源執行。

Hero image preview

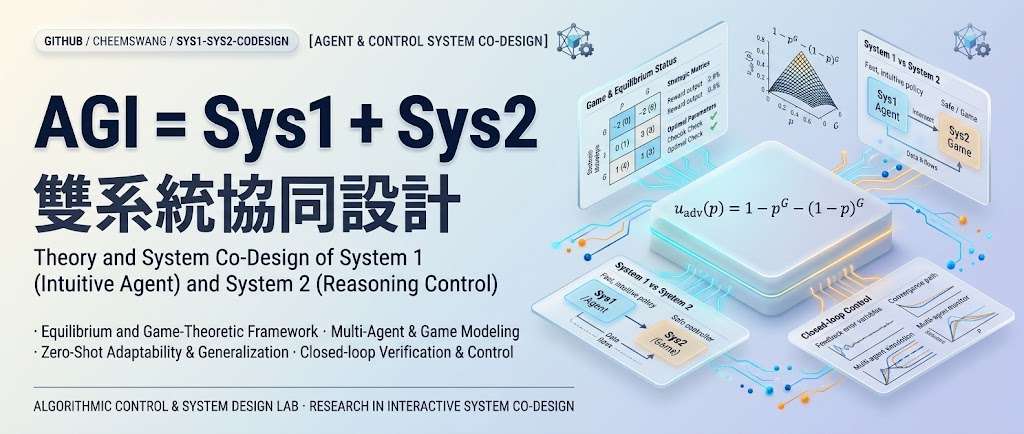
AI 代理搜尋資料、執行程式或讓機械人試走一步,都要付出成本,卻未必帶來有用結果。清華大學團隊提出 System-1/System-2 協同設計構想,希望在執行前先篩選值得投入的互動。

成本較低的 System-1 按預期價值排列互動的優先次序,再由成本較高的 System-2 執行較困難的工作。這個構想把資源分配提前,讓增加推理、訓練或探索次數之前,多一道價值判斷。

它涵蓋的場景包括:

  • 語言模型推理:判斷哪些推理步驟值得繼續投入。
  • AI 代理:篩選搜尋、程式執行及應用程式介面(Application Programming Interface,API)呼叫。
  • 機械人與強化學習(Reinforcement Learning,RL):優先探索可能提供學習訊號的經驗。

對互動成本高、數據取得慢的研究與開發工作,這個構想提供了分配預算的思路。不過,所提供節錄未交代價值預測器的具體實作或量化結果,仍未能判斷它能節省多少成本,以及會否錯過有用的探索。

項目主頁 · Paper

Categories: 清華大學, Agentic, 模型, 模型訓練, API, World-Action Model, Robotic, 框架, 軟件, 編程, AGI, 強化學習

RGB MoCap:把影片動作變成可編輯角色動畫

拍一段影片即可重建人體動作,再修正接觸點、套用角色並匯出動畫。

RGB MoCap workspace showing video tracking and a 3D motion preview

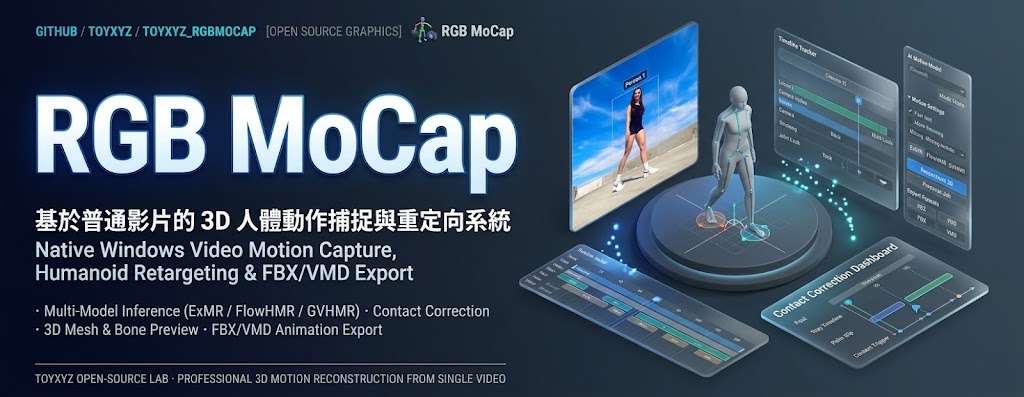
拍攝一段人物影片後,RGB MoCap 會重建人體動作,讓你在 3D 預覽中檢查身體網格與骨骼,再輸出可編輯的人體動畫。這個項目屬於本地運行的 Windows 動作捕捉工具,主要處理由普通影片取得角色動作、修正滑步,以及套用到不同角色格式的工作。

它不只追蹤身體,還提供腳掌和手掌接觸修正,接觸時間可以手動調整;動作可重新套用到 Mixamo FBX、VRM 和 PMX 人形角色,並輸出 FBX,亦可選擇是否連同網格一併匯出。多個 AI 模型的結果能分開保存,方便比較和重做。

安裝需要 Git for Windows、Blender、FFmpeg,以及 ExMR、FlowHMR、GVHMR 等模型運行環境;模型權重和註冊的人體檔案要在 Model Manager 另行準備,部分模型需要帳戶登記和手動下載。MAMMA 與 PromptHMR 屬於可選運行環境,另需 Visual Studio 2022 C++ Build Tools、Windows SDK 和 CUDA Toolkit 12.8;PEAR 則可用於 webcam 或影片中的單人即時身體及手指骨骼預覽。

  • AI 處理在本機完成,適合重視素材私隱的 Windows 使用者
  • 支援多人重建、動作骨骼預覽和 Multi Cam MoCap 工作流程
  • 接觸修正可減少滑步,但仍需人工檢查時間點和追蹤結果
  • 角色重定向涵蓋 Mixamo FBX、VRM、PMX,方便接入 3D 製作流程

提供安裝、更新、模型準備和恢復指引,也附有動作捕捉及角色重定向示例。適合視為可本地測試的製作工具,而不是已有完整性能保證的商用捕捉系統;動畫師、VRM/PMX 角色創作者,以及需要把影片動作帶入 Blender 的團隊會較容易受益。

GitHub

Categories: 開源, AI productions, 模型, NVIDIA, API, Video, 工具, Content Creator, 3D, 庫, 動畫, Dataset 數據集

h3-motion:沿路徑移動照片主體並重生成影片局部

沿路徑移動照片主體,或為影片局部加上遮罩再重新生成;h3-motion 透過自架 ComfyUI 串連影像理解與動畫模型。

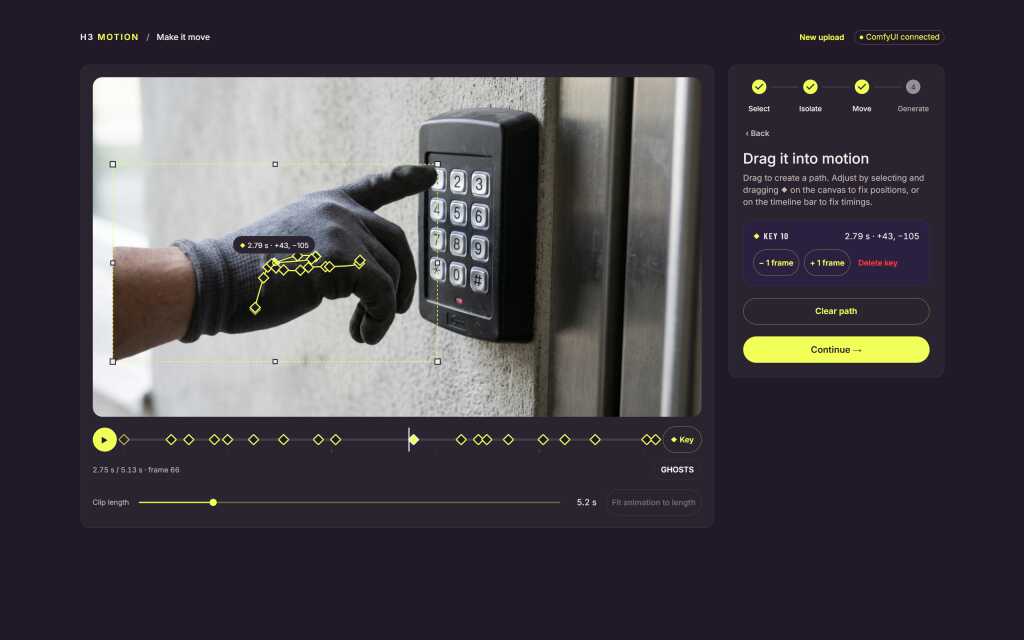
Select step: a gloved hand picked out with SAM 3.1

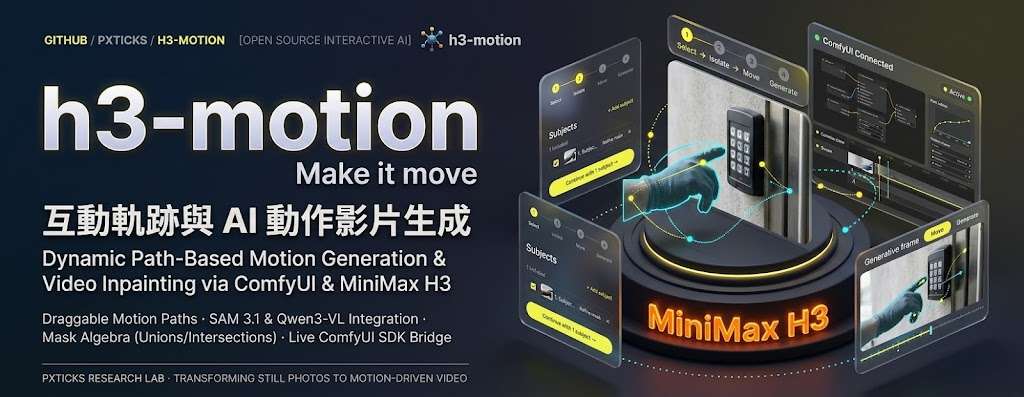
想沿路徑移動照片主體,或只重做影片局部,h3-motion 把兩種編輯流程整合在獨立 React app,透過 Comfy SDK 操作自架 ComfyUI。流程只用開放權重模型,不依賴 Comfy Router、合作夥伴節點或封閉 API。

照片流程以 SAM 3.1 選取主體,並可用點擊修整遮罩;Qwen3-VL 描述主體,Qwen Image 2.1 清除主體並補回背景。使用者設定路徑、大小或翻轉後,由 MiniMax H3 透過 Time-to-Move 生成動畫與聲音。

影片可用矩形或橢圓標出範圍,設定 keyframe 路徑或讓遮罩跟隨物件,並加入描述及可選參考圖。H3 重生成遮罩區域後,由 app 合成回原片;原有聲音可保留、參照或替換。

  • 照片:主體分割、背景清除,再沿路徑生成動畫。
  • 影片:局部遮罩、路徑或物件跟隨,並合成回來源影片。
  • 模型串連 SAM 3.1、Qwen3-VL、Qwen Image 2.1 與 MiniMax H3。

需要 NVIDIA 或 AMD GPU、近期 ComfyUI、ComfyUI-vlo 0.3.0 或更新版本,以及 Node.js 22.12 或更新版本;原生 Windows 尚未測試。文件未提供速度或畫質評測,較適合熟悉 ComfyUI、需要精細編輯影像局部的創作者。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, Qwen, NVIDIA, API, Video, Image, Audio, Content Creator, 動畫, MiniMax

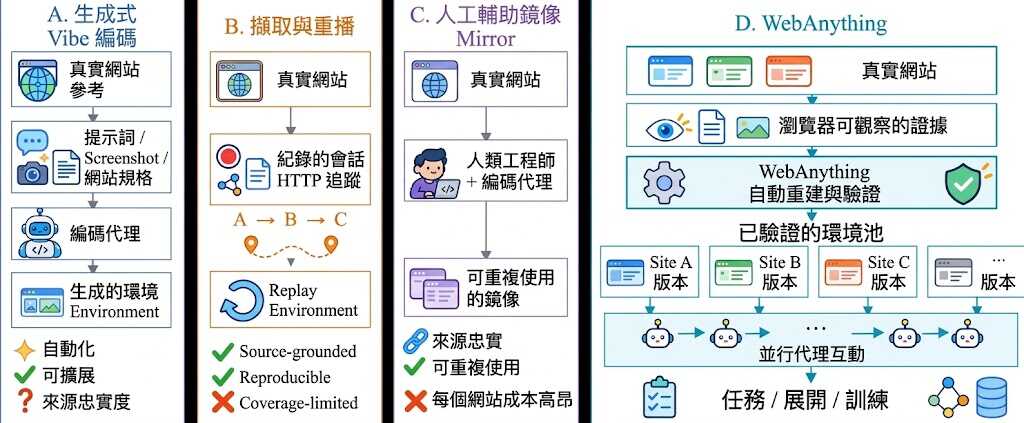
WebAnything 把真實網站重建成可重設的測試環境

從網站獲其內容重建互動網站,能在可重設的環境中完成任務。

WebAnything concept logo

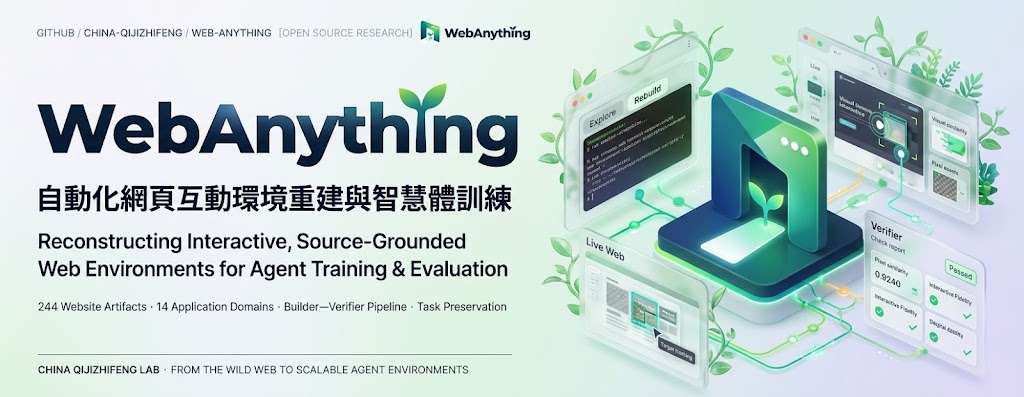
要訓練或評測 Web agent,截取網站畫面並不足夠,代理還要能操作控制項、切換頁面並完成多步任務。WebAnything 是一套研究程式碼,將網站證據轉成可執行、可重設的代理環境,目標是保留任務流程,而不只是重現畫面。

建構流程先由 Builder 透過瀏覽器探索網站,記錄頁面狀態、互動資料、DOM、畫面截圖及網絡資源,再重建環境。候選環境會先凍結,交由 Verifier 獨立檢查;發現實作錯誤或證據不足時,系統會針對問題修正。Full 模式適合追求較廣覆蓋,JIT 則按代理任務需要建構環境,兩者在完整度與建構成本之間作取捨。

項目分析了 6,172 個獲接納的來源任務執行紀錄,平均每個任務使用 10.4 個工具步驟,中位數為 8 步;34.7% 的任務超過 10 步,最長達 89 步。這些數字反映任務包含多步互動,但不能單獨代表重建保真度或代理能力;評估亦分別涵蓋歷史頁面狀態的保真度,以及模型在指定基準測試中的下游效用。

  • 適合研究 Web agent 訓練與評測、需要可重複網站任務環境的團隊。
  • Builder 和 Verifier 使用支援 Responses API 的模型服務;兩者需配置模型 ID、API URL 及 API key。
  • 本機需安裝 Chromium,瀏覽器操作由 Playwright 支援;代理亦需要終端機存取權。README 未列出最低 CPU、記憶體或 GPU 規格,不能據此判定具體硬件門檻。
  • 儲存庫提供建構流程及 244 個歷史網站項目的清單,但網站原始碼與第三方媒體存放在外部 artifact store,並未隨儲存庫附上。

Web agent 提供 Python 套件、命令列工具及設定流程,並可把本機 agent skill 安裝給 Codex 或 Claude Code;這個 skill 不是 MCP server。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 模型訓練, Qwen, API, 工具, Python, 庫, Anthropic, 中國, Dataset 數據集, Skill 技能

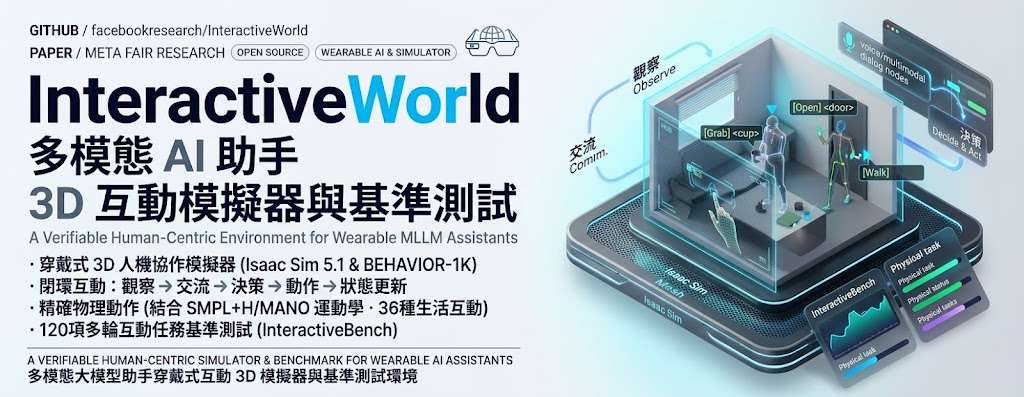
InteractiveWorld:把穿戴式 AI 助理放進可驗證的互動世界

穿戴式助理要看見甚麼、怎樣給建議,最後能否幫人完成任務,InteractiveWorld 把整段互動放進可持續變化的 3D 場景中測試。

First-person view of the human walking to a soda can, grabbing it, putting it on the coffee table and sitting on the sof

穿戴式 AI 助理不只要辨認眼前物件,還要理解人的要求、給出可執行的指引,並跟進行動後的變化。InteractiveWorld 是一套以人為中心的 3D 模擬器,用第一人稱視角呈現環境,讓助理與模擬人物多輪互動;同一個儲存庫亦提供 InteractiveBench,用來比較多模態大型語言模型(MLLM)在這類任務中的表現。

場景涵蓋 44 個 BEHAVIOR-1K 家居及活動空間。助理以對話提供建議,模擬人物則根據所見自行決定行動;研究者可用簡短指令描述抓取、開門、倒液體等操作,由模擬器處理移動、避障、操作物件及更新場景。世界狀態會延續到下一輪,因此助理要根據新視角調整回答,而非只生成一次性的文字答案。

InteractiveBench 收錄 120 個固定的多輪任務,分為六類,每類 20 個。評分會檢查場景中的狀態是否達成目標,而不是單憑回答文字判斷;基準亦提供評估流程、報告及影片。首頁資料提到曾以 12 個前沿 MLLM 進行評估,但所提供的內容沒有列出各模型分數,無法據此比較排名或判斷差距。

• 模擬器可用 Python API 開啟場景、執行動作、取得觀察結果及原生分數。
• 場景與人物行動涵蓋物件操作、室內移動及第一人稱畫面更新。
• 基準任務固定,適合研究團隊比較模型在多輪助理情境下的完成能力。
• 安裝指南列明資產準備與環境需求;執行需要處理 Isaac Sim 場景及相關資產,並非只呼叫一個輕量 API。

這個項目適合研究穿戴式助理、多模態模型及具身互動的團隊,尤其是需要可重複測試、以環境狀態核實結果的工作。模擬場景能補足純文字評測看不到的行動後果,但仍不能完全代表真實佩戴裝置時的感測誤差、人的習慣差異或實體操作風險;評測結果應視為模擬環境中的能力證據。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 多模態模型, API, Video, 3D, Python, 庫, Meta, 蘋果

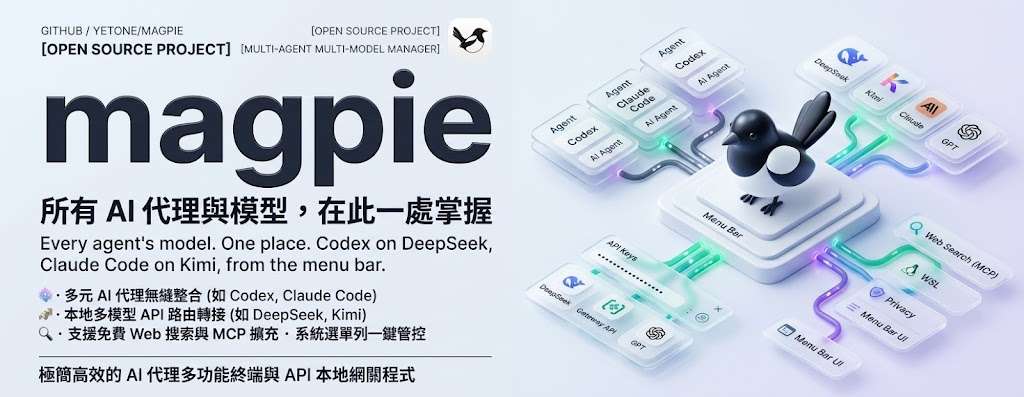
magpie:通過本機閘道,把不同 AI 編程代接上同一模型

Claude Code、Codex、Gemini CLI 等代理可以各自改用其他模型或訂閱帳戶;配額用完時,Magpie 亦可按設定切換帳戶或路由到其他服務。

magpie

想讓 Claude Code 用 Kimi、Codex 用 DeepSeek,或者讓 OpenCode 使用 ChatGPT 訂閱模型,不必逐個代理手動改一堆設定。Magpie 是一款跨平台工具,透過本機閘道統一管理模型與供應商,並從選單列切換代理設定;它改動的是各代理自己的關鍵設定,並非把不同代理合併成同一個程式。

它支援 API key、本機模型,以及 Claude、ChatGPT、Copilot、Gemini、Grok 等已登入帳戶。Claude 整合會呼叫本機的 Claude CLI,並透過 MCP(Model Context Protocol)橋接代理工具;ChatGPT 訂閱模型則可供其他代理使用。這讓使用者能沿用熟悉的代理工作流程,同時更換背後的模型來源。

配額耗盡時,Magpie 可改用同一供應商的另一個帳戶;若設定了路由群組,也可轉往其他模型或供應商。沒有備用帳戶或路由群組時,錯誤仍會傳回代理,因此不中斷並非無條件保證。隱私遮罩則須在設定中手動開啟,啟用後會在請求離開本機前遮蔽提示中的金鑰、密碼和電郵地址,再把內容還原到回覆。

  • 從同一份清單為不同代理選擇模型,減少逐個修改設定的工作。
  • 可混用雲端 API、本機模型和已登入的訂閱帳戶。
  • 帳戶或路由備援可降低配額用盡造成的中斷,但須先配置可用的後備路徑。
  • 隱私遮罩預設關閉,敏感資料保護需自行啟用。

對同時使用多個 AI 編程代理、需要管理不同供應商帳戶的個人或團隊,Magpie 可集中處理切換與備援;若只用單一帳戶,或不希望工具改寫代理設定,收益會較有限。項目支援 macOS、Windows、Linux、Docker 和 Termux;提供下載與文件,但所給資料未列出效能測試或延遲數據,選用前宜確認所需代理、模型與登入方式均在支援範圍內。

GitHub

Categories: 開源, MCP, 模型, 微軟, OpenAI, DeepSeek, Gemini, API, 工具, Mac, Linux, 編程, Anthropic, Kimi, MiniMax

Page 1 of 13
1 2 3 … 13