EarlyTom 令影片理解模型跑得更快

EarlyTom 以免訓練方式減少影片推理時所需的視覺 token,重點是加快推理而盡量保住表現。對 Video-LLMs 使用場景尤其有參考價值。

earlytom logo

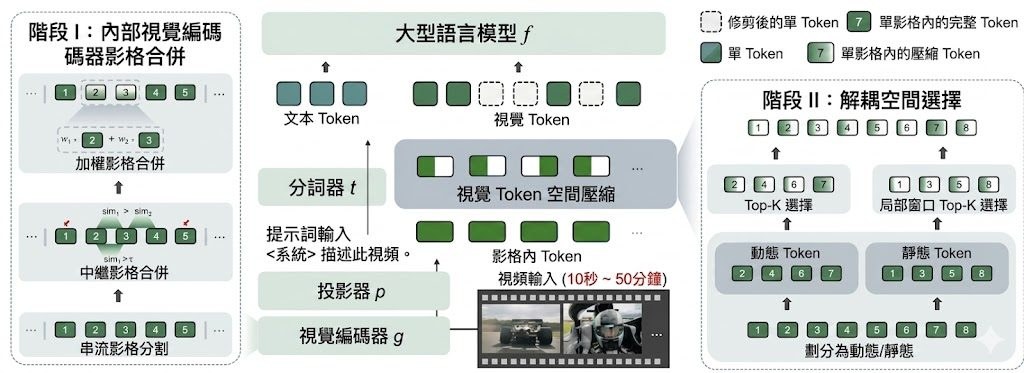
EarlyTom 是一個針對 Video Large Language Models(Video-LLMs)而設的 token 壓縮項目,目標很清晰:在不重新訓練模型的前提下,減少影片理解時要處理的視覺 token 數量。它主要處理推理速度慢、計算量高這個痛點,尤其是影片內容比圖片更長、更重,模型很容易在前段編碼就耗掉大量時間。

這個項目的核心想法,不是等資料全部進入模型後才壓縮,而是更早在 vision encoder 階段動手。EarlyTom 會利用早期 transformer layers 的 attention 訊號,先找出冗餘 token,再做裁剪;另有可選的 inner compression,會在 LLM backbone 指定層以 DPC-KNN 做 token 合併。這種早期壓縮方式,重點在於連 vision encoder 的負擔都一併減少。

使用上,項目是建基於 LLaVA-NeXT,並可包裝 LLaVA-OneVision 模型;程式層面是把已載入的模型再套用 EarlyTom。對已經在跑影片問答、影片描述或多模態理解流程的人來說,這代表可在原有模型管線上加入壓縮機制,而不一定要改動整個訓練流程。

  • 免訓練(training-free)壓縮,部署門檻相對較低
  • 分為 outer compression 與 optional 的 inner compression
  • 重點改善 Time-to-First-Token(TTFT)、throughput 與 FLOPs
  • 依賴早期 attention 訊號挑走冗餘視覺 token
  • 相關模型與框架包括 LLaVA-NeXT、LLaVA-OneVision、Qwen2

從公開資料看,作者以 lmms-eval 進行評測,並在論文內容提到會比較 MVBench、EgoSchema、LongVideoBench 與 VideoMME 等常見影片理解基準。結果描述顯示,它在維持接近 full-token 方法準確度的同時,TTFT 最多可降至 2.65×,亦有更高 throughput;不過不同模型大小、影片長度與硬件配置下,實際增益仍要分開看。

這個項目較適合已經使用 Video-LLMs 的研究者、工程團隊,或想在資源有限環境中提升影片理解效率的人。若你關心的是模型答得準之餘,也要更快開始輸出結果,EarlyTom 的價值就在於它把壓縮時機提早,直接針對最花時間的部分下手。
GitHub: https://github.com/viridisGreen/EarlyTom

項目: https://viridisgreen.github.io/EarlyTom/

Categories: 開源, 阿里巴巴, 視覺模型, 框架

YoCausal 用影片倒播測試模型因果感

YoCausal唔係教你生成影片,而係檢查模型有冇真正理解先後因果。它用真實影片倒播做基準,設計相當清晰。

YoCausal Logo

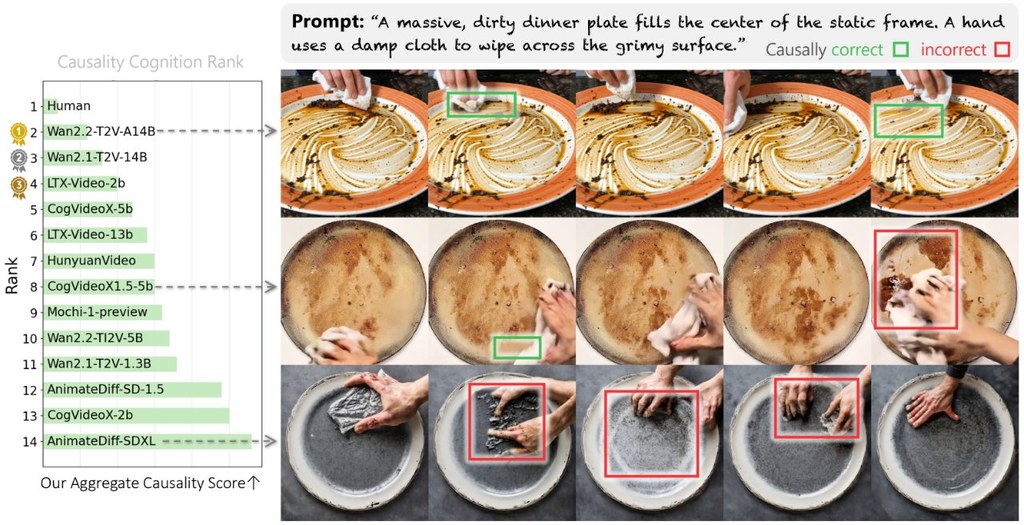
YoCausal 是一個用來評測 Video Diffusion Models(VDMs)嘅項目,核心問題好直接:模型見到一段影片時,究竟係理解事件因果,定只係記住畫面常見嘅時間模式。呢個項目用正播同倒播影片比較 denoising loss,若模型對正向影片分數更合理,代表它較能分辨自然因果關係。

它提出兩個關鍵指標:Reverse Surprise Index(RSI)同 Causality Cognition Index(CCI)。RSI 主要睇模型有幾多次偏好正向時間流;CCI 再進一步將「知道時間方向」同「真正理解因果」分開,避免只靠時間線索就被誤判為懂因果。

使用呢個項目時,重點唔係訓練新模型,而係替現有模型寫 evaluator,然後用指定資料集跑評測。項目亦提供 leaderboard 提交格式,會要求模型名稱、版本或 checkpoint、模型大小,以及 evaluation result JSON 檔案;若改動過預設設定或 preprocessing protocol,也要一併說明。

YoCausal: How Far is Video Generation from World Model? A Causality Perspective
  • 用真實世界影片倒播做 counterfactual,比純合成資料更貼近常見場景
  • 以 denoising loss 比較正播與倒播,測法清楚而且可擴充
  • RSI 測時間方向感知,CCI 嘗試拆出更接近因果理解嘅部分
  • 已評測 13 個 state-of-the-art VDMs,結果顯示時間感知不等於因果理解
  • 文件提到 Wan Model Evaluation(DiffSynth-Studio),亦支援排行榜提交流程

由論文內容看,YoCausal 最大價值係指出一個常被忽略嘅落差:影片生成愈靚,唔代表愈接近 world model。評測結果顯示,即使係表現較前嘅模型,例如 Wan2.2-A14B,與 human baseline 之間似乎仍有明顯差距;中後段模型如 CogVideoX1.5-5B、AnimateDiff-SDXL 則較易出現違反因果嘅畫面變化。

呢個項目適合研究 Video Diffusion Models(VDMs)、world model、影片理解與生成評測嘅人,也適合想比較不同模型因果能力嘅團隊。對一般開發者而言,它最有用之處係提供一套較有解釋力嘅檢查方法,幫你知道模型失分係因為唔懂因果,定只係對時間方向反應不足。

GitHub: https://github.com/youzhe0305/YoCausal

項目: https://www.youzhexie.me/papers/YoCausal/index.html

Categories: 開源, 視覺模型, 世界模型, 框架, 3D

contrastive-probing:拆解 VLM 空間判斷偏差的輕量診斷項目

這個項目不是再做一次答題測試,而是直接觀察 VLM 內部怎樣表示左右、高低與遠近。對想研究模型偏差的人很有參考價值。

Repository image for cheolhong0916/contrastive-probing

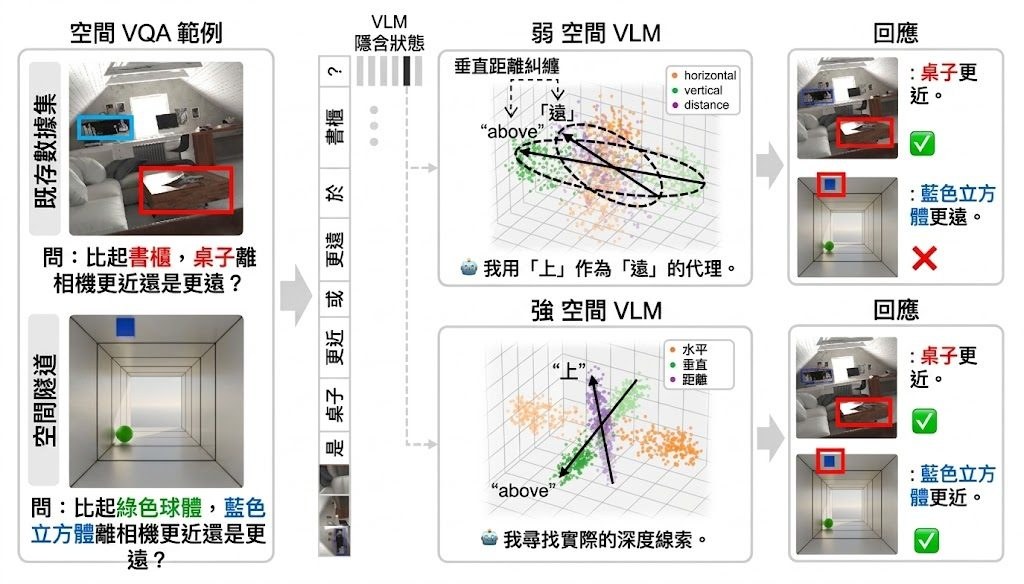
contrastive-probing 是一個用來檢查 Vision-Language Models(VLMs)內部空間表示的輕量項目,焦點不是模型答對幾多題,而是它腦內如何分開 left / right、above / below、far / close。它沿用論文《Why Far Looks Up: Probing Spatial Representation in Vision-Language Models》的 contrastive probing 方法,透過交換問題中的兩個物件,再比較 hidden states 差異,抽出 Δ vectors 作分析。

使用時,做法是把一張圖片配上一條原始空間問題,再生成一條交換 obj1 ↔ obj2 的對照問題,之後對同一個 VLM 跑兩次 forward,並在每層 transformer 擷取最後 token 的表示。這個流程可配合 🤗 transformers 載入的模型,然後輸出 Axis Coherence、6×6 Δ-similarity heatmap、2D/3D PCA 視覺化,以及 Vertical–Distance Entanglement Index(VD-EI)等結果。

這個項目解決的核心問題,是 benchmark accuracy 往往只告訴你模型有冇答中,卻未必揭示它是否用對了空間線索。論文與附帶說明指出,多個模型家族都出現 vertical-distance entanglement,也就是把畫面較高的位置誤當成較遠,反映自然照片常見的 perspective heuristic「higher in the image ⇒ farther away」。

  • 用最少對照設計觀察表示層,而不只看答題分數
  • 可比較不同 layer 的空間軸是否清晰分離
  • 能發現 vertical 與 distance 是否糾纏,幫助找出偏差來源
  • 適合分析 EmbSpatial-Bench、SpatialTunnel 這類空間推理資料

對研究者、模型分析人員,或者要檢查 multimodal assistant、robotics、embodied agents 背後空間推理可靠性的人,這個項目尤其有用。現有資料顯示,就算 benchmark 分數相近,不同 VLM 的內部表示也可能差很遠,而空間軸分得較清楚的模型,通常在不同測試上的穩健性會較好。

整體來看,這不是訓練新模型的項目,而是一套偏向診斷與解釋的工具。它的創新點在於用 minimal contrastive pairs 加上 representation-level analysis,把「模型為何會答對或答錯」拆成更具體的內部結構問題,對想深入理解 VLM 空間能力的人,價值比單看排行榜更高。

GitHub: https://github.com/cheolhong0916/contrastive-probing

項目: https://cheolhong0916.github.io/whyfarlooksup.github.io/

Categories: 開源, 視覺模型, 世界模型, 模型訓練, NVIDIA, 框架, 3D

minWM:由影片生成走向 World Model

minWM不是單一模型,而是一套由資料到推理的 World Model 框架。它特別照顧初學者,也兼顧研究與改造彈性。

Repository image for shengshu-ai/minWM

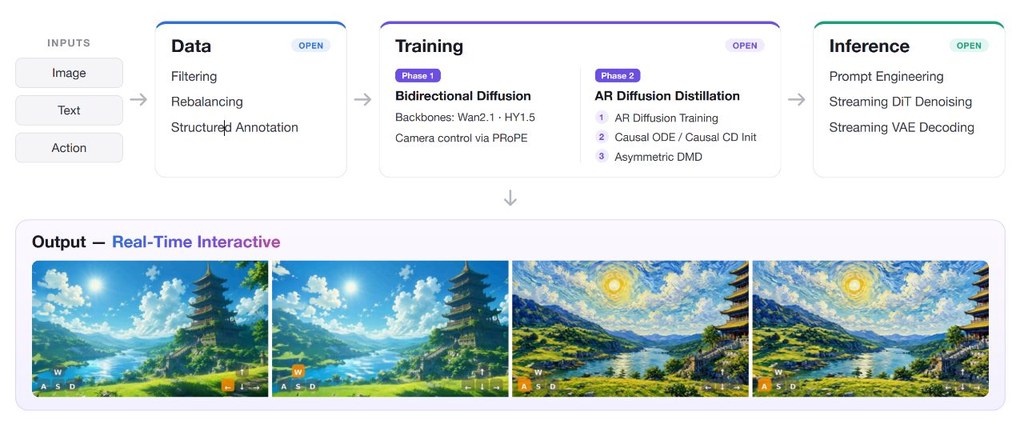
minWM 的定位很清楚:它不是再提供一個新模型,而是把建立 video world model 的整條流程拆開,讓人由 bidirectional T2V(Text-to-Video)或 TI2V(Text-and-Image-to-Video)基礎模型,一步步轉成 action-conditioned video world model。對剛接觸這個領域的人來說,這種完整路線比只放權重或單段程式碼更有幫助。

這項目重點不是「裝完即用」,而是按它提供的資料處理、訓練、蒸餾與推理流程逐段走。項目公開了 data → training → inference 的全流程,並提供 example data、runnable scripts、Claude Skills 與新手知識整理,方便你先跟一次標準流程,再按自己需要改 backbone、資料分佈或控制方式。

它要解決的問題,在於高質影片生成模型未必等同可互動的 world model。要做到低延遲、可因果 rollout、可回應鏡頭軌跡等操作,背後需要 camera control、autoregressive training、few-step distillation 及 streaming inference 等整套機制;minWM 正是把這些環節模組化,並用 Causal Forcing、Causal Forcing++、Teacher Forcing 與 asymmetric DMD 串連起來。

  • 支援 4-step DMD inference,並提到 multi-GPU sequence parallelism
  • 可用 pose strings 或 JSON 檔控制 camera trajectory
  • 提供 debug-world-model,整理 loss NaN、jitter、camera drift 等常見失敗模式
  • 提供 integrate-new-backbone,示範怎樣接入新的 video DiT
  • 參考 backbone 包括 Wan2.1-T2V-1.3B、HY1.5-TI2V-8B,亦提到 HY Action2V、HY TI2V、Wan Action2V

項目的新意在於它同時處理「怎樣訓練」與「怎樣改造」。除了支援不同 backbone 與 condition injection 方式,也把團隊累積的排錯經驗與 Claude 協作流程寫進項目,令研究者或工程人員不只看到結果,還能理解常見錯誤從哪裡出現。

它的目標是 real-time interactive video world models,並附有對 camera trajectory quality、controllability training steps、minimal batch-size requirements 的實驗分析。不過公開資訊較偏向框架與流程,若你想比較單一模型跑分,這個項目更適合當作建立、重現及擴展 World Model 的工作底座。

GitHub: https://github.com/shengshu-ai/minWM

Categories: 開源, 香港科技大學, Agentic, 模型, 視覺模型, 視頻模型, 世界模型, 模型訓練, 影像模型, 影像處理, 框架

CollectionLoRA:把多個效果 LoRA 濃縮成一個

把 50 甚至 180 個效果 LoRA 集中到單一 LoRA,減少部署成本,也降低多重 adapter 疊加帶來的干擾。

Repository image for Qwen-Applications/CollectionLoRA

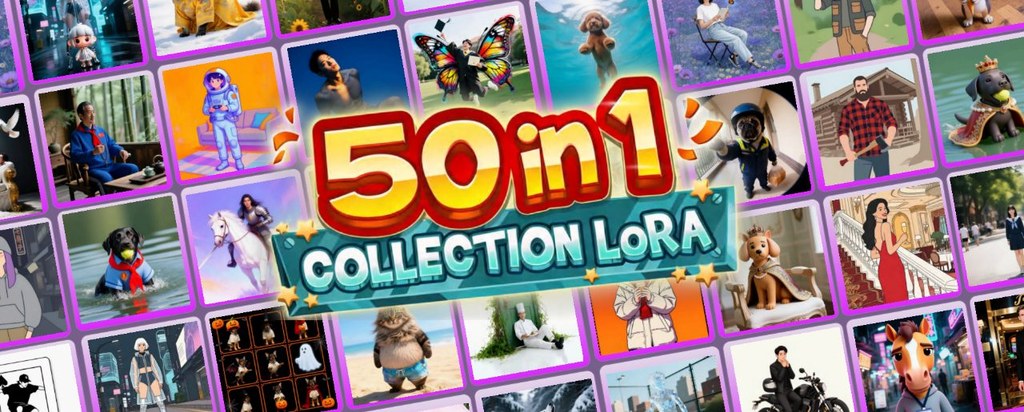
CollectionLoRA 是一個針對 LoRA 管理成本而設的項目,核心做法是用 multi-teacher on-policy distillation,將多個效果 LoRAs 的概念,以及 few-step generation 能力,一次過蒸餾進單一 LoRA。對一般使用者來說,意思就是原本要為不同效果切換或串接多個 adapter,現在有機會改用一個整合版本處理,流程會更簡潔。

使用這個項目時,重點不是由零開始訓練,而是先按項目提供的 ckpt/ 結構放好權重,之後以 50_in_1/ 作推理用途。倉庫亦提供公開的 training and inference code,而 data/manga_tone/ 內有起步用的 teacher LoRA 和示範訓練資產,方便了解整個資料與模型配置方式。

它解決的問題相當明確:當效果 LoRA 數量愈來愈多,部署、切換與疊加都會變得麻煩,配合 acceleration modules 時,還可能出現互相干擾。CollectionLoRA 嘗試把「多效果」與「少步數生成」合併到同一個 LoRA,這比單純收藏大量 LoRA 更像是重新整理整個工作流。

項目公開的重點包括幾個方向:
– 可把 50→1,甚至 180→1 的效果教師整合到單一 LoRA
– 在 EffectBench 上,文中稱其於 8 NFE 下可取得較高 VSA 與較低 BCR
– 支援 zero-shot 的 A ⊕ B 組合效果,推理時可配對兩個已訓練教師,無需額外訓練
– 已開放 training and inference code,但 model weights 仍標示為未全面開放

這個項目較適合會接觸生成效果控制、需要管理大量 LoRA 的研究者與開發者,也適合想減少部署複雜度的團隊。若你關心的是把多種風格或效果整合成較易分發的模型形式,CollectionLoRA 展示的方向很有參考價值;不過現階段公開資訊主要集中在框架、指標與示範資產,完整權重供應情況仍要留意項目後續更新。

GitHub: https://github.com/Qwen-Applications/CollectionLoRA

Categories: 開源, 阿里巴巴, 視覺模型, 影像模型, 影像處理, 框架

GEM 把深度圖生成帶入訓練流程

GEM把深度圖生成帶入訓練流程,目標是令模型更懂空間與動作。這個項目亦展示了由 VLM 走向機械人操作的延伸潛力。

overview

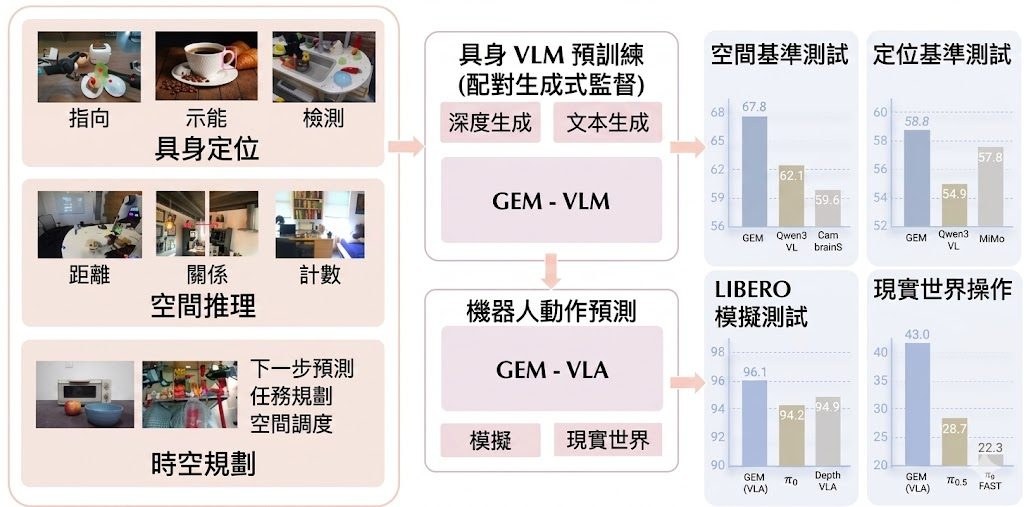
GEM(Generative-supervised Embodied vision-language Model)是一個面向具身智能的 Vision-Language Models(VLMs)項目,重點不是只靠文字與圖片對答,而是讓模型同時學會場景的空間結構。它加入了深度圖生成這個輔助目標,希望補足一般文字驅動預訓練較少接觸的物理與幾何訊息,令模型不只「看得明」,也更接近「知道怎樣在空間中行動」。

這個設計想解決的問題很清楚:很多模型在語意理解、問答和描述表現不錯,但一牽涉到距離、遮擋、方向、可操作位置,或者下一步應怎樣做,能力就未必跟得上。GEM的做法,是在預訓練階段直接把 depth map generation 放進去,令模型在學文字生成時,也學場景深度與結構。論文亦提到其方法結合 hybrid autoregressive-diffusion architecture,並以 progressive training strategy 先穩定生成模組,再聯合訓練。

GEM 比較適合研究與實驗用途。倉庫已提供 GEM-2B checkpoint、GEM-250K 資料樣本,以及 VLM training / inference 代碼;要動手測試,主要是先準備 Python 3.10+ 環境與 torch、transformers、deepspeed、flash-attn 等依賴,再把資料路徑、depth image 路徑、MODEL_PATH 和 OUTPUT_DIR 設定好。由於資料位置需要手動修改到程式檔案內,整個流程不像一般即開即用工具,比較像給熟悉模型訓練流程的人做重現、微調或延伸開發。

項目的亮點不止於模型結構,還包括資料方向。README 提到釋出的是 GEM-250K 樣本,而論文內容則描述了更大規模的 GEM-4M,涵蓋 grounding、reasoning、planning 以及 depth supervision。這表示團隊的重點不只是堆大模型參數,而是把具身任務常見的空間理解、時序規劃和物理推理,放進同一套訓練資料與目標內,這對 Embodied VLMs 走向 Vision-Language-Action Models(VLA)相當關鍵。

  • 核心方法是在 VLM 預訓練中加入 depth map generation,強化 physical grounding 與 spatial reasoning
  • 已公開的相關資源包括 GEM-2B、GEM-250K,以及訓練與推論代碼
  • 延伸版本 GEM-VLA 面向 Vision-Language-Action Models(VLA)與機械人操作
  • 依賴包含 torch>=2.6.0、transformers>=4.57.0、deepspeed、flash-attn、accelerate、peft、triton、torchcodec
  • 現階段較適合研究人員、ML 工程師,或想重現論文結果的團隊

性能方面,GEM 在多個 embodied benchmarks 上有強勁表現,而論文內容則進一步指出 GEM 與 GEM-VLA 在 diverse embodied benchmarks、LIBERO 模擬環境,以及 real-world robot tasks 取得 state-of-the-art results。從公開資訊可見,它比較的是空間推理、grounding 與任務執行能力,而不只是通用聊天或圖文問答分數。不過,倉庫頁面未完整列出所有可重現的評測表格與設定細節,使用時仍應以論文和後續釋出的完整資料為準。

整體來看,GEM最適合關注機械人、多模態學習、Embodied Intelligence 的讀者留意。若你正在找的是一個現成聊天助手,這個項目未必對口;但若你想了解下一代模型怎樣由「看圖答題」走向「理解空間並支援動作決策」,GEM提供了一條很具代表性的路線。相關模型與基礎包括 GEM、GEM-2B、待釋出的 GEM-8B、延伸版本 GEM-VLA,以及其代碼所建基的 Qwen3-VL、Sana、RDT2。

GitHub • Paper

Categories: 清華大學, 騰訊, Agentic, 模型, 視覺模型

LongCat-Video 1.5:生成更實用的長片

項目把多種影片生成工作放進同一模型,重點放在長影片質素與效率。對想比較開源影片模型的人,很有參考價值。

LongCat-Video

LongCat-Video 是一個 13.6B 參數的影片生成項目,主打把文字生成影片、圖片生成影片,以及影片續寫放進同一套架構。對一般使用者來說,最易明白的價值是:不用為不同影片任務分開找不同模型,處理流程可以更集中。

它解決長影片生成常見的畫面走樣、色彩飄移,以及愈生成愈差的情況。項目特別提到自己原生預訓練了影片續寫能力,因此在長時間內容上較有優勢,目標是生成分鐘級影片時仍保持穩定。

先決定輸入方式:有文字概念就做 Text-to-Video,有單張圖片就做 Image-to-Video,要接續既有片段就用 Video-Continuation。提供相關模型與延伸版本,包括 LongCat-Video、LongCat-Video-Avatar 1.5,以及 Hugging Face 與 ModelScope 上提供的模型頁面。

它同時強調速度與畫質。項目表示透過時間與空間兩個方向的 coarse-to-fine 生成策略,再配合 Block Sparse Attention,可在數分鐘內產出 720p、30fps 影片;這類設計對高解析度生成尤其重要,因為影片模型最常見瓶頸就是算力與等待時間。

  • 單一模型支援 Text-to-Video、Image-to-Video、Video-Continuation
  • 強調長影片生成,主打減少色偏與畫質退化
  • 以 coarse-to-fine 加速推理,兼顧效率與解析度
  • 提到用多重獎勵的 GRPO 強化學習提升整體表現

這項目較適合關注開源影片生成、長片段內容、角色或場景延續的人,也適合想研究統一式影片模型設計的開發者。其表現可比肩領先開源模型與新近商業方案,但更細的分數與比較細節,仍需要配合技術報告一併閱讀會較穩妥。

Evaluation Results

Text-to-Video

The Text-to-Video MOS evaluation results on our internal benchmark.

MOS scoreVeo3PixVerse-V5Wan 2.2-T2V-A14BLongCat-Video
AccessibilityProprietaryProprietaryOpen SourceOpen Source
Architecture––MoEDense
# Total Params––28B13.6B
# Activated Params––14B13.6B
Text-Alignment↑3.993.813.703.76
Visual Quality↑3.233.133.263.25
Motion Quality↑3.863.813.783.74
Overall Quality↑3.483.363.353.38

Image-to-Video

The Image-to-Video MOS evaluation results on our internal benchmark.

MOS scoreSeedance 1.0Hailuo-02Wan 2.2-I2V-A14BLongCat-Video
AccessibilityProprietaryProprietaryOpen SourceOpen Source
Architecture––MoEDense
# Total Params––28B13.6B
# Activated Params––14B13.6B
Image-Alignment↑4.124.184.184.04
Text-Alignment↑3.703.853.333.49
Visual Quality↑3.223.183.233.27
Motion Quality↑3.773.803.793.59
Overall Quality↑3.353.273.263.17

GitHub: https://github.com/meituan-longcat/LongCat-Video

Categories: 數字人, 模型, 視覺模型, 視頻模型, 世界模型, 影像處理

WorldKV 點樣用較少記憶保留影片世界記憶

WorldKV用檢索加壓縮方式,令影片世界模型更慳記憶體又更快。重點是在不重新編碼下,盡量保留長期視覺記憶。

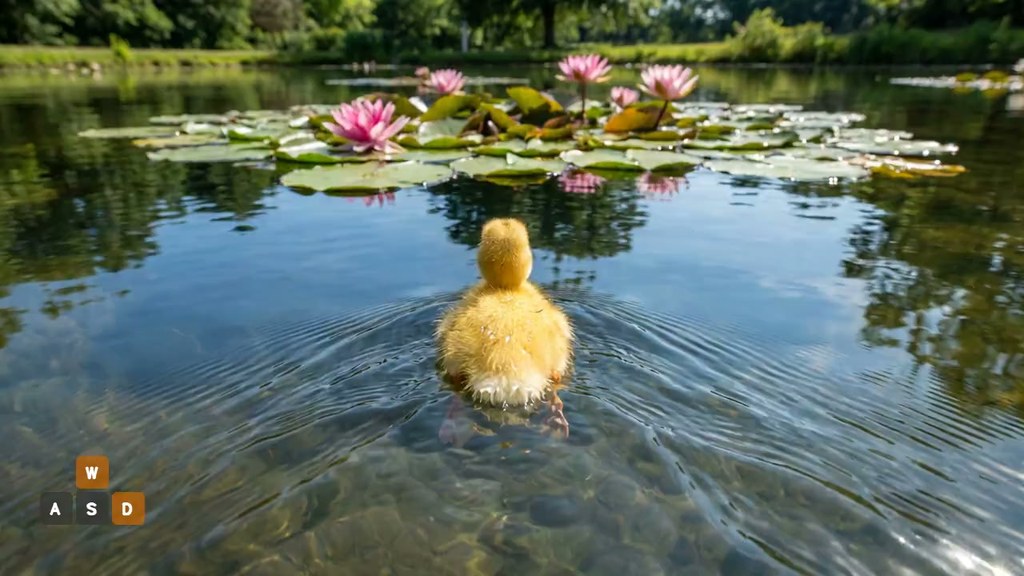
Input image: a yellow duckling swimming on a sunlit pond with water lilies

WorldKV 是一個針對自回歸影片世界模型的記憶管理項目,重點是用更少 KV cache 成本,保留模型對早前畫面與視角的長期記憶。頁面指出,它屬於免訓練框架,意思是不用重新訓練模型,就可以直接加到既有流程之中。

這個項目要處理的核心問題,是完整保留 KV cache 雖然有助模型記住之前見過的場景,但會很快吃光 GPU 記憶體,注意力計算亦會愈來愈慢。WorldKV 的做法是只在需要重訪某個視角或區域時,取回最相關的歷史片段,而不是永遠把全部內容放在作用中的視窗內。

它的設計有兩個關鍵部分:World Retrieval 會把被移出的 KV 片段按鏡頭或動作狀態建立索引,之後在合適時機取回最相關的 top-k 片段,而且不需要重新編碼;World Compression 則以每段首幀作錨點,利用 key-key cosine similarity 移除過於相似的 token,保留較能代表新區域或時間變化的資訊。

重點可留意:
– 屬於免訓練方法,較易接入現有模型流程
– 以檢索方式保留重訪所需記憶,而非硬性保存全部內容
– 以壓縮方式減少每段儲存量,頁面稱可減半
– 在 Matrix-Game 2.0 與 LingBot-World-Fast 上,吞吐量約提升至 2 倍,同時 KV cache 的 VRAM/RAM 佔用接近減半
– 頁面指記憶保真度可達到,部分情況甚至超過 Full KV

對想處理長影片生成、互動世界模擬,或需要模型記住先前視角與場景的人來說,這個項目特別值得留意。從頁面資訊看,它最適合受限於 GPU 記憶體、又希望維持即時或接近即時推理速度的情境;目前展示內容以項目頁與論文摘要為主,更細緻的限制與穩定性仍要留待論文與程式碼進一步確認。

*未有清楚列出完整基礎模型名稱。

項目: https://cvlab-kaist.github.io/WorldKV/

Categories: 視覺模型, 視頻模型, 3D

LatentOmni 想重寫影音推理方式

這個項目嘗試讓模型不只靠文字思考,而是直接結合聲音與畫面推理。對複雜影音理解來說,方向相當值得留意。

LatentOmni

LatentOmni 是一個面向影音多模態大語言模型的研究項目,重點不是叫模型先把線索全都翻成文字再慢慢推理,而是讓聲音與畫面的資訊在同一個潛在空間內一起運作。簡單講,它想保留更多原始感官訊號,減少中途只靠語言猜答案的情況。

這個方向要解決的問題很明確:不少模型在看影片、聽聲音後,雖然能描述內容,但一遇到需要同時對齊時間、事件因果或細節關聯的題目,表現便會下跌。LatentOmni 提出的做法,是把文字推理流程與影音潛在狀態交錯進行,並用 OSPE 這類時間同步設計,幫助模型對準聲畫節奏。

從使用角度看,現時這個 GitHub 儲存庫仍以論文與概念介紹為主,訓練程式、推論程式、模型權重和資料集尚未正式釋出。因此較適合先拿來了解新一代多模態推理方法,或者作為研究與技術評估的參考,而不是立即部署到產品流程。

  • 核心亮點是統一聲音與畫面的潛在推理,而非只輸出文字式思路
  • 加入特徵層級監督與 OSPE,目標是保留時間對齊與跨模態關聯
  • 配套資料集為 LatentOmni-Instruct-35K,用來訓練交錯式影音推理軌跡
  • 論文指出它在多個影音推理基準上,表現優於明確文字 CoT 基線

整體來看,這個項目最吸引之處,是它把「模型怎樣思考」由文字中介,推前到更接近原始聲畫訊號的層面。適合關注 MLLM、影音理解、跨模態推理的人留意;若你想比較相關模型,也可把它與依賴文字 CoT 的開源多模態模型放在同一條線上觀察。不過現階段公開內容有限,性能細節仍應以論文報告為準,評估時要保持審慎。

GitHub: https://github.com/yfanDai/LatentOmni

Paper: https://arxiv.org/pdf/2605.22012

Categories: 開源, 香港科技大學, 北京大學, 清華大學, 模型, 視覺模型, 影像處理, 聲效, 中國

VideoRLVR:教影片模型學會推理

這個項目把強化學習帶入影片推理訓練,重點是用可驗證獎勵提升解題能力。對想研究生成式影片與推理結合的人特別值得留意。

Repository image for luka-group/VideoRLVR

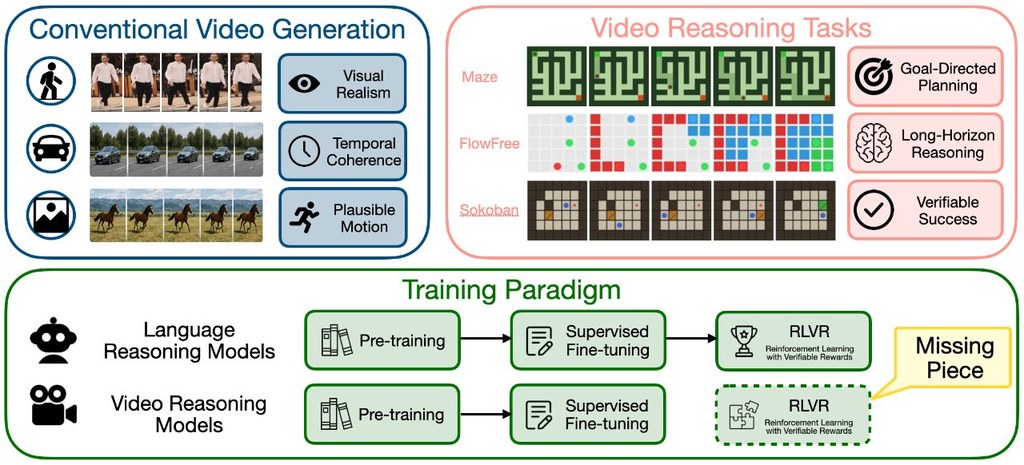
VideoRLVR 是一個用來訓練影片推理模型的項目,核心做法是把強化學習加入影片生成流程,並用「可驗證」的獎勵來判斷答案是否正確。簡單說,它不是只追求畫面像真,而是希望模型在生成影片時,連帶表現出可檢查的解題能力。

這個項目目前圍繞 Wan2.2-TI2V-5B 展開,並以 Maze、FlowFree、Sokoban 這類有明確規則的任務作為訓練與評估場景。這類設計的好處,是模型表現不只靠主觀觀感,而是可以透過任務成功與否來量度,對研究推理能力特別重要。

要理解這個項目,可先由它提供的資源入手:公開集合內有 SFT 與 RLVR 檢查點,也有訓練及測試資料。程式結構亦分開了訓練、推論與評估腳本,並提供多任務及單一任務版本,方便比較不同設定下的結果。

  • 重點放在可驗證獎勵,比只看主觀生成質素更易評估
  • 以 Wan2.2-TI2V-5B 為基礎,提供 SFT 與 RLVR 相關模型
  • 任務涵蓋 Maze、FlowFree、Sokoban,偏向規則清晰的推理測試
  • 已整理模型與資料集到 Hugging Face,查找資源較方便

這個項目的新意,在於把影片生成與可量化的推理訓練更緊密地結合,並且明確提供一套可重複的訓練配方。從 README 可見,它亦包含多任務訓練、純成功訊號版本,以及 OOD 推論與評估腳本,表示作者不只關心是否學會指定題目,也在意模型離開熟悉分佈後的表現。

適合留意這個項目的人,包括研究多模態模型、影片生成、強化學習,或想觀察模型如何在規則環境中表現推理能力的開發者。至於性能數字,這份儲存庫摘要未展示完整量化結果,因此較穩妥的看法是:它的價值目前更偏向研究方法、訓練流程與公開資源,而不是單靠一兩個分數定勝負。

GitHub: https://github.com/luka-group/VideoRLVR

Paper: https://arxiv.org/pdf/2605.15458

Categories: 開源, 視覺模型, 微軟, 深度學習

Page 18 of 23
1 … 16 17 18 19 20 … 23