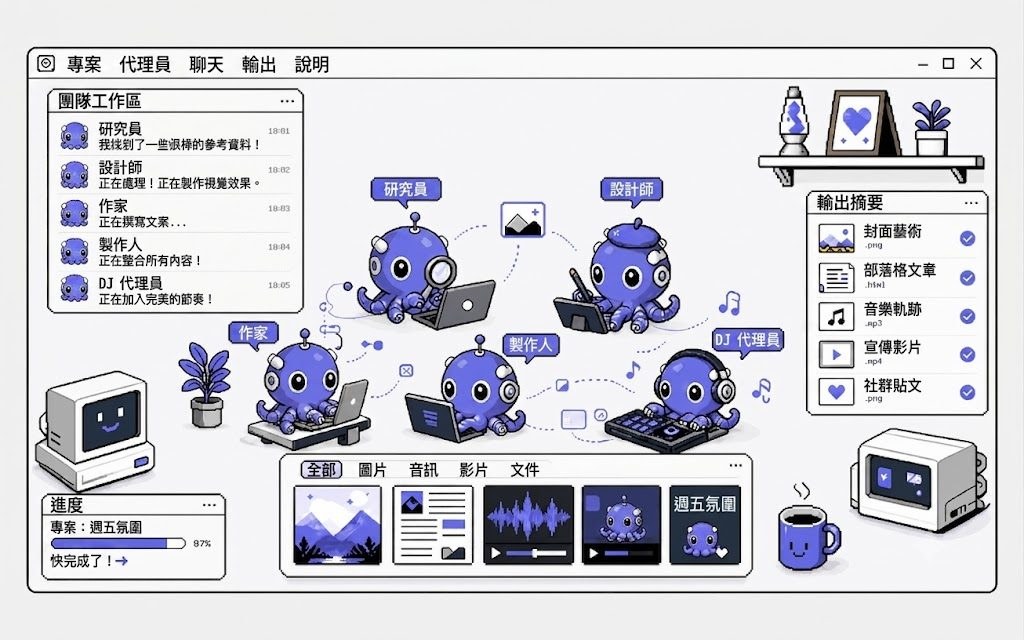
MiniMax Hub:本機優先的多模態創作工作站

MiniMax Hub把文案、影像、影片與配音流程放進同一個創作畫布。重點是本機優先,素材可留在自己電腦。

MiniMax Hub

MiniMax Hub 是一個 Multimodal Creative Agent,定位像 AI 創作工作站,不只是聊天工具。它把 Copy Generation、Image Creation、Video Editing、Audio & Voiceover、Auto Packaging 與 Multi-format Export 整合在同一個流程,讓用家由想法到成片可在一處完成。

它支援 macOS 與 Windows 下載,輸入簡報、文字想法,或直接加入本機素材後,主代理會先理解創作目標,再做 Smart task decomposition,之後交由多個 agents 並行處理文案、視覺與音訊。用家仍可手動選模型,亦會在關鍵節點收到確認,避免流程完全黑箱。

這個項目在於把創作流程保存成可重用的 Skills。系統會隨工作過程累積你的做法與風格,之後可重複套用;如果需要,也可從 MiniMax Skills Market 啟用現成 Skills 或外掛。對經常製作短劇、電商內容、品牌 TVC 與廣告素材的團隊來說,這類流程重用能力相當實用。

  • 本機優先設計,頁面明確指出 local files stay on your machine
  • 單一畫布整合腳本、分鏡、影片、音樂與剪輯流程
  • 支援資產管理與 batch generation,可一次產出多個版本
  • 代理會自動分解任務,並在關鍵步驟要求人工確認
  • 可把工作流程沉澱成 Skills,逐步累積個人或團隊方法

MiniMax Hub較著重工作流編排與創作協作,而不是單一模型能力展示。網站未列出具體性能分數或公開評測結果,因此較適合把它理解為面向內容製作的本地化 AI 工具平台。文中未提供明確模型清單,只提到會自動匹配最合適模型。
項目: https://hub.minimax.io/

Categories: Agentic, AI productions, 模型, 視覺模型, 多模態模型, 視頻模型, Video, Image, Audio, 軟件, Mac, 語音, Win, 音樂, Skill 技能

BRDFusion:物理與生成模型合體,城市街景逆向渲染新框架

結合物理渲染與生成式擴散模型,把城市影片拆解為幾何、材質與 HDR 光源,支援夜景模擬與物件插入等編輯應用。

logo

現有的城市場景逆向渲染方法長期面臨兩難:基於物理的渲染(physically-based rendering)雖然能嚴格遵守光學物理,但在重建與渲染階段容易產生雜訊與破圖;生成式模型(generative models,例如 DiffusionRenderer)能產出逼真影像,卻難以精準控制光源,例如車燈這類局部照明往往被忽略。BRDFusion 正是針對這個 trade-off 而設計的混合框架。

這個項目屬於研究型框架,目標是把多視角城市影片分解為幾何(法線、深度)、材質(albedo、roughness、metallic)與 HDR 環境光源,並支援新視角重照明、夜景模擬與動態物件插入等下游應用。具體做法上,它先用物理模型取得明確且一致的場景屬性,再借助生成式先驗(generative priors)緩解優化過程中的歧義;前向渲染時,物理模型負責可控渲染,生成模型則負責去噪與修補瑕疵。

測試方面,作者提供預處理資料集與預訓練權重,研究人員可直接下載並透過 tools/run_pipeline.py 跑推理與評估;硬體需求偏高,建議使用 NVIDIA RTX A6000,RTX 4090 在記憶體允許下可執行部分階段,但 Gen. Render 階段可能突破 24 GB 限制。資料集與評估影片亦同步發佈於 Hugging Face,方便重現結果。

這個項目的創新之處在於把「物理一致性」與「生成式品質」放在同一條管線中互補,而非二選一。對從事自動駕駛模擬、遊戲或影視場景重建的研究團隊而言,這是一個值得關注的方向。

重點摘要

  • 混合範式:物理渲染負責可控性,生成模型負責修補瑕疵,突破單一方法的極限。
  • 完整分解:輸出幾何、材質與 HDR 光源,支援新視角、夜景與物件插入。
  • 高硬體需求:建議 RTX A6000,4090 僅能跑部分階段。
  • 完整開源資源:程式碼、預訓練權重、資料集與評估影片均已公開。
  • 適用場景:自動駕駛模擬、城市數位孿生、影視級場景編輯。

GitHub: https://github.com/shigon255/BRDFusion

Categories: 開源, 清華大學, 模型, 視覺模型, 模型訓練, NVIDIA, Stable Diffusion, Video, Image, 影像模型, 影像處理, 框架, 工具, Meta, 深度學習

OmniDirector:免配對數據的多鏡頭運鏡克隆技術

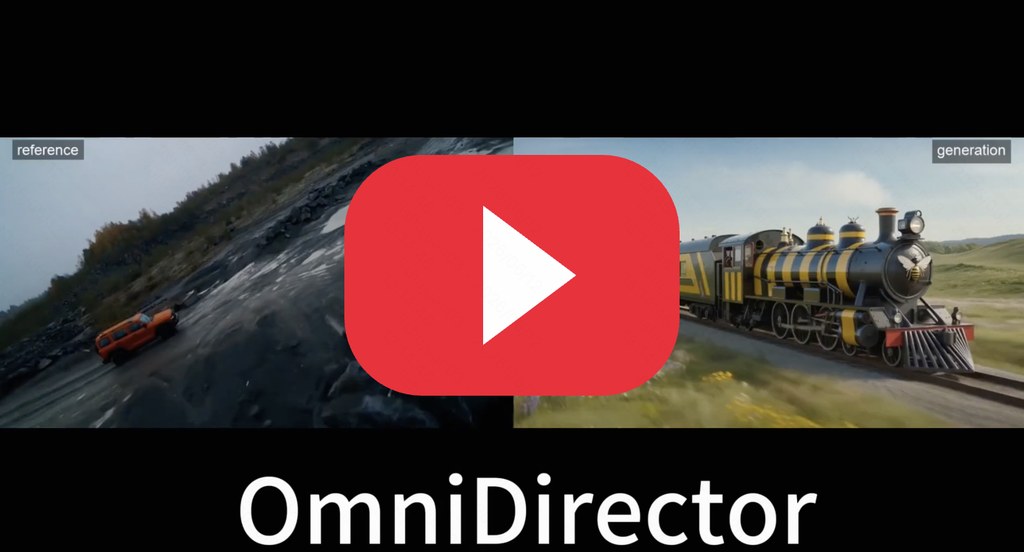
OmniDirector 透過「相機網格」表示法,從多鏡頭影片中克隆運鏡動作,驅動靜態圖像生成動態影片,無需交叉配對數據訓練。

Play video

OmniDirector 由清華大學(Yu-Shen Liu 為北京清華大學團隊)與 Kling Team(快手科技)的研究團隊,共同開發,成員包括 Jiwen Liu、Shujuan Li、Zhixue Fang 等人,團隊來自多個機構,橫跨學術界與業界。研究團隊提出一種無需交叉配對數據的通用多鏡頭相機克隆方法,解決從參考影片中複製運鏡來驅動靜態圖像的難題。

傳統相機控制方法往往依賴大量成對數據進行訓練,而 OmniDirector 的核心創新在於提出「相機網格」(camera grid)表示法。將參考影片的相機姿態渲染為三維空間中的運動軌跡,形成統一的網格表示。配合階層式提示詞擴展代理(hierarchical prompt expansion agent),把多模態控制信號整合成協調的指令。

使用時,使用者只需提供一張源圖像和一段參考影片,OmniDirector 便能克隆其中的運鏡動作,生成動態影片。多鏡頭場景下,新方法支援鏡頭之間的連貫過渡與一致的內容呈現,保持原始的視覺語言。特殊運鏡方面,涵蓋希區柯克式變焦、子彈時間與鏡頭畸變效果,適用的場景類型包括人像、動物、建築及 AIGC 內容等。

OmniDirector: General Multi-Shot Camera Cloning without Cross-Paired Data

OmniDirector 適合從事影片創作、動畫製作或需要快速生成動態素材的內容創作者,以及研究相機控制技術的開發者。經過與其他頂尖相機控制方法的對比,新方法在控制穩定性與物件形變方面表現出色。

重點摘要:
– 核心創新為「相機網格」表示法,免依賴交叉配對數據
– 支援極端運鏡、多鏡頭連貫過渡與特殊相機效果
– 場景泛化能力強,涵蓋人像、動物、建築及 AIGC 內容
– 開源提供論文與程式碼,方便研究與應用

目前 github.com/lisj575/OmniDirector 這個倉庫是空的,沒有 source code 或 model 。

項目: https://ymlinfeng.github.io/OmniDirector.github.io/

Categories: 北京大學, 清華大學, AI productions, 數字人, 模型, 視覺模型, Video, 框架

SpatialClaw:用程式碼推動空間推理代理

SpatialClaw把程式碼變成代理的動作介面,主攻複雜空間推理。它在20個基準上交出明顯領先的平均成績。

SpatialClaw logo

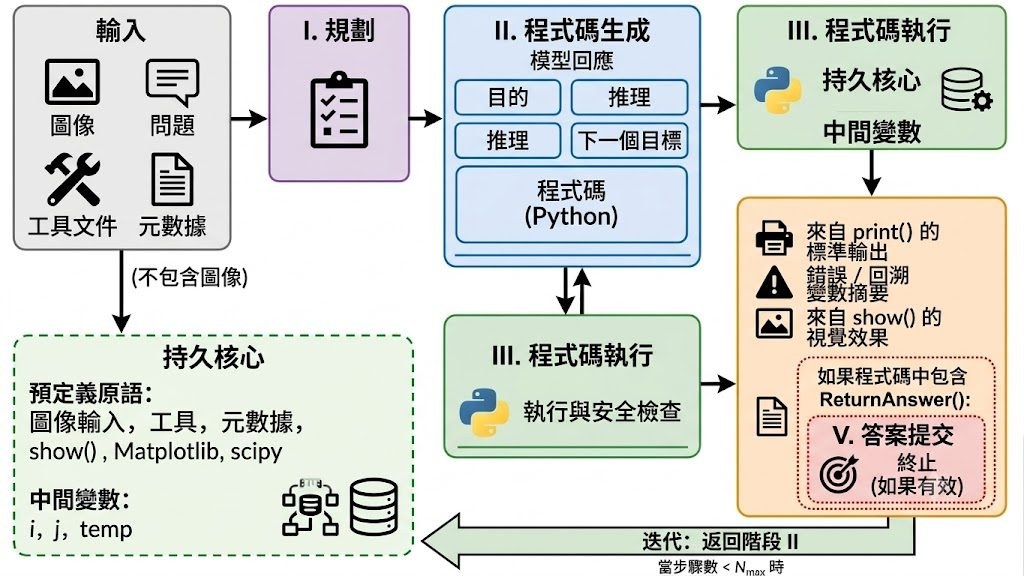
SpatialClaw 是一個免訓練的空間推理框架,重點不是再加更多工具,而是改寫代理如何調用工具。它把程式碼當成動作介面,讓 Vision-Language Model 代理逐步寫入 Python cell,在同一個持續運行的 Jupyter kernel 內查看中間結果、再調整下一步判斷,目標是處理 3D、4D 以及影片場景中的空間理解問題。

這個項目的新意,在於它避開單次執行整段程式或僵硬的 tool-call 方式。代理每次只提交一格程式,能結合 SAM3 segmentation、Depth-Anything-3 reconstruction、geometry utilities,以及 NumPy、SciPy、Matplotlib 這類科學運算庫,分析過程更像逐步查證,而不是一次過猜答案。

如果你想測試它,較合適的做法是用多視角圖片、影片片段,或需要判斷位置、距離、遮擋、移動關係的題目來跑。文件亦提到部署模型有明確硬件要求:FP8 版本需要 Linux 與 NVIDIA Hopper(H100)或更新 GPU;若手上是 A100 或 L40S,則可改用 models.json 內列出的 AWQ 或 GPTQ Int4 條目,並沿用相同 served_name,模型設定毋須重改。這也反映 NVIDIA 近年在 Robotic 與 World Model 相關項目上的投入相當積極。

成績方面,公開資料指出它在 20 個空間推理基準取得 59.9% 平均準確率,比先前最佳空間代理高 11.2 個百分點。更重要的是,這個結果據稱在相同 system prompt、工具組合與 hyperparameters 下完成,覆蓋六個 VLM 骨幹,代表它的提升未必只靠特定 benchmark 微調。

  • 屬於空間推理代理框架,解決 VLM 在 3D/4D 關係判斷上不夠靈活的問題
  • 核心方法是以程式碼作為動作介面,逐步執行與修正分析
  • 支援的感知模組包括 SAM3 segmentation、Depth-Anything-3 reconstruction 與 geometry utilities
  • 公開結果涵蓋 20 個 benchmarks,平均準確率為 59.9%
  • 相關模型家族包括 Qwen3.5、Qwen3.6、Gemma4,規模由 26B 至 397B

這個項目特別適合研究 Computer-use agents、空間智能、機械人感知,或者想比較 tool-augmented agent 與 VLM 推理流程的人。若你關心的不是聊天表現,而是模型能否一步步觀察畫面、調工具、修正推論,SpatialClaw 展示了一條幾有說服力的路線。

GitHub: https://github.com/NVlabs/SpatialClaw

項目: https://spatialclaw.github.io/

Categories: 開源, Agentic, 模型, 視覺模型, NVIDIA

SCAIL-2 把動畫角色控制再推前一步

SCAIL-2 是一個開源角色動畫模型,主打直接用影片條件驅動角色動作。它想解決骨架與遮罩中介帶來的資訊流失。

Teaser

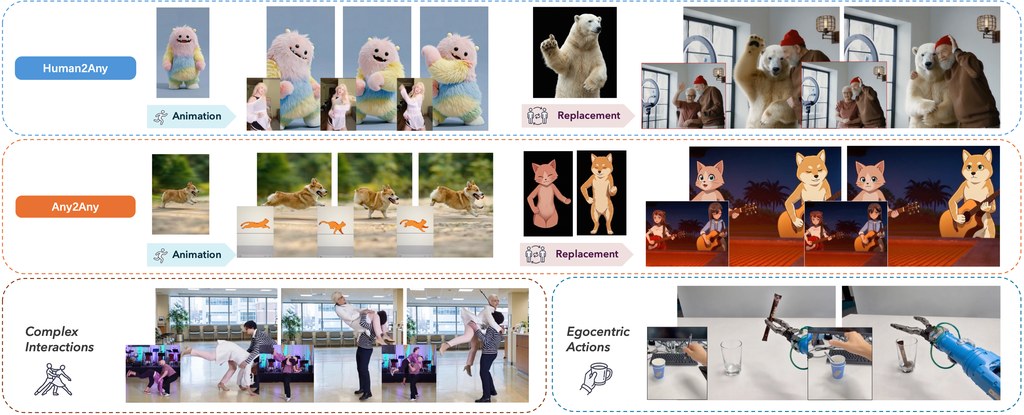
SCAIL-2 是一個用於 End-to-End Character Animation 的開源模型,重點是把驅動影片的視覺資訊直接送入模型,減少依賴 skeleton、mask 這類中介表示。它要處理的問題很明確:傳統角色動畫控制在複雜動作、多角色互動、跨角色替換時,容易因中介資訊過少或含糊而失真。

這項目在於把多種角色動畫子任務合併成同一套流程,並以 Unified Motion Transfer Interface、in-context mask conditioning 與 mode-specific RoPE 作統一控制。根據公開說明,模型還利用 MotionPair-60K 這類合成動作配對資料訓練,並支援 cross-identity replacement、multi-character animation,甚至 animal-driving 與 mesh-based control 這些 zero-shot 能力。

可調參數包括 denoising steps、flow-matching scheduler shift、classifier-free guidance scale、solver,以及是否啟用 offload model;這些設定會影響生成速度、顆粒感與顯示資源負擔,較適合已有 GPU 環境、想比較不同動畫控制效果的人。

  • 用模型來把驅動動作轉到指定角色身上
  • 不再把 skeleton map 當核心依據,目標是減少資訊流失
  • 已列出相關模型:SCAIL-Preview、Wan-Animate、MoCha、SAM3D-Body
  • 可處理多角色、角色替換、跨身份動畫等場景
  • 推論可調整 steps、guide scale、solver 等參數

如果你是做 AI 影片、虛擬角色內容、動畫研究,或者正留意角色動作遷移技術,SCAIL-2 有一定參考價值。至於效能表現,項目明確表示它在多項任務上優於既有 state-of-the-art approaches。

GitHub: https://github.com/zai-org/SCAIL-2

項目: https://teal024.github.io/SCAIL-2/

Categories: 開源, 模型, 視覺模型, 視頻模型, 影像處理, 框架

Bernini:影片生成與編輯的新路線

Bernini 是統一式的影片生成與編輯框架,目標是令生成與修改片段更可控。硬件要求不低,但定位相當鮮明。

Bernini

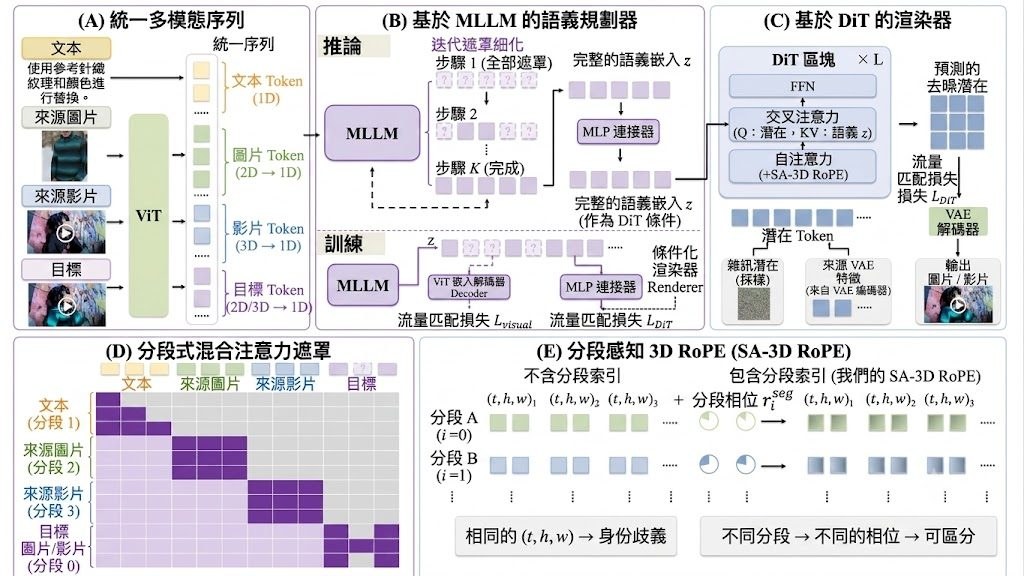
Bernini 是一個影片生成與編輯框架,核心是把 MLLM-based semantic planner 與 DiT-based renderer 組合起來,處理一般影片擴散模型常見的內容漂移、指令跟從不穩定,以及長片段規劃鬆散等問題。從定位看,它不是單純再堆大模型,而是先做語意規劃,再交由生成器落實畫面。

這個項目的關鍵想法,在於「Latent Semantic Planning」:先在潛在空間安排語意,再做 video diffusion。對非研究背景讀者來說,可以理解為先寫分鏡草稿,再逐格畫面化,這比直接由文字一步到位生成影片,更有機會保持故事連貫和編輯意圖一致。

如果想試,較合理的切入點是影片編輯任務,例如風格轉換、字幕或水印移除、局部修改,再觀察輸出有沒有跟足指令。倉庫列出的環境偏高階,建議準備 CUDA 12.4、Python 3.11.2,以及 torch==2.5.1+cu124、diffusers==0.35.2、accelerate==0.34.2、transformers==4.57.3;若有 H100、H800、H200 可配合 FlashAttention-3,其他 CUDA GPU 則退回 FlashAttention-2 或 PyTorch SDPA。

Bernini 在 video editing 的表現進入部分主流 closed-source commercial models 的第一梯隊,評分來自其自建 arena,以人工盲選、Bradley-Terry score 及 pairwise win-rate matrix 彙整。這類結果有參考價值,但暫時主要反映編輯場景;若你關心更複雜的人物生成,官方也提到 1.3B 的 Bernini-R 在簡單任務接近 14B 版本,面對複雜任務仍有差距。

Bernini: Latent Semantic Planning for Video Diffusion
  • 核心組成是 MLLM-based semantic planner + DiT-based renderer
  • 已公開 Bernini-R 權重,包含 1.3B 版本
  • 適合研究影片生成、影片編輯流程,或想比較規劃式生成方法的人
  • 硬件門檻偏高,Multi-GPU sequence parallel 亦需要 Open-VeOmni
  • 相關模型可先留意 Bernini-R-1.3B-Diffusers,以及文中提到的 14B 變體

整體來看,Bernini 最有價值的地方不是「再一個影片模型」,而是把規劃與渲染拆開處理,令可控性成為主要賣點。若你想找可直接在普通電腦輕鬆跑的項目,它未必合適;但如果你重視研究方向、編輯質素與系統設計,這個項目相當值得細看。

GitHub: https://github.com/bytedance/Bernini

Categories: 開源, 字節跳動, 模型, 視覺模型, 視頻模型, 影像模型, 影像處理, 框架, 語音

OmniCap-IF:讓影片描述模型聽懂你的格式要求

這個項目提供全新基準與模型,專門測試影片描述能否同時遵守複雜的格式與內容指令,並開源數據集協助改進。

OmniCap-IF evaluation framework

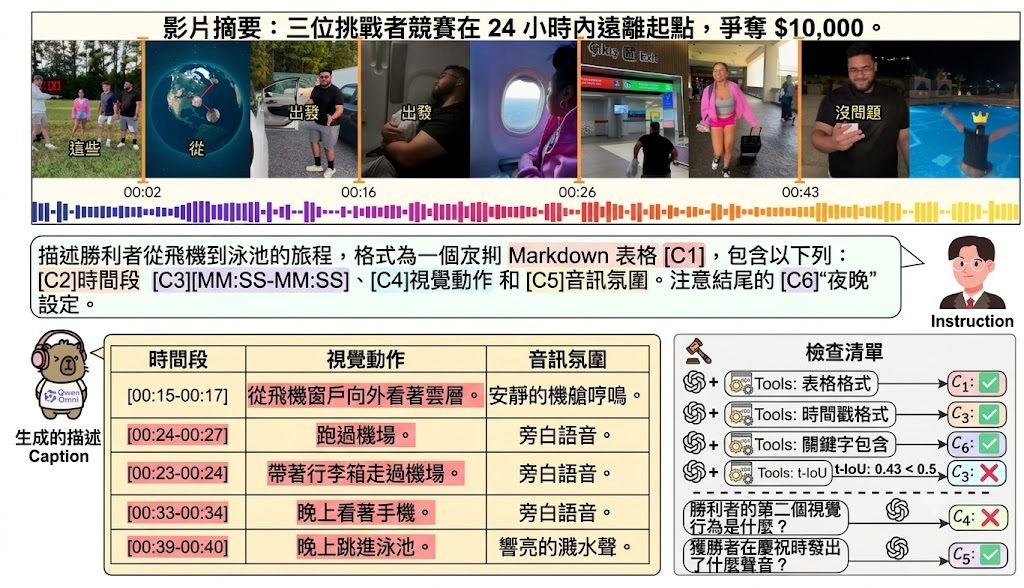
現時不少多模態模型可以為影片自動生成字幕或描述,但當用戶要求「用 Markdown 表格整理時間點」或「特別提及背景音樂」等具體指示時,模型往往只輸出一般化文字。OmniCap-IF 正正針對這個落差,研究模型能否在理解畫面與聲音之餘,亦嚴格跟隨用戶指定的結構、風格、時間、視覺、音訊與音視覺等多重限制。

這個項目由南京大學 NJU-LINK 團隊與快手 Kling 團隊合作推出,包含三部分:用作評估的 OmniCap-IF Benchmark、用作訓練的 OmniCap-IF-54K 數據集,以及以此微調出來的 OmniCaptioner-IF 模型系列。基準涵蓋 480 段影片共 1,920 條樣本,橫跨 50 種約束類型,平均片長約 54.6 秒,並以清單式評分機制同時檢查格式與內容。

對研發人員而言,最直接的做法是透過 Hugging Face 下載預訓練模型(提供 3B 與 7B 兩個版本),再以 Python 載入影片並輸入帶有格式要求的指令。模型會根據指令產生相應的影片描述,研究者便可與基準結果比較,判斷自家系統在指令遵從度上的強弱。

這個項目的創新之處在於雙軌評分機制:一方面驗證輸出是否符合結構規定(例如段落、表格、時間戳),另一方面把內容拆成視覺、音訊與音視覺三個維度逐一核對,並加入時間定位。這種「分項打分」比單純的整體相似度更能診斷模型失誤的位置。配套的 54K 訓練集亦採用了「內容與格式分離生成」的策略,令模型在複雜格式下仍能保持內容準確。

適合從事影片理解、字幕生成、內容審核或需要可控 AI 輸出的團隊。

重點摘要:

  • OmniCap-IF Benchmark:1,920 條樣本、50 種約束的影片描述指令遵從評估基準。
  • OmniCap-IF-54K:54,000 條影片—指令—回應三元組的訓練數據集。
  • OmniCaptioner-IF:3B 與 7B 兩款模型,可從 Hugging Face 直接下載。
  • 雙軌評分機制:分開檢查結構格式與視覺/音訊/音視覺內容。
  • 時間定位能力:把時間戳準確度納入評分,支援需要時序分析的應用。

GitHub: https://github.com/NJU-LINK/omnicap-if

項目: https://nju-link.github.io/OmniCap-IF/

Categories: 開源, 視覺模型, 框架

Stream3D-VLM 把串流影片變成 3D

處理的不只是影片,而是邊看邊理解空間。Stream3D-VLM把串流畫面、幾何資訊與語言回應連起來。

Stream3D-VLM Logo

Stream3D-VLM 是一個 online 3D vision-language model,重點是直接從串流影片做即時空間理解,而不是等整段影片或整個場景收集完才分析。對想研究機械人、空間問答,或 3D 場景互動的人來說,這個項目處理的是「模型可否一邊看、一邊建立場景概念,再即時回答問題」這件事。

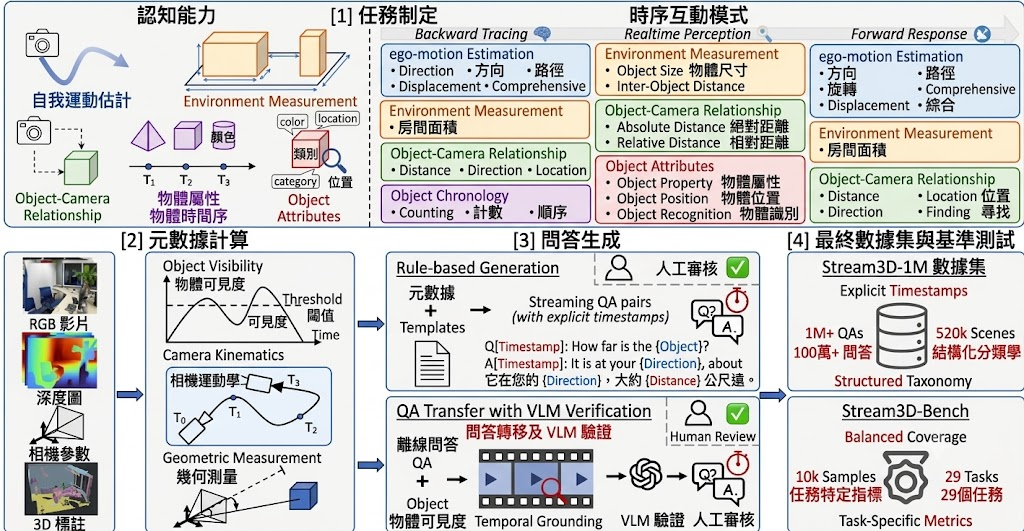
使用這個項目時,核心資源包括已公開的 Stream3D-VLM-4B 模型、Stream3D-1M Dataset,以及 Stream3D-Bench。資料方面未有直接釋出原始媒體,但有提供標註、GLB 與 RRD 等重建結果;GLB 可放入一般 3D viewer 逐步查看點雲,RRD 則可配合相機姿態與點雲記錄觀察完整重建流程。

Stream3D-VLM 加入 incremental geometry priors,令模型隨時間吸收對齊的 3D 幾何線索。項目亦提出 Visual-Spatial Feature Integration(VSFI)模組,以及 Geometry-Adaptive Voxel Compression(GAVC)模組,前者負責把幾何資訊逐步注入視覺串流,後者用 3D 結構去壓縮 visual tokens,減少長序列推理負擔。

團隊亦建立了可擴展的資料生成流程,整理超過 1M online spatio-temporal 3D QA pairs,並設計涵蓋 29 項任務的基準。項目聲稱在 online 與 offline 的 3D spatial understanding、reasoning、grounding 任務上,表現優於部分 proprietary 與 open-source models;不過文章未在這份資訊中列出完整數字,閱讀結果時仍要配合論文與實驗頁面一起看。

  • 解決痛點:傳統 3D Large Multimodal Models 多數依賴離線處理,這個項目改為面向 streaming video。
  • 主要方法:結合 autoregressive streaming control、VSFI 與 GAVC。
  • 資料與基準:提供 Stream3D-1M Dataset 標註及 Stream3D-Bench,涵蓋 29 項任務。
  • 可視化資源:支援 GLB 與 RRD,方便檢查增量重建與相機軌跡。
  • 相關模型:已公開 Stream3D-VLM-4B,可作為了解整體能力的主要入口。

整體來看,Stream3D-VLM 最適合用來觀察 3D 多模態模型如何由「看完整段再答」走向「邊看邊答」。它未必是一般開發者即裝即用的輕量工具,但對研究串流場景理解、3D 問答、空間推理流程的人,這個項目有相當清晰的方向與實驗野心。

GitHub: https://github.com/hanxunyu/Stream3D-VLM

項目: https://stream3d-vlm.github.io/

Categories: 香港科技大學, 騰訊, 模型, 視覺模型, 多模態模型, NVIDIA, Robotic

VideoKR:為影片理解補上「知識與推理」拼圖

一個專為知識密集影片理解而設的大型訓練語料庫,搭配專家標註評測集,挑戰模型真正看懂影片而非依賴文字捷徑。

overview

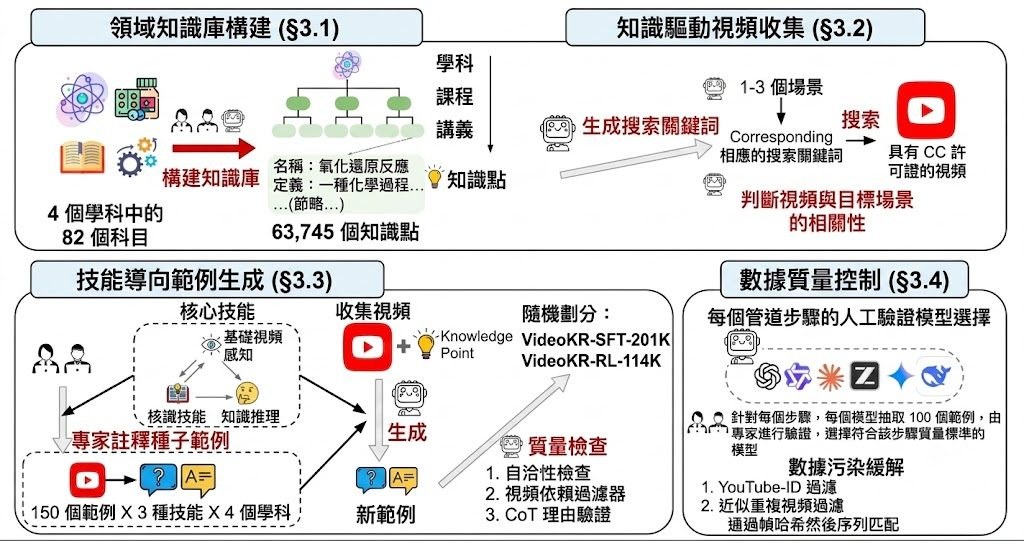
過往的影片問答模型,往往只在畫面表層打轉,碰上需要專業背景的內容就顯得吃力。VideoKR 正是針對這個缺口而設計,被稱為首個專為知識與推理密集型影片理解打造的大規模訓練語料庫,內含 31.5 萬條影片推理範例,橫跨 14.5 萬段以 CC 授權新蒐集的專業領域影片。

整個語料庫採用「人機協作、技能導向」的生成流程,刻意提升題目難度、題材多元性,以及 Chain-of-Thought(CoT)推理過程的品質。換句話說,模型不只是被餵大量影片,還要學會「怎樣一步步推論出答案」,而這個訓練流程分為監督式微調(SFT)與 GRPO 強化學習兩個階段,使用了 LLaMA-Factory 與 verl 兩個框架。

評測方面,項目同時釋出 VideoKR-Eval,由專家人工標註,要求模型真正理解影片內容,不能靠文字提示取巧。完成訓練後釋出的權重包括 VideoKR-Qwen2.5-VL-7B-SFT、VideoKR-Qwen3-VL-8B-SFT,以及對應的 GRPO 版本 VideoKR-Qwen2.5-VL-7B 與 VideoKR-Qwen3-VL-8B,涵蓋兩款主流視覺語言模型,方便不同算力門檻的研究團隊選用。

這個項目適合從事多模態研究、需要領域知識影片分析的團隊,以及關注 SFT-GRPO 訓練管線效果的工程師。對教學與科研機構而言,CC 授權的素材也可作為延伸應用的起點。

重點摘要

  • 首個大規模語料庫:31.5 萬條推理範例、14.5 萬段 CC 授權專業影片。
  • 人機協作生成流程:兼顧難度、多元性與 CoT 推理品質。
  • 專家標註評測集 VideoKR-Eval:避免模型依賴文字捷徑作答。
  • SFT 與 GRPO 雙階段訓練:使用 LLaMA-Factory 與 verl 框架。
  • 開源權重齊備:涵蓋 Qwen2.5-VL-7B 與 Qwen3-VL-8B 兩個規模。

GitHub: https://github.com/Fu-Fu-Fu-Fu/VideoKR

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練

LoomVideo:阿里巴巴 5B 模型挑戰統一影片生成

北京大學與阿里合作推出的 LoomVideo 以 5B 參數的輕量架構,解決統一影片生成成本過高的痛點,並帶來顯著的速度提升。

architecture

LoomVideo 由北京大學與阿里巴巴聯合發布,主打「統一多模態輸入的影片生成與編輯」,把文字、影片、圖片等多種輸入整合到同一個模型。傳統的統一影片模型動輒超過 13B 參數,且為了加入來源影片條件,往往要把所有 token 接在一起,導致序列長度翻倍、self-attention 成本暴增四倍。LoomVideo 的核心定位,就是用更小、更快的設計,達到同等甚至更好的效果。

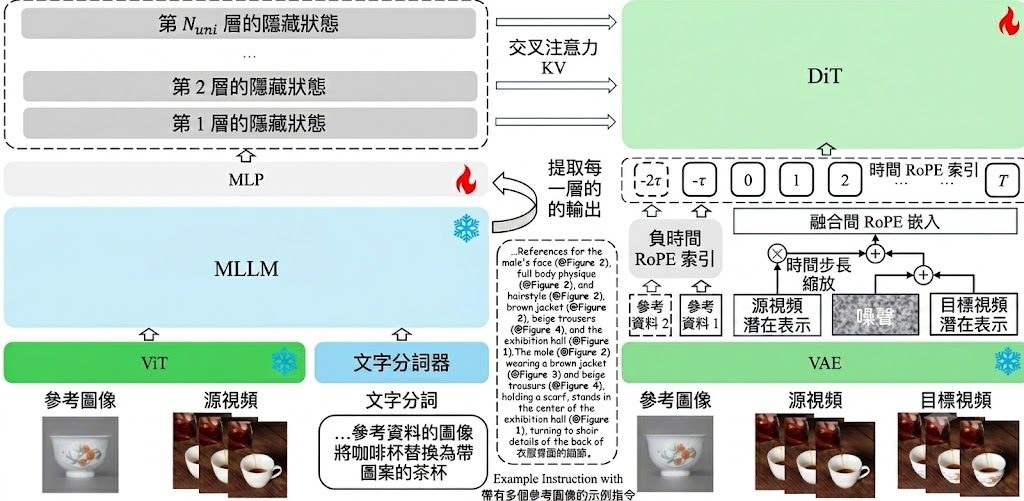
這個項目基於 MLLM(多模態大語言模型)加 DiT(Diffusion Transformer)的組合,並提出三個關鍵設計:Deepstack Injection 從 MLLM 每一層抽取特徵,再透過 cross-attention 注入對應的 DiT 層;Scale-and-Add Conditioning 把乾淨的來源影片潛在變數按時間步長縮放後直接加到雜訊目標上,免去 token 拼接的額外負擔;Negative Temporal RoPE 為參考圖片指定負的時間索引,讓多圖片條件可以無縫整合。

LoomVideo 目前支援四種任務:文生影片、純文字指令編輯、影片加圖片加文字的指令編輯,以及多張參考圖的條件生成,全部由同一個 5B 模型處理。論文報告在多項基準上取得領先或具競爭力的表現,並宣稱比同級模型快至少 5.41 倍。對於電子商務與時尚場景的影片生成,論文也展示了針對性的優勢。

這個項目適合關注影片生成效率的研究者、影像創作工具開發者,以及需要快速生成短影片內容的團隊。目前模型權重已公開在 Hugging Face 的 MSALab/LoomVideo,程式碼亦同步釋出,有興趣的讀者可以直接到 GitHub 與 Hugging Face 取得資源並測試。

重點摘要:

  • 5B 參數的統一影片生成與編輯模型,定位比 13B+ 同類更輕量。
  • 以 MLLM + DiT 架構為基礎,並提出 Deepstack Injection、Scale-and-Add Conditioning 與 Negative Temporal RoPE 三大設計。
  • 支援文生影片、文字指令編輯、影片加圖片文字編輯,以及多圖片條件生成四種任務。
  • 論文聲稱比同級模型快至少 5.41 倍,並在電商與時尚場景表現突出。
  • 模型與程式碼已公開,方便研究者與開發者快速試用與改進。

GitHub: https://github.com/MSALab-PKU/LoomVideo

項目: https://msalab-pku.github.io/projects/LoomVideo/index.html

Categories: 開源, 北京大學, 阿里巴巴, 數字人, 模型, 視覺模型, 視頻模型, 影像處理

Page 16 of 23
1 … 14 15 16 17 18 … 23