WeVisOne-VL 整合多種視覺任務

由座標定位延伸至遮罩與透明度摳圖,WeVisOne-VL 把多種視覺任務整合在一個模型,並以輕量解碼器處理像素輸出。

WeChat Vision

要在一張圖中找出物件、讀取文字,再按需要輸出座標、遮罩或透明度邊緣,WeVisOne-VL 把物件層級與像素層級工作整合為視覺語言模型(Vision-Language Model,VLM),適合標註及影像檢查流程。

模型建基於 Qwen3-VL,以 structured next-token prediction 生成定位結果:座標 token 表示點與框, token 則觸發像素解碼器。解碼器只有 9.6M 參數,重用 Vision Transformer(ViT)特徵,不需 Segment Anything Model(SAM)或外置分割骨幹,可輸出二值遮罩與連續 alpha matte。

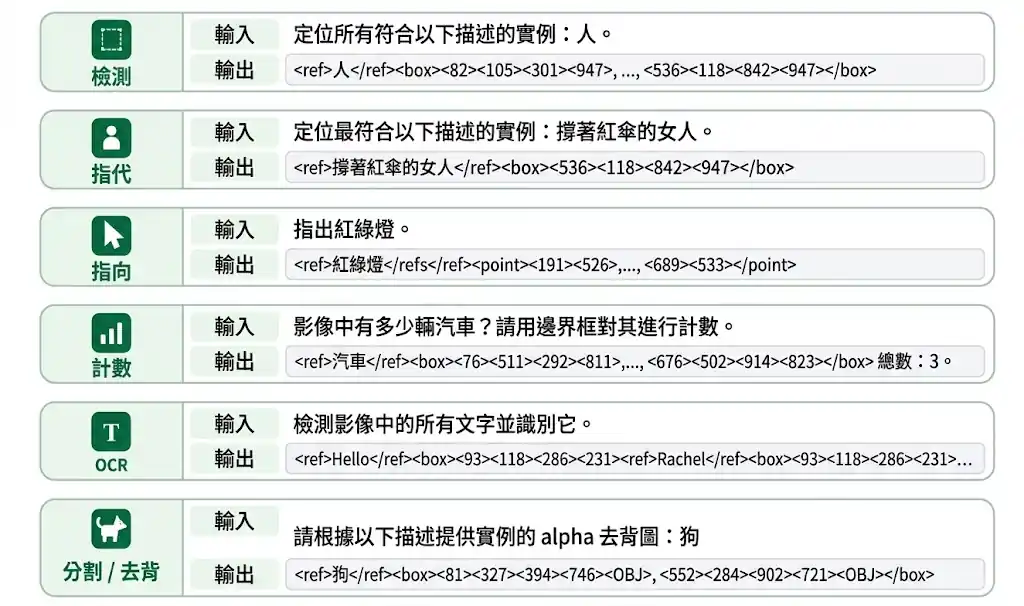
任務涵蓋物件偵測、指稱定位、計數、指點、光學字元辨識(Optical Character Recognition,OCR)、指稱分割及 promptable alpha matting;找不到指定目標時會回傳 None,減少虛構定位。需要在同一流程處理定位、分割與前景摳圖的團隊,可評估它是否適合自身資料和任務。

  • 提供 2B、4B 模型權重、推理套件、Cookbooks、Gradio 示範及評測流程。
  • 微調程式碼尚未提供;資料亦未列出硬件需求或逐步安裝方式。
  • 項目在 30 多項基準測試領先。

項目主頁 · GitHub

Categories: 開源, 騰訊, 模型, 視覺模型, 多模態模型, Qwen, 微軟, Image, Medical醫學

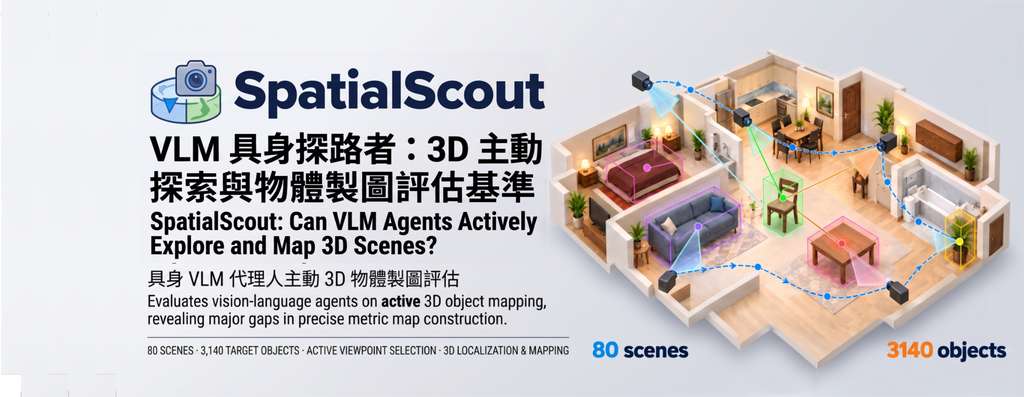
SpatialScout 揭示 3D 定位落差,讓視覺語言模型探索室內空間

視覺語言模型要邊探索室內場景、邊把物件放進共通的 3D 座標,仍難兼顧完整度與精準度。SpatialScout 以 80 個場景測試這種主動建圖能力。

SpatialScout overview

要讓視覺語言模型看過不同角度後,找出物件在房間中的位置,單靠辨認影像並不足夠:模型還要選擇鏡頭視點、累積視覺證據,再把多個畫面中的物件對應起來。SpatialScout 是測試視覺語言模型(Vision-Language Model,VLM)代理主動探索與物件級 3D 建圖能力的基準項目,涵蓋 80 個室內場景及 3,140 個目標物件。

每項任務提供物件清單、RGB 觀察畫面,以及相機校準資料和位置資訊;代理要控制相機,在有限互動回合內探索場景,並估算物件在共通 3D 座標系中的中心位置。這讓測試不只檢查模型能否辨認物件,也衡量它會否選擇有用視點、跨畫面追蹤物件,以及逐步修正位置。

結果反映出由大概布局走向精確地圖仍有明顯距離:表現最佳的受測模型平均 IoU 為 41.71%,只有 3.25%的目標物件達到 IoU 0.9 以上。項目亦提供涵蓋所有物件及已提交物件的八項 IoU 指標,並以成功完成 finish_mapping 的軌跡計算任務平均分;這有助分辨模型是定位不準,還是漏掉了物件。

  • 基準涵蓋 80 個室內場景及 3,140 個目標物件。
  • 每項任務最多 100 回合,模型需主動選擇觀察視點。
  • 評分同時考慮定位準確度與物件完整度。
  • 最佳受測模型平均 IoU 為 41.71%,高精度定位仍有限。

研究團隊可用自己的模型 API 執行全部任務,預設採用 Responses API 模式,亦可切換至 Chat Completions、Anthropic 或 Gemini 端點。項目要求 Linux x86_64 和 Python 3.10,安裝程序會設定 CPU 渲染並透過 apt/sudo 安裝系統套件;場景資源則需另行下載及掛載。它適合研究主動感知、機械人空間理解或多模態代理的團隊作比較測試,但目前提供的是評估基準,不是可直接取代建圖系統的模型。

項目主頁 · GitHub · 數據集

Categories: 開源, 模型, 視覺模型, 多模態模型, Gemini, API, Image, 3D, Linux, Python, Anthropic, Dataset 數據集

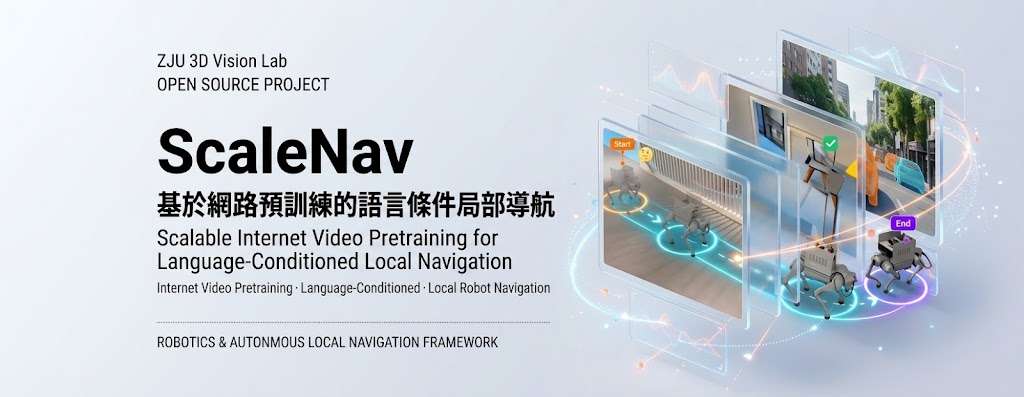
ScaleNav 把影片變成導航能力

ScaleNav 先從互聯網第一視角影片學習路徑規律,再轉成機器人動作,面對語言指定目標的局部導航。

ScaleNav navigation: real robot on the left, simulation on the right

網上第一視角影片 seldom 附帶機器人動作,但當中蘊藏大量「沿走廊前進、避開障礙、轉入目標房間」的視覺規律。ScaleNav 是一個研究型導航模型,試圖把這些 action-free 預訓練所得到的 navigation priors,轉移到有動作標籤的模擬軌跡,再用於 language-conditioned local navigation:按文字尋找初始畫面可見的目標並停下來。

模型屬共享式 Diffusion Transformer,會根據指令、目前 RGB 影像及記憶,共同預測未來 video latents 和 action chunks。流程分三階段:先從互聯網第一視角影片學習目標導向視覺動態,再進行 action alignment,最後 joint fine-tuning,同時保留影片回放並微調共享骨干與輸出頭。

ScaleNav 與同類做法的主要取捨,是毋須先收集大量完整機器人示範,便能借助互聯網影片建立導航先驗;代價是仍要依賴模擬軌跡、動作對齊及多階段訓練。官方模型約 10.02 GB,推論及評估建議使用支援 BF16 的 NVIDIA GPU、24 GB GPU 記憶體與 64 GB 系統記憶體,並按文件配置 Linux、Habitat-GS 和場景轉換工具。

結果涵蓋 HabitatGS-LN、Short-Horizon OVON 與真實四足機械人;公開資料列出 ScaleNav 在兩項模擬評估的成功率分別為 94.9% 及 86.5%,真實機械人則在 60 次試驗中錄得 83.3% 成功率。團隊亦整理 gallery 導航影片、軌跡、目標與結果,以及 summary.json 內的 SR、SPL 和逐任務成績,方便比較與重現。

  • 影片預訓練不必附帶逐格動作標籤
  • 同一模型處理影片動態與動作生成
  • 支援模擬環境及真實四足機械人
  • 提供模型、資料、評估結果與操作文件

這套方法較適合研究 embodied navigation、 robotics 與 VLA(Vision-Language-Action)的團隊;評估數字雖亮眼,仍須留意各方法採用不同設定,跨模型比較應同時核對 episode 數、場景及 fine-tuning 條件。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, NVIDIA, Video, Image, VLA, Robotic, 工具, Linux

RAP-25K 用 AI 把論文自動排版成為海報

清華、港大、美團等團隊把 25,435 對 NeurIPS、ICLR、ICML 論文與海報反解為可填空嘅 HTML 模板,等 AI 唔再從零設計版面,而係取用人類做過嘅版型再改內容。

做會議海報本質係一次迷你視覺代碼:一篇論文要做成 Poster,要同時處理摘要、視覺排版同程式實現。RAP 將呢件事變成可量度嘅任務,開放俾模型訓練同評測。

佢屬於一個資料集加框架嘅組合:核心係 PosterReverse-25K,由 NeurIPS、ICLR、ICML(2022–2026)合共 25,435 套論文同海報組成,每份海報會被自動 pipeline 反解成帶類型、可填空嘅 HTML/CSS,連摘要同三層分類(領域/任務/方法)都一齊整理好。配套仲有一份 RAP-150 測試集,每個領域留 10 篇俾公平比較。

同類做法多數只標註版面框或者小量樣本,要靠 VLM 或人手評分。RAP 嘅差別係每個樣本都可以渲染同原海報直接對比,做到客觀驗證,唔再靠主觀評審。佢提供兩條路線:PosterRAG 係免訓練嘅多智能體流程,會先檢索真實模板再填入新內容;另一條就用同一批 triplet 對 Qwen3.8-27B 做全參數 SFT 加 GRPO 訓練。

對研究人員同會議籌備團隊最直接:寫完一篇論文想快速整海報,可以利用檢索模板避開從零排版;做視覺代碼、版面生成或 VLM 訓練嘅團隊,都能直接用呢批已驗證 triplet 做監督。項目提供 Hugging Face Space demo 同模型權重。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, 框架, Dataset 數據集

[技術文章] 阿里 CommerceGen-Studio:商用級主圖生成端到端框架

把白底 SKU 商品照變成可上架主圖,並以幾秒延遲處理每日百萬級流量。

Hugging Face

白底商品照難以直接吸引搜尋頁點擊,CommerceGen-Studio 由 Alibaba Group 提出,面向電商 SKU 粒度的商業主圖生成。來源沒有交代具體 base model 或 fine-tuned from 哪個模型,因此無法確認其原始基礎模型。

系統分成資訊抽取、語義改寫及多條件生成三階段。Prompt-Eval-Refine-Loop Agent(PERL-Agent)讓 VLM 與 LLM 按照 reference-free rubric 反覆整理商品資料;Layout Thinker Optimization(LTO)則同時以文字描述及渲染圖片質素調整改寫策略。

SKU-DiT 透過 Reinforce-Distill-Reinforce(RDR)漸進式訓練,聯合使用白底商品圖、商標裁剪圖及結構化版面條件,兼顧商品外觀、商標完整性和字元級文字準確度。系統聲稱已達到每日生成數百萬張主圖、每張延遲數秒,並在 CommerceGen-Bench 的兩條編輯測試中勝過所比較的開源基線,部分指標可媲美或超越大型閉源模型。

  • 檔案與推論:來源是研究論文內容,沒有提供 GGUF 檔名、檔案大小、量化級別、mmproj 或 chat template。
  • 框架支援:論文摘要沒有公開各項數值分數,也未交代 SKU-DiT 的參數規模及訓練資料細節。
  • 適用場景:重點在大量電商商品主圖生產,而非通用文字轉圖片服務。

CommerceGen-Studio 與單一生成模型的差異,在於把商品資料理解、賣點整理、版面規劃及圖片生成串成完整項目流程;CommerceGen-Bench 則以真實流量中的困難案例測試 Instruction Following 和 Product Integration。由於缺乏公開權重、量化檔案及硬體規格,讀者目前較適合把它視為可大規模運行的研究框架,而非可直接下載的本地模型。

Paper

Categories: 開源, 阿里巴巴, Agentic, 模型, 視覺模型, 模型訓練, Image, 影像模型, VLA, 框架, LLaMa, Ollama, Dataset 數據集

3dcodeverse 讓 AI 以程式碼建立可驗證 3D 世界

3DCodeVerse 將可執行程式、空間檢查與視覺評審接成工作流,讓 AI 產生的 3D 內容不止能看,亦能修改和驗證。

3DCodeVerse

由幾百行 Blender Python、Three.js 或 GLSL 生成互動場景,內容仍可編輯和檢查,正是 3DCodeVerse 的實用定位。它屬於面向 coding agents 的 3D 研究生態系,處理文字要求轉化為可執行 3D 程式的問題,而不是只輸出一張渲染圖。

核心資料集 3DCodeVerse-2M 收錄約 2.03M 個 code-condition pairs,來自 269,597 個可執行程式,涵蓋 bpy、CadQuery、OpenSCAD、Three.js、URDF、GLSL、OpenGL 七種語言或 runtime,並分為物件、可動物件、場景及圖形渲染四條軌道。每個項目附有程式、所需資產、指令描述、視覺描述、建構步驟和驗證記錄,較適合訓練及測試,而非只作展示素材。

3DCodeVerse Harness 以多智能體和 DAG 結構規劃 3D 項目,再交由空間工具、MCP 服務及確定性檢查驗證連接、介面合約、關節掃描和畫面指標;VLM 評審則用二元缺陷清單及程式上限評分。讀者可先在項目網站瀏覽器執行示例,再從 Hugging Face 取得資料集;自行運行則要準備相應的 Blender、Three.js、OpenGL 等 runtime,不能只靠單一推理套件完成。

開放模型部分提供 Qwen 的 LoRA、DPO 微調配方,並列出 27B 模型在 3DCodeBench 的執行率由 51.9% 提升至 92.9%;項目亦列出相對同一 Claude Opus 5.5 backbone 的 90% 人類偏好結果。這些數字反映訓練資料和驗證流程的價值,但仍應留意評測設定、成本及不同 runtime 對結果的影響。

  • 可生成可修改的程式化 3D 物件、場景和渲染效果
  • 以 DAG Harness 串連規劃、執行、空間檢查和視覺評審
  • 2.03M code-condition pairs 支援模型訓練與基準測試
  • Qwen 微調配方兼顧執行成功率和偏好評審

對研究 3D 生成、coding agents、程式化建模或模型微調的團隊,這個項目提供由資料集、工具鏈到模型配方的完整起點。限制在於工作流程依賴多個 3D runtime,評審仍可能受視覺品質和規則覆蓋範圍影響。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 視覺模型, 模型訓練, Qwen, Google, 工具, 3D, Python, 編程, 安全, Anthropic, Dataset 數據集, LoRA

Urbex 讓城市級 3D 定位改用主動搜尋

Urbex 讓視覺語言代理在城市級 3D 場景自行搜尋證據,毋須預先建立物件候選框,定位能力與效率取捨更值得檢視。

Urbex logo

面對城市級 3D 場景,逐一比較預先產生的物件候選框容易拖慢搜尋,也會受候選品質限制。Urbex 屬於開源的 Agentic 視覺模型項目,將 3D grounding 改成主動空間搜尋,讓 vision-language agent 按需要查詢地標、縮放區域、切換斜視角,再提交目標 bounding box。

它不是只靠一次影像判斷,而是在互動式 multi-view environment 逐步收集證據。Reinforcement learning 同時訓練定位和搜尋決策,模型會學習應該檢查哪裏、何時縮窄範圍,以及幾時足以作答;這免除對 precomputed instance proposals 和 ground-truth boxes 的依賴,但每次搜尋仍要承受多步操作成本。

CityRefer 測試中,Urbex 的 ND Hit@1、Hit@3、Hit@5 為 25.8、39.2、42.3,NO 對應為 23.9、36.9、40.7,搜尋時間約 3.2 秒。相較 CityAnchor 的 32.1 秒,速度明顯較快;模型亦在 STPLS3D-Refer 取得 zero-shot 結果,反映跨場景泛化潛力,但不能直接等同於所有城市環境都同樣穩定。

• 支援 CityRefer 訓練及單查詢互動式 3D 推理
• 提供 Hugging Face 的 Urbex-4B 模型和 Urbex-Data 數據集
• 可透過 Colab notebook 試用預測視圖
• 安裝需要 Linux、Python 3.11、CUDA 12.8 及 C++ 編譯器

研究城市建模、3D 視覺定位或多模態代理的團隊,較適合用它測試 candidate-free grounding;想快速驗證概念的人則可先用 Colab。完整訓練需要 CUDA 12.8、Megatron Core、Transformer Engine 和 FlashAttention,硬件及環境門檻明顯高於單純推理,因此本地部署前應先確認 GPU、編譯工具和數據下載流程。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Image, 工具, 3D, Linux, Python, Dataset 數據集, 強化學習

CineRecon 以 Blender 重建實景影片

CineRecon 將影片重建變成可檢驗的 Agent 任務,要求模型由參考影片建立可編輯、可動畫化的 Blender 場景。

CineRecon logo

由完整參考影片出發,Coding Agent 透過 Blender MCP 撰寫及修改 Python,反覆比對渲染畫面,再建立包含幾何、材質、角色動作與鏡頭動畫的可編輯場景。CineRecon 屬於影片重建 benchmark,處理的是模型能否將時間連續的影像內容還原成可修改的 3D 工作成果,而不只是產生相似畫面。

項目以三個重建層級拆開能力差異:Proxy 只要求位置、互動及鏡頭運動,Simplified 再保留可辨認形狀和主要外觀,Detailed 則加入特色形狀、材質和細節。三個層級都要求相同的主體動作、事件及攝影機行為,方便分辨模型是只掌握構圖,還是能重建完整視覺內容。

  • 50 段參考影片,切分成 360 個評估片段
  • 35,836 筆獨立 checklist 記錄,按層級擴展至 49,668 項檢查
  • 評估 Camera、Static、Dynamic 三類一致性
  • 支援畫面選取、時間戳對齊、並行評分、續跑及分數彙總

評分由獨立 VLM judge 對齊參考與渲染影片,按片段 checklist 檢查 11 個類別,並以 Camera、Static、Dynamic 三個同等權重維度計算結果。這比單一影像相似度更能揭示鏡頭是否跟足、物件是否保持穩定,以及動作和事件有沒有在正確時間發生。

測試需要 Python 3.10 或以上,支援 Linux 及 macOS;項目提供資料、提示詞、驗證工具和離線 smoke test,但不包含 Agent launchers。團隊可先用離線流程確認資料與評分管線,再接駁 Blender MCP 和隔離 worker 執行重建;研究模型能力時,CineRecon 的價值在於把「看似相似」拆成可追蹤的鏡頭、靜態內容和動態內容,而不是只比較最後一段影片。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, MCP, 模型, 視覺模型, Video, Image, 提示詞, Vibe Coding, 工具, Mac, 3D, Linux, Python, 編程, Anthropic, 動畫, Dataset 數據集

GroundAnything 以並行解碼提升視覺定位速度

GroundAnything 把多種視覺定位任務放進 4B 模型,嘗試同時處理精準座標與推理速度的取捨。

GroundAnything

要在圖片中找出物件、位置和空間關係,GroundAnything 可一次處理多類 visual grounding 任務,減少逐個輸出座標帶來的延遲。它屬於 4B 級視覺基礎模型,實際處理的是影像內容與文字查詢之間的精準定位問題,適合影像標註、視覺搜尋及多模態分析工作流。

模型以 GroundAnything 的 diffusion decoding 配合 parallel decoding,讓空間假設可以並行生成;GroundAnything-VLM 則是獨立的 autoregressive checkpoint。前者針對序列生成的速度限制,後者保留自回歸模型路線,兩者均使用 GAM evaluation mode,並非同一模型的不同介面。

項目透過 grounding pretraining、AR-to-diffusion conversion、joint objectives、supervised fine-tuning 和 GRPO-based reinforcement learning 建立模型。30 個基準測試中,GroundAnything 勝過同級自回歸模型的整體最佳結果,亦超越較大的 Qwen3.7-Max;GroundAnything-VLM 在同級別取得新的整體最佳結果,並與 GPT-6 Astra 保持競爭力。

適合需要精準視覺定位、又要控制推理延遲的研究團隊和影像處理項目,硬件需求、實際吞吐量及不同圖片任務的穩定性仍需自行驗證。

  • 速度取捨:以 diffusion decoding 和並行輸出減少空間預測的序列等待。
  • 模型關係:GroundAnything 是 diffusion 路線,GroundAnything-VLM 是獨立 autoregressive checkpoint。
  • 評估範圍:涵蓋 30 個 benchmarks,並比較 MTP-based generation 與多階段基礎設施優化。
  • 適用場景:影像定位、批次標註、視覺搜尋及需要座標輸出的多模態工作流。

項目主頁 · GitHub

Categories: 開源, 香港大學, 香港科技大學, 北京大學, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, Image, 影像處理, 香港, 強化學習

GroundingPI 以 4B 視覺基礎模型連接感知與機械控制

GroundingPI 把視覺定位轉成可供機械系統使用的點和框,主打複雜場景下的精準感知與控制效率。

GroundingPI

要讓自動駕駛或機械人準確知道「要處理哪件物件、位置在哪裏」,單靠一般視覺語言模型仍可能在雜亂畫面和細小物件上失準。GroundingPI 屬於視覺 grounding foundation model,以 4B 參數模型處理定位問題,輸出可供後續控制使用的視覺結構。

模型以 visual primitives 為核心,將點和框表示成 shared vocabulary 中的 quantized coordinates,再配合 vision-language model、tokenizer、processor 和 custom model code。這種做法針對 VLA(vision-language-action)及 WAM(world-action models)常見的感知瓶頸,並讓 perceptual foundation 可以轉移到 autonomous driving 和 robotic manipulation。

  • 定位方式:同時支援點與框,適合指定目標及描述空間位置。
  • 模型規模:4B 參數,目標是在能力與運算成本之間取得平衡。
  • 評測結果:涵蓋 34 個 grounding benchmarks、11 種感知能力,對比 44 個基準模型平均達 73.68%,高於 GPT-6 Astra 的 71.54%。
  • 轉移價值:在 ID 和 OOD 評估,以及 action-data efficiency 方面,展示對自動駕駛和機械人操作的幫助。

對研究團隊而言,GroundingPI 不只是單次定位模型,亦可作為 System-1 foundation-model 的感知層,補足未必擅長精準 grounding 的通用視覺模型。項目提供 Hugging Face 模型及 Demo,並列出 vLLM、Transformers backend、OpenAI-compatible API 和 JSONL batch annotation 工作流;不過提供的儲存庫資料未交代完整硬件需求,部署前仍需按文件確認環境。

研究重點同時放在 pretraining scale 和 data composition 如何影響 grounding 及轉移效果。需要即時視覺定位、閉環控制或希望減少 action data 的自動駕駛、機械人及 embodied AI 團隊,會較容易從這個模型的感知能力受益;純文字或一般影像分類工作則未必能直接發揮其價值。
項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 香港科技大學, 北京大學, 清華大學, 模型, 視覺模型, 多模態模型, 模型訓練, API, Image, VLA, World-Action Model, Robotic, 香港, 庫, Tokenize

Page 1 of 23
1 2 3 … 23