Qwen3-VL-Embedding-2B

「Qwen3-VL-Embedding-2B」是 Qwen 家族中最新的多模態信息檢索和交叉模態理解模型。可在同一向量空間做相似度計算,方便做「跨模態檢索」與「圖文混合檢索」。 Embedding 維度可控:預設最高 2048 維,但支援使用者自訂輸出維度 64–2048,可依儲存成本與下游模型需求調整(例如 256/512 維用於向量 DB)。 模型規模與 context length:2B 參數,context 長度 32k,適合放在邊緣或低資源伺服器上,同時能處理長文檔、多 frame 影片描述等輸入。

「Qwen3-VL-Embedding-2B」是 Qwen 家族中最新的多模態信息檢索和交叉模態理解模型。可在同一向量空間做相似度計算,方便做「跨模態檢索」與「圖文混合檢索」。

Embedding 維度可控:預設最高 2048 維,但支援使用者自訂輸出維度 64–2048,可依儲存成本與下游模型需求調整(例如 256/512 維用於向量 DB)。

模型規模與 context length:2B 參數,context 長度 32k,適合放在邊緣或低資源伺服器上,同時能處理長文檔、多 frame 影片描述等輸入。

模型Gemini Multimodal EmbeddingsQwen3-VL-Embedding (2B/8B)
模態支援文字、圖片、video(含 audio 軌道,1 FPS + 音頻特徵)文字、圖片、截圖、video(多 frame),混合任意組合
語言多語(英文主導)30+ 語言,強中文/多語對齊
維度固定 1408可自訂 64–4096(預設 2048)
ContextVideo 上限 1-3 小時32K tokens(長影片多 frame)
開源否(API)是(HF/GitHub,Apache 2.0)
成本$0.0001/1000 chars(text),更高 video/image免費本地,GPU 硬體成本
整合Vertex AI / Gemini API,易 scaleTransformers/vLLM,量化友好
  • 1. 圖像和文本檢索系統:可以用於基於文本描述搜索相關圖像,或者基於圖像內容搜索相關文本描述。
  • 2. 視頻推薦平台:將視頻和文本描述映射到共享表示空間,以提高視頻推薦的準確性。
  • 3. 多模態內容管理:對於包含圖像、文本和視頻的大型數據集,可以進行有效的內容聚類和組織。
  • 4. 社交媒體分析:分析和理解跨文本和圖像的用戶生成內容。
  • 5. 教育和培訓:藉助於視覺問答和多模態學習材料,提供個性化的學習體驗。
Categories: 開源, 阿里巴巴, Embedding, 視覺模型, 多模態模型, Qwen

PlenopticDreamer – NVidia 解決影片一致性

PlenopticDreamer 主要解決「鏡頭控制生成影片」的不一致問題。這是一個能讓 AI「像無人機一樣繞著物體飛」生成影片的技術。它可以應用在自駕車的模擬環境、機器人的視覺訓練,以及好萊塢等級的虛擬拍攝。 1.  Robotics(機器人):     *   情境模擬: 機器人需要理解物體在不同角度下的樣貌。這個技術可以根據單一攝影機的畫面,生成該物體在其他視角的影像,幫助機器人進行視覺導航或物體抓取的訓練。     *   模擬數據生成: 為機器視覺系統生成更多樣化的訓練數據。 2.  Self-Driving(自駕車):     *   場景理解: 自駕車通常有多個鏡頭。這個技術可以補足盲區,或者將一個鏡頭的畫面轉換成其他鏡頭的視角,幫助車輛更全面地感知周圍環境。     *   未來幀預測: 預測道路上物體在下一秒鐘會出現在哪個位置(從不同角度)。 3.  影視製作與 AR/VR:     *   新視角補全: 如果拍攝時漏掉了某個角度,可以利用這個技術「憑空生成」該角度的連續影片。     *   重定向(Re-direction): 可以將拍好的影片,根據新的鏡頭軌跡重新渲染(Re-rendering),讓同一段故事可以從不同角度重新看一遍。

PlenopticDreamer 主要解決「鏡頭控制生成影片」的不一致問題。這是一個能讓 AI「像無人機一樣繞著物體飛」生成影片的技術。它可以應用在自駕車的模擬環境、機器人的視覺訓練,以及好萊塢等級的虛擬拍攝。

1.  Robotics(機器人):

    *   情境模擬: 機器人需要理解物體在不同角度下的樣貌。這個技術可以根據單一攝影機的畫面,生成該物體在其他視角的影像,幫助機器人進行視覺導航或物體抓取的訓練。

    *   模擬數據生成: 為機器視覺系統生成更多樣化的訓練數據。

2.  Self-Driving(自駕車):

    *   場景理解: 自駕車通常有多個鏡頭。這個技術可以補足盲區,或者將一個鏡頭的畫面轉換成其他鏡頭的視角,幫助車輛更全面地感知周圍環境。

    *   未來幀預測: 預測道路上物體在下一秒鐘會出現在哪個位置(從不同角度)。

3.  影視製作與 AR/VR:

    *   新視角補全: 如果拍攝時漏掉了某個角度,可以利用這個技術「憑空生成」該角度的連續影片。

    *   重定向(Re-direction): 可以將拍好的影片,根據新的鏡頭軌跡重新渲染(Re-rendering),讓同一段故事可以從不同角度重新看一遍。

Categories: 開源, 香港中文大學, 視覺模型, 視頻模型, NVIDIA, 影像模型, 影像處理

SpaceTimePilot 時間軸控制影片生成模型

SpaceTimePilot 是一個把「攝影機運鏡」和「時間軸控制」徹底拆開來玩的視覺生成模型,從一支普通的單眼影片出發,就能同時改變鏡頭路徑和動作節奏,做出 bullet-time、慢動作、倒帶、甚至空間與時間交錯前進這種高自由度效果。 過去的 Camera-control V2V 模型(例如 ReCamMaster、Generative Camera Dolly)只能改鏡頭、不能動時間;4D 多視角模型(如 Cat4D、Diffusion4D)雖支援時空條件,但通常只給離散片段,沒辦法連續、細緻地玩時間線。 SpaceTimePilot 最大的賣點,就是讓「鏡頭怎麼走」和「畫面播到第幾秒」變成兩條獨立的控制軌,創作者可以像在 3D 時空中開飛機一樣,自由規劃路線。​ 為了做到這件事,作者先在 diffusion 裡加了一個專門描述「動畫時間」的 time-embedding 機制,讓模型能精確理解「現在這一幀應該是原影片第幾秒、第幾個動作狀態」;接著用 temporal warping 資料增強,把既有多視角資料集重新時間扭曲,模擬快轉、倒帶、停格等不同節奏,強迫模型學會把「場景動作」和「攝影機移動」拆開學。 他們還自建了一個 Cam×Time 合成資料集,對同一個場景做出「攝影機 × 時間」的全格點渲染,總共 10 萬級場景時間組合,給模型完整的時空監督,讓 bullet-time 這種超細膩的時間控制可以穩定、不抖動地跑出來。 在推理端,SpaceTimePilot 透過自回歸(autoregressive)推進,把一段段 81 幀的生成片段接起來,不但能長時間探索,也能在多輪生成中維持鏡頭、時間與內容的一致性,對影視特效、互動體驗、AR/VR 內容創作來說,是非常實用的一條未來工作流路線。(劍橋 與 Adobe 聯合開發)

SpaceTimePilot 是一個把「攝影機運鏡」和「時間軸控制」徹底拆開來玩的視覺生成模型,從一支普通的單眼影片出發,就能同時改變鏡頭路徑和動作節奏,做出 bullet-time、慢動作、倒帶、甚至空間與時間交錯前進這種高自由度效果。 過去的 Camera-control V2V 模型(例如 ReCamMaster、Generative Camera Dolly)只能改鏡頭、不能動時間;4D 多視角模型(如 Cat4D、Diffusion4D)雖支援時空條件,但通常只給離散片段,沒辦法連續、細緻地玩時間線。 SpaceTimePilot 最大的賣點,就是讓「鏡頭怎麼走」和「畫面播到第幾秒」變成兩條獨立的控制軌,創作者可以像在 3D 時空中開飛機一樣,自由規劃路線。

為了做到這件事,作者先在 diffusion 裡加了一個專門描述「動畫時間」的 time-embedding 機制,讓模型能精確理解「現在這一幀應該是原影片第幾秒、第幾個動作狀態」;接著用 temporal warping 資料增強,把既有多視角資料集重新時間扭曲,模擬快轉、倒帶、停格等不同節奏,強迫模型學會把「場景動作」和「攝影機移動」拆開學。 他們還自建了一個 Cam×Time 合成資料集,對同一個場景做出「攝影機 × 時間」的全格點渲染,總共 10 萬級場景時間組合,給模型完整的時空監督,讓 bullet-time 這種超細膩的時間控制可以穩定、不抖動地跑出來。 在推理端,SpaceTimePilot 透過自回歸(autoregressive)推進,把一段段 81 幀的生成片段接起來,不但能長時間探索,也能在多輪生成中維持鏡頭、時間與內容的一致性,對影視特效、互動體驗、AR/VR 內容創作來說,是非常實用的一條未來工作流路線。(劍橋 與 Adobe 聯合開發)

Categories: 視覺模型, 視頻模型, 影像模型, 影像處理

GaMO 稀疏視角 3D 重建

GaMO:Geometry-aware Multi-view Diffusion Outpainting for Sparse-View 3D Reconstruction,是一套專門為「稀疏視角 3D 重建」設計的全新框架,主打關鍵字就是:幾何感知、多視角、Diffusion 外擴(outpainting)、零訓練、超省時間。傳統方法通常會在新相機位上生成人工視角,來補足原始影像的不足,但這樣很容易在多視角之間出現幾何不一致、邊界破碎、甚至幽靈般的重影,同時計算成本也相當驚人。 GaMO 反其道而行,直接「從原本的相機視角往外長」,也就是針對每張輸入影像做視野擴張,保留原始內容不動,只在周邊補齊缺失區域,天然就比較容易維持幾何一致性。​ 技術上,GaMO 利用多視圖條件化的 diffusion 模型,再配合幾何感知去噪策略,先透過粗略 3D 重建拿到幾何先驗,再在影像層面做多視圖 outpainting,最後用這些擴張後的影像做精緻 3D 重建。 這樣的設計有幾個亮點:第一,完全不需要針對特定場景再訓練(zero-shot inference),直接使用現成的多視圖 diffusion 模型即可;第二,在 Replica、ScanNet++ 等資料集上,GaMO 在 PSNR、SSIM、LPIPS 等指標上刷新了現有 SOTA,同時比其它 diffusion 式方法快上約 25 倍,整個流程控制在 10 分鐘內完成。 對需要做室內掃描、VR/AR 場景建模、機器人導航環境重建的團隊來說,GaMO 提供了一種更務實、計算友善,又兼顧幾何品質的新選項。

GaMO:Geometry-aware Multi-view Diffusion Outpainting for Sparse-View 3D Reconstruction,是一套專門為「稀疏視角 3D 重建」設計的全新框架,主打關鍵字就是:幾何感知、多視角、Diffusion 外擴(outpainting)、零訓練、超省時間。傳統方法通常會在新相機位上生成人工視角,來補足原始影像的不足,但這樣很容易在多視角之間出現幾何不一致、邊界破碎、甚至幽靈般的重影,同時計算成本也相當驚人。 GaMO 反其道而行,直接「從原本的相機視角往外長」,也就是針對每張輸入影像做視野擴張,保留原始內容不動,只在周邊補齊缺失區域,天然就比較容易維持幾何一致性。

技術上,GaMO 利用多視圖條件化的 diffusion 模型,再配合幾何感知去噪策略,先透過粗略 3D 重建拿到幾何先驗,再在影像層面做多視圖 outpainting,最後用這些擴張後的影像做精緻 3D 重建。 這樣的設計有幾個亮點:第一,完全不需要針對特定場景再訓練(zero-shot inference),直接使用現成的多視圖 diffusion 模型即可;第二,在 Replica、ScanNet++ 等資料集上,GaMO 在 PSNR、SSIM、LPIPS 等指標上刷新了現有 SOTA,同時比其它 diffusion 式方法快上約 25 倍,整個流程控制在 10 分鐘內完成。 對需要做室內掃描、VR/AR 場景建模、機器人導航環境重建的團隊來說,GaMO 提供了一種更務實、計算友善,又兼顧幾何品質的新選項。

Categories: 開源, 視覺模型, 影像模型, 影像處理

InfCam 攝影機 outpaint 控制

InfCam,一個無需深度資訊、攝影機控制的視訊生成框架,能夠實現高姿態保真度。該框架整合了兩個關鍵組件: 架構包含同次引導自注意力層(homography-guided self-attention),輸入源視頻、目標及變換潛在表示與相機嵌入,確保時間對齊與旋轉感知推理。 變換模塊處理旋轉後添加平移嵌入,將重投影簡化為相對於無限遠平面的視差估計,提升軌跡忠實度。 透過增強 MultiCamVideo 數據集生成 AugMCV,引入多樣初始姿態與焦距軌跡,解決現有 SynCamVideo 等數據集偏差。 實驗結果表明,在 AugMCV 與 WebVid 數據集上,InfCam 在相同/不同內參情境下,於姿態準確度與視覺保真度皆優於基準,尤其在真實世界數據泛化表現突出。

InfCam,一個無需深度資訊、攝影機控制的視訊生成框架,能夠實現高姿態保真度。該框架整合了兩個關鍵組件:

架構包含同次引導自注意力層(homography-guided self-attention),輸入源視頻、目標及變換潛在表示與相機嵌入,確保時間對齊與旋轉感知推理。 變換模塊處理旋轉後添加平移嵌入,將重投影簡化為相對於無限遠平面的視差估計,提升軌跡忠實度。

透過增強 MultiCamVideo 數據集生成 AugMCV,引入多樣初始姿態與焦距軌跡,解決現有 SynCamVideo 等數據集偏差。

實驗結果表明,在 AugMCV 與 WebVid 數據集上,InfCam 在相同/不同內參情境下,於姿態準確度與視覺保真度皆優於基準,尤其在真實世界數據泛化表現突出。

Categories: 開源, 視覺模型, 視頻模型, 影像模型, 影像處理

MiniCPM-V 4.5 視覺與語言結合

MiniCPM-V 的核心亮點在於其驚人的效率與效能平衡。儘管模型尺寸輕巧,例如 MiniCPM-V 2.0 僅有 2.4B 參數,而更新的 MiniCPM-V 2.4 則為 2.8B 參數,它們卻能展現出足以媲美甚至超越許多大型模型的實力,例如 LLaVA-1.5 7B/13B 或 Qwen-VL。這種「小而強大」的特性,使得 MiniCPM-V 在部署上更具彈性,降低了運算資源的需求,為更廣泛的應用場景開啟了大門。 MiniCPM-V 系列在多項關鍵能力上表現出色,尤其在 OCR(光學字元辨識)、物體偵測與視覺推理方面。它不僅能夠精準地從複雜圖像中提取文字資訊,還能有效地識別圖像中的物件,並進一步進行高層次的語義理解與推理。例如,MiniCPM-V 2.0 支援高達 640×640 像素的圖像解析度,而 MiniCPM-V 2.4 更將其提升至 768×768 像素,確保了在細節處理上的卓越表現。這意味著無論是文件處理、街景分析,還是需要深度圖像理解的應用,MiniCPM-V 都能提供可靠的解決方案。此外,該模型還支援多語言能力,進一步擴展了其全球應用的潛力。

MiniCPM-V 的核心亮點在於其驚人的效率與效能平衡。儘管模型尺寸輕巧,例如 MiniCPM-V 2.0 僅有 2.4B 參數,而更新的 MiniCPM-V 2.4 則為 2.8B 參數,它們卻能展現出足以媲美甚至超越許多大型模型的實力,例如 LLaVA-1.5 7B/13B 或 Qwen-VL。這種「小而強大」的特性,使得 MiniCPM-V 在部署上更具彈性,降低了運算資源的需求,為更廣泛的應用場景開啟了大門。

MiniCPM-V 系列在多項關鍵能力上表現出色,尤其在 OCR(光學字元辨識)、物體偵測與視覺推理方面。它不僅能夠精準地從複雜圖像中提取文字資訊,還能有效地識別圖像中的物件,並進一步進行高層次的語義理解與推理。例如,MiniCPM-V 2.0 支援高達 640×640 像素的圖像解析度,而 MiniCPM-V 2.4 更將其提升至 768×768 像素,確保了在細節處理上的卓越表現。這意味著無論是文件處理、街景分析,還是需要深度圖像理解的應用,MiniCPM-V 都能提供可靠的解決方案。此外,該模型還支援多語言能力,進一步擴展了其全球應用的潛力。

MiniCPM-V 4.5: High-Refresh Rate Video Understanding MLLM
(more…)
Categories: 開源, 視覺模型

ROSE2025 移除影片中任何物件

ROSE2025,全名為「可靠且開放集事件修補(Remove Objects with Side Effects)」。旨在推動電腦視覺領域,為處理複雜、動態的視覺數據缺失問題提供更穩健、更智能的解決方案。在不斷演進的電腦視覺領域,事件修補(Event Inpainting)正成為一項引人注目的新興研究方向。 ROSE2025 涵蓋了多個關鍵研究主題,包括但不限於:基於生成式模型的事件修補方法、深度學習在事件資料恢復的應用、新穎的損失函數與評估指標、開源數據集與基準的創建、以及與機器人、自動駕駛、監控等實際應用場景的結合。

ROSE2025,全名為「可靠且開放集事件修補(Remove Objects with Side Effects)」。旨在推動電腦視覺領域,為處理複雜、動態的視覺數據缺失問題提供更穩健、更智能的解決方案。在不斷演進的電腦視覺領域,事件修補(Event Inpainting)正成為一項引人注目的新興研究方向。

ROSE2025 涵蓋了多個關鍵研究主題,包括但不限於:基於生成式模型的事件修補方法、深度學習在事件資料恢復的應用、新穎的損失函數與評估指標、開源數據集與基準的創建、以及與機器人、自動駕駛、監控等實際應用場景的結合。

Categories: 開源, 香港大學, 視覺模型, 視頻模型, 影像模型, 影像處理

MVTracker 多視角 3D 點追蹤技術突破

在動態場景中精確追蹤物體,一直是電腦視覺領域的一大挑戰。傳統的單目追蹤器常受限於深度模糊和遮擋問題,而現有的多攝影機解決方案又往往需要多達20多個攝影機,並進行繁瑣的逐序列優化。然而,一項由ETH Zürich等機構開發的創新技術——MVTracker,正以其獨特的方法,為多視角3D點追蹤領域帶來革命性的突破。 引領多視角3D追蹤進入數據驅動新時代

在動態場景中精確追蹤物體,一直是電腦視覺領域的一大挑戰。傳統的單目追蹤器常受限於深度模糊和遮擋問題,而現有的多攝影機解決方案又往往需要多達20多個攝影機,並進行繁瑣的逐序列優化。然而,一項由ETH Zürich等機構開發的創新技術——MVTracker,正以其獨特的方法,為多視角3D點追蹤領域帶來革命性的突破。

引領多視角3D追蹤進入數據驅動新時代

(more…)
Categories: 開源, 視覺模型, 影像處理, 3D

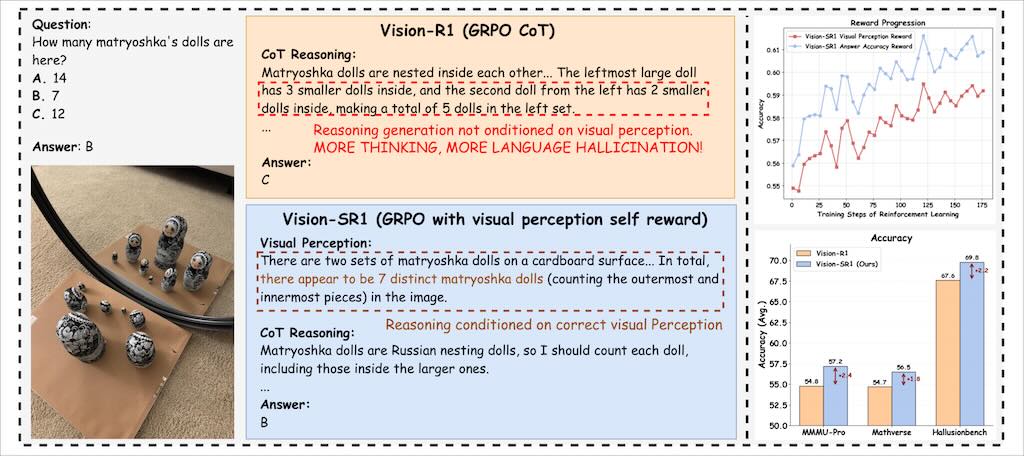
Vision-SR1 獨特的視覺空間推理機制

你是否曾因圖像模糊而感到困擾?想放大照片卻又擔心細節盡失?在數位時代,清晰的視覺體驗至關重要。今天,我們將深入探討一項令人興奮的技術——Vision-SR1,一個基於視覺空間推理網路的圖像超解析度解決方案,它有望徹底改變我們處理低解析度圖像的方式。 圖像超解析度(Super-Resolution, SR)的目標是從低解析度(Low-Resolution, LR)圖像中重建出高解析度(High-Resolution, HR)圖像。這項技術在監控、醫學影像、娛樂等多個領域都有廣泛應用。然而,如何有效恢復細節並生成逼真的高解析度圖像,一直是研究人員面臨的挑戰。Vision-SR1 正是為了解決這一挑戰而誕生的創新方法。 Vision-SR1 項目,全名為「Visual-Spatial Reasoning Network for Image Super-Resolution」(用於圖像超解析度的視覺空間推理網路),其核心在於引入了一個獨特的視覺空間推理機制。這意味著它不僅僅是簡單地放大圖像,而是能夠理解圖像中的空間關係和視覺語義,進而更智慧地推斷和重建缺失的細節。透過這種方式,Vision-SR1 能夠生成更為精確和自然的高解析度圖像,顯著提升視覺品質.。

你是否曾因圖像模糊而感到困擾?想放大照片卻又擔心細節盡失?在數位時代,清晰的視覺體驗至關重要。今天,我們將深入探討一項令人興奮的技術——Vision-SR1,一個基於視覺空間推理網路的圖像超解析度解決方案,它有望徹底改變我們處理低解析度圖像的方式。

圖像超解析度(Super-Resolution, SR)的目標是從低解析度(Low-Resolution, LR)圖像中重建出高解析度(High-Resolution, HR)圖像。這項技術在監控、醫學影像、娛樂等多個領域都有廣泛應用。然而,如何有效恢復細節並生成逼真的高解析度圖像,一直是研究人員面臨的挑戰。Vision-SR1 正是為了解決這一挑戰而誕生的創新方法。

Vision-SR1 項目,全名為「Visual-Spatial Reasoning Network for Image Super-Resolution」(用於圖像超解析度的視覺空間推理網路),其核心在於引入了一個獨特的視覺空間推理機制。這意味著它不僅僅是簡單地放大圖像,而是能夠理解圖像中的空間關係和視覺語義,進而更智慧地推斷和重建缺失的細節。透過這種方式,Vision-SR1 能夠生成更為精確和自然的高解析度圖像,顯著提升視覺品質.。

Categories: 開源, 視覺模型, 模型訓練

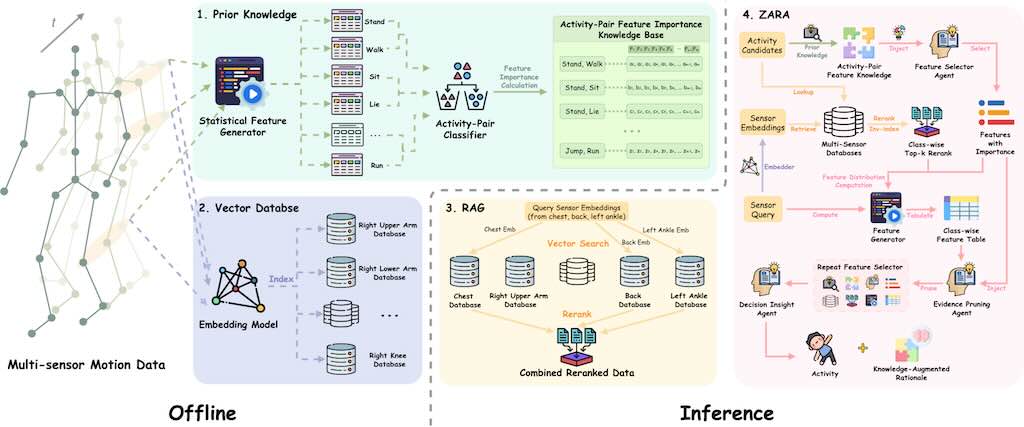
ZARA 人類身體活動識別框架

ZARA 是一個用於人類身體活動識別 (HAR Human Activity Recognition) 的新型框架,它利用穿戴式感測器的原始運動數據。傳統的 HAR 系統通常需要針對特定任務的深度學習模型進行昂貴的重新訓練,而且在引入新感測器或未見活動時,其泛化能力和零樣本識別能力有限,同時也缺乏可解釋性。 ZARA 透過結合多感測器檢索增強生成 (RAG)、自動化的成對領域知識注入和層次代理式大型語言模型 (LLM) 推理來克服這些限制。ZARA 不需額外訓練,就能在多種數據集和感測器配置上實現零樣本分類,其性能超越現有方法,並可提供驗證。研究強調了其檢索、知識庫和代理模組在提升準確性和支援決策方面的關鍵作用。

ZARA 是一個用於人類身體活動識別 (HAR Human Activity Recognition) 的新型框架,它利用穿戴式感測器的原始運動數據。傳統的 HAR 系統通常需要針對特定任務的深度學習模型進行昂貴的重新訓練,而且在引入新感測器或未見活動時,其泛化能力和零樣本識別能力有限,同時也缺乏可解釋性。

ZARA 透過結合多感測器檢索增強生成 (RAG)、自動化的成對領域知識注入和層次代理式大型語言模型 (LLM) 推理來克服這些限制。ZARA 不需額外訓練,就能在多種數據集和感測器配置上實現零樣本分類,其性能超越現有方法,並可提供驗證。研究強調了其檢索、知識庫和代理模組在提升準確性和支援決策方面的關鍵作用。

Categories: 開源, RAG, 視覺模型, Medical醫學

Page 19 of 20
1 17 18 19 20