Relit-LiVE:令影片重新打燈更自然

這個專案主打影片重打光,重點是光影連貫而且更像真實拍攝。對影像研究者和進階創作者特別有參考價值。

Nanjing University

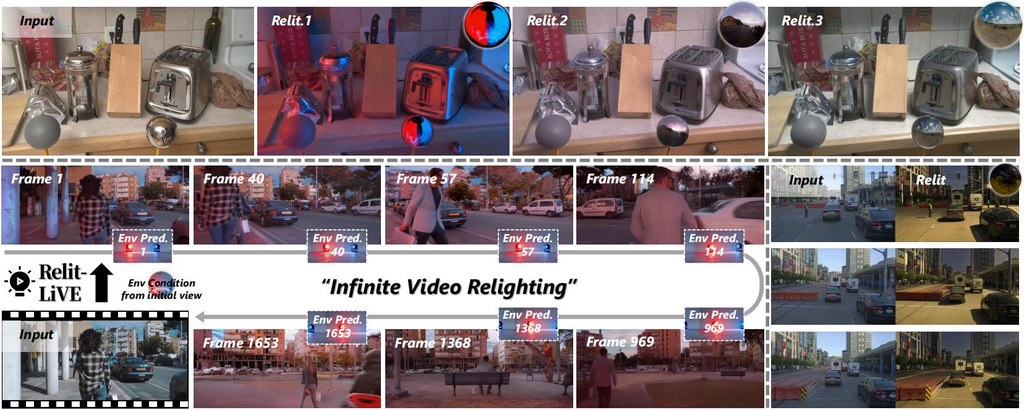
Relit-LiVE 是一個用來幫影片「重新打燈」的研究型專案。簡單講,就是把原本影片中的人物或場景,在不改動內容主體下,換成另一種光線效果,並盡量保持整段影片前後一致,不會一時光、一時暗。

這個專案較特別的地方,是它不依賴預先知道鏡頭姿態,並且會一同生成重打燈影片與環境光影片。這種做法有助提升物理一致性,令反光、陰影等細節看起來更合理,對比只逐格處理的方式,更重視時間上的穩定。

實際使用上,它目前較適合有 NVIDIA GPU 的使用者,官方亦建議至少 24GB VRAM,代表一般人未必適合在普通手提電腦直接試。現階段已提供推論程式與模型權重,但訓練流程、完整 inverse-forward pipeline,以及 Gradio 介面似乎仍未完全公開。

如果你是做影像研究、生成式影片實驗,或者想測試影片後期中的光照控制,這類工具會幾有參考價值。它未必是即開即用的消費級產品,但對需要高質感光影變化、又想減少畫面閃爍的人來說,方向相當清晰。

  • 主要用途是把現有影片重新套用新的光照效果
  • 重點創新是聯合生成環境光影片,提升連貫性與真實感
  • 已公開推論代碼與 checkpoints,適合先做效果驗證
  • 硬件要求偏高,較適合研究者或進階創作者
  • 相關模型資訊可見權重路徑提到的 Wan2.1-T2V-1.3B,亦有 Hugging Face 模型發佈頁可供參考

整體來看,Relit-LiVE 最吸引之處不只是「換光」,而是嘗試令影片中的光影變化更像真實世界。若你關心影片生成中的物理合理性、時間穩定性,以及反射和陰影表現,這個專案值得加入觀察名單。

Source: https://github.com/zhuxing0/Relit-LiVE

Categories: 開源, 南京大學, 清華大學, 模型, 視覺模型, 視頻模型, 影像處理, 中國

PAE:令擴散模型更快收斂的潛在空間設計

PAE不是只追求重建清晰度,而是重新整理潛在空間本身。對想提升生成質素與訓練效率的人,這個方向值得留意。

pae teaser

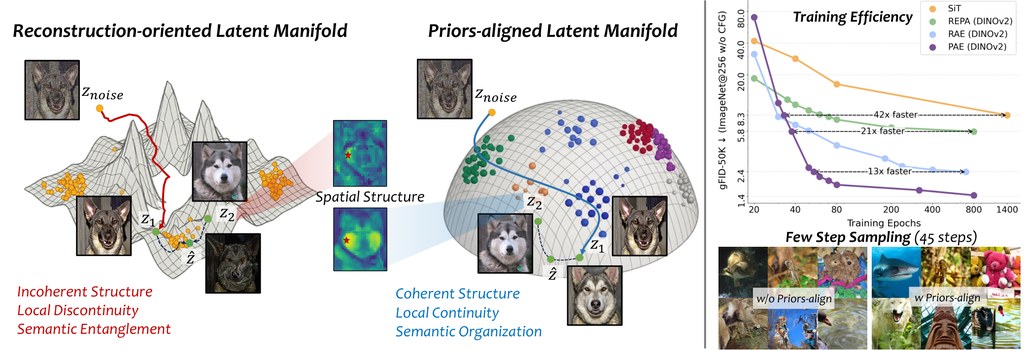
PAE 是一個為潛在擴散模型而設的自編碼器框架,重點不只是把圖片壓縮再還原,而是先把潛在空間整理成更適合擴散模型學習的形態。簡單講,它關心的不是「壓得靚唔靚」,而是「模型之後生圖時會唔會更順、更穩定」。

實際使用上,PAE 可理解為擴散模型前面的 tokenizer 或影像編碼模組:先把圖片轉成 latent,再交畀後續生成模型訓練。這種做法特別適合本身已在做 latent diffusion、但覺得收斂慢、訓練成本高,或者生成效果未夠穩定的研究與開發流程。

這個專案較有意思的地方,是它明確提出三個「對擴散友善」的潛在空間特質:空間結構一致性、局部流形連續性,以及全域語意組織。作者不是假設這些特質會自然出現,而是用三種 prior-alignment regularization 去主動約束,這比單靠重建誤差的傳統思路更進一步。

根據專案提供的結果,PAE 在 ImageNet 256×256 上做到 gFID 1.03,並且在相同 LightningDiT 設定下,收斂速度最高可比 RAE 快 13 倍。對非研究人員而言,這代表同樣資源下有機會更快見到可用成果;不過這些表現仍應視乎資料集、訓練設定與骨幹模型而定。

  • 核心定位:為 latent diffusion 準備更易學的潛在表示
  • 主要創新:把「擴散友善」拆成三個可優化的性質來訓練
  • 實際價值:有機會縮短訓練週期,提升生成質素與少步數採樣表現
  • 適合場景:影像生成研究、需要高效率訓練的生成系統、比較不同 tokenizer 設計
  • 可配骨幹:支援多種編碼器方向,包括 DINOv2、SigLIP2、DINOv3、MAE

如果你關心的是「如何令擴散模型學得更快,而唔係只換更大模型」,PAE 的切入點相當值得參考。它最適合有一定生成模型流程的人採用;對一般用家而言,未必是即裝即用工具,但作為下一代 latent tokenizer 的設計思路,含金量相當高。

Source: https://github.com/ZhengrongYue/PAE

Categories: 開源, 阿里巴巴, 模型, 視覺模型, 模型訓練, 影像模型, 中國

4DThinker:讓影片理解動態空間的4D視覺腦

4DThinker嘗試令模型不只「看圖說話」,而是從影片內部模擬場景變化。對動態空間推理有明顯研究價值。

drawing

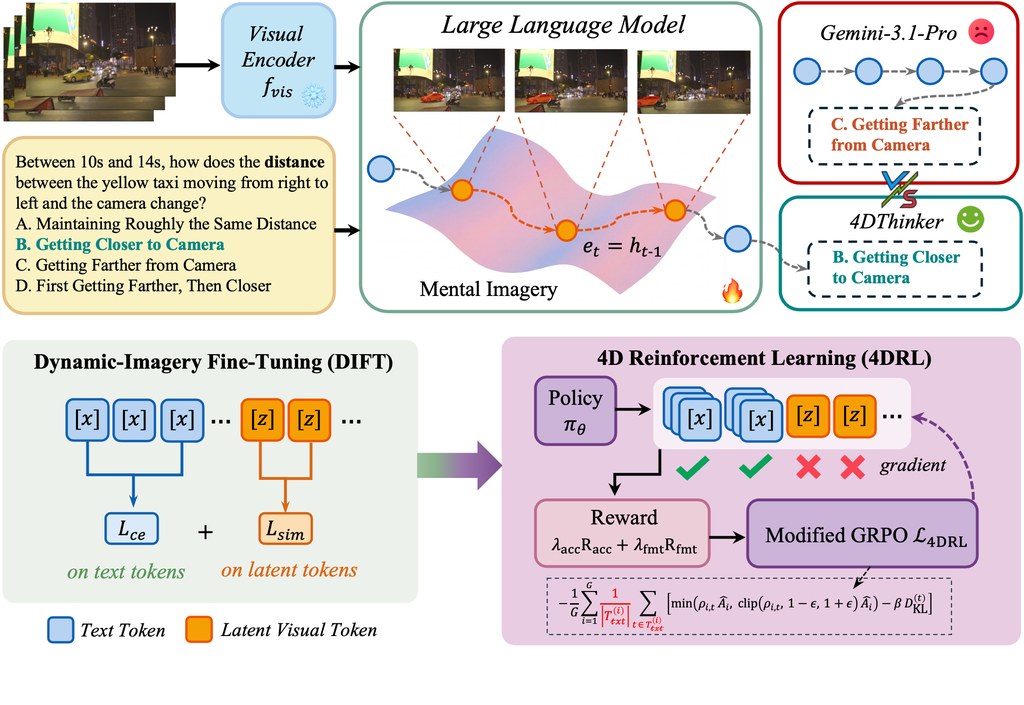
4DThinker 是一個面向研究用途的視覺語言模型框架,重點不是單純描述影片內容,而是讓模型從單鏡頭影片理解物件如何移動、互相影響,以及場景隨時間怎樣變化。簡單講,它想解決「模型見到影片,能否真正理解空間變動」這件事。

它的實際用法較接近訓練與評估流程,而不是即裝即用的消費級工具。專案提供資料集、模型權重、訓練程式,以及前處理所需資源;若要重現效果,需準備影片資料、SAM3 checkpoint,並以 Qwen2.5-VL-3B-Instruct 作為基礎模型,部分資料生成流程亦會用到 OpenAI 相容 API。

這個專案最值得留意的創新,在於它不再只靠文字一步步「講出」推理過程,而是加入所謂 4D latent imagery,讓模型在隱藏空間中模擬場景演化。配合 DIFT 微調,以及 4DRL 強化學習,方向上是希望把動態視覺理解能力直接學進模型本身,而非額外串接複雜幾何模組。

重點摘要:
– 針對單鏡頭影片的動態空間推理
– 提供資料生成、訓練與評測相關組件
– 以 4D 潛在表徵處理時間與空間變化
– 支援調整 latent token 數量與損失權重
– 較適合研究團隊,而非一般用家直接部署

如果你做的是機械人感知、影片問答、場景理解,或者想提升模型對「之後會怎樣」的判斷,4DThinker 特別值得留意。至於一般內容摘要或靜態圖片分析,它未必是最直接的選擇,因為整個設計明顯是為動態推理而生。

Source: https://github.com/zhangquanchen/4DThinker

Categories: 開源, 清華大學, Agentic, 模型, 視覺模型, 庫, 中國

HumanNet:百萬小時影片庫,點樣幫AI更識人類動作

HumanNet 不是聊天工具,而是訓練 AI 看懂人類動作的大型影片資料庫。它的價值在於規模、視角配對與細緻標註。

teaser

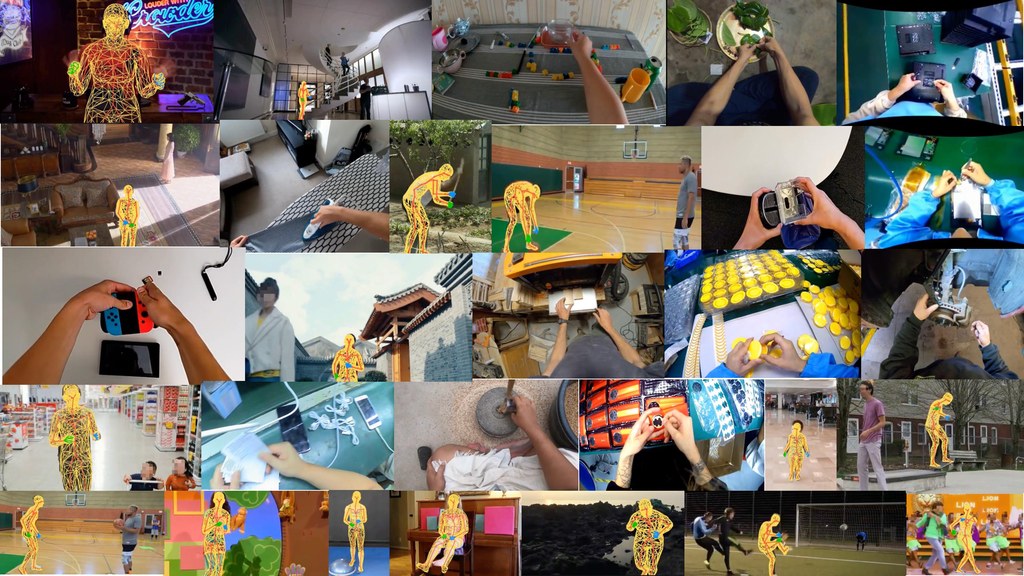
HumanNet 是一個以「人類活動」為核心的大型影片資料庫,目標是幫研究團隊訓練模型,更準確理解動作、互動同身體運動。它收集接近百萬小時影片,重點不只是片量大,還包括第一身與第三身視角的配對,以及動作相關標註。

實際使用上,這個專案較適合做 AI 研究、資料集分析,或者作為影片理解模型的預訓練基礎,而不是一般用家即裝即用的應用程式。現階段公開資訊顯示,完整語料、整理流程同驗證程式碼仍在陸續釋出,較像研究預覽版本。

它最值得留意的創新,是把資料整理流程本身當成核心設計,包括以人為中心的篩選、視角分類、去重、品質控制同私隱審查。相比單純堆影片數量,HumanNet 更著重資料是否適合訓練模型理解細緻動作,這點對機械人學習同具身智能尤其重要。

根據項目提供的結果,在受控的 vision-language-action 後訓練設定下,用 HumanNet 內約 1,000 小時第一身影片作初始化,效果可追近甚至略勝較少量真實機械人資料,亦明顯縮窄與超大型機械人資料基線的差距。這代表當機械人實拍數據昂貴又難收集時,人類第一身影片可能是更可擴展的替代方案。

  • 做什麼:提供大規模人類活動影片,用於動作理解、影片學習與具身 AI 預訓練。
  • 點樣用:適合研究人員用來訓練、初始化或評估影片與動作模型。
  • 主要特色:兼有第一身與第三身視角,並附說明文字、動作、手部與身體訊號。
  • 最適合場景:機械人學習、活動辨識、從影片學習操作行為。
  • 要注意:目前看來仍屬研究預覽,部分資料與流程尚未完全公開。

Source: https://github.com/DAGroup-PKU/HumanNet

Categories: 開源, 北京大學, 模型, 視覺模型, 中國

iWorld-Bench:互動世界模型評測新基準

iWorld-Bench 針對互動世界模型建立統一評測框架,涵蓋動作控制、記憶與多場景能力。它也補上大型資料集與標準化測試不足的缺口。

iWorld-Bench Overview

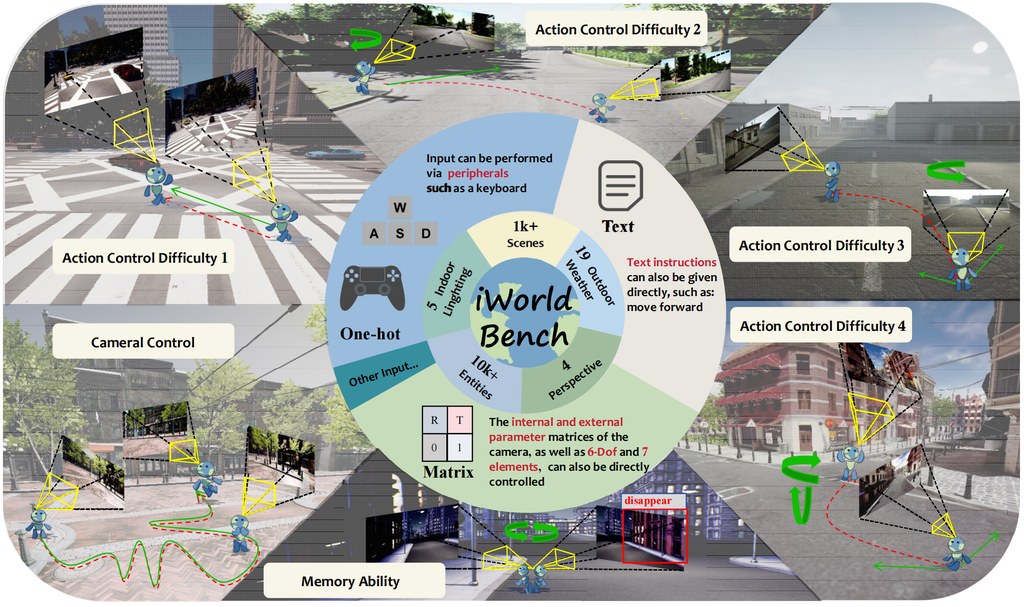
iWorld-Bench 是一個面向互動式世界模型的基準測試,目標是評估模型在外部動作序列驅動下的感知、推理與回應能力。網站資訊指出,它提供 33 萬段影片資料、4,900 個測試任務,以及 9 項綜合指標,用來觀察模型在距離感知、記憶與軌跡跟隨等面向的表現。

實際使用上,研究者可把不同類型的世界模型接到其統一的 Action Generation Framework,將多種輸入模態轉換為可比較的互動任務。這種做法特別適合訓練後評測、模型橫向比較,以及檢查模型在多視角、不同天氣與多場景條件下的穩定性。

這個專案的主要創新,在於把原本互動形式不一致的世界模型拉到同一套評估框架中,並設計六類任務統一測試。相較既有基準多偏向一般世界模型或操作策略評估,iWorld-Bench 強調多輸入、動作控制、鏡頭控制、記憶能力,以及跨場景與全天候適應性。

  • 提供 33 萬段影片與 4,900 個測試任務
  • 以統一動作生成框架比較不同互動世界模型
  • 評測重點涵蓋視覺生成、軌跡跟隨與記憶能力
  • 支援多模態輸入、多視角、多場景與全天候條件
  • 已用於評估 14 個具代表性的世界模型

從應用角度看,會受惠的工作包含具身 AI、機器人模擬、可控影片生成、自主代理訓練,以及需要互動式環境建模的研究。性能與評估方面,網站明確表示其以 9 項指標檢驗 14 個代表性模型,並指出現有方法仍有侷限;但由於論文、程式碼、資料集與排行榜尚未公開,部分細節仍需等待正式發布確認。

模型列表:文中僅提到共評估 14 個代表性世界模型,頁面內容未列出具體名稱。

Categories: 視覺模型, 世界模型, AGI

OmniShotCut 在鏡頭邊界偵測任務的最新技術

OmniShotCut 以其多功能的轉換器模型革新了鏡頭邊界偵測。對於追求精確度的影片編輯師和研究人員來說,這是理想的選擇。

logo

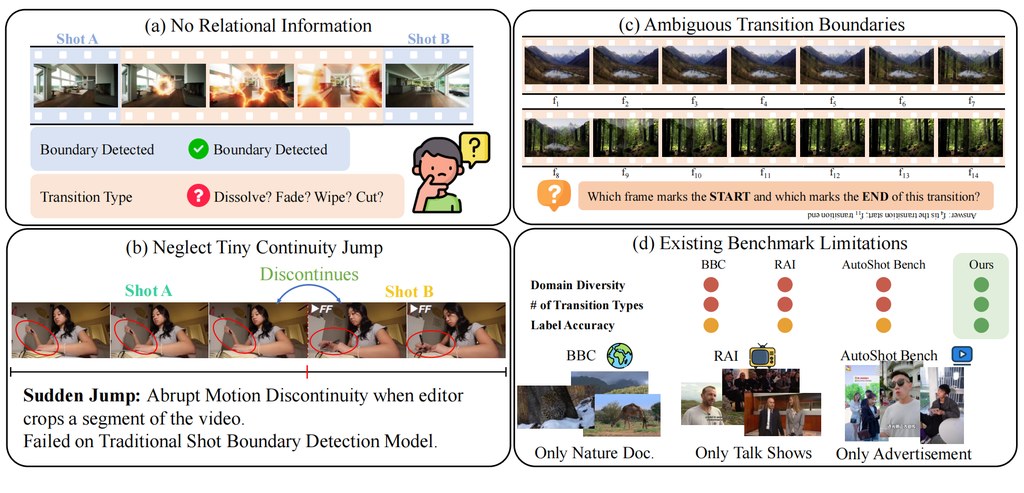
OmniShotCut 作為一種先進的解決方案,在各種類型的影片中都能出色地偵測鏡頭邊界,從動畫到體育轉播皆適用。該工具採用基於鏡頭查詢的影片轉換器,與傳統方法相比,提供了更高的靈敏度和資訊豐富性。處理多樣化影片來源的影片編輯師、內容創作者和研究人員應該考慮使用 OmniShotCut,因為它能夠準確識別突兀的跳接和微妙的轉場如溶解和漸變。對於初次使用該工具的人,首先理解鏡頭查詢機制的核心概念可以提供堅實的基礎。這種方法使模型能夠有效地分析和分類影片中的不同類型的鏡頭變化,特別適合需要對影片編輯過程進行精確控制的專業人士。

實際上,OmniShotCut 通過其複雜的轉換器架構處理影片幀來運作。模型學習根據視覺線索和時間關係區分不同的鏡頭類型。用戶可以從這項技術中獲益良多,特別是在處理需要細緻編輯的大批量影片內容時。自動偵測這些邊界可以節省大量的時間和精力,讓編輯師能夠專注於創意方面而非手動分割。此外,本地 Gradio 介面的加入簡化了實驗和與現有工作流程的整合,即使對那些程式設計經驗有限的人也同樣易於使用。

OmniShotCut 的主要受益者是媒體製作專業人士、研究影片內容的學術研究人員以及從事影片分析應用的開發人員。這些群體可以利用該工具的能力來提升他們項目的品質和效率。然而,需要注意潛在的權衡。雖然 OmniShotCut 在準確性和多功能性方面表現優異,但用戶必須確保擁有足夠的計算資源以高效運行模型。此外,底層轉換器架構的複雜性可能對不熟悉深度學習概念的用戶構成挑戰。因此,基本的機器學習原則理解將會很有幫助。

為了最大化 OmniShotCut 的效益,用戶應從探索提供的 Gradio 示範開始。這種親手實踐的體驗可以提供對模型性能的洞察,並有助於理解其輸出。觀察的重點包括模型如何處理不同類型的影片以及其鏡頭變化偵測的準確性。透過實驗各種輸入影片,用戶可以對將 OmniShotCut 應用於特定需求充滿信心。此外,在推理過程中考慮 clean_shot 模式可以簡化結果,提供僅聚焦於有效鏡頭而無轉場或突兀跳接的乾淨輸出。

OmniShotCut 代表了鏡頭邊界偵測技術的重大進步。其堅固的設計和多功能應用使其成為任何處理影片內容的人的無價資產。儘管在計算需求和技術知識方面存在某些考量,但使用 OmniShotCut 的好處遠遠超過這些小障礙。隨著影片分析領域的不斷髮展,像 OmniShotCut 這樣的工具無疑將在塑造未來創新中發揮關鍵作用。

Source: https://github.com/UVA-Computer-Vision-Lab/OmniShotCut

Categories: 開源, 視覺模型, 視頻模型, 影像模型, 影像處理

Amaze 獨特的視覺規劃工具

探索Amaze,一個強大的視覺規劃工具,透過影像編輯模型實現。對於研究人員和開發人員解決複雜的迷宮挑戰尤為理想。

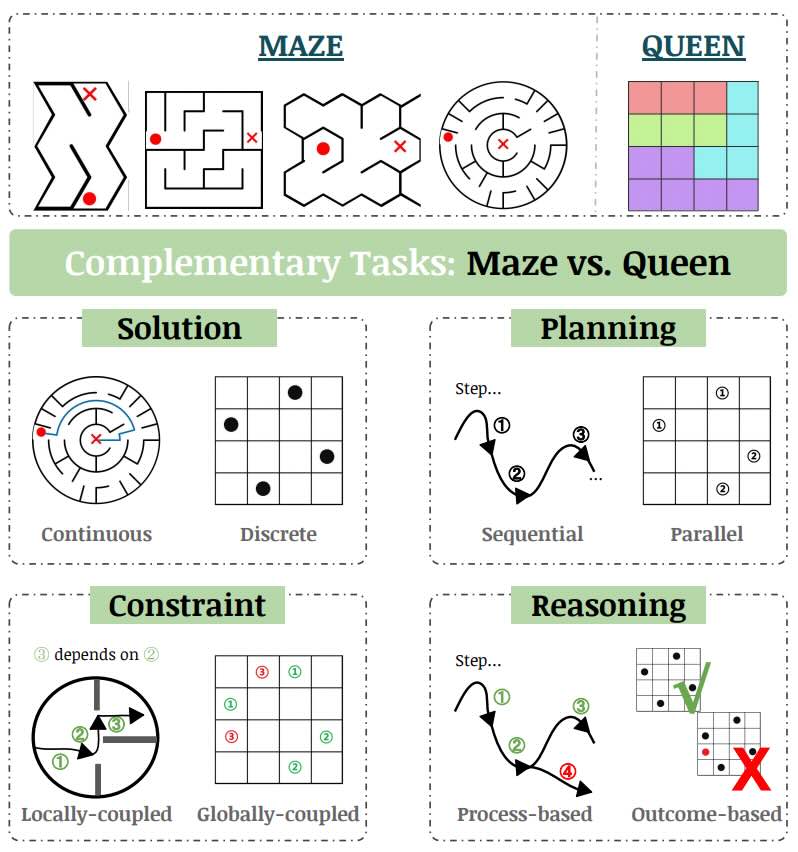
Amaze 提供了一種獨特的視覺規劃方法,透過先進的影像編輯模型來實現。這個儲存庫對於有興趣探索電腦視覺與AI驅動問題解決交集的研究人員和開發人員特別有價值。該專案專注於針對特定任務微調這些模型,例如導航迷宮,這需要對空間關係和模式識別有深入的理解。使用者應首先熟悉支援的模型,包括Bagel、Janus-Pro-7B和Qwen-Image-Edit,以及允許與外部服務靈活整合的API基於的模型。

在實踐中,Amaze通過應用監督式微調(SFT)技術來適應預訓練模型以符合迷宮解決任務的細微差異。該過程涉及使用config/資料夾中詳細指定的參數配置模型,其中maze.py包含Amaze Bench的特定設定。配置完成後,使用者可以進入sft/目錄執行為每個模型量身定做的微調腳本。此步驟對於優化目標任務的性能至關重要,確保模型能夠有效地解釋和操作視覺數據以解決迷宮。

使用Amaze的好處對於那些需要複雜視覺推理能力的專案最為顯著。機器人、自動系統和AI驅動遊戲等領域的研究人員可以利用此工具增強其應用程式在複雜環境中的導航能力。此外,希望將尖端影像編輯技術整合到產品中的開發人員會發現Amaze因其堅固的支持和清晰的文檔而無價。

然而,也有一些權衡需要考慮。對於初學者或沒有豐富機器學習經驗的人來說,設置和微調模型的複雜性可能會構成挑戰。根據專案規模的不同,訓練和推理所需的計算資源也可能相當龐大。使用者應仔細評估其硬體能力並分配足夠的時間進行實驗和優化。

要開始使用,請專注於理解專案結構。該儲存庫組織成幾個關鍵目錄:config/、data/、infer/、scripts/和sft/。每個目錄在工作流程中都具有不同的目的,從管理配置和加載數據集到執行推理和微調過程。特別注意infer/目錄,它包含了生成模型響應和計算評估指標的核心邏輯。該目錄中的maze_metrics.py文件尤其重要,因為它定義了用於評估模型在迷宮解決任務上表現的專業指標。

Amaze提供了一個全面的框架,用於在視覺規劃場景中利用影像編輯模型。雖然它需要一定的專業知識和資源投資,但在增強視覺推理能力方面的潛在收益使其成為相關領域專業人士值得追求的事業。透過仔細瀏覽其特點和功能,使用者可以解鎖AI驅動問題解決的新可能性。

Source: https://github.com/spatigen/amaze

Categories: 開源, 視覺模型, 庫

FORGE:製造場景的細粒度多模態評估

FORGE 提供了一個穩健的框架,用於評估視覺語言模型在製造異常檢測中的表現。適合希望在工業環境中優化 AI 應用的研究人員和工程師。

FORGE 標誌
AI4Manufacturing/FORGE 在 GitHub 上

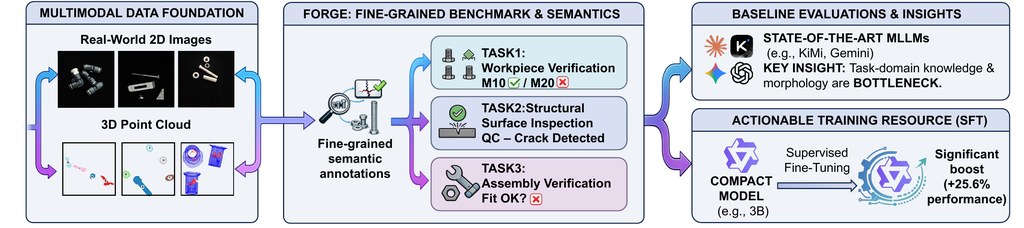
FORGE 提出了一個全面的評估框架,專門針對視覺語言模型(VLMs)在工業製造異常檢測中的應用。這個工具對於希望評估和改進 VLMs 在實際製造場景中表現的研究人員、工程師和 AI 專業人士特別有價值。該框架涵蓋了三個核心任務和基礎消融研究,提供了一種多維度的方法來理解 VLMs 在檢測異常(如錯誤模型、額外零件和缺失組件)方面的能力和限制。

在深入研究 FORGE 時,用戶應首先專注於理解三個主要任務:錯誤模型檢測、異常分類和額外/錯誤零件檢測。這些任務旨在模擬製造環境中面對的實際挑戰,使用照片和渲染圖像。基礎消融研究進一步探討了空間基礎和跨圖像零件匹配,提供了對 VLMs 空間推理能力的洞察。

在實踐中,FORGE 通過利用多種評估設置(包括零樣本、少樣本和上下文學習(ICL))來運作。用戶可以通過 YAML 文件配置這些設置,這些文件控制所有評估參數,如模型名稱、溫度和最大令牌數。這種靈活性使研究人員能夠根據自己的特定需求和假設量身定製評估過程。該框架支持多種後端,如 OpenRouter、OpenAI、Anthropic 和 Google,使用戶能夠實驗不同的 VLMs 並觀察其性能變化。

最能從 FORGE 中受益的是那些參與製造業 AI 解決方案開發和部署的人士。通過提供標準化的基準,FORGE 幫助這些專業人士識別各種 VLMs 的優缺點,促進在模型選擇和整合方面的明智決策。此外,詳細的輸出文件,包括緊湊結果、帶有原始 API 訊息的完整結果和執行日誌,為分析和報告提供了寶貴的數據。

然而,也有一些權衡需要考慮。框架的複雜性可能對新手構成學習曲線,需要對 VLMs 和異常檢測原理有紮實的理解。此外,運行廣泛評估所需的計算資源可能相當龐大,特別是在處理大型數據集和多種評估設置時。用戶還應當小心數據集中的潛在偏見和評估任務的限制,這些可能無法完全捕捉到實際製造異常的所有方面。

為了充分利用 FORGE,用戶應從探索存儲庫中提供的示例 YAML 配置文件開始。這些文件作為設置和運行評估的實踐指南。熟悉不同任務及其特定要求也是有益的,因為這些知識有助於設計有效的評估策略。此外,利用基礎消融研究可以提供對 VLMs 空間推理能力的更深洞察,這對於涉及零件匹配和空間基礎的任務至關重要。

FORGE 是一個強大的工具,用於評估視覺語言模型在製造異常檢測中的應用。它提供了一種結構化的評估模型性能的方法,涵蓋各種任務和設置,使希望在工業環境中增強 AI 應用的研究人員和工程師受益。儘管存在複雜性和資源需求,但框架的靈活性和全面的輸出使其成為推進製造業 AI 領域的寶貴資產。

City University of Hong Kong | HKUST (Guangzhou) | CUHK (Shenzhen)

Source: https://github.com/AI4Manufacturing/FORGE

Categories: 開源, 香港中文大學, 香港科技大學, 香港城市大學, 視覺模型, 庫

WildDet3D:擴展野外可提示的3D檢測

WildDet3D 將可提示的3D檢測擴展到實際應用中。適合電腦視覺領域的研究人員和開發人員。

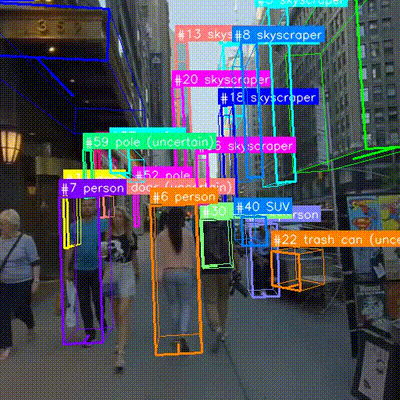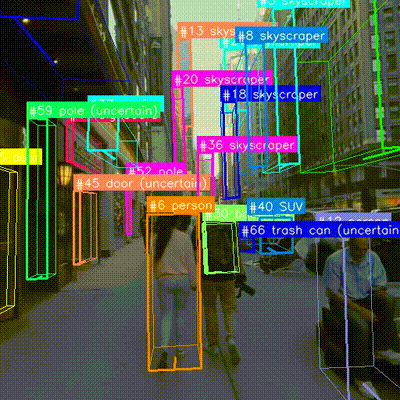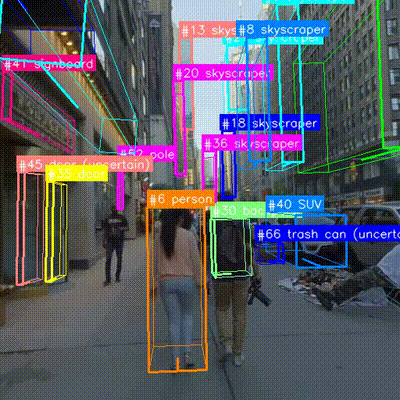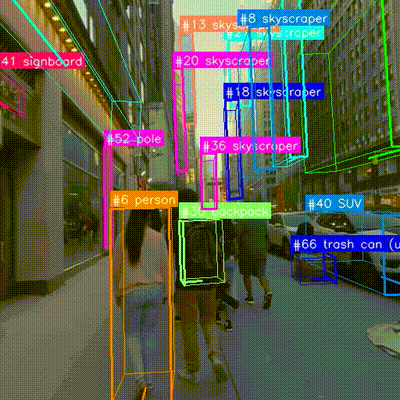
WildDet3D 的主要受益者是電腦視覺、機器人和擴增實境領域的研究人員和開發人員。在非結構化環境中進行準確的3D檢測為機器人操作等應用打開了新的可能性,其中精確的物件定位至關重要。同樣,在AR/VR中,WildDet3D可以通過準確檢測和渲染現實世界環境中的3D物件,實現更沉浸和互動的體驗。

WildDet3D 在3D檢測領域代表了一個重要的進步,特別是在現實世界、非結構化環境中。這個項目由艾倫人工智慧研究所和華盛頓大學等機構的協作團隊領導,為希望提升3D檢測能力的人們提供了一個多功能的工具包。無論您是探索電腦視覺最新技術的研究人員,還是將先進3D檢測整合到應用中的開發人員,WildDet3D 都提供了堅實的基礎供您建立。

對於新手來說,最直接的重點應該是理解核心功能以及如何將其應用於特定的使用案例。該項目的文檔和示範應用提供了一個明確的起點。例如,HuggingFace 互動示範允許用戶在網頁瀏覽器中直接實驗文本、點和框提示,提供了一個直觀的技術介紹。此外,iPhone 應用展示了實時的裝置上3D檢測,展示了WildDet3D在移動環境中的實際應用。

在實踐中,WildDet3D 通過利用先進的機器學習模型來解讀2D圖像並推斷3D空間資訊。該系統可以處理各種類型的提示,包括文本描述、幾何框輸入和視覺範例,以檢測和定位三維空間中的物件。這種靈活性使其特別適用於需要動態和互動3D物件檢測的應用。例如,將WildDet3D與視覺語言模型整合可以增強系統理解並回應關於3D環境的複雜查詢的能力。

然而,也有一些權衡需要考慮。雖然WildDet3D提供了令人印象深刻的性能,但它需要大量的計算資源,特別是對於實時應用。用戶應確保他們有足夠的硬體能力來支持模型的需求。此外,對高品質輸入數據的依賴,如準確的相機內參和可選的深度輸入,可能影響系統的有效性。要達到最佳結果,仔細的校準和數據預處理是必不可少的。

要開始使用WildDet3D,安裝過程涉及克隆儲存庫並設置具有必要依賴項的Python環境。以下是安裝的代碼塊:

Bash
git clone --recurse-submodules https://github.com/allenai/WildDet3D.git
cd WildDet3D
conda create -n wilddet3d python=3.11 -y
conda activate wilddet3d

安裝所有依賴項
pip install -r requirements.txt

安裝後,用戶可以探索該項目提供的各種推理方法。這些包括基於文本提示、幾何框輸入和視覺範例檢測物件。每種方法都有其優點,適用於不同的使用案例。例如,文本提示對於需要自然語言互動的應用最為理想,而框提示則更適合已知特定物件位置的場景。

總之,WildDet3D 是一個強大的工具,用於擴展現實世界應用中的3D檢測。它為研究人員和開發人員提供了一個靈活且堅實的框架,以探索和整合先進的3D檢測能力。雖然需要仔細考慮計算資源和輸入數據品質,但對於電腦視覺、機器人和AR/VR應用的潛在好處使其成為這些領域工作人員工具包中的寶貴添加。通過專注於核心功能並理解實際影響,用戶可以為其特定需求釋放WildDet3D的全部潛力。

Source: https://github.com/allenai/WildDet3D
Categories: 開源, 視覺模型

LGTM – 0.5 秒 重建 3D 場景

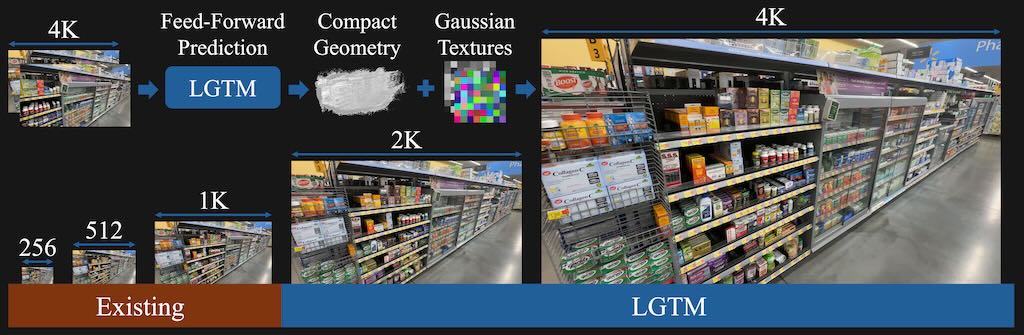
LGTM 是首個原生支援 4K 饋送前向(feed-forward)方法,透過預測緊湊的高斯原語(Gaussian primitives)搭配每個原語的紋理(textures),解耦幾何複雜度與渲染解析度,避免傳統方法隨解析度增加而原語數量二次方爆炸。這是由 Yixing Lao(香港大學博士生)領導的 3D 高斯噴濺(Gaussian Splatting)研究項目,已被 ICLR 2026 接受。

LGTM 是首個原生支援 4K 饋送前向(feed-forward)方法,透過預測緊湊的高斯原語(Gaussian primitives)搭配每個原語的紋理(textures),解耦幾何複雜度與渲染解析度,避免傳統方法隨解析度增加而原語數量二次方爆炸。這是由 Yixing Lao(香港大學博士生)領導的 3D 高斯噴濺(Gaussian Splatting)研究項目,已被 ICLR 2026 接受。

Categories: 開源, 香港大學, 視覺模型, 視頻模型

Page 20 of 23
1 … 18 19 20 21 22 23