TRON 視覺推理環境

TRON 是一套包含520個視覺推理環境的工具,每次訓練都會即時生成新題目,並由系統自動核對答案,協助多模態模型透過強化學習提升表現。

TRON overview

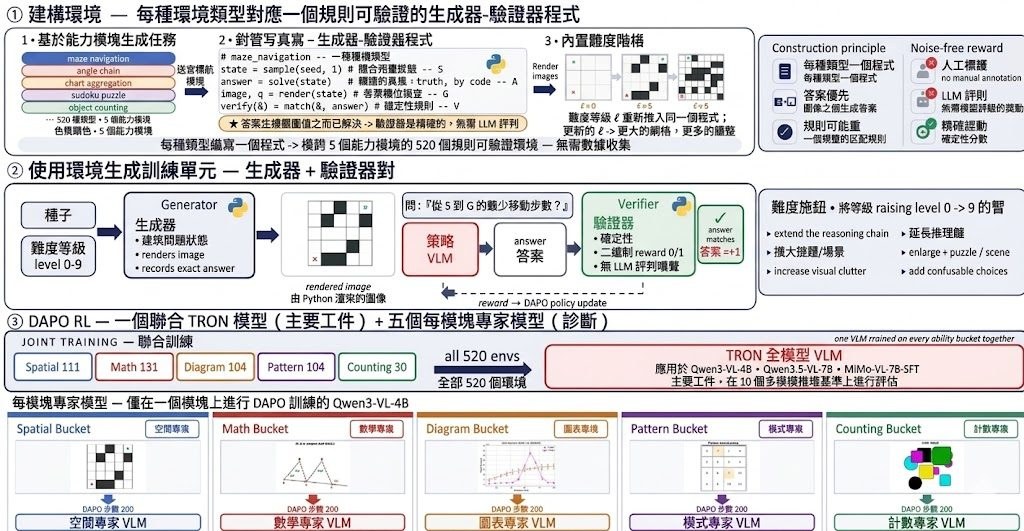
TRON(Targeted Rule-verifiable Online Environments for Visual Reasoning RL)由喬治亞大學運算學院的研究團隊開源,是一個用於視覺推理強化學習的環境套件。與傳統固定的圖文題庫不同,TRON 的每個環境都由「生成器」與「驗證器」組成:生成器負責抽樣新的視覺狀態並繪製圖片,驗證器則即時比對模型答案與標準答案,因此每次呼叫都會產生全新題目,數量上不受既有資料集限制。

這個項目解決的核心問題是視覺推理強化學習長期缺乏可擴展、可控制、可驗證的訓練信號。過往做法依賴人工標註或合成指令的靜態資料集,題目數量受限,且難以針對特定難度與技能做調整。TRON 把每道題目變成可程式化的環境,訓練時可依據當前課程難度持續產出新實例,並由驗證器提供精確的獎勵。

套件規模方面,TRON 包含520個環境,分為五大能力類別:空間(111個)、數學(131個)、圖表(144個)、規律(104個)和計數(30個)。同一套環境可同時訓練一個全能力的「full TRON model」,或分別訓練五個針對單一能力的 specialist 模型。團隊亦針對生成穩定性、題目多樣性、跨環境重複率與基礎模型在不同難度的通過率進行了完整的子環境分析。

訓練與評估部分,項目採用 TRON-DAPO 強化學習方法。使用 TRON 進行 RL 後訓練,Qwen3-VL-4B、Qwen2.5-VL-7B 與 MiMo-VL-7B 等多個多模態模型,在十個外部視覺推理基準測試上都有穩定提升。對想研究視覺 RL 的研究人員或團隊而言,TRON 提供了一個現成、可擴展且易於自訂難度的訓練場景。

重點摘要

  • 520個可程式化的視覺推理環境,分屬空間、數學、圖表、規律、計數五大類別。
  • 每次訓練都會即時生成新題目,並由驗證器自動核對答案。
  • 支援訓練單一全能力模型或多個單一能力的 specialist 模型。
  • 內建子環境分析,涵蓋生成穩定性、難度梯度與基礎模型表現。
  • 在多個主流多模態模型上,採用 TRON-DAPO 訓練皆能提升外部基準表現。
GitHub: https://github.com/YangTianze009/TRON

Paper: https://arxiv.org/pdf/2606.01599

Categories: 視覺模型, 模型訓練, 深度學習, Dataset 數據集

DRDD:用兩階段拆解擴散模型,更省數據的圖像轉譯方案

港大團隊提出的 DRDD 把擴散過程拆成兩段獨立階段,統一處理多種圖像修復任務,並在配對數據有限時仍維持穩定表現。

Main figure

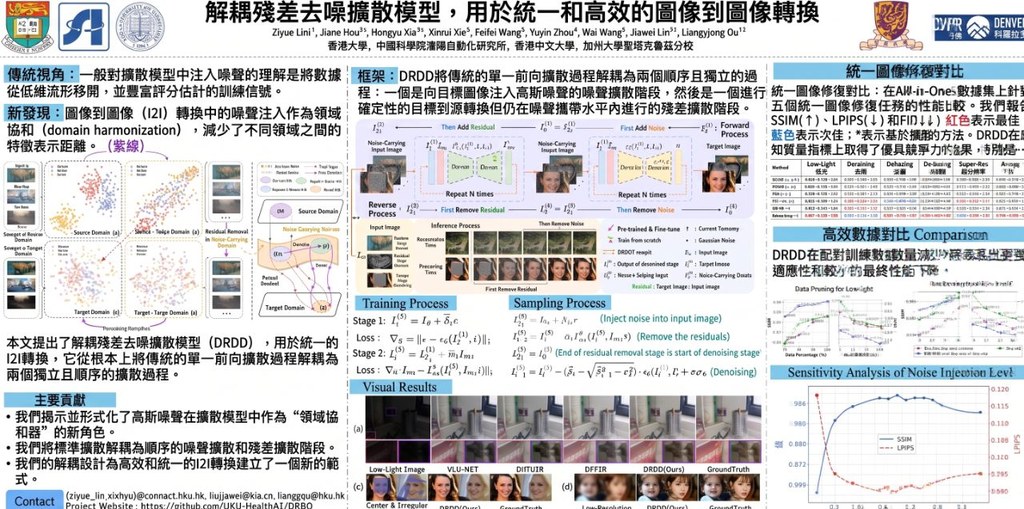
圖像到圖像轉譯(Image-to-Image Translation, I2I)涵蓋去雨、去霧、低光增強、去噪、去模糊等多種任務,傳統做法往往需要為每個場景單獨訓練模型。HKU-HealthAI 提出的 Decoupled Residual Denoising Diffusion models(DRDD)嘗試用一套架構同時處理這些任務,並減少對大量配對數據的依賴。

DRDD 的核心做法是把擴散過程拆成兩個獨立階段:第一階段負責加入雜訊,達到所謂的「域調和」(domain harmonization)與流形抬升(manifold lifting);第二階段則在固定雜訊下做決定性的殘差擴散,專注學習語意對應。這種解耦設計避免了傳統擴散模型在去噪過程中提早耗散域調和效果的問題,因此能在一個模型內統一處理多個修復任務。

由於第一階段的雜訊擴散只使用目標域的非配對圖像訓練,DRDD 在配對數據稀缺時仍能保持表現,這對醫療影像或特殊場景數據蒐集成本高的領域特別有用。團隊在 all-in-one-5 設定下測試,涵蓋 Rain100L、GoPro、Dehaze、CBSD68 與 LOL 等數據集,並使用 LPIPS 等指標評估。論文亦提供理論與實證分析,說明其設計相容於主流擴散模型架構。

這個項目適合從事圖像修復、影像增強或風格轉換的研究者與工程師,尤其關心多任務統一、數據效率的團隊。使用前需要 Linux 環境、NVIDIA GPU、Python 3.7 以上,以及 Conda。預訓練權重可從 Quark 或其他途徑取得,並依說明放入 ./pretrained_models 目錄。

重點摘要:
– 將擴散拆成「雜訊擴散」與「殘差擴散」兩階段,保留域調和效果。
– 支援去雨、去霧、低光、去噪、去模糊等多種 I2I 任務的統一訓練。
– 第一階段僅用非配對目標域數據,降低對配對樣本的依賴。
– 相容主流擴散模型,可作為插件式改良方向。
– 適合醫療影像、遙測或數據稀缺場景的研究團隊。

DRDD 已在 GitHub 公開代碼與數據集結構,鼓勵社群以現有擴散骨幹(如 DDPM 系列)進一步測試與延伸。

GitHub: https://github.com/HKU-HealthAI/DRDD

Paper: https://arxiv.org/pdf/2606.01048

Categories: 開源, 香港中文大學, 香港大學, 模型, 視覺模型, 影像模型, 影像處理, Dataset 數據集

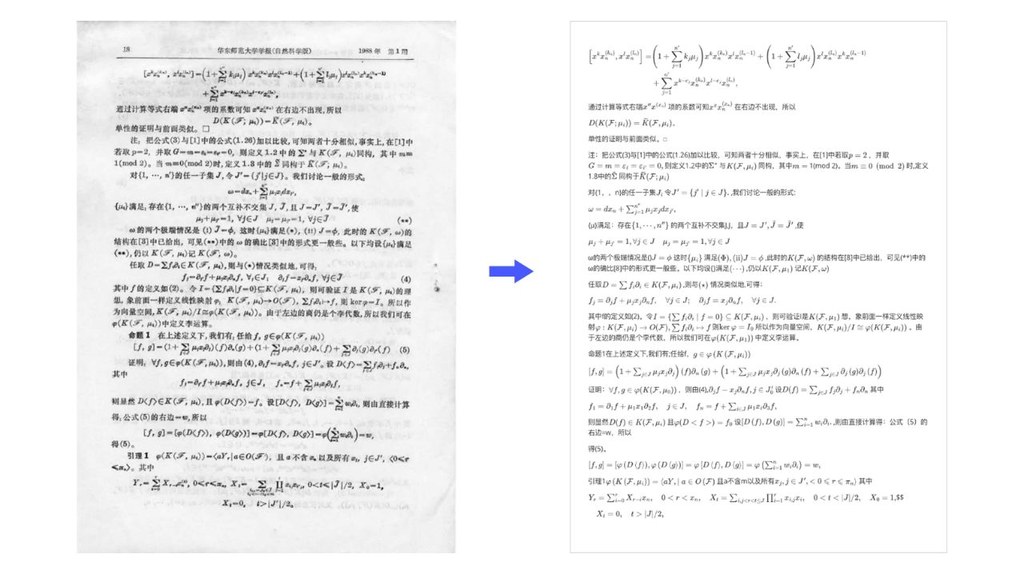
PaddleOCR 把圖片和 PDF 變成 LLM 吃得到的結構化資料

百度開源的 PaddleOCR 已累積逾 7 萬顆星,1.6 版輕量模型在 OmniDocBench 取得 96.33% 分數,為 RAG 與 Agent 應用提供高效率的文檔解析基礎。

Star-history

處理 PDF 和圖片一直是企業導入 LLM 應用時最頭痛的關卡,傳統 OCR 工具只會吐出零散文字,遇到表格、公式或多語言混排就頻頻出錯。PaddleOCR 由百度 PaddlePaddle 團隊開源,目標是把雜亂的掃描檔和圖片整理成 LLM 友善的 JSON 或 Markdown,後續無論餵給 RAG 檢索還是 Agent 流程都更順暢。

這個項目以兩個核心模型撐起整套能力。PaddleOCR-VL-1.6 是一款 0.9B 參數的視覺語言模型,專注文件解析,在 OmniDocBench v1.6 取得 96.33% 分數,對古文、罕見字、印章及圖表也有顯著強化。PP-StructureV3 則補足了另一條路線,提供表格儲存格、文字等更細粒度的座標資訊,方便需要版面重建的場景。最新版 PP-OCRv5 支援 100 多種語言,準確度較前代提升約 13%,同時保持輕量部署特性,可在 CPU、GPU、NPU 等不同硬體運行。

目前的 LLM-RAG 開源生態中,Dify、RAGFlow、Cherry Studio 等知名項目都採用 PaddleOCR 作為文件解析層,社群也累積超過 6,000 個依賴它的下游項目。對需要批次處理合約、研究論文、政府公文或多語文件的人來說,這套工具兼具商用級準確度與邊緣裝置可用的效率,動手前只要準備好 Python 3.8 至 3.12 環境即可開始試跑。

重點摘要

  • PaddleOCR-VL-1.6 (0.9B) 在 OmniDocBench v1.6 達到 96.33%,輕量卻具競爭力。
  • PP-StructureV3 補足細粒度座標,適合需要表格與版面重建的應用。
  • PP-OCRv5 支援逾 100 種語言,準確度較前代提升約 13%,硬體需求低。
  • 已被 Dify、RAGFlow、Cherry Studio 等 LLM 應用項目整合採用。
  • GitHub 逾 7 萬顆星、6,000 多個依賴項目,社群驗證度高。

GitHub: https://github.com/PaddlePaddle/PaddleOCR

Paper: https://arxiv.org/pdf/2606.03264

Categories: 開源, 模型, 視覺模型, 中國, Dataset 數據集, 百度

GGT-100K:用十萬對真實影像 拓寬圖像修復的泛化邊界

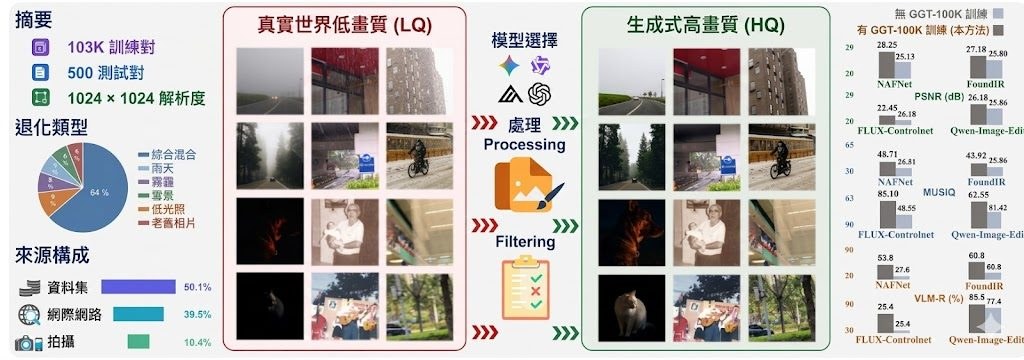
香港理工大學與 OPPO 研究院聯手發布 GGT-100K 數據集,從 MFM 模型生成十萬對低品質與高品質影像配對,協助圖像修復模型在真實場景中表現更穩定。

GGT-100K logo

過去訓練圖像修復模型時,開發者往往受限於合成數據與真實場景之間的差距;模型在實驗室數據集表現亮眼,遇到街拍、手機夜拍等真實退化影像就大打折扣。GGT-100K 正是為了解決這個落差而生,由香港理工大學 OPPO 研究院共同推出,主打從 MFM(Multimodal Foundation Models)直接生成十萬對 LQ-HQ 配對資料,覆蓋更貼近日常的真實退化類型。

這個項目的核心想法是「讓高品質影像本身充當 Ground Truth(GT)」,再利用 MFM 推演對應的低品質版本,省去繁瑣的人工蒐集與標註。GGT-100K 並附帶 baseline 訓練程式碼與 checkpoint,研究者只需在自有的修復模型上加掛 LoRA 或重新微調,就能測試跨域泛化效果;對工程團隊而言,等於取得一條快速驗證真實世界表現的捷徑。

GGT-100K 重點摘要

  • 提供十萬對從 MFM 生成的 LQ-HQ 影像配對,涵蓋多元真實退化情境。
  • 內建 baseline 訓練與推論程式碼,支援主流修復模型微調。
  • 透過 Generative GT 策略,免除傳統人工蒐集配對的高昂成本。
  • 數據集可從 Hugging Face 或百度雲下載,附完整 Construction Process 說明。
  • 實驗結果顯示,模型在跨域真實退化測試中的泛化能力有明顯提升。

至於性能表現,作者在多個 SOTA(State-of-the-Art)MFM 上進行了修復評估,結果顯示加入 GGT-100K 訓練後,模型對未見過的真實退化樣本有更佳的適應力;具體的數值比較已收錄在 Experimental Results 區段與論文 arXiv 2605.31039 之中。如果你是從事影像修復、攝影 App 開發,或是想評估自家模型在真實世界表現的團隊,這份開源資源值得花時間一試。

GitHub: https://github.com/PolyU-VCLab/GGT-100K

項目: https://polyu-vclab.github.io/GGT-100K/

Categories: 開源, 香港理工大學, 模型, 視覺模型, 模型訓練, 影像處理, Dataset 數據集

用 PEEK 幫影片挑重點影格:省時又精準

PEEK 是一個無需文字查詢的影格挑選器,透過知識蒸餾從教師模型學習排序,在少量影格預算下大幅提升影片標題生成品質。

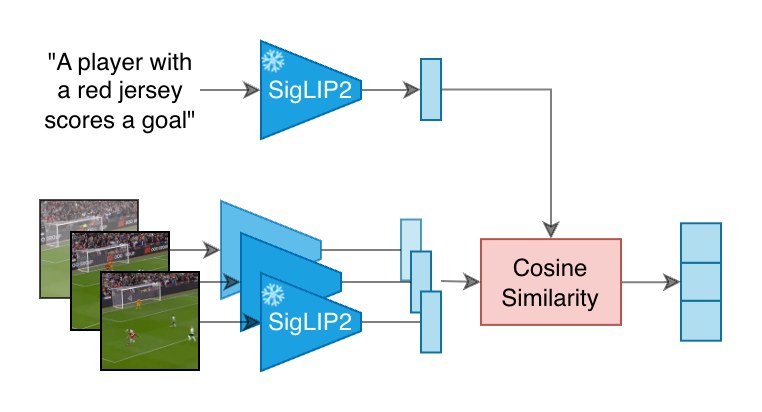
Stage 1: privileged teacher scoring

處理長影片時,視覺語言模型 (VLM) 一次只能看幾幀畫面,於是「要挑哪幾幀」就成了影片標題生成的瓶頸。PEEK 這個開源項目正是為了解決這個問題:它是一個 query-free 的影格挑選器,專為低預算 (low-budget) 影片標題任務而設計。

PEEK 的運作分為兩階段。第一階段由凍結的 SigLIP2 SO400M patch14 384 雙編碼器擔任教師模型,利用真實標題與每一幀計算餘弦相似度,並做最小最大正規化 (min-max normalization),產生幀級相關性分數。第二階段是一個 2 層 Transformer 學生模型,接收凍結的 MobileCLIP2-S0 幀嵌入,以 ListMLE 排序損失 (listwise ranking loss) 學習重現教師的排序。推論時學生模型只需看畫面,無需任何標題或文字編碼器介入。

選幀策略採用「分組取最大」(stratified argmax):將影片均分成 k 個時間區段,每段挑出分數最高的幀,以兼顧時間分佈。當 k=1 時則退化為全影片取最大。

實驗結果顯示,單一在 ActivityNet 訓練的 PEEK 權重在多個影片標題 VLM 上,於一幀與兩幀設定的 CIDEr 分數均優於均勻取樣,且預算越緊、省下的時間越多。論文亦報告 PEEK 在標題生成流程中僅增加 5.2% 時間,相比 CSTA 的 65.4% 與 MaxInfo 的 211.9% 更為輕量。

適合需要快速處理大量影片的研發團隊、影片摘要系統開發者,以及想為現有 VLM 加上智能取樣的研究者。倉庫已提供教師分數生成、蒸餾訓練、單段影片推論 CLI 與 Python API,並於 Hugging Face 釋出 ActivityNet 訓練的 base 權重。

重點摘要

  • 問題:VLM 處理影片時,如何在極少影格預算下挑出最有資訊量的畫面。
  • 方法:以 SigLIP2 為教師產生排序標籤,再以 MobileCLIP2 + 2 層 Transformer 學生模型做知識蒸餾 (knowledge distillation)。
  • 推論:無需文字查詢,僅靠視覺證據;採用 stratified argmax 兼顧時間覆蓋。
  • 效率:額外開銷僅約 5.2%,遠低於 CSTA 與 MaxInfo 等自適應方法。
  • 資源:開源訓練與推論代碼,並提供 Hugging Face 預訓練權重。

GitHub: https://github.com/momentslab/peek

項目: https://www.killian-steunou.com/peek/

Categories: 開源, 模型, 視覺模型, 模型訓練, 影像處理, 框架

MVCHead:少資源做高擬真 3D 頭像

MVCHead主打只靠2D圖片學出多視角一致的3D Gaussian頭像。對想降低3D人物製作門檻的人,這個項目相當有參考價值。

Teasor

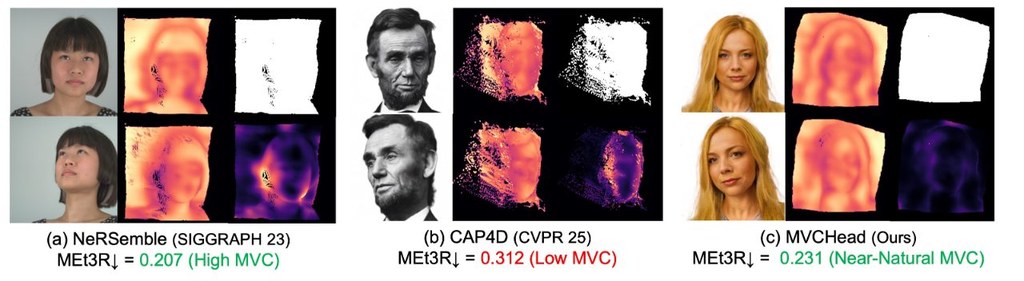
MVCHead 是一個聚焦 3D Gaussian head avatars 生成的研究項目,目標很清晰:不依賴 multi-view 資料、3D 掃描,甚至不需要中間視角生成,也能做出高擬真、multi-view consistent 的頭像。對非技術讀者來說,它想處理的問題就是:以往做這類 3D 人頭資產,通常要大量拍攝設備和昂貴流程,這個項目則希望用較少資源完成。

目前公開內容以論文與項目頁為主,程式碼、weights 及 FaceGS-10K dataset 仍標示為即將推出。現階段較適合先閱讀方法設計、觀察展示圖片與論文結果,了解它是否符合 AR/VR、telepresence、digital humans 或遊戲角色資產製作需求,再決定之後是否跟進測試。

它的核心做法,是用 single-shot state space model 直接在 3D 表徵裡約束 multi-view consistency,而不是先補中間視角。當中包含 Hierarchical State Space(HiSS)block、Hierarchical Bi-directional State Scan(HiBiSS),以及 SE(3) Multi-view Critic;前兩者負責由粗到細調整 3D Gaussians,後者則檢查不同自我渲染畫面是否像來自同一個 3D 結構。

  • 只需 randomly sampled 2D images,毋須 multi-view data 或 3D supervision
  • 生成重點放在 wrinkles、hair wisps、lip contours、eyes、accessories 等細節
  • 論文表示在 perceptual quality 屬 state-of-the-art
  • texture 與 geometric consistency 超越既有方法,shape consistency 則維持可比水平
  • 另提出 FaceGS-10K,作為大規模 3D Gaussian head assets 資料集

這個項目特別適合研究 3D 頭像生成、虛擬人、低資源內容製作流程的人留意。若你期待的是可立即部署的生產工具,現時資訊仍偏研究導向;但若你關心 3D head models 怎樣擺脫多視角拍攝依賴,MVCHead 展示的方向相當具前瞻性。

GitHub: https://github.com/humansensinglab/MVCHead

項目: https://humansensinglab.github.io/MVCHead/

Categories: 開源, 模型, 視覺模型, 世界模型

ViGeo:一個模型處理影片幾何重建

ViGeo把影片或單張畫面的幾何資訊一次估出來。對深度、法線、3D點與鏡頭位姿有興趣的人,這個項目很值得留意。

Repository image for aigc3d/ViGeo

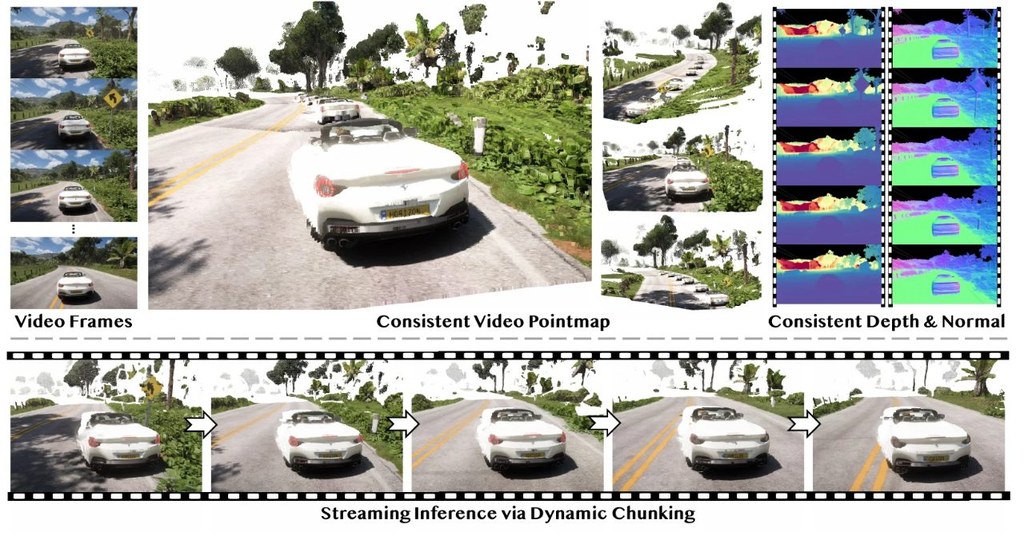
ViGeo 是一個用來估算場景幾何的項目,輸入可以是影片片段,也可以是單張影像。它會輸出 depth、3D points、normals、confidence,處理連續影格時亦可估算 camera poses,重點是盡量保持時間上的一致性,減少前後幀結果跳動。

使用這個項目時,先按手頭資料選擇模式:完整影片可用 offline,串流畫面可用 online,長影片則可分段用 chunk 處理。這種安排對做影片重建、機械人感知、AR、導航或後期視覺分析的人較實用,因為不需要為不同輸入形式換另一套模型。

它想解決的核心問題,是影片幾何估計常見的兩難:不是短片效果好但難以串流,就是能即時推理但長時間一致性不足。ViGeo 以同一個 feed-forward foundation model 統一 full-sequence reconstruction、streaming inference 與 long-video inference,論文指出關鍵在 dynamic chunking attention,讓模型可因應測試情境切換時間關注方式,而不用重新訓練。

另一個重要部分是 VideoLDCM,完整名稱是 VideoLDCM,負責 depth completion。它在這項工作中用作 data-refinement model,把稀疏或帶雜訊的深度觀測整理成較乾淨的 dense depth supervision,對訓練幾何模型有幫助,也解釋了為何這個項目不只看單幀品質,還強調跨影格穩定性。

  • 同時支援 offline、online、chunk 三種推理流程
  • 可由影片或單張影像估算 depth、3D points、normals 等結果
  • 以 dynamic chunking attention 兼顧串流與長影片處理
  • 結合 VideoLDCM 改善深度監督資料品質
  • 論文聲稱在多項 video geometry 任務達到 state-of-the-art
ModelDownloadDescription
ViGeoLINK用於深度、點、法線、姿態和置信度的主要視覺幾何模型
VideoLDCMLINK用於稀疏深度濾波、泊松補全和深度細化的資料細化模型

性能方面,論文描述它在 online、offline、long-video depth estimation、surface normal estimation、video point map estimation 都有很強表現,並以 public datasets 訓練。不過目前公開 checkpoint 亦已註明存在已知 loss implementation 問題,可能在 camera poses 視覺化與遠距區域出現輕微瑕疵,因此較適合先用來理解能力範圍,再決定是否放入要求很高的生產流程。

GitHub: https://github.com/aigc3d/ViGeo

項目: https://pkqbajng.github.io/ViGeo/

Categories: 開源, 阿里巴巴, 模型, 視覺模型, 世界模型

URM 自動駕駛點樣看見被遮擋風險

用統一風險地圖處理視線死角,幫自動駕駛在看不清環境時作出較穩妥判斷。

Hero image preview

這項研究由中國復旦大學提出,聚焦自動駕駛在部分可觀察環境中的難題:前方或路口被遮擋時,系統看不到潛在車輛或行人,但仍要提早規劃安全路線。現有方法通常走兩個方向,一類根據可到達狀態估算風險,往往過於保守;另一類用學習方法預測隱藏目標軌跡,但在高遮擋不確定性下未必夠準。

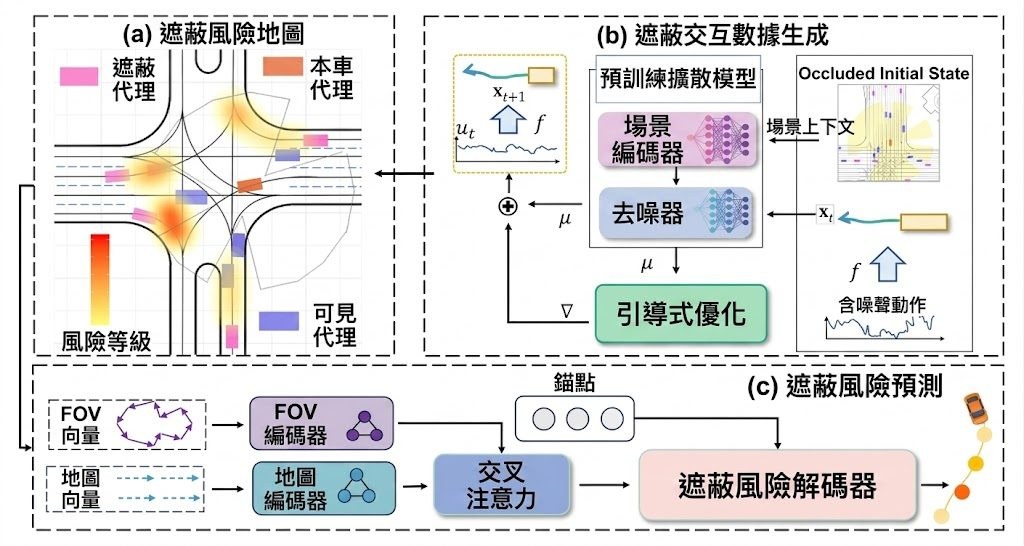
項目首先提出一個 URM (Unified Risk Map),把交通流風險與碰撞風險放入同一個時空框架建模。前者從 multimodal trajectory distributions 估算密度,後者則透過模擬 ego vehicle 軌跡,找出不同時間與位置的高風險區域,令系統不只知道「可能有東西」,亦知道「哪裏更危險」。

為了補足遮擋互動場景不足的問題,研究同時加入 diffusion-based scenario generation framework,生成既真實又帶挑戰性的情境,用來訓練 unified risk map。整體框架把風險建模、學習與規劃串連起來,目標是在 partial observability 下支援 risk-aware planning。

重點可概括為:
– 把 traffic flow risk 與 collision risk 合併成單一風險表示
– 針對 occlusion-aware prediction 的盲點,提供更細緻的時空風險判斷
– 用 diffusion-based scenario generation framework 製造稀缺的遮擋互動情境
– 在 Waymo Open Motion Dataset 上,較現有 occlusion-aware baseline 有明顯提升

這個方法在 Waymo Open Motion Dataset 上,把 minimum time-to-collision 改善 0.78 倍,average time-to-collision 改善 1.67 倍,顯示系統能更早避開高風險情況。這個項目較適合關注 autonomous driving、Planning under Uncertainty、Integrated Planning and Learning 的研究者與工程團隊;如果你想了解自動駕駛如何處理視線死角,這套方法提供了相當具體的方向。

Paper: https://arxiv.org/pdf/2605.22189

Categories: 開源, 視覺模型, 世界模型, 框架

EarlyTom 令影片理解模型跑得更快

EarlyTom 以免訓練方式減少影片推理時所需的視覺 token,重點是加快推理而盡量保住表現。對 Video-LLMs 使用場景尤其有參考價值。

earlytom logo

EarlyTom 是一個針對 Video Large Language Models(Video-LLMs)而設的 token 壓縮項目,目標很清晰:在不重新訓練模型的前提下,減少影片理解時要處理的視覺 token 數量。它主要處理推理速度慢、計算量高這個痛點,尤其是影片內容比圖片更長、更重,模型很容易在前段編碼就耗掉大量時間。

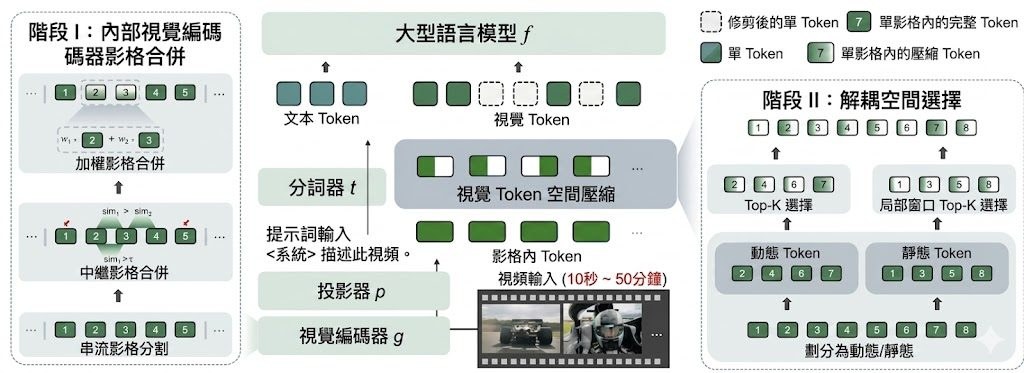
這個項目的核心想法,不是等資料全部進入模型後才壓縮,而是更早在 vision encoder 階段動手。EarlyTom 會利用早期 transformer layers 的 attention 訊號,先找出冗餘 token,再做裁剪;另有可選的 inner compression,會在 LLM backbone 指定層以 DPC-KNN 做 token 合併。這種早期壓縮方式,重點在於連 vision encoder 的負擔都一併減少。

使用上,項目是建基於 LLaVA-NeXT,並可包裝 LLaVA-OneVision 模型;程式層面是把已載入的模型再套用 EarlyTom。對已經在跑影片問答、影片描述或多模態理解流程的人來說,這代表可在原有模型管線上加入壓縮機制,而不一定要改動整個訓練流程。

  • 免訓練(training-free)壓縮,部署門檻相對較低
  • 分為 outer compression 與 optional 的 inner compression
  • 重點改善 Time-to-First-Token(TTFT)、throughput 與 FLOPs
  • 依賴早期 attention 訊號挑走冗餘視覺 token
  • 相關模型與框架包括 LLaVA-NeXT、LLaVA-OneVision、Qwen2

從公開資料看,作者以 lmms-eval 進行評測,並在論文內容提到會比較 MVBench、EgoSchema、LongVideoBench 與 VideoMME 等常見影片理解基準。結果描述顯示,它在維持接近 full-token 方法準確度的同時,TTFT 最多可降至 2.65×,亦有更高 throughput;不過不同模型大小、影片長度與硬件配置下,實際增益仍要分開看。

這個項目較適合已經使用 Video-LLMs 的研究者、工程團隊,或想在資源有限環境中提升影片理解效率的人。若你關心的是模型答得準之餘,也要更快開始輸出結果,EarlyTom 的價值就在於它把壓縮時機提早,直接針對最花時間的部分下手。

GitHub: https://github.com/viridisGreen/EarlyTom

項目: https://viridisgreen.github.io/EarlyTom/

Categories: 開源, 阿里巴巴, 視覺模型, 框架

YoCausal 用影片倒播測試模型因果感

YoCausal唔係教你生成影片,而係檢查模型有冇真正理解先後因果。它用真實影片倒播做基準,設計相當清晰。

YoCausal Logo

YoCausal 是一個用來評測 Video Diffusion Models(VDMs)嘅項目,核心問題好直接:模型見到一段影片時,究竟係理解事件因果,定只係記住畫面常見嘅時間模式。呢個項目用正播同倒播影片比較 denoising loss,若模型對正向影片分數更合理,代表它較能分辨自然因果關係。

它提出兩個關鍵指標:Reverse Surprise Index(RSI)同 Causality Cognition Index(CCI)。RSI 主要睇模型有幾多次偏好正向時間流;CCI 再進一步將「知道時間方向」同「真正理解因果」分開,避免只靠時間線索就被誤判為懂因果。

使用呢個項目時,重點唔係訓練新模型,而係替現有模型寫 evaluator,然後用指定資料集跑評測。項目亦提供 leaderboard 提交格式,會要求模型名稱、版本或 checkpoint、模型大小,以及 evaluation result JSON 檔案;若改動過預設設定或 preprocessing protocol,也要一併說明。

YoCausal: How Far is Video Generation from World Model? A Causality Perspective
  • 用真實世界影片倒播做 counterfactual,比純合成資料更貼近常見場景
  • 以 denoising loss 比較正播與倒播,測法清楚而且可擴充
  • RSI 測時間方向感知,CCI 嘗試拆出更接近因果理解嘅部分
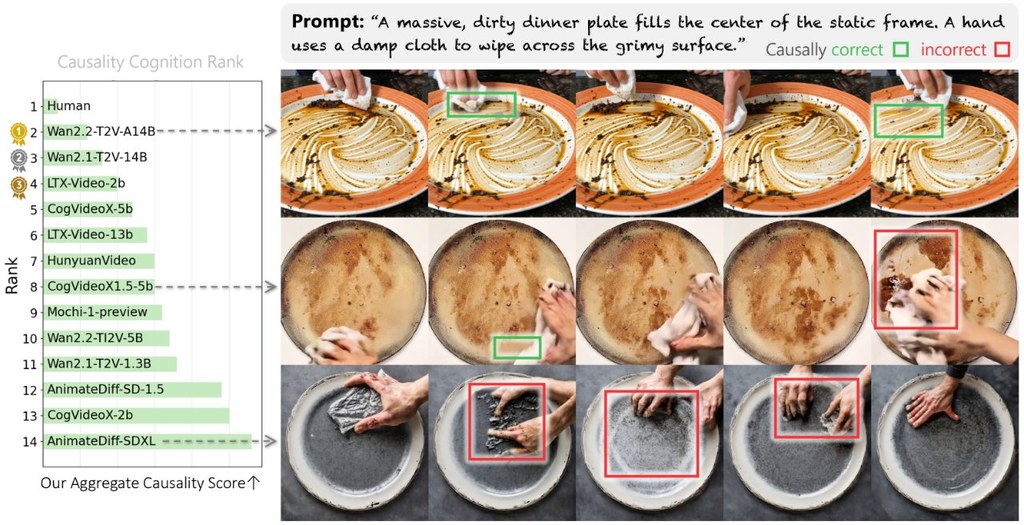
  • 已評測 13 個 state-of-the-art VDMs,結果顯示時間感知不等於因果理解
  • 文件提到 Wan Model Evaluation(DiffSynth-Studio),亦支援排行榜提交流程

由論文內容看,YoCausal 最大價值係指出一個常被忽略嘅落差:影片生成愈靚,唔代表愈接近 world model。評測結果顯示,即使係表現較前嘅模型,例如 Wan2.2-A14B,與 human baseline 之間似乎仍有明顯差距;中後段模型如 CogVideoX1.5-5B、AnimateDiff-SDXL 則較易出現違反因果嘅畫面變化。

呢個項目適合研究 Video Diffusion Models(VDMs)、world model、影片理解與生成評測嘅人,也適合想比較不同模型因果能力嘅團隊。對一般開發者而言,它最有用之處係提供一套較有解釋力嘅檢查方法,幫你知道模型失分係因為唔懂因果,定只係對時間方向反應不足。

GitHub: https://github.com/youzhe0305/YoCausal

項目: https://www.youzhexie.me/papers/YoCausal/index.html

Categories: 開源, 視覺模型, 世界模型, 框架, 3D

Page 14 of 20
1 12 13 14 15 16 20