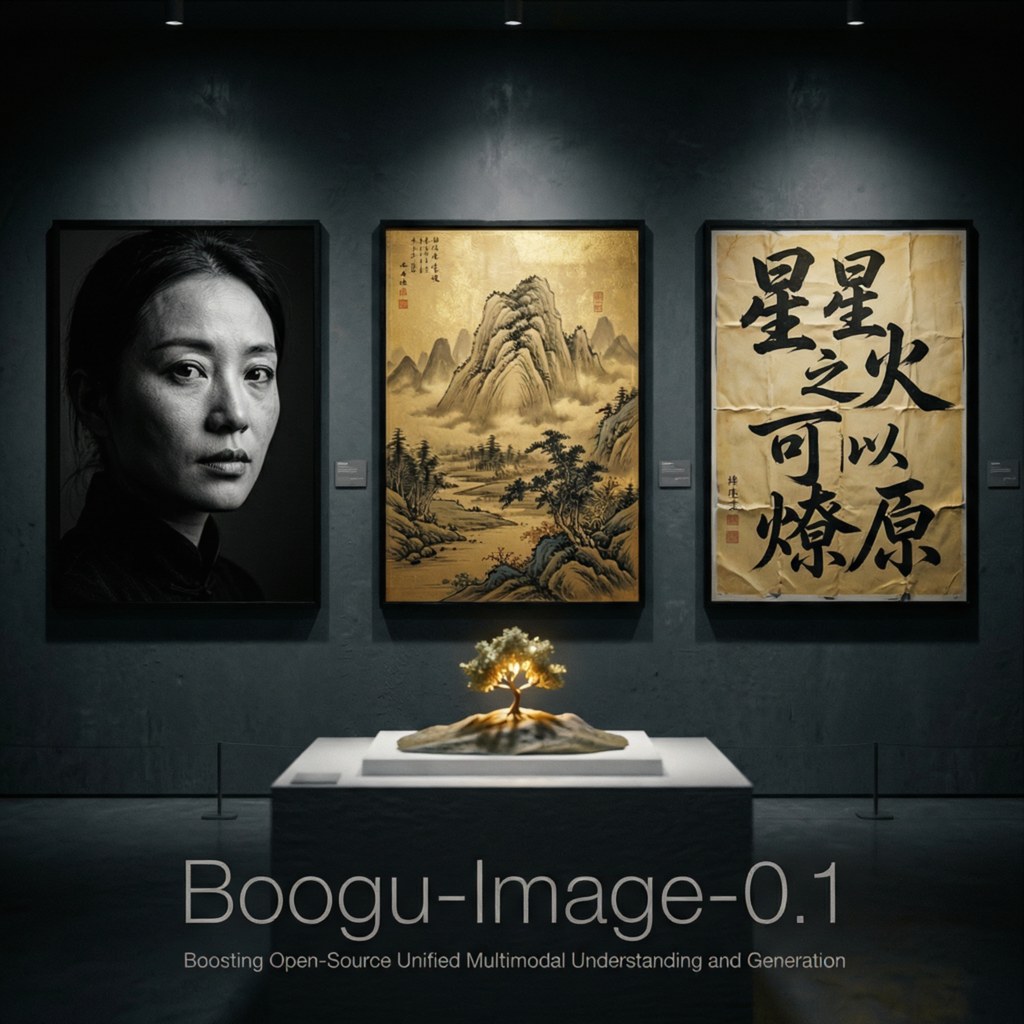
Boogu-Image-0.1 是一個統一式多模態圖像生成與編輯模型家族,重點不只是出圖,還想同時處理修圖、中英文字渲染與較複雜的提示理解。它實際想解決的,是開源模型常見的能力分散問題:生成一套、改圖一套、文字排版又另一套,最後很難維持一致表現。
項目現階段較適合用兩種方式理解:一是直接試官方 Demo,比較 Base、Turbo、Edit 三個版本的分工;二是到 Hugging Face 或 ModelScope 留意模型權重與部署資訊。項目團隊也明確表示這屬研究性質,並非完整商業服務,因此較像給開發者、研究者或內容製作團隊作能力驗證與流程測試。
它和同類開源做法的差異,在於把「理解提示、生成畫面、編輯內容、處理文字」放進同一條路線,而不是只追單一榜單分數。Boogu 亦強調,在訓練資源比封閉系統少很多、數據規模約小一個數量級的前提下,仍希望靠資料質素與訓練流程改善,追近 Nano Banana Pro、GPT-Image-2 一類整體型系統;這代表它的取向較重視整體實用性,而不只是某一項效果特別突出。
較容易受益的人,包括要做海報、商品視覺、雙語設計稿、指定風格插圖,或需要局部改圖的團隊。若你在意中文與英文文字能否穩定出現在圖中,這個項目的吸引力會比很多只擅長純畫面生成的模型更高;不過目前公開內容偏展示與定位說明,完整評測報告尚未見到,性能判斷仍要保留一點空間。
boogu-image:实测这个 10B 级 AI 大模型:不仅懂排版能写中文,局部编辑更是强得离谱!

- 相關模型包括:Base、Turbo、Edit,另有其他變體
- 支援文字轉圖、快速生成、圖像編輯、中英雙語文字渲染
- 強項集中在海報、文件介面、產品圖、風格化創作與局部文字修改
- 可先用官方 Demo 分別測試生成速度、畫質與編輯穩定性
- 目前較像研究型開源項目,商業級整合與長期維護情況仍要再觀察
GitHub: https://github.com/boogu-project/Boogu-Image
項目主頁: https://boogu.org/