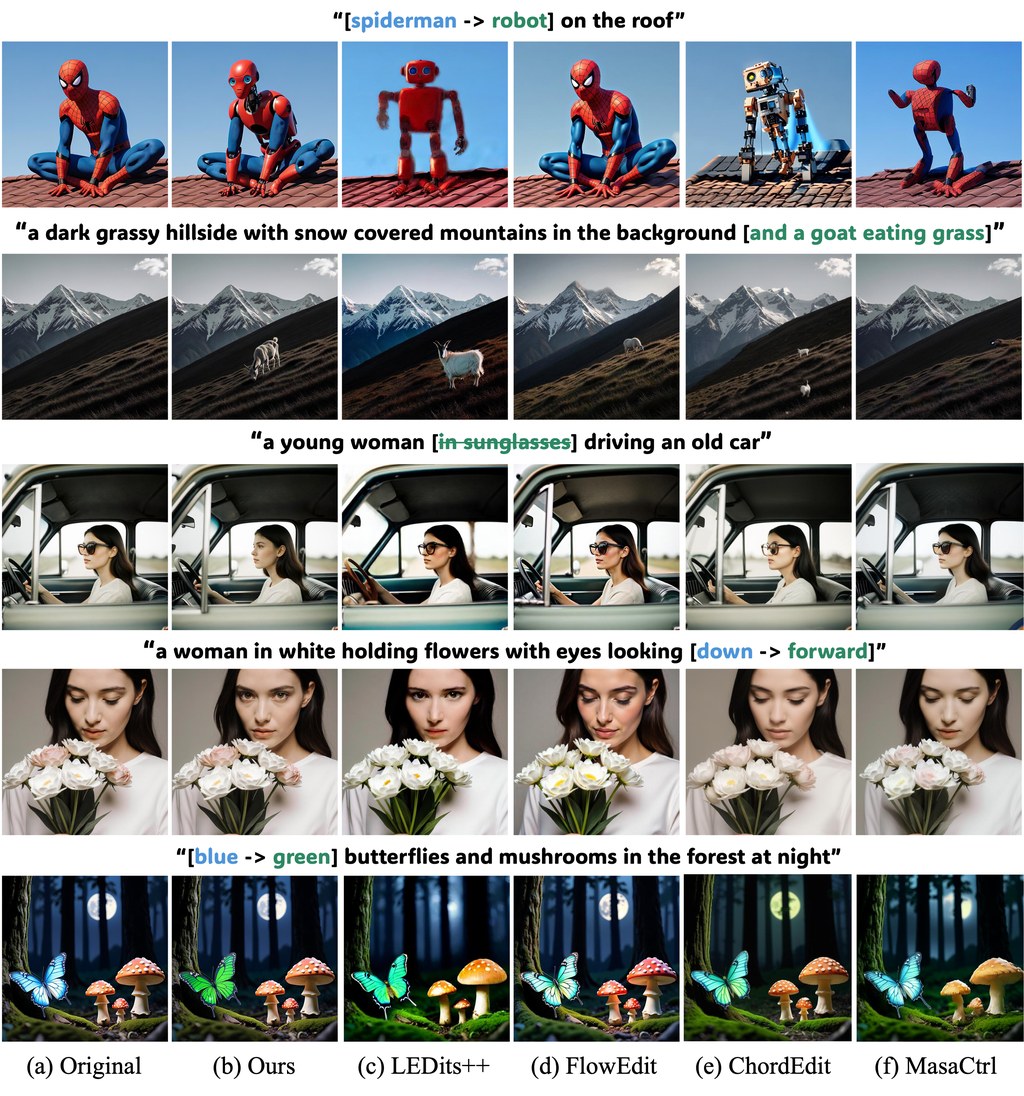
由 source prompt 改成 editing prompt 時,RefineEdit 會先生成來源圖,再重用中間 refinement state,讓 1024 × 1024 編輯結果較容易保留原有內容。這個項目屬於免訓練的 prompt-to-prompt 影像編輯方法,實際處理的是文字驅動編輯中「改變指定內容」與「維持畫面穩定」之間的取捨。
GRN 負責生成流程,HBQ tokenizer 和 UMT5 encoder 會一同載入;RefineEdit 本身沒有額外 checkpoint。source-anchored bit routing 先選出可編輯座標,再配合 adaptive spatial freezing(AdaSF)及 finite bit locking(FBL)限制後續變化,毋須外部 editing mask。
RefineEdit 需要 Linux、支援 BF16 的 CUDA GPU,以及官方 GRN 預訓練權重;A100 80 GB 是參考配置,項目並不適合低記憶體 GPU 或 CPU 推理。FlashAttention 2 可加速原始流程,未能安裝時可改用 PyTorch scaled dot-product attention,但速度、記憶體消耗和數值結果都可能不同。
- 不需額外訓練、RefineEdit checkpoint 或外部遮罩
- 只支援由提示詞內部生成的來源 refinement trajectory
- 不直接編輯任意真實圖片,應用範圍比一般照片編輯流程窄
- 附有 mask summary/step PNG 及 adaptive bit lock stats.csv,方便檢查座標選擇和鎖定狀態
它適合研究文字生成影像編輯、需要可重現實驗的團隊,以及已有 GRN 推理環境的開發者。儲存庫未提供統一 benchmark 數字,不能單靠 1024 × 1024 輸出判斷畫質;不同 attention backend 即使使用相同 seed,也不保證產生逐像素一致的結果。