MiniMax-H3-Motion-Director 全能導演台節點

ComfyUI 自訂節點 Motion Director 將 T2V、I2V、V2V 等多段生成整合到同一介面,支援分鏡重跑、跨鏡頭連貫與即時預覽,讓多片段 AI 影片製作不再被節點海淹沒。

MiniMax H3 Motion Director — Mixed Mode

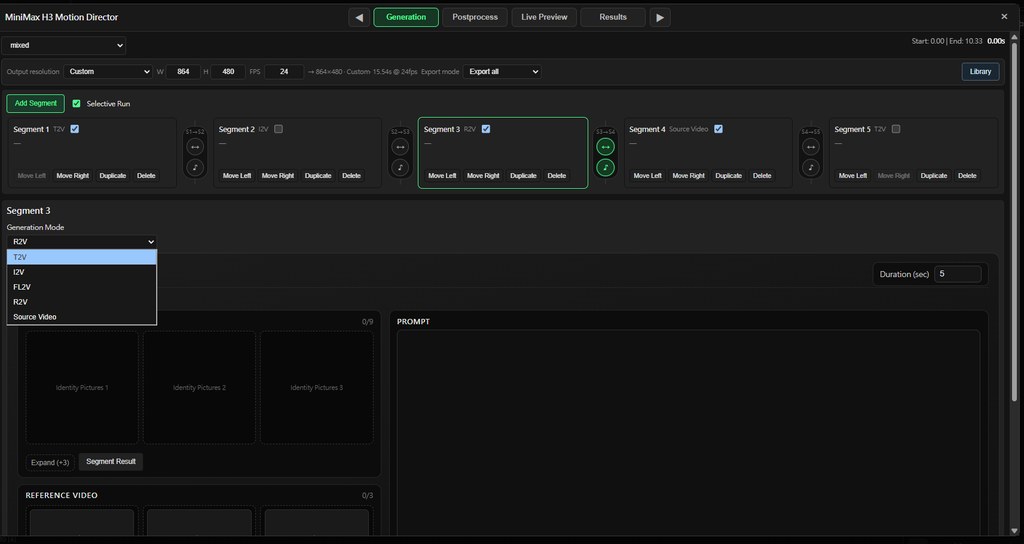
用 ComfyUI 砌 AI 影片嘅朋友,多數都經歷過呢個困局:想做一個有五個鏡頭嘅項目,要由零開始接 T2V、I2V、V2V 各種 workflow,每段調好參數再串埋,節點一多就連自己都搞唔清邊段行緊、邊段要重做。Motion Director 想處理嘅就係呢個問題——佢係一個 ComfyUI 自訂節點,把多段影片生成收納到同一個 Director 介面,等你可以逐段揀唔同生成方法(T2V / I2V / FL2V / R2V / V2V / RV2V),又唔使為咗切換而重新拉整個圖。

佢同一般 ComfyUI 工作流最大嘅分別,係圍繞「項目」做設計。Director 介面入面有 Segment、Multi Segment、Final Result 三層檢視,亦有 Director Live Preview 即時顯示邊段行緊、邊段做完。跨段連貫靠 Motion Context、Context Frames、Latent Scale Lock 同生成音訊接續,仲可以將上一段已解碼嘅幀直接當下一段嘅 I2V/FL2V 輸入,避免每次都重新生成首幀。素材方面提供 Common References 同持久化 Material Library,圖、音、影片、提示詞都可以重複用。

另一個貼地嘅設計係 Selective Run——只要揀要重做嘅片段就得,唔使成條 pipeline 重跑,配合 MIXED 模式用,可以幾段文生、幾段圖生、幾段源影片剪輯混埋做項目。Director 本身係 OUTPUT_NODE,最尾嗰格就可以輸出畫面、音訊同 FPS 畀下游 ComfyUI 節點繼續接。後製方面內置 Global Refine、放大、可揀 NVIDIA RTX VSR / Deblur 同 Face Refine,不過 VSR/Deblur 要相容 NVIDIA VFX runtime,Face Refine 要 UI 揀好對應 detector/SAM 路徑。

適合要處理多鏡頭、有分鏡表、要保持視覺同音訊一致嘅創作者,例如廣告原型、MV 概念、敘事短片預覽,或者要把源影片做局部 V2V/RV2V 修補嘅後期流程。生成方面支援內建 sampling 或外部 ComfyUI SAMPLER + SIGMAS,方便想自己控制 noise schedule 嘅人。版本去到 v1.2.0,採用 GPL-3.0;硬件門檻就睇你揀嘅功能——基本生成跟返 ComfyUI 一般配置,想用 VSR/Deblur 或大尺寸放大就要 NVIDIA 顯卡同對應 runtime。

重點摘要:

  • 多段整合 Director 介面:T2V/I2V/FL2V/R2V/V2V/RV2V 同一畫面揀,逐段切換唔使重拉 workflow
  • Selective Run + Mixed Mode:只重跑指定片段,唔使成條 pipeline 由頭嚟
  • 跨鏡頭連貫:Motion Context、Context Frames、Latent Scale Lock 同音訊接續,仲可以重用上一段解碼幀
  • 內建 Live Preview 與三層檢視:Director 介面直接睇 Segment/Multi Segment/Final Result
  • 後製選項齊全:Global Refine、放大、可選 RTX VSR/Deblur 與 Face Refine,對硬件有特定要求
GitHub

Categories: 開源, ComfyUI, AI productions, NVIDIA, Video, 框架, 庫, MiniMax

Semantica 用圖譜為 AI 決策加上可追溯證據

Semantica 把分散企業資料整理成 Context Graph 和知識圖譜,再為 AI 決策保留可審計的來龍去脈。對需要解釋原因、追查來源的團隊,這比單靠向量索引更實用。

Semantica

Semantica 是一個開源 Python 庫,做的是把企業資料整理成可查詢的 Context Graph 與 knowledge graph(KG),再把推理、決策與來源脈絡一併留下。它特別適合需要回答「AI 為何這樣判斷」的場景,因為每一步都能追到資料來源與處理過程。

它的做法不是只做檢索,而是先從零散資料抽取實體、關係和衝突資訊,再處理去重、譜系與本體管理,讓圖譜可直接承接 GraphRAG、因果推理和決策分析。官方也提到可自架,並支援 RDF 與 LPG,方便接入既有資料平台。

Semantica Platform Tour | Knowledge Graphs, Reasoning & Decision Intelligence

對 Databricks、Snowflake,或者受監管行業的資料與平台團隊,比把資料送去第三方 SaaS 更貼近實際要求。它不只服務 AI/ML platform teams,也照顧合規、風險和審計需求,因為 provenance 和 lineage 不是事後補寫,而是系統的一部分。

目前文件強調的是可解釋、可追溯與可自託管,並沒有把自己包裝成單純的模型套件。若團隊已經有 LangGraph、CrewAI 或 LlamaIndex,Semantica 比較像補上「上下文治理」與「決策證據」那一層,而不是取代原本的 LLM 流程。

  • 把碎片化資料轉成可查詢的 Context Graph 和 KG
  • 保留決策來源、譜系與審計軌跡
  • 支援 GraphRAG、因果推理與本體管理
  • 可自架,避免資料先送出企業邊界
  • 適合合規、風險與 AI 平台團隊

項目主頁 · GitHub

Categories: 開源, Agentic, KnowledgeGraph, LangGraph, Python, 庫

VoiceMem 讓語音 AI 記住你的情緒與偏好

VoiceMem 以流式雙腦架構處理事實記憶、情緒與人格,讓語音智能體在對話中更懂使用者,同時控制延遲與成本。

VoiceMem Logo

語音智能體要記住「我是素食者、對堅果過敏」,並不只是保存轉錄文字,還要分辨人物、情緒、偏好與性格。VoiceMem 屬於語音 AI 記憶引擎及可整合的庫,處理音訊輸入、記憶抽取、檢索和回應前的上下文注入,讓長期個人化對話不必每次重新建立背景。

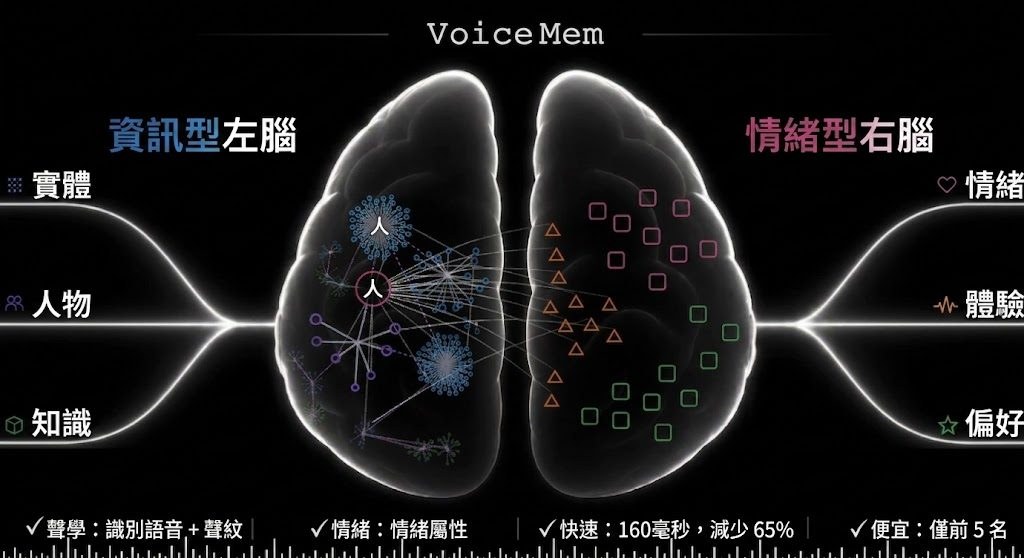
它採用 VoiceMem Dual-Brain Streaming Architecture(流式雙腦架構):左腦以 schema 與 entity 組織事實記憶,右腦獨立管理情緒、偏好和人格,亦維護跨 entity 的關聯。音訊仍在輸入期間,系統已經分段、轉錄、抽取資料並寫入記憶圖;查詢時先路由及排序,只把 Top-K 記憶放入上下文,減少語音回應需要處理的內容。

  • 左腦在 Top-3 限制下維持 Mem0 的滿載性能
  • 右腦加入長短期情緒歸因及交叉節點
  • 透過壓縮資訊、分層儲存和流式查詢降低等待時間
  • 單輪查詢約需 300 token,架構及底層記憶引擎可替換

VoiceMem 內置 ASR(Automatic Speech Recognition)、聲紋、場景、情緒感知及本地 embedding 元件,亦提供離線記憶引擎和 streaming interface。倉庫資訊包含 Python 庫、互動式網頁 demo、VoiceMem_Default_Models_Env 模型環境,以及可選的 Qwen 回應模型;但完整硬件要求、服務依賴和模型授權仍需按連結內容逐項確認,不能單靠 README 推斷。

ChatMem-400K 以記憶世界構建、SLM 驗證的 online on-policy distillation 和人工修訂三階段製作,配合 VoiceMem Model Families 的 Qwen3 6 35B A3B Qlora 模型系列。這令項目較適合需要長期語音陪伴、個人助理、客服或具情緒連續性的 voice agent 團隊;對只需短對話轉錄的工作流,雙腦記憶層會增加整合和維護成本。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 清華大學, Agentic, Embedding, 多模態模型, Qwen, Python, 庫, 語音

needle:14MB 本地工具模型,專攻結構化操作

Needle 2 把工具呼叫、裝置操作和結構化抽取收進單一 14MB 引擎,本地跑完整對話只需約 28MB RAM。它適合要低記憶體、離線部署又要輸出 JSON 的工作流。

Needle

Needle 2 屬於用於 tool calling 的小型模型,同時處理 device use 和 structured extraction。它把輸入文字轉成可直接接入工作流的結構化結果,適合在本地裝置、隔離網絡環境或資源很緊的情況下部署。

這個 Python package 提供 inference、LoRA fine-tuning 和 export,安裝後會先從 Hugging Face 下載一次 engine,再在本機快取,之後不再依賴網絡。開發者只要描述工具,模型就會按 schema 產生 JSON,並用 byte-level grammar 收窄輸出範圍,減少格式跑偏。

This 14MB AI Model Runs Locally — Needle 2 Explained

它和同類小模型的取捨很明確:45M 參數、單一 14MB binary,換來的是極低記憶體佔用和離線運行能力;官方測試也顯示,它會和 FunctionGemma 270M、LFM2.5 230M 及 Apple FM 互有勝負,但體積小得多。另一個做法是加入 confidence score,低於門檻就可以交回人工或上層流程處理。

  • 單一引擎打包,部署時不用分開管理權重檔
  • 以 JSON 與 schema 約束輸出,方便串接工具鏈
  • 支援大量工具目錄,但每輪只取 top five
  • 256-token sliding window 令記憶體維持在約 28MB
  • 適合離線裝置、邊緣設備和需要穩定結構輸出的團隊

GitHub · 模型

Categories: 開源, 模型, 模型訓練, Python, 庫, 蘋果

demystify-agent-skills:Agent Skills 點樣幫到代理,又會喺邊度失手

呢個研究項目唔係再做一個新 agent,而係拆解 Agent Skills 真正幫緊乜、又會喺邊一步開始失靈。這項目讓你會更易判斷技能封裝值唔值得放入自己嘅自動化流程。

Offline retrieval precision

當你想將一段成功經驗整理成可重用指引,最麻煩唔係有冇記錄,而係代理之後會唔會真係拎啱、用得啱。demystify-agent-skills 係一個研究型程式碼項目,圍繞 Agent Skills、Workflow Memory 同 raw trajectories 做受控比較,集中處理代理經驗應該點樣封裝,先至更有機會幫到後續任務。

佢吸引嘅地方不只是話「技能有用」,而係拆開幾層去驗證。相同來源經驗同相同目標任務之下,Skill 成功率有 61.9%,高過 Workflow Memory 嘅 55.9%,差距係 6.06 個百分點;但增益主要來自 procedural anchoring,佔 65.7%,唔係靠明示成功或失敗標籤去灌輸知識。

  • 同一批 agent trajectories 會被整理成 raw、Workflow Memory 同標準化 SKILL.md,再放返去同一類 target tasks 測試
  • retrieval、agent selection 同 real execution 係分開檢查,唔當成單一路徑
  • skill pool 由 5 增加到 100 時,embedding top-1 precision 由 88.3% 跌到 76.9%
  • parsed actual-use precision 會由 29.6% 進一步跌到 3.3%,但 downstream success 仍大致維持喺 36% 至 39%

「識得檢索」同「真係用對技能」原來係兩回事。項目指出 invocation 本身會帶來新失敗邊界:Skill 案例入面,有 10.0% 係誤用或者忽略技能指引,明顯高過 Raw 嘅 0.8% 同 Workflow Memory 嘅 0.4%。換句話講,技能格式改善咗執行穩定度,卻同時引入另一個決策風險。

呢個項目較適合研究 Agentic workflow、做 AI agent 評測,或者想建立可重用 skill library 嘅團隊重現。並非安裝一個即用產品,而係沿住 raw traces、matched artifacts、retrieval diagnostics 同 target task evaluation 去重跑實驗;對正在設計 Computer-use agents、CUAs 或其他多步代理流程嘅人,呢份分析比單看總成功率更有參考價值。

項目主頁 · GitHub

Categories: 開源, Agentic, Embedding, 庫, Skill 技能

HarnessEval-W 讓世界模型評測留下可核查推理鏈

世界模型評測不再只給一個分數,HarnessEval-W把每次判斷拆成可追溯的證據樹,讓物理與因果錯誤更容易核對。

HarnessEval logo

當世界模型生成一段互動場景,真正難判斷的往往不是畫面是否漂亮,而是物理、因果和世界狀態有沒有隨行動正確演變。HarnessEval-W 屬於開源的 agentified benchmark,實際處理的是如何把這些需要理解上下文的評測工作,轉化成可檢查、可重現的判斷流程。

它借用 Large Language Model(LLM)生態常見的 harness 思路,先按每個 evaluation case 的初始世界、action 和 probe intent 分解問題,再由具備不同工具與上下文的 specialized sub-agents 分工判斷,最後由 parent agent 驗證證據並整合 verdict。每次評測都會留下 evidence tree,記錄測試內容、視覺依據和完整推理鏈,研究團隊可以追查分數由何而來,而不是只接受一個難以解釋的 scalar score。

  • 支援 330 個 evaluation cases、5,940 次 scored rollouts
  • 以 11 個 specialized evaluation skills 覆蓋品質、轉換與持續性
  • 涵蓋 18 個 world models,並提供 leaderboard 與可執行評測程式
  • 包含 harnesseval-metrics,以及 physical-plausibility backend harnesseval-pavrm

HarnessEval-W 在 intentional transition 上與人類 Bradley–Terry ranking 的 Spearman correlation 為 0.93;physical transition 的 pairwise accuracy 達 71.7%,高於 WBench 的 31.9%。重複評測的結果範圍亦較 WBench 窄 4.9 倍,但這些數字仍取決於案例設計、技能路由和代理判斷品質,不能直接視為所有世界模型任務的通用排名。

項目提供固定 plans、benchmark 資源、metric backends 和可延伸的 skill library;團隊可以先重現既有 cases,再提交新世界、新 action、新 probe family 或新 skill。它較適合研究世界模型、建立可審計評測流程,或需要比較物理合理性與狀態持續性的團隊;對只想快速取得單一分數的測試流程而言,完整證據樹會增加運算與整合成本,但換來更清楚的錯誤定位能力。

項目主頁 · GitHub

Categories: 開源, 北京大學, Agentic, 世界模型, 庫, Dataset 數據集, Skill 技能

dembrandt:把網站風格秒轉成可追蹤的設計 tokens

Dembrandt 直接把網站的 logo、色彩、字體和間距抽成 design tokens,方便你在 AI 工具或 CI 裡持續比對變化。它不只做擷取,還把每次改版的風格漂移記錄下來。

Dembrandt: Any website to design tokens

Dembrandt 係一個用來抽取網站設計系統嘅工具,重點係將 logo、色彩、字體、邊框、陰影等視覺元素整理成 design tokens,方便團隊快速理解一個網站嘅視覺規則。對做前端、設計系統或者品牌一致性檢查嘅人嚟講,佢可以省去逐頁抄資料嘅時間。

使用時要先準備 Chromium,因為它透過 Playwright 核心去驅動瀏覽器,唔裝 browser binaries 就冇得啟動。安裝後可以用 CLI 直接抽取,亦可以透過 MCP 接入 Claude Code、Cursor 或 Windsurf,令 AI 助手幫你讀出 tokens。

同類工具多數只做一次性擷取,Dembrandt 加入咗漂移追蹤同快照時間線,令你可以比較兩次發佈、兩個網站,或者同一個 domain 喺唔同時間嘅變化。佢仲提供視覺差異、分類分數同 baseline 比對,對 CI 監察改版影響特別有用。

  • 可把網站外觀整理成可重用嘅 design tokens
  • 需要先安裝對應 Chromium,否則無法運行
  • 支援 MCP,方便接入 AI 編程工作流
  • 可以記錄快照,持續追蹤設計漂移
  • 適合前端、設計系統同品牌檢查工作

如果團隊要維持多個頁面或多次發布之間嘅視覺一致性,呢個工具比單次擷取更有用。它將抽取、比較同追蹤放埋一齊,令設計變化唔容易悄悄走樣。

GitHub

Categories: 開源, MCP, IDE, 庫

NVIDIA Nemotron 3.5 Lightning:專為長期運行 Agent 而生的輕量 MoE 模型

AI Agent 大部分時間都在做工具呼叫、結果驗證等高頻次執行,而非高階推理。Nemotron 3.5 Lightning 以 30B MoE 架構瞄準這個執行層,速度比同級模型快 4 倍。

Og image

長期運行的 AI Agent 真正花時間的地方,往往不是規劃,而是工具呼叫、結果驗證、子代理分派這些高頻次的執行步驟。每一個小動作都用頂級推理模型去跑,會帶來明顯的成本與延遲壓力。NVIDIA 推出的 Nemotron 3.5 Lightning 就是針對這個「執行層」設計的開放模型,採用 30B 參數的 Mixture-of-Experts(MoE)架構,但每次只啟動 3B 參數,在維持效率的同時兼顧準確度。

與坊間常見做法不同,Nemotron 3.5 Lightning 並非要取代大型推理模型,而是與之分工——前者處理高頻執行,後者專注規劃與複雜推理。模型本身針對 agent harness(如 OpenClaw、Hermes Agent)做了訓練優化,並提供 speculative decoding、NVFP4 與 BF16 量化版本,宣稱輸出速度比同級模型快 4 倍。這對需要長時間在線、隨時待命的 Agent 來說,省下的不只是金錢,還有回應時間。

Nemotron Lightning - NVIDIA's Super Fast Agent MoE

NVIDIA 同時推出 NeMo Switchyard,一個負責任務分派的路由函式庫,能根據任務類型自動挑選最合適的模型。整個 Nemotron 系列定位有點像「模型版的軟件庫」,每次發佈都在累積可組合的元件。對於需要自己掌控成本與效能的開發團隊,這套組合提供了相當完整的權重、數據與訓練配方,加上寬鬆的開源授權,方便做深度客製化。

  • 專注 Agent 執行層:30B MoE 架構、3B 活躍參數,設計目標是高頻低延遲的工具呼叫與驗證。
  • 速度與成本取捨:相比同級模型,輸出速度提升達 4 倍,搭配 NVFP4 量化可在本地硬件運行。
  • 分層協作模式:與 Nemotron 3 Ultra 等大型推理模型分工,由 NeMo Switchyard 負責智能路由。
  • 完整開源:權重、訓練數據與配方一併釋出,授權寬鬆,方便客製與整合。
  • 生態整合:對應 NemoClaw 安全管理開源方案,支援 OpenClaw、Hermes Agent 等長期運行框架。

項目主頁

Categories: 開源, Agentic, 模型, NVIDIA, 軟件, 庫, 安全, OpenClaw

round-trip-consistency:雙向 diffusion 幫長序列預測錯誤

遇上長步數 rollout,最難不是生成下一步,而是知道幾時開始唔可信。round-trip-consistency 用一次來回推演,直接估計模型當下誤差。

Bidirectional round-trip consistency overview

長序列 rollout 最棘手的位,在於錯誤會一路累積,但部署之後偏偏冇真值可以對照。round-trip-consistency 針對的正正是呢個缺口:它屬於一個研究型模型項目,用單一 conditional latent diffusion model 同時向前、向後推演 dynamical system,然後用來回一次嘅落點差距 round-trip consistency 當成自監督誤差訊號,判斷當前預測仲值唔值得信。

相比靠 ensemble、外部觀測、保留測試資料,甚至依賴 governing equations 去估可信度,呢個做法嘅取捨幾直接:代價係多做一次反向 rollout,換來唔需要額外真值。模型關係亦唔複雜,高維輸入先經 VAE 壓到 latent space,再由同一個 bidirectional latent diffusion model 配合 direction flag 做 forward 或 backward rollout,所以 backward 不只是檢查工具,亦順手變成 inverse solver。

現有資料已經講清楚它較適合點樣理解和測試:重點唔係即裝即用嘅應用介面,而係跟隨論文與程式碼重現 rollout、計算 C_i(Confidence Interval),再觀察它同真實 rollout error 嘅關係。對做科學模擬、時序生成、物理場預測,或者想為 autoregressive generative model 加一層 test-time trust signal 嘅研究團隊,呢類方法比單純看步數深度更有參考價值。

  • 用 forward 再 backward 嘅差距作為無需量測嘅 test-time error signal
  • 同一個 bidirectional diffusion model 包辦雙方向推演,訓練成本冇因雙向設計而上升
  • 在 MHD、turbulent Navier-Stokes 同 CelebV-HQ 呢類資料上驗證,覆蓋物理場與影像序列
  • 可用來做 error ranking、OOD flags 同 selective prediction,而唔止係生成結果本身

結果 C_i 在 held-out MHD trajectory 與 rollout error 有高相關,固定深度下 Spearman 可達 0.91 至 0.98;面對 out-of-distribution 的 Orszag-Tang vortex,AUROC 達 0.98,到 depth 10 去到 1.0。它亦能在 80% coverage 下將 incurred error 降低 15%,而在 LE-PDE-UQ 的 benchmark,一個 bidirectional model 已接近十模型 ensemble 嘅水位,訓練成本只係十分之一。不過呢個項目仍然偏研究原型,價值最大嘅場景係替長 rollout 模型補上「幾時應該停、幾時可以信」呢個判斷層,而唔係即時提供完整產品化流程。

項目主頁 · GitHub

Categories: 開源, World-Action Model, 庫, Dataset 數據集

ComfyTV 把 ComfyUI 拉進完整媒體工作流

想用 ComfyUI 做圖、剪片同整理素材,通常要在多個介面之間跳來跳去。ComfyTV 把這些步驟收進同一個畫布,重點不只生成,仲包括挑選、編修同輸出。

ComfyTV canvas overview

做生成內容唔少人最怕流程一長就難改、難追版本,ComfyTV 針對的正是這個卡位。它屬於建基於 ComfyUI 的畫布式媒體工作台,將生成、挑圖、編輯、合成到輸出串成同一條流程,處理範圍橫跨 image、video、audio、music、panorama、2D layers 同 3D,而唔係停留喺單次出圖。

跟一般要靠 ComfyUI 全域 queue 推整條鏈不同,ComfyTV 採用 per-node run,每個 stage 可以獨立重跑,下游只會接住上游最近一次輸出的 snapshot。這種做法減少反覆測一小步時牽動全流程的等待,代價是你要更清楚每個節點當下吃的是哪個版本輸出,但對長流程調整明顯更順手。

它的另一個重點是以項目為中心管理素材與歷史。每個 stage 都掛在同一個項目內,輸出會連同歷史保留,重新載入後可還原;再加上 asset library、resource library 同 prompt fragments,可直接在提示詞用 @ 引用。README 亦提到可匯入任何 ComfyUI workflow JSON,在側邊欄綁定輸入、保存 stage preset,並透過 Bridge nodes 接第三方插件,甚至登記遠端 ComfyUI 機器做 runner。

內容深度比一般前端殼再走前一步,現時提供約 190 個 stages,而且不少節點內置真正編輯器,例如 layer editor、storyboard workbench、piano rolls、3D viewports 同 scopes,部分 video effects 亦有 live preview。2D 編輯一段還延伸到 PSD import/export、Fountain script import 這類偏製作流程的功能,顯示它瞄準的是需要持續迭代的創作項目,而唔係一次性玩效果。

  • 把 ComfyUI 擴展成完整媒體工作台,覆蓋生成、編修、合成與輸出
  • per-node run 減少重跑整條流程的等待,適合長鏈路反覆微調
  • 以項目保存 stage 歷史、素材與資源,較方便追版本同回復狀態
  • 可匯入 ComfyUI workflow JSON,兼容 subgraphs、第三方 plugins 同遠端 runners
  • 約 190 個 stages,加上節點內編輯器,定位比純工作流編排器更完整

它依賴你現有的 ComfyUI 生態與本地模型,較像建在 ComfyUI 之上的創作界面層,而唔係獨立模型服務。適合已經有一批 workflows、想將 image、video、audio 放入同一項目管理的團隊或創作者;純粹只求最快出一張圖的人,未必需要它這麼重的工作台結構。

GitHub

Categories: 開源, ComfyUI, Video, Image, Audio, 3D, 庫

Page 12 of 17
1 … 10 11 12 13 14 … 17