一張平面圖變出 3D 房間?看懂 Code-as-Room

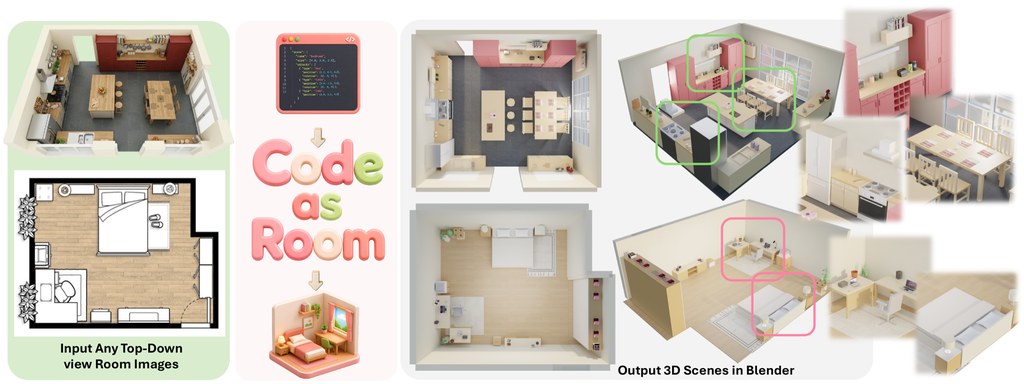
Code-as-Room 嘗試把單張俯視圖轉成可執行的 Blender 場景程式。概念清晰,特別適合關注 3D 自動生成的人留意。

Code-as-Room teaser

Code-as-Room 想處理的核心問題很直接:只靠一張房間俯視圖,怎樣較有系統地重建出可用的 3D 室內場景。它不是單純輸出一張效果圖,而是進一步產生 Blender 可執行程式碼,連同幾何、材質和燈光一併描述,方向相當實際。

現時公開資訊顯示,這個框架以多模態大型模型作為核心,並採用分階段流程,先理解房內物件與相對位置,再把結果整理成結構化程式表示。這種做法的特別之處,在於把「看圖生成」和「可重現的 3D 腳本」接起來,對後續修改、除錯和重用都更有幫助。

實際使用層面上,現時程式碼尚未正式釋出,所以比較適合先把它當成研究方向觀察。已經使用 Blender、關注室內建模、自動生成內容,或者想研究 AI 代理如何拆解複雜空間任務的人,可以先看論文與示例頁面,理解它如何由影像分析一路走到場景合成。

  • 由單張俯視圖推斷房間內物件與空間關係
  • 輸出重點不是圖片,而是 Blender 可執行程式碼
  • 採用多階段流程,處理幾何、材質與燈光
  • 適合 3D 內容生成、室內設計研究與代理式 AI 工作流

從相關技術脈絡看,它屬於 MLLM、agentic framework、scene understanding、code synthesis 與 Blender-based 3D generation 的交界。若之後開源內容完整,這類方法有機會成為由 2D 圖像快速建立可編輯 3D 房間的一種新工具;不過在未正式釋出前,效果細節與部署門檻仍要保守看待。
GitHub: https://github.com/YxuanAr/Code-as-Room

Paper: https://arxiv.org/pdf/2605.18451

Categories: 開源, 上海人工智慧實驗室

CM-EVS:用更少視角看完整個場景

CM-EVS 用較少全景畫面覆蓋更多室內場景,重點在挑選視角而非盲目多拍。對做 3D 資料整理的人特別實用。

Repository image for Strange-animalss/CM-EVS

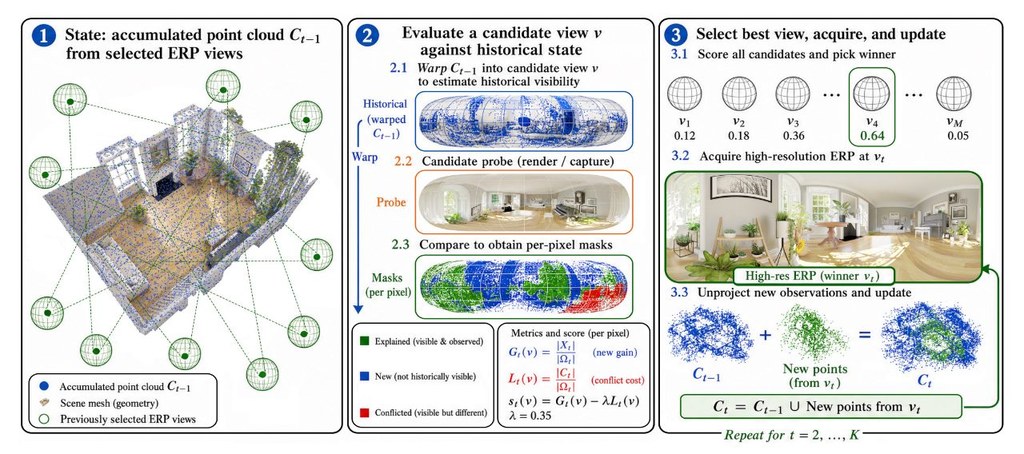
CM-EVS 係一個為 3D 場景整理全景 RGB、深度同姿態資料嘅流程工具,重點唔係不停輸出更多畫面,而係用較少但更有代表性嘅視角,盡量覆蓋完整場景。對需要建立訓練資料、檢查場景覆蓋度,或者整理室內空間視圖嘅工作,方向相當清晰。

實際使用時,較穩陣嘅做法係先由 Blender 室內場景路線開始,之後再按需要接 HM3D、一般 GLB 或 ScanNet++ PLY 這類來源。流程大致分成三步:先產生候選視角,再從中揀選衝突較低嘅視角組合,最後輸出已選畫面與相關記錄,方便重現結果同做後續核對。

呢個專案特別之處,在於佢唔單止計算「邊個視角睇到最多」,仲會考慮視角之間是否過分重疊,避免揀出一堆內容相似嘅畫面。對建立稀疏但有效嘅資料集尤其重要,因為畫面數量少啲,後續儲存、檢查同訓練成本通常都更易控制。

  • 支援統一資料格式,涵蓋 ERP RGB、range-depth 同 pose
  • 可處理多種來源,包括 Blender、HM3D/GLB、ScanNet++/PLY
  • 會輸出候選視角、逐步紀錄同已選結果,方便重做與比對
  • 核心模組拆分得較細,例如投影、深度與變形部分可獨立替換

適合對象包括做 3D 視覺、機械人感知、場景重建,或者要整理研究資料集嘅團隊。文中提到嘅相關資料來源與場景類型,主要有 Blender indoor、HM3D、generic GLB、ScanNet++,亦提及可延伸到戶外來源;不過從公開資訊睇,Blender 室內路線仍然係最建議先試嘅入口。

GitHub: https://github.com/Strange-animalss/CM-EVS

Paper: https://arxiv.org/pdf/2605.15597

Categories: 開源, 香港科技大學, 影像處理, 中國

Flash-GRPO:影片生成訓練再提速

這個專案聚焦影片擴散模型對齊訓練,用更省資源的方法換來更快效率。對研究型團隊尤其值得留意。

LOGO

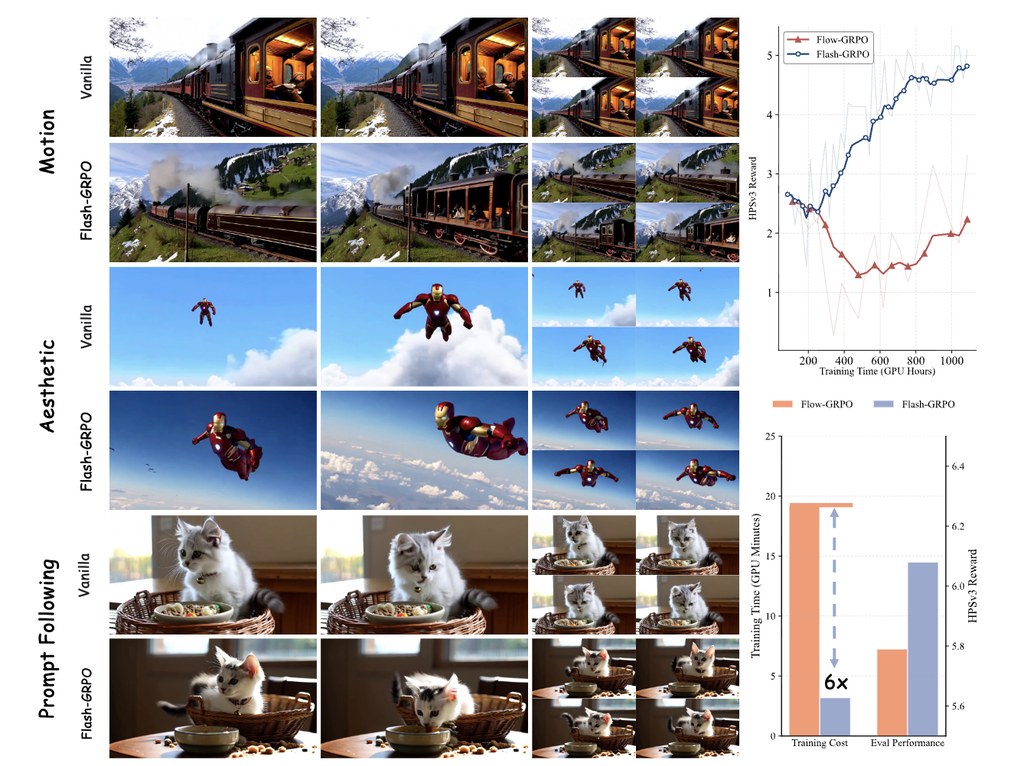
Flash-GRPO 針對的是影片生成模型訓練中一個很實際的難題:要令模型更貼近人類偏好或評分標準,傳統做法往往要走完整訓練軌跡,計算量高、時間長,對硬件要求亦相當重。這個專案提出單步式優化框架,重點是用較低運算預算,換取更有效率的對齊效果。

從公開資料來看,它主要面向影片擴散模型,並配合獎勵模型一同使用。實際動手時,需要先準備基礎模型 Wan2.1-1.3B,以及 README 提到的 HPSv3 獎勵模型,再按專案提供的訓練流程啟動;現階段較適合已熟悉 Python、分散式訓練和 GPU 環境的人直接試跑。

這個方法較有意思的地方,在於它不只是「少做步驟」,而是嘗試處理時間步之間訓練訊號不穩定的問題。README 提到兩個核心設計:一個是維持同一提示詞在時間上的一致性分組,另一個是修正不同時間步梯度尺度不一致的情況,目標是令訓練更穩定,也更容易比較模型表現。

  • 主打影片擴散模型的對齊訓練,而非一般文字模型微調
  • 強調單步式策略優化,方向上比完整軌跡訓練更省資源
  • 已在 1.3B 到 14B 規模模型做實驗驗證
  • 相關基礎組件,包括 Wan2.1-1.3B 與 HPSv3

整體來說,Flash-GRPO 比較適合做生成式 AI 研究、影片模型訓練優化,或想評估低成本對齊方案的團隊。對一般用家而言,它不是即裝即用的成品;但對需要在有限 GPU 預算下提升訓練效率的人,這個專案展示了一條相當值得關注的技術路線。

GitHub: https://github.com/Shredded-Pork/Flash-GRPO

Paper: https://arxiv.org/pdf/2605.15980

Categories: 開源, 清華大學, 影像模型, 中國

InsightTok:令生圖文字人臉更清晰

這個專案專注改善生成圖片中最易失真的文字與人臉細節。對已有自回歸生圖流程的人來說,特別有參考價值。

Method

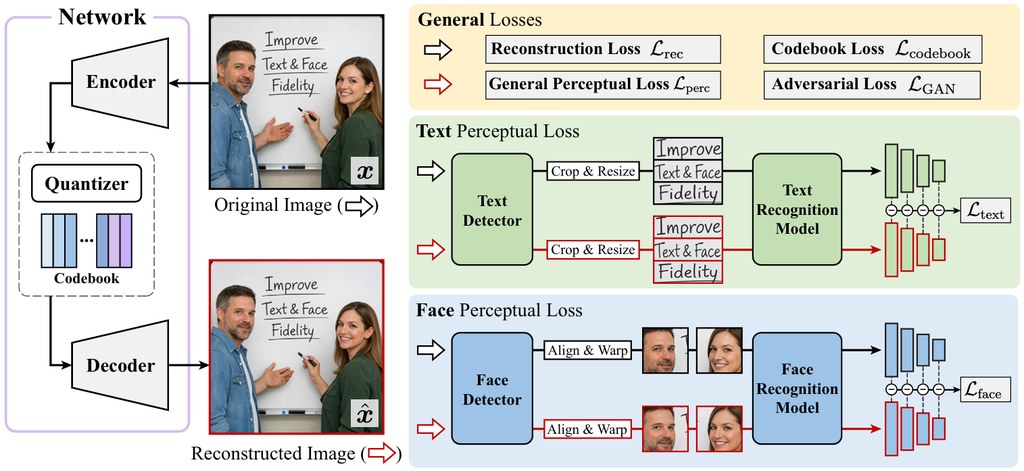
生成圖片時,最常令人出戲的往往不是背景,而是招牌上的字、海報上的字句,或者人臉五官的細節。InsightTok 針對的正正是這兩個難位:它不是直接改整個生圖模型,而是先改善圖片被「拆解成代碼」的方式,讓後續生成時更易保留重要內容。

實際使用上,這類專案較適合已經在做文字生成圖片、研究離散視覺 tokenization,或使用自回歸圖像生成流程的開發者與研究者。重點在於把原有流程中的視覺 tokenizer 換成 InsightTok 這一類方案,後面的生成模型理論上毋須大改,對現有管線算是較容易接入。

它的特別之處,在於沒有只用一般重建目標,而是更有意識地照顧局部而且重要的內容,例如文字區域與人臉區域。根據儲存庫提供的說明,它在相同壓縮率下,能做到更好的文字與人臉重建,同時只用 16× downsampling 和 16,384 個條目的 codebook,額外訓練成本亦相對有限。

  • 主要改善圖片中的文字可讀性與人臉細節還原
  • 可兼容標準自回歸圖像生成流程,毋須連下游模型一併重寫
  • 在相同壓縮條件下,重建效果主打更清晰、更忠於原圖
  • 設計上延續 VQGAN 風格 tokenizer 思路,但加強重點區域 supervision
  • 相關脈絡包括離散視覺 tokenizer、VQGAN 風格方法,以及文字生成圖片模型

整體來看,InsightTok 吸引之處不在花巧功能,而在於它抓到生圖最常被批評的痛點,再用相對務實的方法補強。對一般讀者來說,可以把它理解成一個「令 AI 更識得保住字同樣貌」的底層零件;對技術團隊而言,它較像是一個可直接提升畫面可用性的基礎組件。

GitHub: https://github.com/LeapLabTHU/InsightTok

Paper: https://arxiv.org/pdf/2605.14333

Categories: 開源, 清華大學, 視覺模型, 視頻模型, 微軟, 中國

CiteVQA

答啱問題未必代表可信。CiteVQA專門檢查模型有冇引用到真正證據位置。

CiteVQA overview

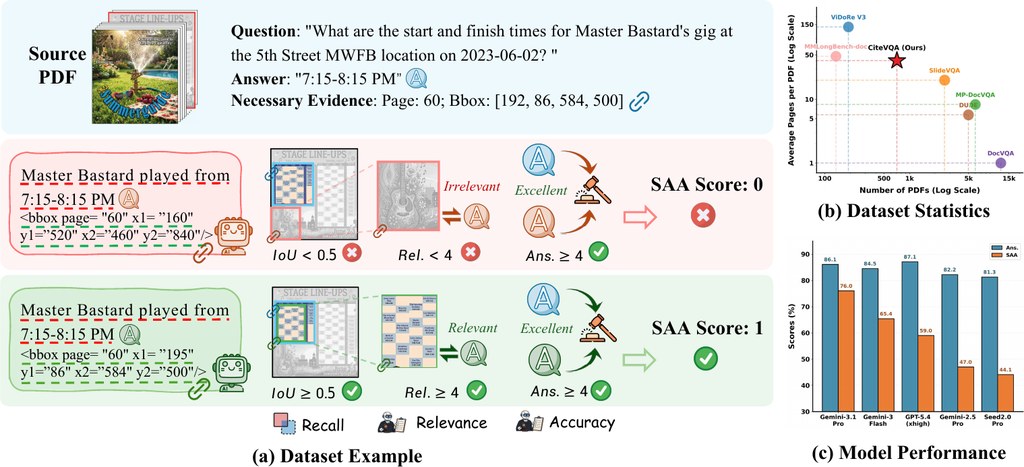
做文件問答評測時,很多工具只睇最後答案啱唔啱,但現實上,尤其是合約、財務報告、醫療文件呢類長篇 PDF,真正重要的是「答案來自邊一頁、邊一段、邊個區塊」。CiteVQA 針對的正正是這個缺口:它不只要求系統回答問題,仲要指出支撐答案的文件位置,而且細到元素層級,例如頁碼同區域框選。對想評估文件 AI 是否可靠的人來講,這比單純比拼答題分數實用得多。

實際使用上,這個專案較適合作為評測基準,而唔係一般用家即開即用的聊天工具。研究團隊、產品開發者或企業內部做文件自動化測試時,可以先取得資料集,再用自己的多模態模型跑推論,之後交畀評估程式比對答案與引用位置是否同樣正確。資料涵蓋英文與中文文件,來自 711 份 PDF、共 1,897 條問題,平均每份文件超過 40 頁,亦分成單一文件問答,以及要在多份文件中找答案的情境,難度相當貼近真實工作流程。

這個專案最值得留意的地方,是它把「答對」與「引對證據」綁埋一齊計分。核心指標 SAA 只有在答案正確,而且引用區域同標準證據對得上時先會得分,能更直接揭示模型有冇出現「講得似乎合理,但引用錯地方」的情況。根據公開結果,即使是表現較強的模型,答案分數與這種嚴格分數之間仍有明顯差距,反映現時不少系統其實未真正做到可追溯。這一點對高風險場景尤其重要,因為用戶要的不只是結論,仲要查得到根據。

重點可簡單整理成以下幾點:
– 不只評分答案,亦檢查引用證據是否真係來自正確頁面與區域
– 文件夠長亦夠真實,涵蓋 7 個大類領域、30 個細分類,並支援中英文
– 場景設計多樣,包括單文件、多文件但只有一份正確來源,以及多份來源都可能成立
– 適合測試文件型多模態模型,特別係要處理 PDF 版面、圖文混合與跨頁搜尋的系統
– 可用來比較模型可靠度,而唔係只比較誰的答案最似正解

從模型觀察角度看,這個基準亦提供了不錯的參考名單。公開結果提到的相關模型包括 Gemini-3.1-Pro-Preview、Gemini-3-Flash-Preview、GPT-5.4、Gemini-2.5-Pro、Seed2.0-Pro、GPT-5.2、Qwen3.6-Plus、GLM-5V-Turbo、Qwen3-VL-235B-A22B、Gemma-4-31B、Kimi-K2.5、Qwen3.5-397B-A17B 等。由這些結果可見,封閉模型在整體表現上暫時較領先,但開源模型同樣能作為對照組,方便團隊用統一方式測試自家方案。對要建立文件審核、知識搜尋、報告核對、法規查證流程的人來說,CiteVQA 的價值不在於幫你直接產生答案,而在於幫你分辨:哪個模型,才真係值得信。

GitHub: https://github.com/opendatalab/CiteVQA

Paper: https://arxiv.org/pdf/2605.12882

Categories: 開源, 上海人工智慧實驗室, Agentic, 中國

PhysBrain-VLA:教機械人先懂物理常識

全球首個物理智能數據引擎,將海量人類視頻轉化為多模態大模型訓練數據

Repository image for Phys-Brain/PhysBrain-VLA

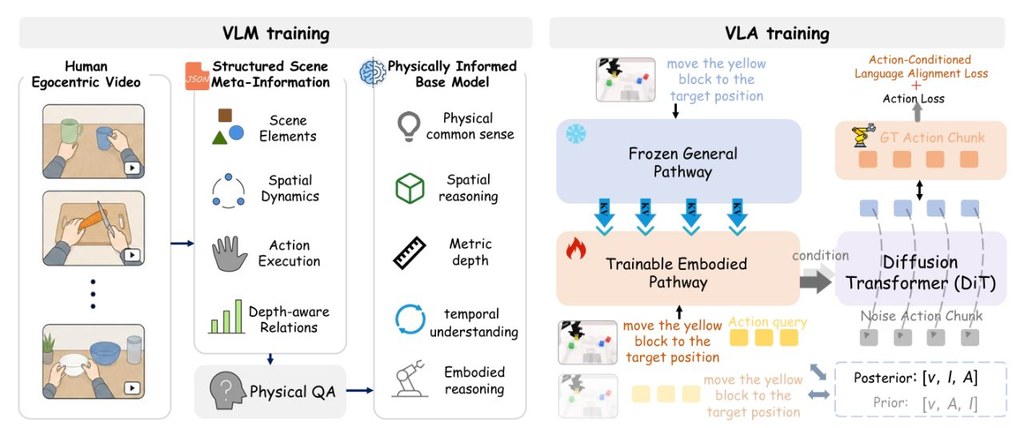
PhysBrain-VLA 係一個面向機械人控制的研究專案,但它最值得留意的地方,其實係訓練思路改變咗。以往不少系統主要靠機械人示範資料學動作,成本高之餘,遇到新場景亦未必識變通;而呢個專案就主張先由大量人類第一身影片抽取「物理常識」,再轉化畀模型學習。

對一般讀者嚟講,可以將它理解為:與其死記「點樣拎起杯」,不如先明白杯喺枱上、手要接近、物件有前後高低關係,甚至某些動作做唔做到。根據公開資料,團隊處理咗超過 3,000 小時人類影片,並整理成包含空間關係、動作可行性同推理線索的多模態訓練資料。

如果你想上手理解這個專案,較實際的方法唔係直接當成即裝即用工具,而係先由它的整體架構入手:先看資料引擎點樣把影片轉成結構化訊息,再看基礎模型如何吸收這些知識,最後理解 VLA 部分點樣把理解能力轉成機械人動作。對研究員、機械人開發者,或者關心 embodied AI 發展方向的人,呢個閱讀路線會比較清晰。

  • 核心價值係減少對昂貴機械人示範數據的依賴
  • 主要做法係由人類第一身影片提煉物理與空間常識
  • 架構包含 PhysBrain、TwinBrainVLA、LangForce
  • 提到的評測包括 ERQA、PhysBench、SimplerEnv-WidowX、LIBERO、RoboCasa

其中較有新意的是 TwinBrainVLA 的雙腦式設計,目標是減輕微調後「學咗新嘢就忘記舊嘢」的問題;LangForce 則把訓練重心由單純模仿行為,轉向較貼近物理推理的學習方式。從論文摘要來看,它在多個理解與控制評測都有強表現,尤其在陌生環境的泛化能力方面值得關注。

整體而言,PhysBrain-VLA 未必係面向普通用家的產品型專案,但作為技術方向,它展示咗一條幾實際的路:先讓模型理解世界,再叫它出手做事。若你想追蹤未來機械人如何由「照做」走向「識判斷」,這個專案相當有參考價值。

Project Page:  https://phys-brain.github.io

網址: https://github.com/Phys-Brain/PhysBrain-VLA

網址: https://arxiv.org/pdf/2605.15298

Categories: 開源, 模型, 視覺模型, 影像模型, Robotic, 中國

PAGER 提升 GUI 操作介面準確度

呢項研究聚焦AI喺幾何畫布上嘅精準點擊難題,並提出新基準同方法縮窄「識做」同「做到」之間嘅落差。

pager icon v3

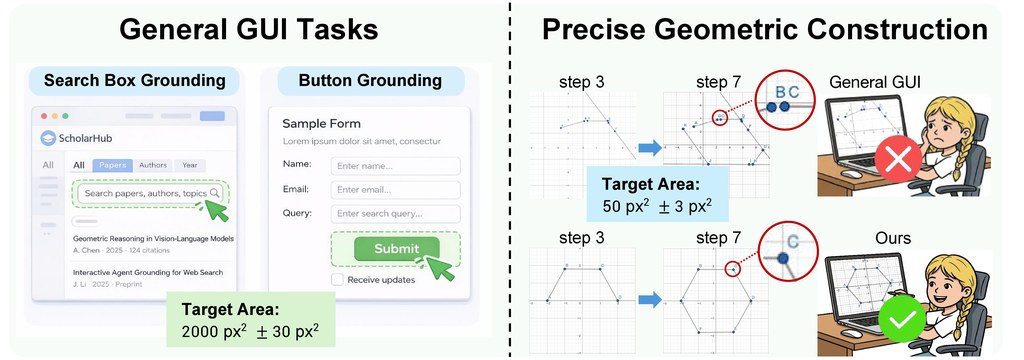
而家好多 GUI 智能代理都已經識得喺網頁、手機同桌面介面按掣、輸入文字,但呢類能力多數建立喺「大概撳中就得」嘅情況。呢篇研究處理嘅,係另一種要求高好多嘅環境:喺幾何畫布上落點,少少座標偏差都可能令之後所有圖形關係出錯。

研究團隊將呢類任務界定為對精度非常敏感嘅介面操作,並提出 PAGE Bench 作為評測基準,包含 4,906 條題目,同超過 22.4 萬個帶有過程監督嘅像素級操作資料。對一般讀者嚟講,可以理解為:研究者唔單止睇最後畫啱未,仲會逐步記錄每一下應該點做,方便訓練同評估模型。

為咗應付呢個問題,團隊提出 PAGER。佢會先按幾何物件之間嘅依賴關係做規劃,再執行像素級操作;另外再配合針對精準度嘅強化學習,用當前畫面狀態同幾何回饋去修正行為。簡單講,佢唔只係「認得要畫咩」,而係更著重「每一步要落喺邊個點」。

重點可以歸納為:
– 針對連續畫布上嘅落點操作,而唔係一般按鈕式介面
– 建立咗 PAGE Bench,專門量度像素級幾何控制能力
– 指出多模態模型存在明顯落差:理解指令未必代表真係做到
– PAGER 透過結構化規劃同幾何回饋,提升實際完成率

實驗結果亦幾有代表性。論文指出,一般多模態模型即使喺動作類型判斷上可超過 88% 準確率,整體任務成功率仍低於 6%,反映「語意理解」同「可執行操作」之間有明顯鴻溝;PAGER 就將任務成功率提升到最強通用基線嘅 4.1 倍,步驟成功率亦由不足 9% 提升到超過 62%。如果你關注 AI 代理、自動化操作,或者需要處理 CAD、教學幾何、精密繪圖等場景,呢項工作值得留意。

由應用角度睇,PAGER 特別適合用喺幾何教學軟件、自動作圖代理,同需要高精度圖形互動嘅研究場景。相比只判斷「有冇撳中元件」嘅方法,佢更重視座標、半徑、端點等連續參數,對處理精細圖形操作更有參考價值。

網址: https://openraiser.github.io/Pager-webpage/

Categories: 開源, 影像模型, 中國, Dataset 數據集

Causal-Forcing 點樣令影片動作更豐富

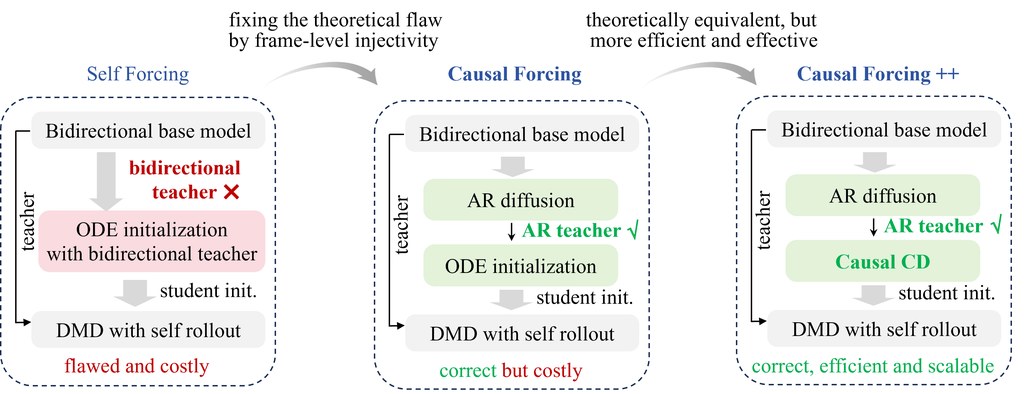
呢個專案主打即時互動影片生成,特別強化動作連貫同自然感。重點在於用更貼近時間因果的方式,改善畫面會動但唔夠順的問題。

overview

如果你對 AI 生成影片有興趣,Causal-Forcing 最值得留意的地方,不只是「出片快」,而是它特別著重動作變化是否合理。很多影片模型可以生成靚畫面,但人物移動、鏡頭轉換或物件軌跡,往往會有忽快忽慢、前後不連貫的情況;呢個專案正正是針對這類動態問題下手。

它的核心想法,是用更符合時間先後關係的方法,去引導自回歸式影片生成。簡單講,模型不只是學每一格畫面「似唔似」,而是更重視每一步動作點樣接續上一刻,令運動軌跡更穩定。README 亦明確指出,Causal Forcing 在視覺品質之外,對 motion dynamics 的表現比 Self Forcing 更好,而且訓練成本與推理效率大致維持同一水平。

對一般使用者而言,上手方向算清晰:它已提供推理與訓練流程,並支援文字生成影片,以及由圖片延伸成影片的形式。特別是 frame-wise 版本,因為按逐格方式處理,較容易理解為直接面向每個時間步,對需要細緻控制動作延續的人會更有吸引力。

  • 重點放在動作連貫性,不只追求單幀畫面靚
  • 支援 chunk-wise 與 frame-wise 兩類模型設計
  • 涵蓋 T2V、I2V,實用場景較廣
  • Causal Forcing++ 再進一步提供 1-step、2-step frame-wise 模型
  • 相關版本可留意 Causal Forcing、Causal Forcing++,以及 README 提到的 Self Forcing 作比較對象

再看它的創新位,關鍵在於用 Causal ODE,或在 Causal Forcing++ 中改用 causal Consistency Distillation,去做一個更合理的初始化,再配合 asymmetric DMD。從專案說明可見,作者很強調「生成軌跡要對齊」這件事,亦因此在某些階段要使用自回歸老師模型,這對保持動作隨時間推進的一致性尤其重要。

如果你的重點是互動式影片、角色連續動作、長一點的鏡頭推進,呢個專案比起只看單張效果的模型更值得研究。它未必是最易即學即用的大眾化工具,但對於想改善 AI 影片「會動但唔自然」這個老問題的人,方向相當明確。

網址: https://github.com/thu-ml/Causal-Forcing

網址: https://arxiv.org/pdf/2605.15141

Categories: 開源, 清華大學, 視頻模型

Orthrus如何令Qwen3生成更快

這個專案嘗試在不改變原本輸出品質下,加快大型語言模型生成速度。對想用Qwen3做推理的人尤其值得留意。

Orthrus logo

Orthrus 是一個圍繞 Qwen3 模型建立的生成框架,重點不是做全新聊天模型,而是想辦法令文字生成更快,同時保持與原本基礎模型一致的輸出分佈。對一般讀者來說,可以理解成它想保留傳統逐字生成的準確感,又借用擴散式並行生成的速度優勢。

這類工具主要針對大型模型生成時「要逐個字等」的樽頸。Orthrus 提出雙重架構做法,讓同一個模型同時具備兩種觀看方式,並強調結果是無損的,也就是目標並非用近似答案換速度;根據專案資料,生成可有最高約 7.8 倍加速。

如果你想上手,最直接方法不是自行訓練,而是先試用作者提供的模型檢查點,再用 Hugging Face 的常見載入流程做推理。現時公開型號包括 Orthrus-Qwen3-1.7B、Orthrus-Qwen3-4B 和 Orthrus-Qwen3-8B,分別對應 Qwen3 的 1.7B、4B 與 8B 基礎模型。

值得留意的是,它不是靠把整個模型重訓來換速度,而是只微調部分參數,基礎 LLM 保持凍結,同時兩種生成視角可共用同一套高保真 KV cache。對部署者來說,這代表它除了講求快,亦有意控制額外記憶體成本,這點對長輸出或高頻推理場景特別實際。

  • 以 Qwen3 為骨幹,現有 1.7B、4B、8B 幾個版本
  • 重點在提升生成吞吐,而非改變模型用途
  • 強調結果與原基礎模型保持一致,而非近似加速
  • 額外記憶體開銷較低,較適合推理部署評估
  • 對研究者、模型工程師及需要大量文字生成的團隊較有參考價值

整體來看,Orthrus 最吸引之處在於它把「快」與「不走樣」放在同一個方案內處理。若你正關注本地或伺服器端 LLM 推理效能,尤其已經在使用 Qwen3 生態,這個專案很適合作為實驗與比較基準;至於與 vLLM 或 SGLang 的更原生整合,則似乎仍在後續規劃中。

網址: https://github.com/chiennv2000/orthrus

Categories: 開源, 模型, 模型訓練, Qwen, 中國

PresentAgent-2:將查詢變成影片簡報

PresentAgent-2 由短短查詢出發,自動整理資料、製作投影片,再輸出旁白影片。對想快速做講解內容的人尤其有參考價值。

image

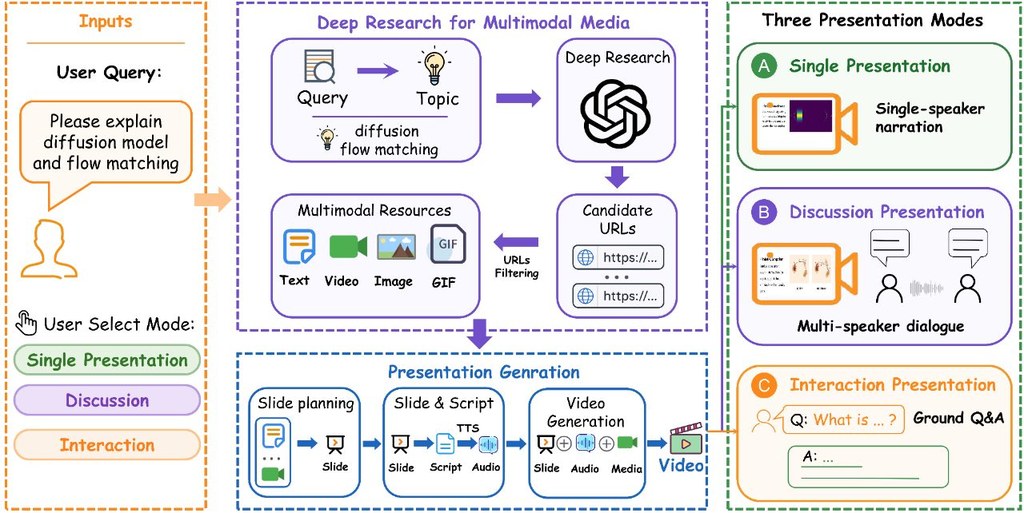
如果你曾經試過為一個新題目做簡報,就會知道最花時間的往往不是排版,而是先找資料、定重點、再把內容講清楚。PresentAgent-2 想處理的,正正是由一句自然語言提問開始,逐步變成一段有旁白的簡報影片,而不是假設你一開始已經有一份完整文件。

這個專案的流程相當清晰:先把模糊問題收窄成較聚焦主題,再整理候選來源,抽取文字、圖片、GIF 甚至影片素材,之後才規劃簡報結構、生成投影片與講稿,最後合成音畫對齊的影片。對一般用家來說,可以理解為把「搜集資料、寫大綱、做 slides、配音」串成一條自動化工作流。

較有意思的是,它不只做單一講者式內容,還支援多講者討論,以及有根據的互動問答三種形式。另一方面,動態素材會盡量保留為 GIF 或影片,而不是全部截成靜態圖,這令最後成品更接近真正可觀看的解說片,而不只是會動的投影片。

如果你想了解它是否適合自己,較合用的情境包括教學短片、研究題目導讀、產品介紹,或需要快速把一個概念講清楚的內容製作。現階段它更像研究型框架,較適合 AI、多模態內容生成、代理式工作流的開發者與研究者參考,而非即開即用的普通消費工具。

  • 由短查詢出發,不需要先準備完整原稿
  • 可產出投影片、講稿、旁白與最終影片
  • 支援單人講解、多人討論、互動問答
  • 能保留 GIF 與影片等動態素材,表達力較強
  • 評估方式包含選擇題測試與主觀打分,重視內容與呈現效果

相關模型方面,倉庫資料提到以 VLM 參與評估,扮演觀眾回答問題及進行評分,但公開資訊未見完整列出所有底層模型名稱。若你關心的不是單一模型,而是「怎樣把多個能力串成可交付影片」,PresentAgent-2 的參考價值會比單看文字或圖像生成工具更高。

網址: https://github.com/AIGeeksGroup/PresentAgent-2

Categories: 開源, 北京大學, 視頻模型, 中國

Page 18 of 20
1 … 16 17 18 19 20