LatentOmni 想重寫影音推理方式

這個項目嘗試讓模型不只靠文字思考,而是直接結合聲音與畫面推理。對複雜影音理解來說,方向相當值得留意。

LatentOmni

LatentOmni 是一個面向影音多模態大語言模型的研究項目,重點不是叫模型先把線索全都翻成文字再慢慢推理,而是讓聲音與畫面的資訊在同一個潛在空間內一起運作。簡單講,它想保留更多原始感官訊號,減少中途只靠語言猜答案的情況。

這個方向要解決的問題很明確:不少模型在看影片、聽聲音後,雖然能描述內容,但一遇到需要同時對齊時間、事件因果或細節關聯的題目,表現便會下跌。LatentOmni 提出的做法,是把文字推理流程與影音潛在狀態交錯進行,並用 OSPE 這類時間同步設計,幫助模型對準聲畫節奏。

從使用角度看,現時這個 GitHub 儲存庫仍以論文與概念介紹為主,訓練程式、推論程式、模型權重和資料集尚未正式釋出。因此較適合先拿來了解新一代多模態推理方法,或者作為研究與技術評估的參考,而不是立即部署到產品流程。

  • 核心亮點是統一聲音與畫面的潛在推理,而非只輸出文字式思路
  • 加入特徵層級監督與 OSPE,目標是保留時間對齊與跨模態關聯
  • 配套資料集為 LatentOmni-Instruct-35K,用來訓練交錯式影音推理軌跡
  • 論文指出它在多個影音推理基準上,表現優於明確文字 CoT 基線

整體來看,這個項目最吸引之處,是它把「模型怎樣思考」由文字中介,推前到更接近原始聲畫訊號的層面。適合關注 MLLM、影音理解、跨模態推理的人留意;若你想比較相關模型,也可把它與依賴文字 CoT 的開源多模態模型放在同一條線上觀察。不過現階段公開內容有限,性能細節仍應以論文報告為準,評估時要保持審慎。
GitHub: https://github.com/yfanDai/LatentOmni

Paper: https://arxiv.org/pdf/2605.22012

Categories: 開源, 香港科技大學, 北京大學, 清華大學, 模型, 視覺模型, 影像處理, 聲效, 中國

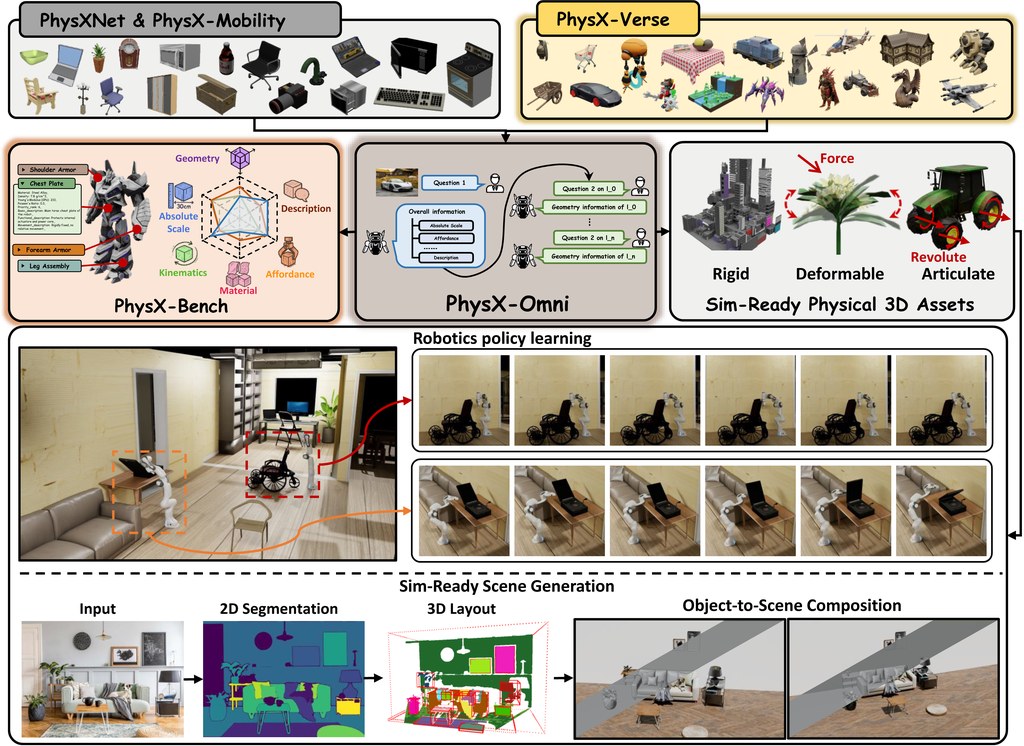
PhysX-Omni:讓 3D 生成更貼近物理世界

項目不只生成3D外形,還嘗試補上材質、尺寸與關節等物理資訊。對模擬、機械人與場景製作尤其有參考價值。

teaser

PhysX-Omni 由南洋理工大學及 中國 ACE Robotics 開發,是個面向模擬用途的 3D 生成項目,重點不只是做出外觀,而是連同剛體、可變形物件與可動關節物件一併考慮。簡單說,它想解決的問題是:很多 3D 生成結果看起來像樣,但未必能直接放進物理模擬或機械人流程裡使用。

這個項目的亮點,在於把幾何形狀、絕對尺寸、材質、可供互動的功能,以及運動結構放到同一套框架內處理。它配合 PhysXVerse 資料集和 PhysX-Bench 評估方法,目標是同時檢查生成能力與理解能力,這點比只看外觀相似度更進一步。

整體流程偏向研究型:先準備 Python/conda 環境,再安裝相依套件,之後下載 PhysXNet、PhysX-Mobility 與 PhysXVerse 等資料,完成前處理和條件圖像渲染,最後再設定訓練路徑。這代表它較適合已有 AI 或 3D 處理基礎的人,而不是即開即用的輕量工具。

PhysX-Omni: Unified Sim-Ready Physical 3D Generation for Rigid, Deformable, and Articulated Objects
  • 核心價值:生成可放進模擬流程的 3D 資產,而非只有表面外觀
  • 覆蓋範圍:支援剛體、可變形物件、關節物件三類內容
  • 相關資源:包括 PhysXVerse 資料集、PhysX-Bench 評估,以及 README 提到的 Qwen2.5 相依套件
  • 適合場景:機械人訓練、物理模擬、具條件控制的 3D 場景生成

性能方面,公開資料指出它會用一般指標加上自家的基準一同評估,並強調在生成與理解兩邊都有不錯表現。不過從現有資訊來看,較完整的數字仍應以論文與官方頁面為準;對一般讀者而言,最值得留意的是它把「看得像」推進到「更可能用得著」,這正是這個項目最有意思的地方。

GitHub: https://github.com/physx-omni/PhysX-Omni

Paper: https://arxiv.org/pdf/2605.21572

Categories: 開源, 模型, 影像模型, 影像處理, 中國, Dataset 數據集

Pi-Bench 點評:測試主動型助手夠唔夠醒

Pi-Bench唔係教你做助手,而係用嚟檢驗助手有幾主動。它特別重視長流程、多輪互動同隱藏需求。

Pi-Bench Overview

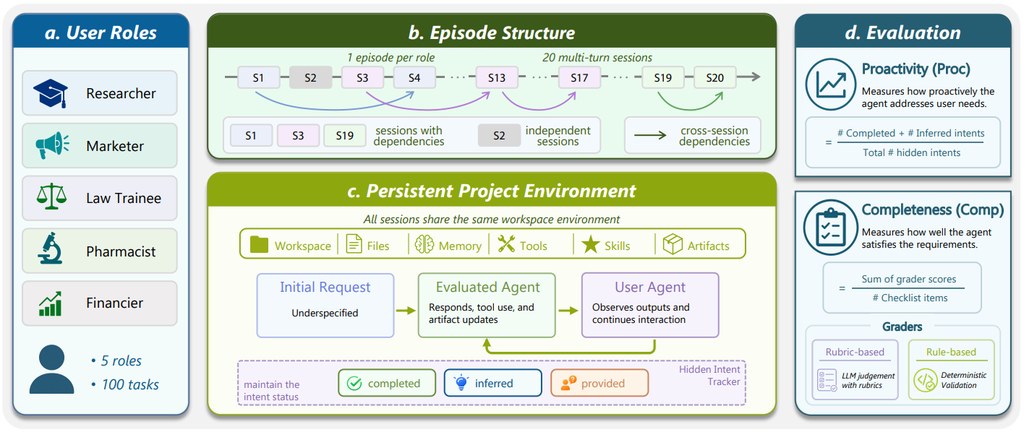
OpenClaw 等個人助理代理的興起凸顯了大型語言模型在支援使用者日常生活和工作方面日益增長的潛力。這些環境中的一個核心挑戰是主動協助,因為使用者通常從未明確說明的請求開始,而未說明重要的需求、限製或偏好。

Pi-Bench 不是一般聊天問答,而是評測檢查個人助手型代理在長流程工作中,能否及早察覺用戶未講出口的需要。這類情境很常見,因為不少人一開始只會講大方向,細節、限制同偏好往往在後續對話才慢慢浮現。

這個項目收錄了 100 個多輪任務,涵蓋 researcher、marketer、pharmacist、law trainee、financier 五類角色,並且把任務放進可持續保存的工作空間,模擬跨時段處理事情的情況。相比只測短回合回答的基準,它更接近「一路做、一路補需求」的助手工作模式。

Pi-Bench 的特別之處,在於它同時看兩件事:助手夠不夠主動,以及最後交付是否完整。前者會看系統能否提早推斷隱藏意圖,或主動追問關鍵資訊;後者則檢查輸出是否符合清單要求。README 提到評分包含隱藏意圖判斷與 checklist 驗證,而且審核分歧低於 4%,顯示評估設計有一定穩定性。

對研究代理系統、評估 LLM 助手,或者想比較 OpenClaw、Nanobot、Claude Code 一類模型/系統表現的人,這個項目幾有參考價值。使用時重點不是「跑出高分」本身,而是觀察模型在哪些回合漏問、忘記前文,或者只懂被動完成指令。

  • 針對長流程、多輪互動,不只測單次回答
  • 納入隱藏需求、跨任務依賴與跨 session 延續性
  • 以主動性與完整度兩條線一齊評估
  • 包含 5 種角色、100 個任務,場景較立體
  • 適合比較個人助手型代理,而非純文字問答模型

整體來說,Pi-Bench 最有價值的地方,是把「助手是否主動幫到手」拆成可觀察、可比較的評測問題。它未必直接提升模型能力,但很適合作為檢查工具,幫團隊看清楚一個助手究竟只是跟指令做事,還是真正懂得提前補位。

GitHub: https://github.com/Simplified-Reasoning/Pi-Bench

項目: https://simplified-reasoning.github.io/Pi-Bench/

Categories: 開源, 香港中文大學, 框架, 中國, Dataset 數據集

TransitLM:點樣評估生成巴士地鐵路線

這項目不是用來規劃路線,而是專門檢查模型生成的路線是否合理。它把評分拆細,較易看清模型錯在邊一層。

Repository image for HotTricker/TransitLM

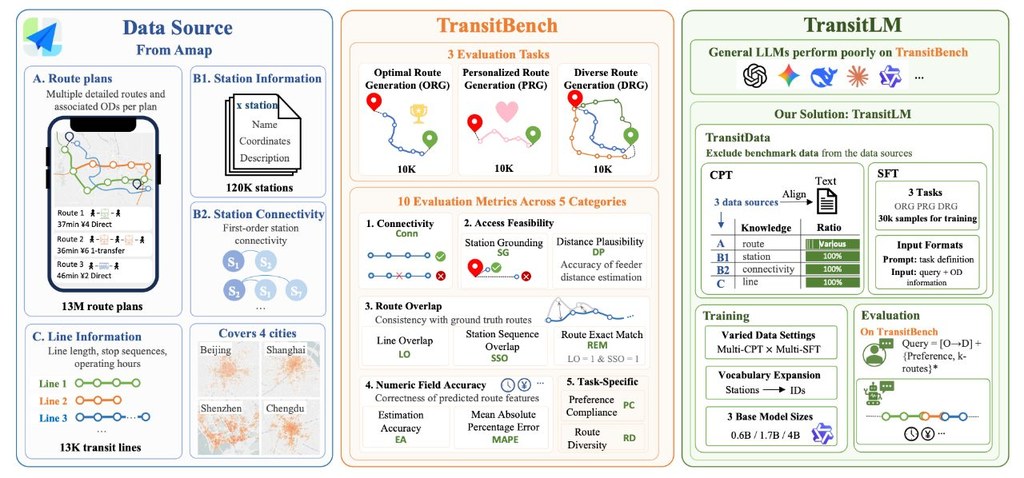
TransitLM 重點不是直接幫你找車程,而是提供一套評估流程,專門量度模型生成公共交通路線的表現。它配合同名論文與資料集使用,主要服務「不靠地圖引擎、直接由資料學出路線」這類研究方向。

項目已經附上示例 CSV,並按不同情境分成幾個評估腳本,包括單一路線、偏好路線、多路線多樣性,以及透過遠端 API 評估一般大語言模型輸出。因為只依賴 Python 標準函式庫,環境要求相對輕巧,想重現論文評估流程的人會較容易開始。

這個項目最值得留意的地方,是它不只給一個總分,而是把結果拆成多層來看,例如路線是否可達、站點是否對應得上、整體結構是否一致,以及時間、距離、票價估算是否可信。對比只看「答得似唔似」,這種分層做法更容易找出模型到底是認錯站、接錯線,還是只在數值估算上失準。

  • 支援四類評估情境,覆蓋論文基準與一般 LLM 輸出
  • 評分拆成多個維度,比單一總分更有診斷價值
  • 可檢查偏好是否符合,例如少轉車、避開地鐵等
  • 多路線模式會額外比較替代路線與多樣性
  • 安裝負擔低,適合重現與快速驗證

從論文資訊看,TransitLM 背後資料規模相當大,涵蓋超過 1,300 萬筆公共交通規劃紀錄、四個中國城市、120,845 個站與 13,666 條路線;相關研究亦提到模型可在沒有明確地圖對接下,學到站點對應與路線結構。不過這個儲存庫本身偏重「評估」而非「訓練」,所以較適合研究人員、做交通路線生成的模型開發者,或者想比較 GPT、Qwen 這類一般模型在路線任務上表現的人。

整體來看,TransitLM 的價值在於把一個很易流於主觀的任務,整理成可重現、可分解、可比較的評估項目。對非專業讀者來說,可以把它理解成一把較精細的尺:不是幫你直接畫路線,而是幫你判斷模型畫出來的路線,到底有幾可信。

GitHub: https://github.com/HotTricker/TransitLM

Paper: https://arxiv.org/pdf/2605.22355

Categories: 開源, 阿里巴巴, 框架, 中國, Dataset 數據集

Mega-ASR:嘈雜環境下更穩定的語音辨識

Mega-ASR主打真實混亂聲學環境下的語音辨識穩定度,重點不是追求乾淨語音分數,而是減少漏字、亂估和空白輸出。

Mega-ASR Logo

Mega-ASR 是一個針對野外場景而設的語音辨識項目,重點放在「環境愈差,結果仍然可用」。一般模型在雜音、回音、收音距離遠,甚至傳輸中斷時,常會出現漏句、亂寫內容或直接沒有輸出;這個項目正是為了解決這類問題而來。

它的做法不是只靠單一噪音增強,而是把真實世界常見的聲學干擾拆成 7 類基本條件,再組合成 54 種複合場景,用約 260 萬筆訓練樣本去磨練模型。論文亦提到兩個關鍵方法:A2S-SFT 與基於 DG-WGPO 的強化學習,目標是令模型由聲音訊號一路更穩定地對應到語意,特別加強嚴重失真下的語意恢復與局部關鍵字重建。

想試這個項目,最直接是查看其 Hugging Face 權重、技術報告,以及配套的 Voices-in-the-Wild-2M 資料集和 Voices-in-the-Wild-Bench 基準。對開發語音輸入、會議轉錄、客服錄音整理,或戶外收音產品的人來說,這類資源比單看示範更有參考價值,因為可以用同一套基準比較不同模型在惡劣環境下的表現。

  • 針對雜音、遠場、遮擋、回音、錄音瑕疵、電子失真與傳輸掉包而訓練
  • 特色是減少 hallucination、空白輸出與整句遺漏
  • 提供模型權重、資料集與基準,方便延伸評估
  • 相關模型可留意 Qwen3-ASR-1.7B,以及 README 提到的其他開源與閉源強模型比較

表現方面,公開資料指出它在多個惡劣條件基準上優於先前強模型,例如在 VOiCES R4-B-F 與 NOIZEUS Sta-0 的錯誤率均有明顯下降;在複合聲學場景下,亦錄得超過 30% 的相對錯誤率改善。不過這些結果主要來自論文與項目提供的評估,使用時仍要看語言種類、音訊長度和部署資源是否配合你的場景。

整體來看,Mega-ASR 最值得留意的,不是它把乾淨語音分數推高多少,而是它把語音辨識帶回更接近現場的問題:收音差、環境亂、訊號不完整時,系統還能否交出可信文本。對需要「穩定比完美更重要」的項目,這個方向相當有吸引力。

GitHub: https://github.com/xzf-thu/Mega-ASR

Paper: https://arxiv.org/pdf/2605.19833

Categories: 開源, 上海人工智慧實驗室, 模型, 語音

PixVerve-95K:衝擊超高像素生圖評測

這個項目不只談生成圖片,更想建立一套面向超高解析度生圖的資料與評測框架。對研究與模型比較都頗有參考價值。

image

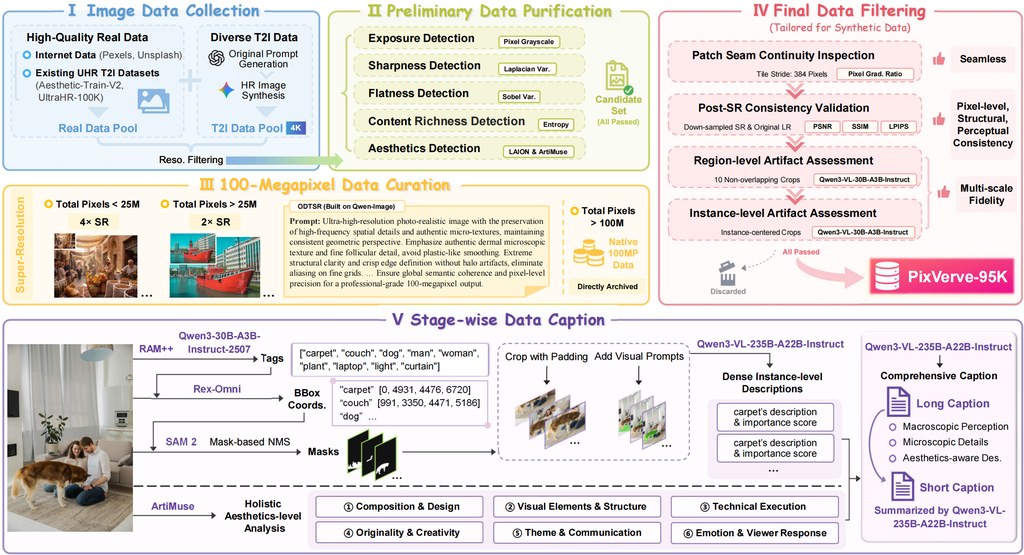
PixVerve-95K 是一個圍繞原生文字生成圖片而設的研究項目,重點放在把輸出推向 100MP 等級的超高解析度。它不只是提供資料,還連同模型方法與評測基準一併整理,方向相當清晰:回答「高像素生圖到底做得夠唔夠好」這個常見但難量化的問題。

對一般讀者來說,最易理解的切入點是把它視為一個「比較平台」。研究人員或開發者可先查看公開的資料集與基準設定,再用自己的文字生成圖片模型產出結果,之後按它提出的評估方式比較畫面細節、主體是否貼合描述,以及不同縮放層級下的穩定度。

這個項目的亮點,在於它不是只看一張圖表面是否好看,而是更重視超高解析度下的完整性與一致性。README 提到的 Multi-scale Fidelity Index(MSFI)與 Instance-centric Compliance Score(ICS),反映它嘗試由多尺度保真度與主體對應程度兩方面衡量結果,這比單純看主觀觀感更有系統。

重點可先看這幾項:
– 目標聚焦於原生文字生成圖片走向 100MP
– 內容涵蓋資料集、模型方法、基準評測三部分
– 評估指標包括 MSFI 與 ICS
– 適合拿來比較不同模型在高解析度場景的表現
– 已提及可配合 Qwen3.5-35B-A3B 與 vLLM 相關流程使用

適合關注這個項目的人,包括做文字生成圖片研究的團隊、想測試高解析度輸出能力的模型開發者,以及需要有系統 benchmark 的學術場景。若你平時留意的模型包括 Qwen3.5-35B-A3B,或其他文字到圖片生成系統,PixVerve-95K 的價值更像是一把尺,幫你判斷模型在大尺寸畫面下是否仍能守住細節與語意一致性。

GitHub: https://github.com/HaojunChen663/PixVerve-95K

Paper: https://arxiv.org/pdf/2605.20147

Categories: 開源, 清華大學, 框架, 中國

Aurora:把影片編輯指令講清楚的 AI 代理

Aurora 想處理影片編輯最麻煩的一步:把含糊要求轉成可執行流程。它把代理式理解與影片生成結合,方向幾幾清晰。

Repository image for yeates/Aurora

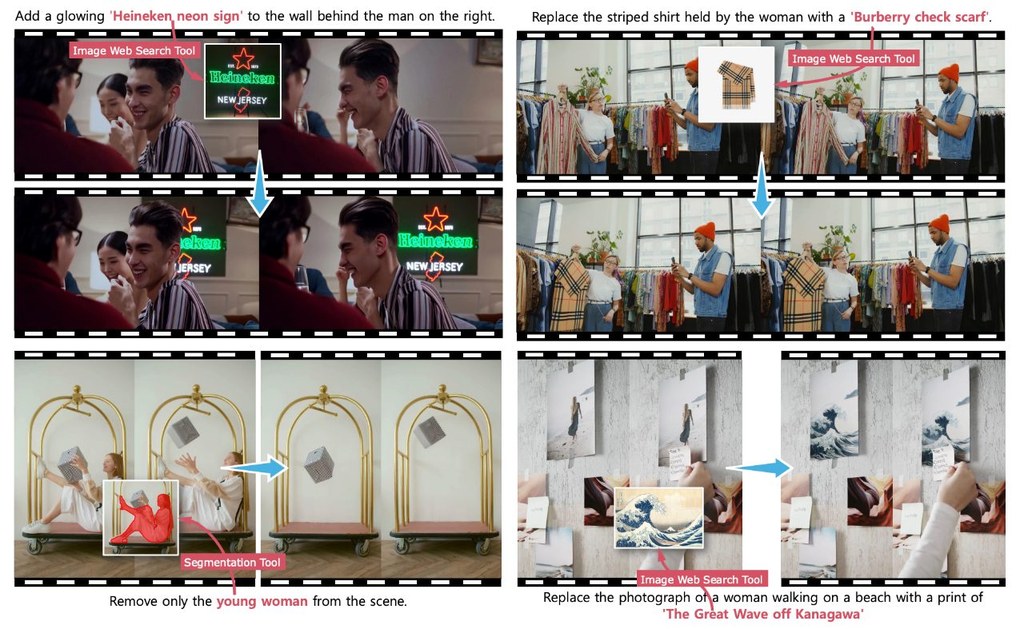
Aurora 是一個面向影片編輯的 AI 項目,重點不只是「生成畫面」,而是先理解你想改甚麼。它把使用者一句較口語、甚至有點含糊的要求,整理成較明確的編輯計劃,再交給影片模型處理,目標是減少「講唔清、改唔準」的情況。

這個項目想解決的核心問題,是影片編輯要求經常不完整。你可能只說想「換走背景」、「刪除路人」或「改成某種風格」,但未必提供參考圖,亦未必指出遮罩範圍;Aurora 會嘗試補回這些缺口,例如用圖像搜尋找參考,或用分割方式找出需要修改的位置。

它較有新意的地方,在於把多種影片編輯工作放進同一個框架,而不是每種效果各自一套模型。根據目前資料,這個項目支援替換、移除、風格轉換,以及根據參考內容插入元素,背後並結合了工具增強的視覺語言模型代理,以及統一的影片 diffusion transformer,也就是影片 DiT。

動手了解這個項目時,可先把它當成「會先幫你整理需求的影片編輯助手」。現階段儲存庫內容顯示官方實作仍在準備中,所以較適合先閱讀論文與項目頁,理解它如何把原始要求拆成指令、任務標籤、圖像搜尋查詢與遮罩描述四部分,再留意之後公開的程式。

  • 同一個項目框架處理多類影片編輯工作
  • 會先重寫使用者要求,再交由影片模型生成
  • 可補足缺少的參考圖與編輯區域資訊
  • 相關模型重點包括工具增強 VLM 代理與影片 DiT
  • 另有 AgentEdit-Bench,用來評估這類代理式影片編輯能力

對內容創作者、影像研究人員,或者關心人機協作編輯流程的人來說,Aurora 特別值得留意。它未必是即刻可用的成品,但從設計方向看,這個項目著重的不是單次炫技效果,而是令影片編輯指令變得更完整、更可執行。

GitHub: https://github.com/yeates/Aurora

Paper: https://arxiv.org/pdf/2605.18748

Categories: 開源, Agentic, NVIDIA, 框架, 中國

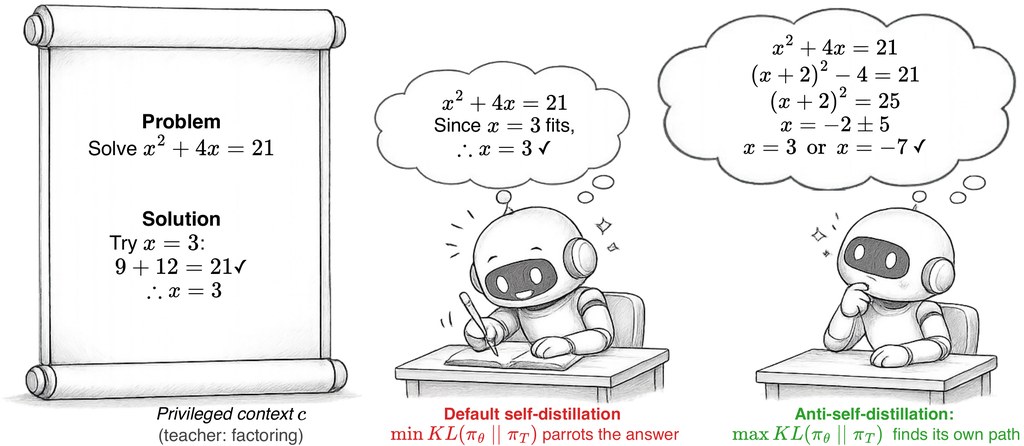
AntiSD 點樣改善推理訓練盲點

AntiSD 針對數學推理訓練入面常見的「學得快但諗得淺」問題,提出一個幾反直覺但有實證支持的方法。

fig1a overview

AntiSD 係一個研究型專案,主力處理語言模型做數學推理時嘅訓練偏差。一般做法會叫模型向一個「已知答案、更有提示」嘅自己學習,但作者指出,呢種安排往往會令模型更著重格式化、收尾式嘅字詞,反而削弱真正幫到逐步思考嘅中間推理線索。

呢個專案最特別嘅地方,係將常見嘅自我蒸餾方向反轉。簡單講,唔再一味逼學生版本貼近「已經知道答案」嘅老師版本,而係用一種受控制嘅方式保留兩者差異,等模型唔會過早放棄探索思路;同時再加上一個基於不確定度嘅開關,避免訊號去到後期失控。

實際睇法上,呢個方法唔係畀一般用家即裝即玩,而係較適合已經做緊推理模型訓練、想比較不同強化學習策略嘅人。閱讀論文、配合 GitHub 內嘅實驗設定同 W&B 結果去重現,會係較合理嘅使用方式;重點係觀察訓練步數、最終準確率,同埋模型喺中間推理字詞上有冇被過度壓縮。

  • 針對數學推理訓練中「答案啱,但思路變薄」嘅問題
  • 核心做法係反轉自我蒸餾訊號,而唔係沿用標準貼近策略
  • 論文提到以 pointwise mutual information 解釋點解方法有效
  • 在多個 4B 至 30B 模型上,據報可用更少訓練步數追平或超過基線
  • 相關模型包括 Qwen3-4B、Qwen3-8B,以及其他同級 4B 至 30B 語言模型

以定位來講,AntiSD 比較似一個畀研究員同模型工程團隊參考嘅訓練配方,而唔係面向終端用戶嘅應用程式。對於關注 AIME、HMMT、BeyondAIME 呢類數學推理基準,或者正用 GRPO 一類方法微調模型嘅團隊,呢個專案提供咗一個值得認真比較嘅替代方向。

GitHub: https://github.com/FloyedShen/AntiSD

Paper: https://arxiv.org/pdf/2605.11609

Categories: 開源, 框架, 中國

ZEDA 點樣令 MoE 推理更慳力

ZEDA針對已訓練完成的 MoE 模型,嘗試用較低成本換取更快推理。重點是減少專家計算,同時盡量保住原有表現。

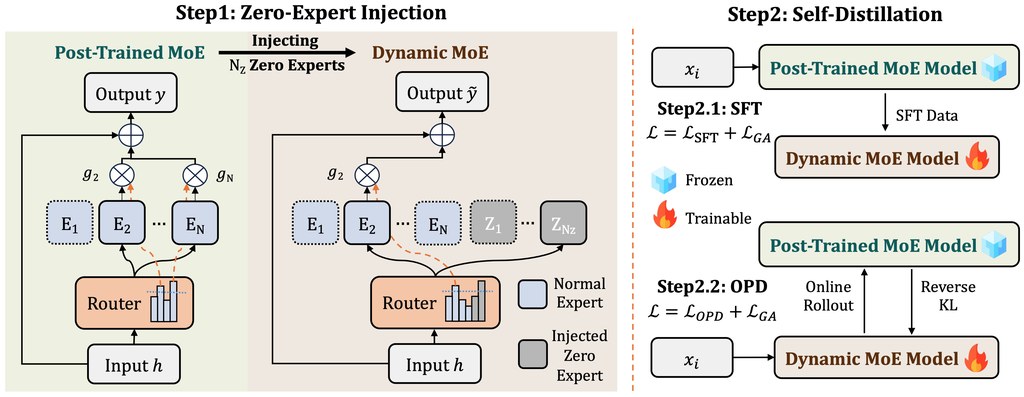
Overview of Unified Post-Training Framework.

ZEDA 針對的是一個很實際的痛點:大型 MoE 模型雖然強,但部署時每次回應都要動用唔少計算資源,成本高、速度亦受影響。呢個專案的目標,係唔使由頭再訓練模型,而係在現有、已做完後訓練的 MoE 之上,再改造成更靈活的動態版本。

它的做法有點似「老師帶學生」:先用原本的 MoE 當固定老師,再訓練新的學生模型去學習輸出,同時加入一種零輸出的專家,讓部分較簡單的 token 可以略過不必要計算。根據論文與倉庫資訊,這種方法可減少超過一半 expert FLOPs,整體表現只屬輕微下跌,並帶來約 1.20 倍端到端推理加速。

ZEDA 不是通用開發框架;它是清華 C3I 團隊的一個研究專案,從公開論文摘要看,全名是 Zero-Expert Self-Distillation Adaptation,目標是把靜態 MoE 模型轉成更高效的動態 MoE 模型,以降低推理成本並提升速度。這個專案對應的 GitHub 倉庫就是 TsinghuaC3I/ZEDA,而論文頁面也明確指向該 repo。

實際動手時,流程大致分兩步:先做 SFT,利用老師模型產生的回應或已釋出的 rollout 結果訓練學生;之後再做 OPD,改為由學生自己生成,再由老師提供 token 級別目標去微調。倉庫亦提到可配合已公開的 prompts 與 rollout 資料使用,對想重現結果或套用到指定 MoE 的人會方便不少。

  • 核心價值:把已完成訓練的靜態 MoE,改成推理時更慳算力的動態 MoE
  • 方法亮點:加入零輸出專家,再用兩階段自蒸餾穩定轉換過程
  • 可選模型:Qwen3-30B-A3B、GLM-4.7-Flash
  • 適合場景:模型已定版,但上線後仍想再壓低推理成本
  • 資料配套:提供 prompts 集合,亦釋出部分 rollout 結果可直接利用

整體來看,ZEDA 最值得留意的地方,不是單純追求更高分,而是補上「模型已經訓練完,之後仲可以點樣再慳資源」這一步。對研究 MoE 部署、推理優化,或者手上已有大型後訓練模型的團隊,這個方向相當有參考價值;至於一般讀者,可以把它理解成一種用較少電腦功夫,換來差不多效果的改裝方案。

GitHub: https://github.com/TsinghuaC3I/ZEDA

Paper: https://arxiv.org/pdf/2605.18643

Categories: 開源, 清華大學, 上海人工智慧實驗室, 中國

KVPO 點樣提升影片生成對齊

KVPO聚焦自動回歸影片生成訓練,嘗試令結果更貼近提示內容。重點在於用分支探索加獎勵學習,改善畫面走向。

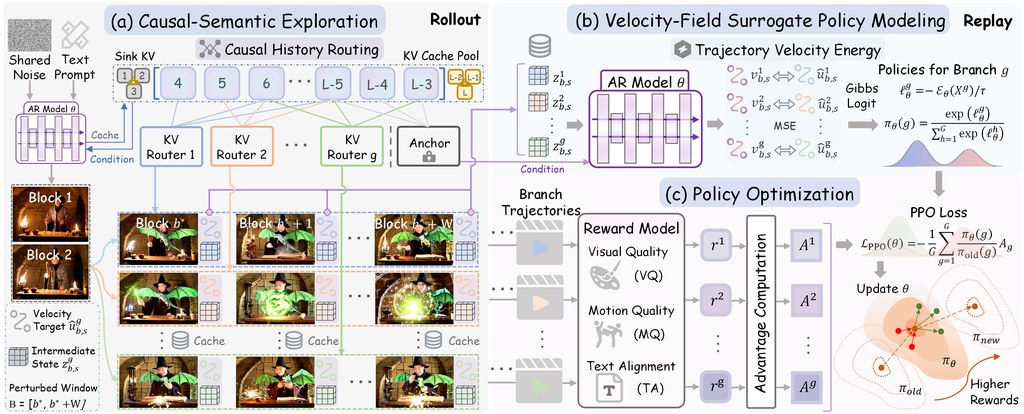
KVPO

KVPO 係一個針對影片生成訓練流程嘅研究型專案,焦點唔係單純「生成到片」,而係令模型喺逐格、逐段生成嘅過程中,更穩定咁貼近文字提示同預期內容。對一般讀者嚟講,可以理解成:佢想改善 AI 影片成日出現嘅「開頭啱、之後走樣」問題。

呢個方法特別之處,在於佢唔只睇最後條影片好唔好,而係會喺生成途中做多條候選路線探索,再用獎勵模型判斷邊條路線更值得學。README 提到佢結合咗類似 PPO 嘅強化學習更新,以及對生成軌跡嘅機率估計,目標係令自動回歸影片模型學得更準。

實際了解同試用呢個專案,會由查看論文、專案頁面同釋出權重開始,再按設定準備對應環境、模型權重同資料。由於文件列出咗 H200、CUDA 12.8、Wan2.1 backbone,以及 HPSv3、VideoReward 等元件,較適合已有 GPU 資源、熟悉深度學習訓練流程嘅讀者,而唔係即開即用型工具。

  • 主要處理影片生成中內容偏離提示、時間一致性變差等問題
  • 核心做法係先探索多個生成分支,再用獎勵分數引導學習
  • 研究重點放喺自動回歸影片模型,而唔係一般圖片生成
  • 文件顯示會配合 Wan2.1-T2V-1.3B 等 backbone 使用
  • 仲會涉及 HPSv3、VideoReward 呢類評分或獎勵相關模型

整體而言,KVPO 比較適合關注影片生成訓練方法嘅研究者、工程師,或者想比較唔同對齊策略嘅團隊。對非技術用家,佢未必係直接拎嚟出片嘅方案;但作為觀察新一代影片模型點樣「學識跟指令」嘅方向,呢個專案幾有參考價值。

GitHub: https://github.com/Richard-Zhang-AI/KVPO

Paper: https://arxiv.org/pdf/2605.14278

Categories: 開源, 香港科技大學, 清華大學, 影像模型, 影像處理

Page 17 of 20
1 … 15 16 17 18 19 20