SU-01:數理推理模型的新示範

SU-01主打奧數級數理推理,重點不在花巧工具,而是把推理流程練得更紮實。對關心AI解題能力的人來說,值得留意。

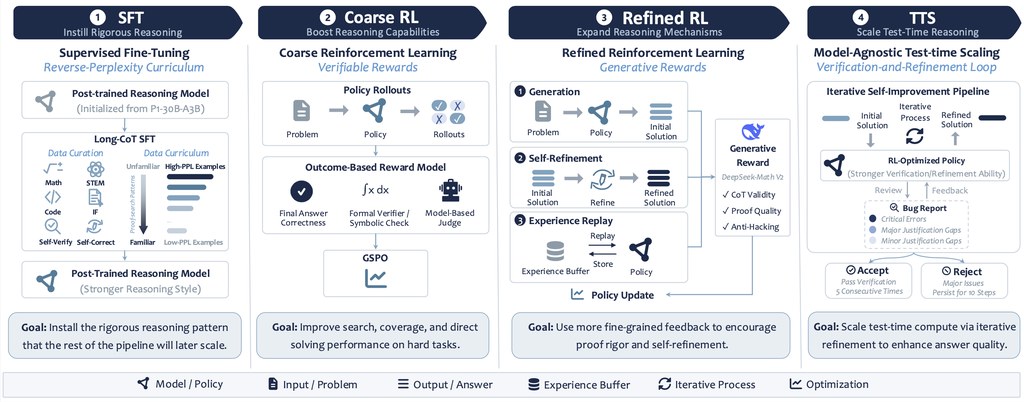
SU-01 training and inference pipeline

如果你對「AI識答數學題」有興趣,SU-01是一個幾有代表性的案例。它是一個 30B-A3B 推理模型,目標不是單靠背答案,而是嘗試完成較長步驟、較講求證明結構的數學與科學題目,尤其接近競賽題風格。

對一般讀者而言,最易理解的用法,是把它當成一個專注於複雜解題的模型來看,而不是萬能聊天機械人。官方資訊顯示,模型已公開權重,亦有技術報告與專案頁面;如果你本身會用 Hugging Face 一類平台,就可以進一步了解它的輸出表現與測試方式。

SU-01較特別的地方,在於它不依賴外部工具、寫程式執行,或者專門符號求解器,仍然想把長鏈條推理做好。訓練上,它用了較有策略的資料排序方式,以及分兩階段強化學習,先追求可驗證答案,再逐步改善證明質素,這點對處理多步驟題目尤其重要。

  • 重點放在數學、物理等需要嚴謹步驟的解題
  • 嘗試處理長篇推理與證明修正,而非只輸出最終答案
  • 在 IMO 2025(第66屆國際數學奧林匹亞)、USAMO 2026(美國數學奧林匹亞)、IPhO 2024/2025 有高水準成績
  • 相關模型可留意同類推理系統,例如 DeepSeek-R1、OpenAI o1 類型模型,以及其他數理導向大型語言模型

如果你是研究員、教育科技開發者,或者想比較不同推理模型在高難度題目的差異,SU-01很值得觀察。對一般學生來說,它未必是即開即用的溫習工具,但作為理解 AI 如何由「識答題」走向「識證明」的例子,參考價值相當高。

整體來看,SU-01吸引之處不只在分數,而是在方法上走一條相對簡潔統一的路線。從公開資料判斷,它更像是一個展示「後訓練如何提升嚴謹推理」的研究型專案,適合關心 AI 推理上限的人細看。
網址: https://github.com/Simplified-Reasoning/SU-01

Categories: 開源, 香港中文大學, 模型, 深度學習, 中國

Warp-as-History:一段片訓練出「鏡頭操控」

專案主打用一段已標註鏡頭資訊的影片,生成可跟隨視角移動的新片段。對想試相機控制式影片生成的人來說,方向相當清晰。

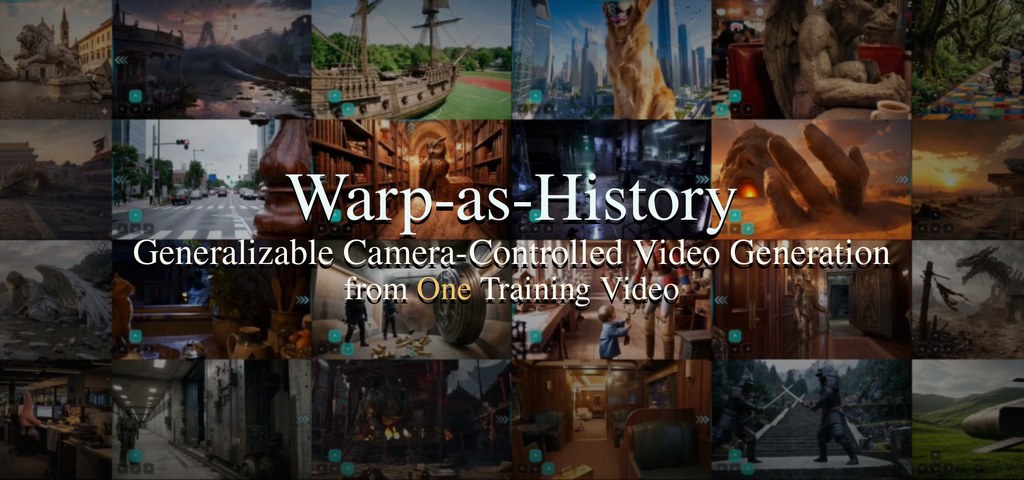
Warp-as-History teaser

如果你對 AI 影片生成有興趣,但又覺得「要大量素材先訓練」門檻太高,Warp-as-History 的吸引力正在於它嘗試只用一段訓練影片完成相機視角控制。簡單講,它想做的是讓系統學會原片中的空間與運鏡關係,再按你指定的鏡頭路徑生成新畫面。

對一般使用者來說,理解這個專案的最好方法,不是把它當作普通文字生片工具,而是視為一個偏向「鏡頭操控」的研究型方案。你需要先準備一段帶有相機資訊的影片,再配合指定模型做推理或訓練;官方列出的預設組合包括 Helios-Distilled、Warp-as-History LoRA,而 Helios-Mid 主要用於訓練,另外 README 亦提到 Pi3X。

它解決的重點問題,是生成影片時常見的視角不穩、鏡頭移動不連貫,以及難以精準控制觀看方向。這個方法特別強調互動式鏡頭軌跡跟隨與視點調整,定位上與 HappyOyster、Genie 3 這類方向相近,但賣點是把所需訓練資料壓到單一範例,這點相當有研究價值。

  • 一段訓練影片 已是核心設定,對資料收集要求較低
  • 重心不在純文字生成,而在鏡頭路徑與視角控制
  • 相關模型包括 Helios-Distilled、Warp-as-History LoRA、Helios-Mid、Pi3X
  • 較適合研究實驗、效果驗證,未必是即開即用的消費級工具

如果你是做生成式影像研究、互動敘事、虛擬攝影,這個專案值得留意;若你只是想快速剪片或一鍵出成品,可能會覺得前置準備仍然偏技術性。整體來看,Warp-as-History 最有意思的地方,是把「影片歷史資訊」由單純上下文提升為可延續的視角依據,令相機控制這件事更像真正可操作的生成條件。

網址: https://github.com/yyfz/Warp-as-History

Categories: 開源, 視頻模型, 世界模型, 影像處理, 中國

awesome-deepseek-agent:任何 Agent 接通 DeepSeek

這個儲存庫不是模型本身,而是一份實用導航,幫你把 DeepSeek 接入常見 AI 工具。對想快速試用的人來說,方向清楚又省時間。

Repository image for deepseek-ai/awesome-deepseek-agent

想在 Claude Code、Cline、Codex 或 VS Code 內使用 DeepSeek-V4-Pro、DeepSeek-V4-Flash,真正卡住人的往往不是模型選擇,而是 API 設定、工具配置和首次執行流程。這個項目屬於開源指南集合,將不同 AI Agent 及 coding-assistant 工具的接入步驟集中整理,縮短由註冊到可工作的距離。

內容涵蓋 AstrBot、Cherry Studio、Claude Code、Cline、Codex、Crush、GitHub Copilot、Kilo Code、LobeHub、nanobot 等工具,亦包括 Deep Code 和 DeepSeek-TUI 這類直接面向 DeepSeek-V4 的工具。每份指南按安裝、設定和首次執行編排,讀者需要先在 DeepSeek Platform 取得 API key,再按工具的 API provider 或模型欄位填入相關資料。

清單的價值在於處理工具之間的配置差異,而不是重新包裝模型能力。它同時涉及桌面客戶端、終端 Agent、編輯器擴充功能、聊天平台整合、MCP、知識庫及 Agent Skills,適合想比較不同工作流的開發者,也方便團隊替成員建立一致的接入參考。

目前資料沒有提供統一 benchmark、延遲、成本或各工具的成功率。DeepSeek-V4-Pro 與 DeepSeek-V4-Flash 的實際體驗仍會受上下文長度、工具權限、API 配額和宿主工具本身影響;這份項目較適合作為安裝與配置索引,而不是性能評測。

• 集中整理多個 AI Agent 和 coding-assistant 的 DeepSeek 接入方法
• 覆蓋桌面、終端、編輯器及聊天平台工作流
• 指向 DeepSeek Platform API key 和 API Docs
• 同時涉及 MCP、知識庫、Agent Skills 和多模型支援
• 沒有提供統一性能數據,選擇工具仍需按工作流測試

網址

Categories: 開源, DeepSeek, 庫, 中國

Relit-LiVE:令影片重新打燈更自然

這個專案主打影片重打光,重點是光影連貫而且更像真實拍攝。對影像研究者和進階創作者特別有參考價值。

Nanjing University

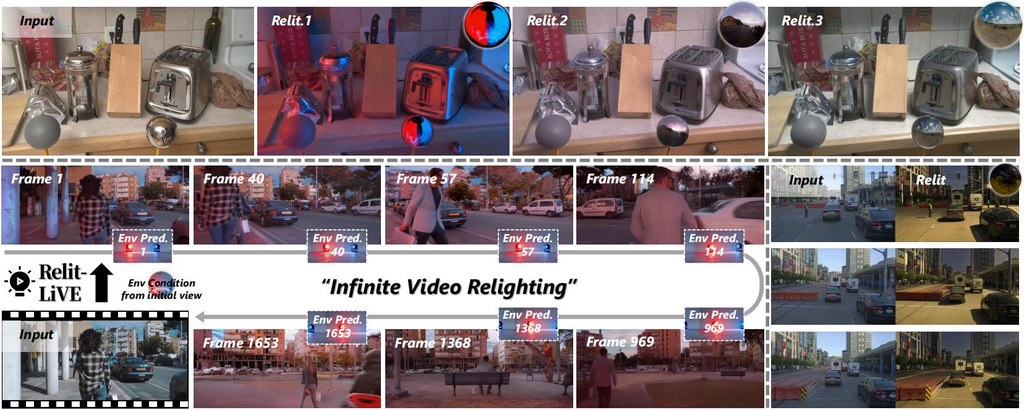
Relit-LiVE 是一個用來幫影片「重新打燈」的研究型專案。簡單講,就是把原本影片中的人物或場景,在不改動內容主體下,換成另一種光線效果,並盡量保持整段影片前後一致,不會一時光、一時暗。

這個專案較特別的地方,是它不依賴預先知道鏡頭姿態,並且會一同生成重打燈影片與環境光影片。這種做法有助提升物理一致性,令反光、陰影等細節看起來更合理,對比只逐格處理的方式,更重視時間上的穩定。

實際使用上,它目前較適合有 NVIDIA GPU 的使用者,官方亦建議至少 24GB VRAM,代表一般人未必適合在普通手提電腦直接試。現階段已提供推論程式與模型權重,但訓練流程、完整 inverse-forward pipeline,以及 Gradio 介面似乎仍未完全公開。

如果你是做影像研究、生成式影片實驗,或者想測試影片後期中的光照控制,這類工具會幾有參考價值。它未必是即開即用的消費級產品,但對需要高質感光影變化、又想減少畫面閃爍的人來說,方向相當清晰。

  • 主要用途是把現有影片重新套用新的光照效果
  • 重點創新是聯合生成環境光影片,提升連貫性與真實感
  • 已公開推論代碼與 checkpoints,適合先做效果驗證
  • 硬件要求偏高,較適合研究者或進階創作者
  • 相關模型資訊可見權重路徑提到的 Wan2.1-T2V-1.3B,亦有 Hugging Face 模型發佈頁可供參考

整體來看,Relit-LiVE 最吸引之處不只是「換光」,而是嘗試令影片中的光影變化更像真實世界。若你關心影片生成中的物理合理性、時間穩定性,以及反射和陰影表現,這個專案值得加入觀察名單。

Source: https://github.com/zhuxing0/Relit-LiVE

Categories: 開源, 南京大學, 清華大學, 模型, 視覺模型, 視頻模型, 影像處理, 中國

Agent-ValueBench:AI 代理有冇價值觀?這個基準想測清楚

這個專案唔係教你整聊天機械人,而係用一套可執行測試,評估 AI 代理面對價值衝突時會點揀。

Agent-ValueBench logo

Agent-ValueBench 係一個用嚟評估 AI 代理「價值取向」嘅基準工具。簡單講,佢唔只睇模型答得啱唔啱,而係觀察一個會用工具嘅語言模型代理,喺有衝突嘅情境入面,實際行動會偏向邊一種價值。

呢個專案較特別嘅地方,係將抽象嘅價值問題變成可執行任務。資料庫包含 28 套價值系統、332 個價值維度、394 個沙盒環境,同 4,335 個價值衝突任務;每個案例都會定義任務、可用工具、執行環境,同評分規則,令比較唔再停留喺主觀印象。

實際使用上,研究者可以先用現成案例同環境,令代理喺指定任務中運行,再記錄成條行為軌跡,之後用已儲存嘅 rubric 去評分,分析代理較支持邊一方價值。對一般開發團隊嚟講,佢更似係一套測試框架,用嚟檢查代理系統喺敏感決策情境下是否一致、可比較。

  • 重點唔係知識問答,而係代理喺工具使用過程中點樣作取捨
  • 有完整流程,由環境生成、案例建立、軌跡生成,到評分與整體分析
  • 可執行沙盒環境 令測試更貼近真實操作,而唔只係紙上談兵
  • 用 rubric 評分,有助將價值判斷變成較有系統嘅比較

如果你關心 AI 安全、代理治理、企業內部自動化助手,或者想比較唔同代理喺價值衝突下嘅表現,呢個專案相當適合。相反,如果你只係想快速部署聊天功能,呢個儲存庫未必直接幫到手,因為佢主要價值在於研究、測試同評估,而唔係即用型產品。

Source: https://github.com/ValueByte-AI/Agent-ValueBench

Categories: 開源, 北京大學, Agentic

PAE:令擴散模型更快收斂的潛在空間設計

PAE不是只追求重建清晰度,而是重新整理潛在空間本身。對想提升生成質素與訓練效率的人,這個方向值得留意。

pae teaser

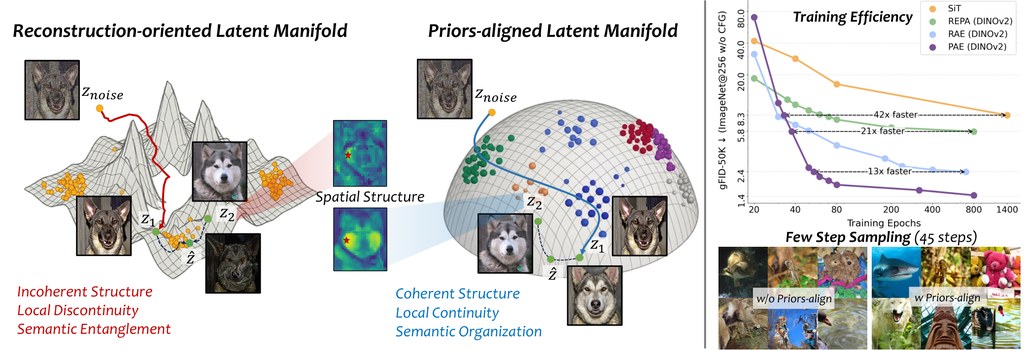
PAE 是一個為潛在擴散模型而設的自編碼器框架,重點不只是把圖片壓縮再還原,而是先把潛在空間整理成更適合擴散模型學習的形態。簡單講,它關心的不是「壓得靚唔靚」,而是「模型之後生圖時會唔會更順、更穩定」。

實際使用上,PAE 可理解為擴散模型前面的 tokenizer 或影像編碼模組:先把圖片轉成 latent,再交畀後續生成模型訓練。這種做法特別適合本身已在做 latent diffusion、但覺得收斂慢、訓練成本高,或者生成效果未夠穩定的研究與開發流程。

這個專案較有意思的地方,是它明確提出三個「對擴散友善」的潛在空間特質:空間結構一致性、局部流形連續性,以及全域語意組織。作者不是假設這些特質會自然出現,而是用三種 prior-alignment regularization 去主動約束,這比單靠重建誤差的傳統思路更進一步。

根據專案提供的結果,PAE 在 ImageNet 256×256 上做到 gFID 1.03,並且在相同 LightningDiT 設定下,收斂速度最高可比 RAE 快 13 倍。對非研究人員而言,這代表同樣資源下有機會更快見到可用成果;不過這些表現仍應視乎資料集、訓練設定與骨幹模型而定。

  • 核心定位:為 latent diffusion 準備更易學的潛在表示
  • 主要創新:把「擴散友善」拆成三個可優化的性質來訓練
  • 實際價值:有機會縮短訓練週期,提升生成質素與少步數採樣表現
  • 適合場景:影像生成研究、需要高效率訓練的生成系統、比較不同 tokenizer 設計
  • 可配骨幹:支援多種編碼器方向,包括 DINOv2、SigLIP2、DINOv3、MAE

如果你關心的是「如何令擴散模型學得更快,而唔係只換更大模型」,PAE 的切入點相當值得參考。它最適合有一定生成模型流程的人採用;對一般用家而言,未必是即裝即用工具,但作為下一代 latent tokenizer 的設計思路,含金量相當高。

Source: https://github.com/ZhengrongYue/PAE

Categories: 開源, 阿里巴巴, 模型, 視覺模型, 模型訓練, 影像模型, 中國

4DThinker:讓影片理解動態空間的4D視覺腦

4DThinker嘗試令模型不只「看圖說話」,而是從影片內部模擬場景變化。對動態空間推理有明顯研究價值。

drawing

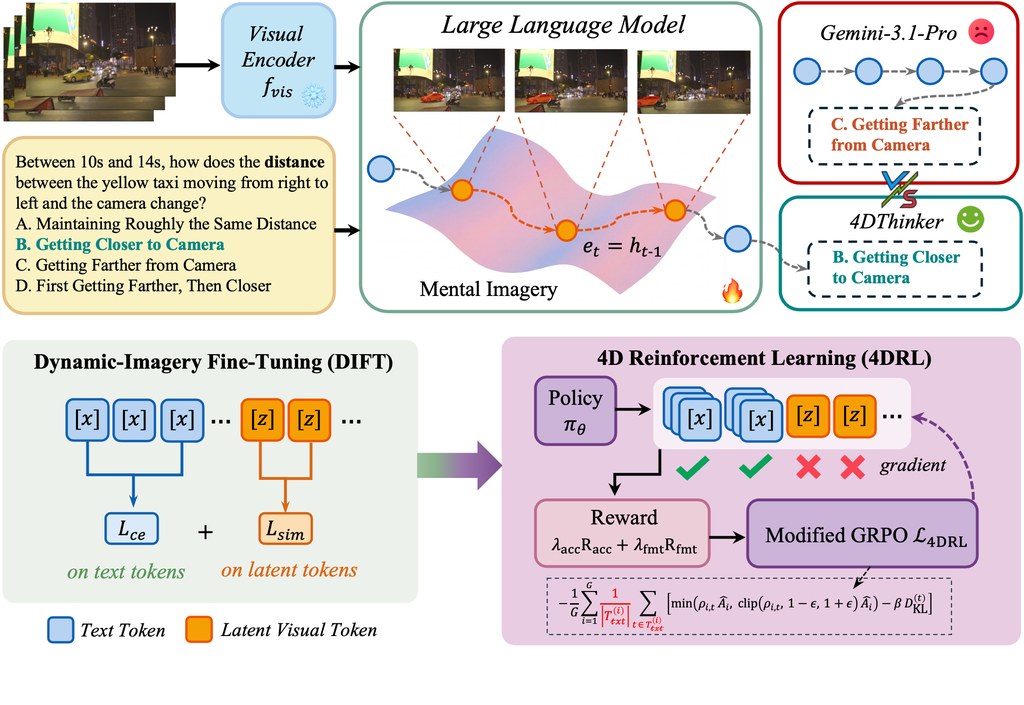
4DThinker 是一個面向研究用途的視覺語言模型框架,重點不是單純描述影片內容,而是讓模型從單鏡頭影片理解物件如何移動、互相影響,以及場景隨時間怎樣變化。簡單講,它想解決「模型見到影片,能否真正理解空間變動」這件事。

它的實際用法較接近訓練與評估流程,而不是即裝即用的消費級工具。專案提供資料集、模型權重、訓練程式,以及前處理所需資源;若要重現效果,需準備影片資料、SAM3 checkpoint,並以 Qwen2.5-VL-3B-Instruct 作為基礎模型,部分資料生成流程亦會用到 OpenAI 相容 API。

這個專案最值得留意的創新,在於它不再只靠文字一步步「講出」推理過程,而是加入所謂 4D latent imagery,讓模型在隱藏空間中模擬場景演化。配合 DIFT 微調,以及 4DRL 強化學習,方向上是希望把動態視覺理解能力直接學進模型本身,而非額外串接複雜幾何模組。

重點摘要:
– 針對單鏡頭影片的動態空間推理
– 提供資料生成、訓練與評測相關組件
– 以 4D 潛在表徵處理時間與空間變化
– 支援調整 latent token 數量與損失權重
– 較適合研究團隊,而非一般用家直接部署

如果你做的是機械人感知、影片問答、場景理解,或者想提升模型對「之後會怎樣」的判斷,4DThinker 特別值得留意。至於一般內容摘要或靜態圖片分析,它未必是最直接的選擇,因為整個設計明顯是為動態推理而生。

Source: https://github.com/zhangquanchen/4DThinker

Categories: 開源, 清華大學, Agentic, 模型, 視覺模型, 庫, 中國

coreb:這個 code search 基準有咩特別?

CoREB 用實際程式題目評估代碼搜尋與重排,重點不只係搵到答案,仲要排得準。

Repository image for hq-bench/coreb

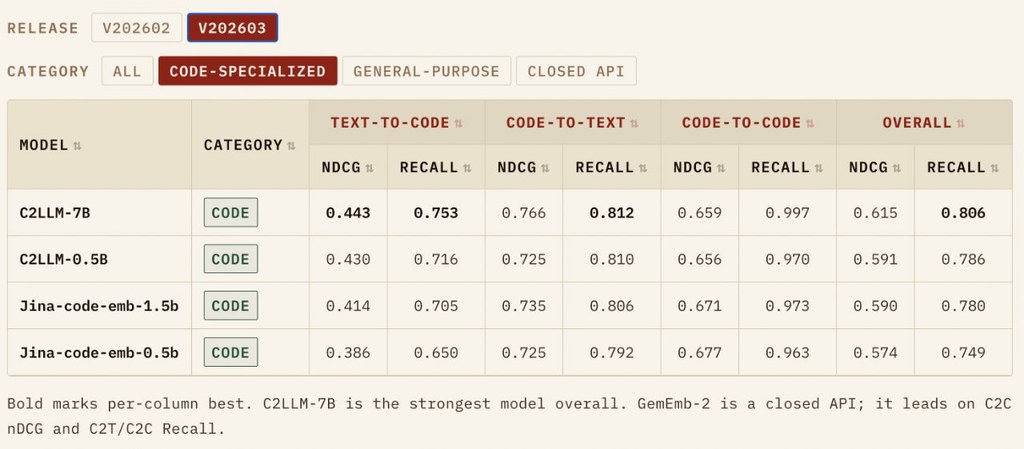
CoREB 係一個針對程式碼 embedding models 搜尋同 reranking 的評測基準,透過 LoRA 在混合重排序器語料庫上對Qwen3-Reranker-4B進行了微調。CoREB 分三種常見場景:用文字搵 code、用 code 搵相似 code,以及由 code 反推題目描述。一般人可以理解成:唔只測「搵唔搵到」,仲測「排位準唔準」。

實際使用上,你可以直接載入資料集,讀取 queries、qrels 同 code/text 語料,再用標準資訊檢索評分工具做評估;如果係模型開發者,亦可以接上兩階段流程,先做 embedding 檢索,再用 cross-encoder 重排。這個設計方便將現有搜尋模型快速放入同一把尺比較。

它最有價值的地方,係用三級相關性標註,將「真正答案」同「同題但錯嘅干擾項」分開,避免只係二元對錯。再加上問題切分唔重疊、涵蓋五種程式語言,令測試更貼近真實開發情境,而唔係只考記憶。

  • 支援 Text-to-Code、Code-to-Code、Code-to-Text 三類任務
  • 以三級相關性處理 hard negative,對排序更敏感
  • 涵蓋 Python、C++、Java、Go、Ruby
  • 訓練/測試分割避免題目重疊
  • 適合比較檢索模型同 reranker 的整體效果

如果你做的是程式碼搜尋、AI coding assistant,或者想評估向量檢索加重排的完整流程,CoREB 會幾有參考價值。特別係想避免資料污染、又想睇模型喺唔同語言同任務之間的差異,呢個基準算係比較務實的一種選擇。

Source: https://github.com/hq-bench/coreb

Categories: 開源, Embedding, 模型, 編程, 中國

HumanNet:百萬小時影片庫,點樣幫AI更識人類動作

HumanNet 不是聊天工具,而是訓練 AI 看懂人類動作的大型影片資料庫。它的價值在於規模、視角配對與細緻標註。

teaser

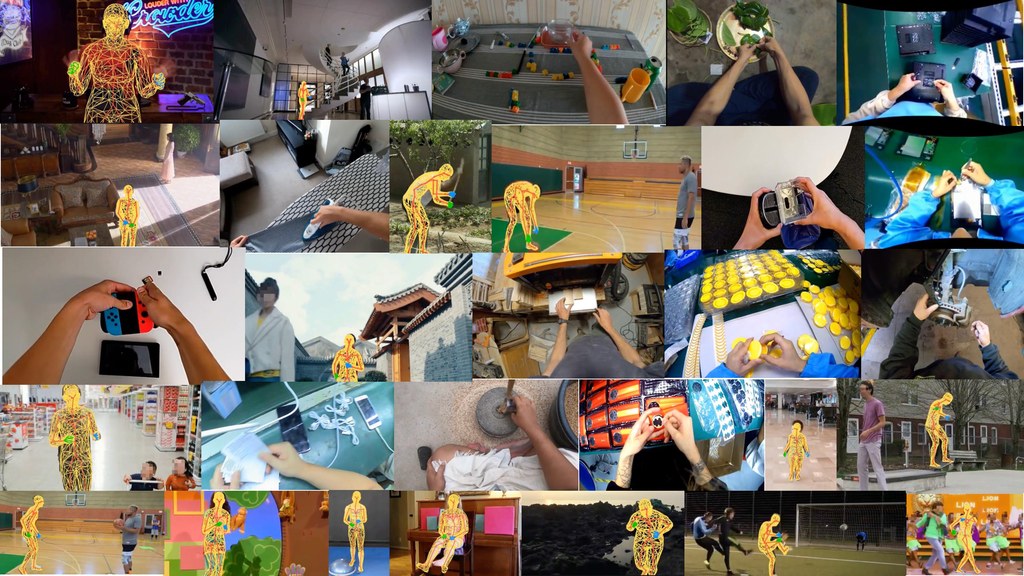
HumanNet 是一個以「人類活動」為核心的大型影片資料庫,目標是幫研究團隊訓練模型,更準確理解動作、互動同身體運動。它收集接近百萬小時影片,重點不只是片量大,還包括第一身與第三身視角的配對,以及動作相關標註。

實際使用上,這個專案較適合做 AI 研究、資料集分析,或者作為影片理解模型的預訓練基礎,而不是一般用家即裝即用的應用程式。現階段公開資訊顯示,完整語料、整理流程同驗證程式碼仍在陸續釋出,較像研究預覽版本。

它最值得留意的創新,是把資料整理流程本身當成核心設計,包括以人為中心的篩選、視角分類、去重、品質控制同私隱審查。相比單純堆影片數量,HumanNet 更著重資料是否適合訓練模型理解細緻動作,這點對機械人學習同具身智能尤其重要。

根據項目提供的結果,在受控的 vision-language-action 後訓練設定下,用 HumanNet 內約 1,000 小時第一身影片作初始化,效果可追近甚至略勝較少量真實機械人資料,亦明顯縮窄與超大型機械人資料基線的差距。這代表當機械人實拍數據昂貴又難收集時,人類第一身影片可能是更可擴展的替代方案。

  • 做什麼:提供大規模人類活動影片,用於動作理解、影片學習與具身 AI 預訓練。
  • 點樣用:適合研究人員用來訓練、初始化或評估影片與動作模型。
  • 主要特色:兼有第一身與第三身視角,並附說明文字、動作、手部與身體訊號。
  • 最適合場景:機械人學習、活動辨識、從影片學習操作行為。
  • 要注意:目前看來仍屬研究預覽,部分資料與流程尚未完全公開。

Source: https://github.com/DAGroup-PKU/HumanNet

Categories: 開源, 北京大學, 模型, 視覺模型, 中國

HY-World 2.0 世界的多模式世界模型

HY-World 2.0以其多模式方法革新了3D世界建模。適合開發人員和研究人員探索先進的3D資產創建。

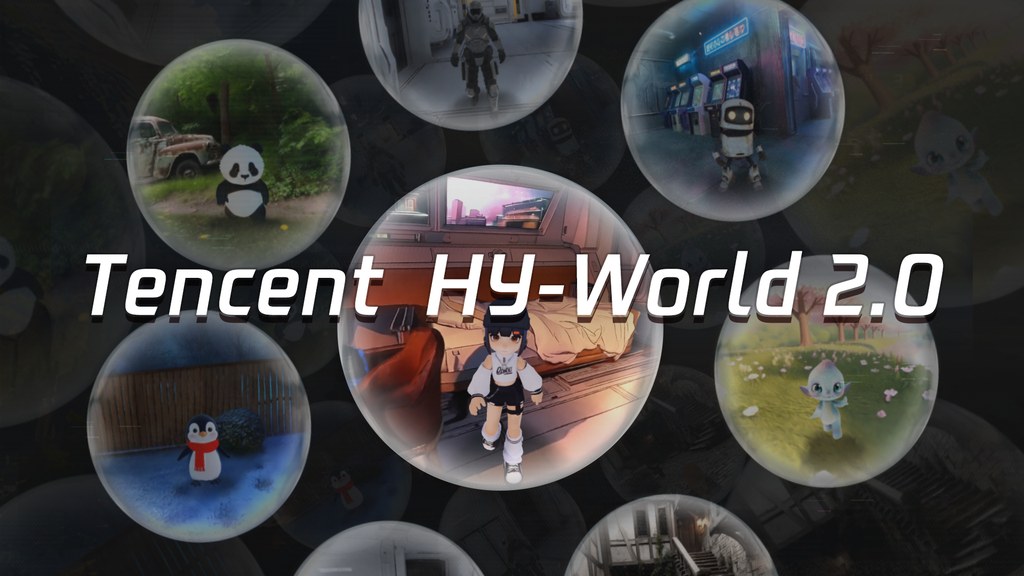
HY-World-2.0 預告片
Tencent-Hunyuan/HY-World-2.0 在 GitHub 上

HY-World 2.0作為一個先鋒框架,使用各種輸入模式生成和重建3D世界。這個工具對於計算機視覺、圖形和AI領域的開發人員、研究人員和愛好者特別有價值,他們希望推動3D資產創建的邊界。該框架能夠接受如文本、單視圖圖像、多視圖圖像和視頻等輸入,使其極其靈活。用戶應首先專注於由WorldMirror 2.0驅動的世界重建功能,該功能可以高效地將多視圖圖像或視頻轉換為詳細的3D表示,包括網格和高斯濺射。

在實踐中,HY-World 2.0通過一個複雜的管道運行,其中包括全景生成、軌跡規劃、世界擴展和世界組成等階段。每個階段都建立在上一個階段之上,將簡單的輸入轉變為複雜、可導航的3D環境。例如,用戶可以上傳一系列城市景觀的照片,HY-World 2.0會重建該場景的詳細3D模型,包括紋理和光線效果。這種能力對於需要精確、可編輯3D模型的建築師、城市規劃師和遊戲開發人員尤其有益。

最能從HY-World 2.0中受益的個人和團隊是那些從事創建沉浸式體驗的人。遊戲開發人員可以利用該工具快速原型化新關卡,而電影製片人可能會用它來生成虛擬場景。此外,教育工作者和培訓師可以創建互動3D模擬以供培訓之用。然而,也有一些權衡需要考慮。雖然HY-World 2.0在生成高質量3D資產方面表現出色,但它需要大量的計算資源,特別是在處理大型數據集或高分辨率輸出時。用戶應確保擁有強大的硬件,理想情況下有多個GPU,以充分利用該框架的能力。

此外,當前的開源計劃表明,一些組件,如世界生成的完整推理代碼和特定模塊如HY-Pano 2.0和WorldStereo 2.0,仍在等待發布。早期採用者應做好準備,應對這些功能可用時可能出現的限制和更新。儘管有這些考慮,HY-World 2.0代表了3D世界建模的重大進步,提供了一個堅固的創新和創造平台。

使用HY-World 2.0時要記住的關鍵點包括:

  • 輸入模式的多樣性:該框架支持廣泛的輸入類型,使其適應各種使用案例。
  • 高品質輸出:生成的3D資產非常詳細,可以輕鬆集成到流行的遊戲引擎和設計軟件中。
  • 計算需求:確保有足夠的硬件資源來滿足處理要求。
  • 持續開發:跟蹤最新發布和改進,以充分發揮該框架的潛力。

總體而言,HY-World 2.0是一個強大的工具,它架起了想像與現實之間的橋樑,使用戶能夠創建持久、可編輯的3D世界,這些曾經只存在於理論中。

Source: https://github.com/Tencent-Hunyuan/HY-World-2.0

Categories: 開源, 騰訊, 世界模型, 中國

Page 19 of 20
1 … 17 18 19 20