Qwen3.6-Plus 專為 Agentic AI 設計的模型

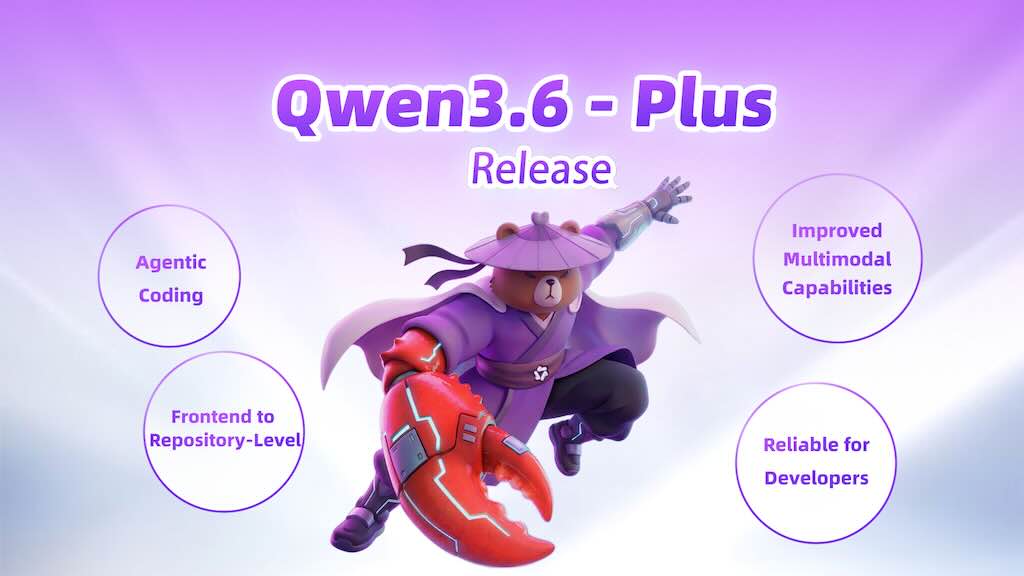
Qwen3.6-Plus 顯著增強了模型的智能體(Agent)編程能力。無論是前端網頁開發,還是複雜的代碼倉庫級問題求解,Qwen3.6-Plus 均樹立了全新的業界標桿(SOTA)。此外,Qwen3.6-Plus 對世界的感知更加精准,多模態推理能力也更為敏銳。本次發佈直接回應了社區在 Qwen3.5-Plus 部署期間反饋的意見,為開發者生態提供了高度穩定可靠的基礎,帶來真正具有變革意義的“氛圍編程”(Vibe Coding)體驗。 官方已提供 OpenClaw 整合,編輯 ~/.openclaw/openclaw.json

Qwen3.6-Plus 顯著增強了模型的智能體(Agent)編程能力。無論是前端網頁開發,還是複雜的代碼倉庫級問題求解,Qwen3.6-Plus 均樹立了全新的業界標桿(SOTA)。此外,Qwen3.6-Plus 對世界的感知更加精准,多模態推理能力也更為敏銳。本次發佈直接回應了社區在 Qwen3.5-Plus 部署期間反饋的意見,為開發者生態提供了高度穩定可靠的基礎,帶來真正具有變革意義的“氛圍編程”(Vibe Coding)體驗。
官方已提供 OpenClaw 整合,編輯 ~/.openclaw/openclaw.json

{
  "models": {
    "mode": "merge",
    "providers": {
      "bailian": {
        "baseUrl": "https://dashscope.aliyuncs.com/compatible-mode/v1",
        "apiKey": "DASHSCOPE_API_KEY",
        "api": "openai-completions",
        "models": [
          {
            "id": "qwen3.6-plus",
            "name": "qwen3.6-plus",
            "reasoning": true,
            "input": ["text", "image"],
            "contextWindow": 1000000,
            "maxTokens": 65536
          }
        ]
      }
    }
  },
  "agents": {
    "defaults": {
      "model": {
        "primary": "bailian/qwen3.6-plus"
      },
      "models": {
        "bailian/qwen3.6-plus": {}
      }
    }
  }
}
Categories: 阿里巴巴, Agentic, Vibe Coding, OpenClaw, 中國

Qwen3.5-Omni 多模態模型

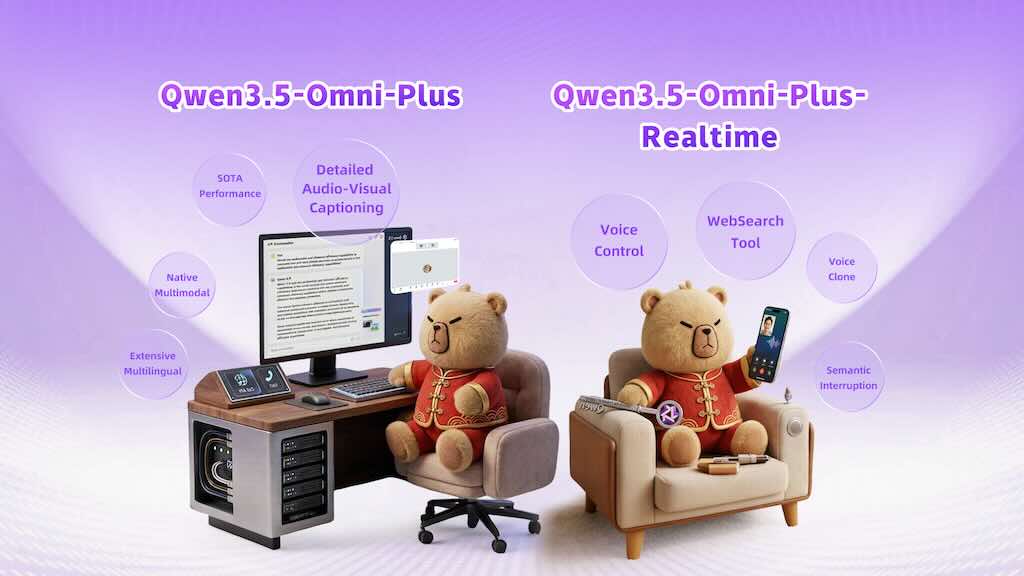
Qwen3.5-Omni 是 Qwen 最新一代全模態大模型,支持文本、圖片、音頻、音視頻理解。結構上,Qwen3.5-Omni 的 Thinker 與 Talker 均採用 Hybrid-Attention MoE 架構。Qwen3.5-Omni 系列包含 Plus、Flash、Light 三種尺寸的 Instruct 版本,支持 256k 長上下文,模型支持超過 10 小時的音頻輸入及超過 400 秒的 720P(1 FPS)音視頻輸入。模型在海量文本、視覺以及超過 1 億小時的音視頻數據上進行原生多模態預訓練,該模型展現出卓越的全模態感知與生成能力。相比 Qwen3-Omni,Qwen3.5-Omni 多語言能力大大增強,能夠支持 113 種語種和方言的語音識別和 36 種語種和方言的語音生成。目前可通過 Offline API 和 Realtime API 進行體驗。 Qwen3.5-Omni Thinker 通過 Vision Encoder 和 AuT 接受視覺和音頻信號輸入,音視頻信號通過 interleave 交織並搭配 TMRoPE 編碼位置信息。Thinker 負責處理全模態信號並輸出文本,Talker 負責接收來自 Thinker 的多模態輸入以及文本輸出,進行 […]

Qwen3.5-Omni 是 Qwen 最新一代全模態大模型,支持文本、圖片、音頻、音視頻理解。結構上,Qwen3.5-Omni 的 Thinker 與 Talker 均採用 Hybrid-Attention MoE 架構。Qwen3.5-Omni 系列包含 Plus、Flash、Light 三種尺寸的 Instruct 版本,支持 256k 長上下文,模型支持超過 10 小時的音頻輸入及超過 400 秒的 720P(1 FPS)音視頻輸入。模型在海量文本、視覺以及超過 1 億小時的音視頻數據上進行原生多模態預訓練,該模型展現出卓越的全模態感知與生成能力。相比 Qwen3-Omni,Qwen3.5-Omni 多語言能力大大增強,能夠支持 113 種語種和方言的語音識別和 36 種語種和方言的語音生成。目前可通過 Offline API 和 Realtime API 進行體驗。

Qwen3.5-Omni Thinker 通過 Vision Encoder 和 AuT 接受視覺和音頻信號輸入,音視頻信號通過 interleave 交織並搭配 TMRoPE 編碼位置信息。Thinker 負責處理全模態信號並輸出文本,Talker 負責接收來自 Thinker 的多模態輸入以及文本輸出,進行 contextual 語音生成,語音表徵通過 Qwen3-Omni 提出的 RVQ 編碼來替代繁重的 DiT 運算。由於 chunk-wise 的流式輸入設計和流式 Talker 設計,整個模型可以進行 realtime interaction。不同於上一代 Qwen3-Omni 的雙軌 Talker 輸入,Talker 在輸入的組織方式上採用了 ARIA(自適應速率交錯對齊,Adaptive Rate Interleave Alignment)來動態對齊文本與語音單元,然後進行交錯排布,以避免由於文本與語音 Token 編碼效率差異導致的語音不穩定性,如漏讀、誤讀或數字發音模糊等問題。

Categories: 阿里巴巴, 多模態模型, 中國

Gen-Searcher 準確同貼近現實圖片

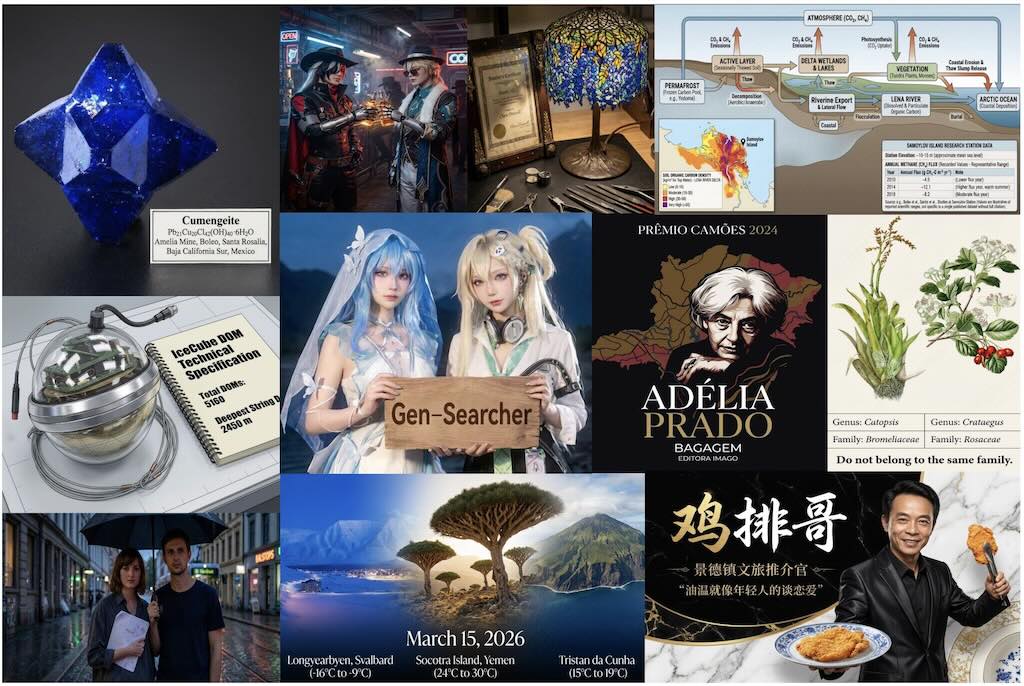
Gen-Searcher 係全球首個專為圖像生成設計嘅多模態深度研究代理,佢會先上網搜尋資料、瀏覽證據同埋搵視覺參考,先至開始繪圖。呢個模型透過專門嘅訓練數據同強化學習,令生成嘅圖片更準確同貼近現實。佢喺多個測試基準上表現出色,仲可以輕鬆轉移應用到唔同嘅圖像生成模型上。所有代碼、模型同數據都已經完全開源,方便開發者直接使用。影像產生使用Qwen/Qwen-Image-Edit-2509 和 FastAPI 進行服務。(MMLab, CUHK)

Gen-Searcher 係全球首個專為圖像生成設計嘅多模態深度研究代理,佢會先上網搜尋資料、瀏覽證據同埋搵視覺參考,先至開始繪圖。呢個模型透過專門嘅訓練數據同強化學習,令生成嘅圖片更準確同貼近現實。佢喺多個測試基準上表現出色,仲可以輕鬆轉移應用到唔同嘅圖像生成模型上。所有代碼、模型同數據都已經完全開源,方便開發者直接使用。影像產生使用
Qwen/Qwen-Image-Edit-2509 和 FastAPI 進行服務。(MMLab, CUHK)

Categories: 開源, 香港中文大學, 影像模型, 庫, 中國

Pulse of Motion 讓影片更自然

Pulse of Motion 讓你在觀看影片時「感覺更舒服」,但看不到技術本身。目前很多生成影片(如 SVD、Pika 等)的動作時間常常跑偏,作者稱這種現象為 chronometric hallucination,也就是「看起來平滑但實際上時間尺度錯亂」。 現在很多生成模型會「時間錯亂」角色走路太快/太慢;手勢、動作和音效不搭;看起來動作很順,但「感覺怪怪的」。這套技術可以用來:調整生成模型的輸出(例如:自動快慢放或重採樣),讓影片「更像真實拍攝」,看起來更舒服。自動檢測影片的 真實時間尺度;

Pulse of Motion 讓你在觀看影片時「感覺更舒服」,但看不到技術本身。目前很多生成影片(如 SVD、Pika 等)的動作時間常常跑偏,作者稱這種現象為 chronometric hallucination,也就是「看起來平滑但實際上時間尺度錯亂」。

現在很多生成模型會「時間錯亂」角色走路太快/太慢;手勢、動作和音效不搭;看起來動作很順,但「感覺怪怪的」。這套技術可以用來:調整生成模型的輸出(例如:自動快慢放或重採樣),讓影片「更像真實拍攝」,看起來更舒服。自動檢測影片的 真實時間尺度;

Categories: 開源, 視頻模型, 影像處理, 中國

Page 20 of 20
1 … 18 19 20