AHA-WAM:讓機械人決策一致的世界動作模型

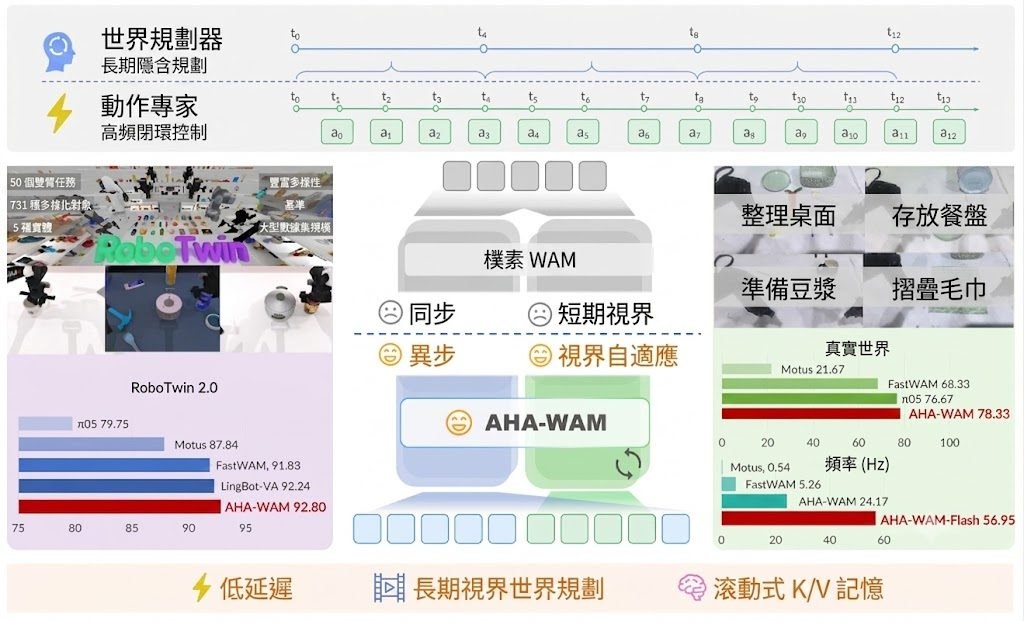
AHA-WAM 透過分離長程規劃與高頻動作執行,解決機械人策略中節奏錯位的難題,並在模擬與真實環境均創下新高成功率。

PDF

機械人學習操作技能時,往往要把「預測未來畫面」和「即時輸出動作」綁在同一個節奏上,導致規劃與控制互相拉扯。上海交通大學、百度智能雲及上海人工智能實驗室等團隊提出的 AHA-WAM(Asynchronous Horizon-Adaptive World-Action Modeling)項目,就是要把兩者拆開來處理。

核心架構:雙分支異步運作

AHA-WAM 採用兩個 Diffusion Transformer(DiT)分支:低頻的 video DiT 負責長程的視覺世界規劃,並利用滾動式 K/V 記憶體儲存可重用的上下文;高頻的 action DiT 則接收本體感覺訊號,向 video DiT 查詢所需上下文後,即時產生短時閉環動作區塊。兩者各司其職,避免互相拖累。

兩項關鍵訓練與推論機制

  • Horizon-Adaptive Offset Training(水平自適應偏移訓練):讓執行器在規劃器與執行器出現相位差時仍能穩定運作。
  • Observation-Guided Video-Context Routing(觀察引導的視覺上下文路由):根據最新觀察調整快取的規劃上下文,無需重新運行 video DiT 即可對齊當下狀態。

實測表現亮眼

在 RoboTwin 2.0 模擬環境的 50 項雙臂任務中,AHA-WAM 達到 92.80% 平均成功率,且無需任何機械人數據預訓練;在四項原始設定的真實雙手任務中則取得 78.33% 成功率。控制頻率方面,閉環頻率達 24.17Hz;經 ODE 蒸餾的輕量版 AHA-WAM-Flash 更可達 56.95Hz,相比 Fast-WAM 提升約 10.82 倍。

AHA-WAM 適合研究世界模型、機械人操控策略,以及追求高頻閉環控制的開發團隊;其異步架構亦為離線規劃與即時控制分離的設計思路提供新參考。

項目: https://serene-sivy.github.io/aha-wam/

Categories: 開源, 香港大學, 上海人工智慧實驗室, 模型, 視頻模型, 世界模型, 百度

SpatialWorld:測試多模態代理空間理解的統一基準

SpatialWorld 用統一介面評估多模態代理在 3D 任務中的空間理解。數據亦顯示,現有模型距離可靠完成任務仍有明顯差距。

SpatialWorld framework overview

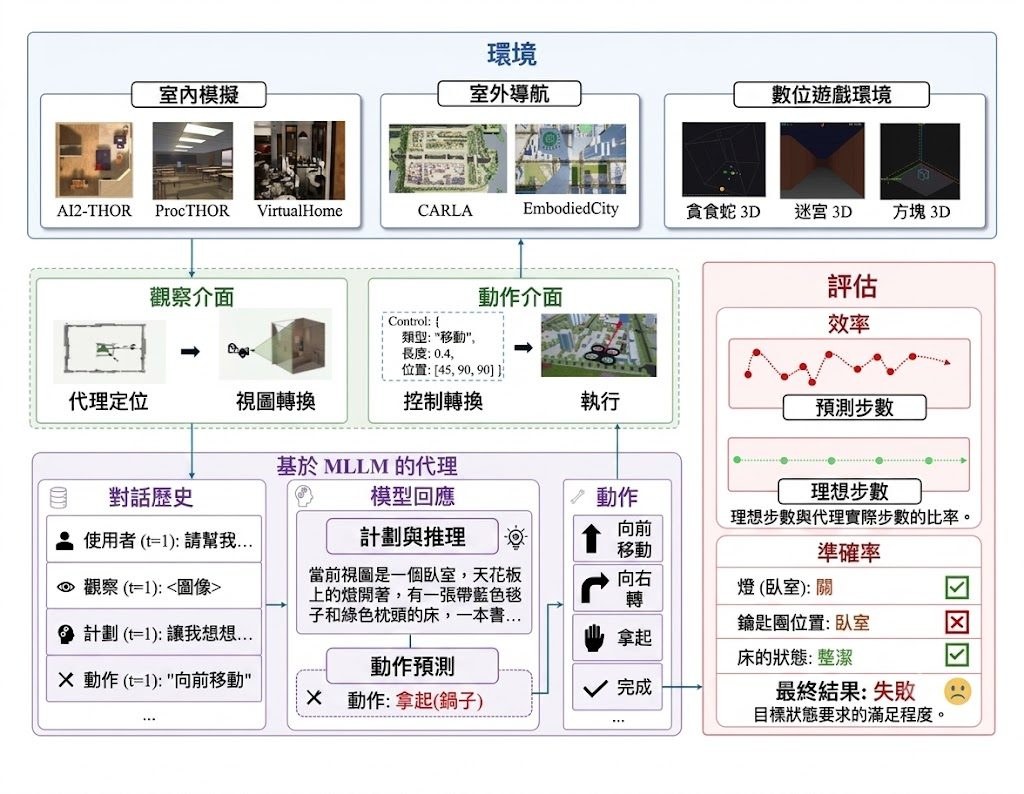
SpatialWorld 是一個用來測試 Multimodal Large Language Models(MLLMs)與代理能力的 benchmark。它把 8 個不同的 3D 模擬後端整合成同一套 observation–action 介面,讓模型只靠自然語言指令、第一身 egocentric RGB 畫面,以及統一的文字動作指令完成任務。

如果你想知道一個模型是否真的懂得在環境中探索、轉向、移動、判斷位置與完成多步驟任務,SpatialWorld 提供了較一致的測試方法。它包含 760 個人工標註任務,覆蓋家居、出行、協作與數碼 3D 遊戲等場景,並以 human-validated terminal-state verifiers 判定結果。

讓代理輸入文字動作,例如 Move、Rotate,再由 action parser 轉成各個模擬器原生指令。這種做法的重點,是避免每個 simulator 各有一套流程,令不同模型之間較容易作橫向比較。

  • 統一 8 個 3D backends,減少 simulator-specific pipelines 帶來的比較困難
  • 只提供 vision-only partial observability,更接近代理逐步探索的情況
  • 除了 task success rate(TSR),亦會看 step efficiency(SE),不只比較有沒有完成
  • 已評估 15 個代理,方便對照現有模型表現

從公開結果看,這個項目揭示了目前模型的限制。GPT-5 的平均 TSR 為 17.4%,領先的 open-source 模型 Qwen-3.5 為 14.1%;若看 Physical Overall TSR,GPT-5 只有 14.4%,Qwen-3.5-397B-A17B 為 12.2%。這表示模型即使能理解圖片與文字,也未必能穩定完成需要空間推理與長步驟規劃的任務。

相關模型有 GPT-5、Qwen-3.5、Qwen-3.5-397B-A17B 與 Gemini-3.1-Pro,其中 Gemini-3.1-Pro 在 digital 3D games 達到 39.0% TSR。若你是做 agent、embodied AI、MLLM 評測,或者想比較不同模型在互動式空間任務的差異,SpatialWorld 會是一個很有參考價值的項目。

GitHub: https://github.com/Hongcheng-Gao/SpatialWorld

項目: https://spatial-world.github.io/

Categories: 香港大學, 北京大學, 清華大學, 多模態模型, 框架

Echo-Memory 讓世界模型認得回家的路

當 AI 影片模型控制鏡頭離開某個場景再折返時,常常會「認錯地方」——同一條街、同一件家具,回來時卻變成另一個看起來合理、但其實陌生的世界。

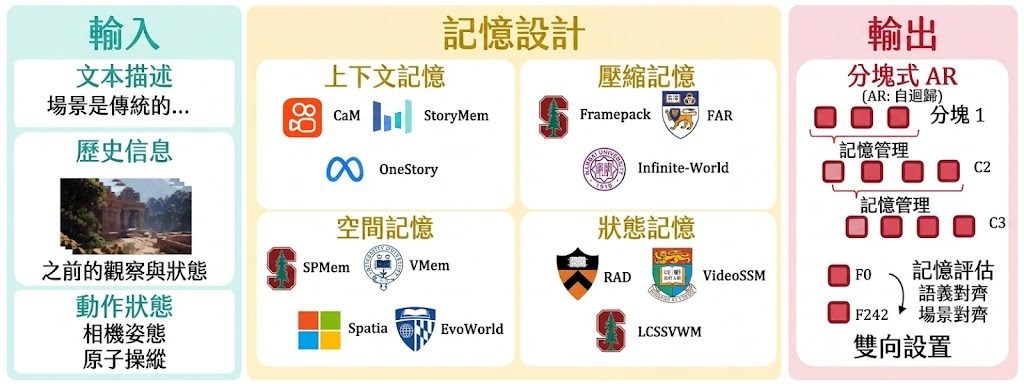
Echo-Memory paper teaser and workflow

當 AI 影片模型控制鏡頭離開某個場景再折返時,常常會「認錯地方」——同一條街、同一件家具,回來時卻變成另一個看起來合理、但其實陌生的世界。Echo-Memory 想解的,正是這個讓生成影片失去一致性的老問題。整個研究的設計非常克制:只更換「記憶模組」,其餘一概不動。

Echo-Memory 以同一套 Wan 2.1 1.3B 動作到影片(action-to-video)模型作為共用底座,把記憶方式分成四大類——Context(原始幀滑窗)、Compression(壓縮後的學習 token)、Spatial(顯式空間讀寫狀態)、State-Space(區塊式 SSM 遞迴更新)。所有變體都掛在相同的寫入—讀取介面上,差別只在於「存什麼」和「怎麼取回」。這種單一變因的設定,讓四種記憶家族的表現可以乾乾淨淨地比較。

對研究員和工程師而言,項目提供了開發者指南。Echo-Team 已把訓練到 30,000 步的 Wan 2.1 1.3B 權重放在 Hugging Face 的 Echo-Team/Echo-Memory,並附上 SpatialVID 子集的動態訓練池設定文件,開發者指南亦提供中英雙語流程。評測方面,項目提供 GT replay、in-domain 180 度折返,以及 open-domain 編輯式回訪三種探測腳本,涵蓋靜態回放和場景重訪兩個維度。

要注意的是,目前的權重僅限 Wan 2.1 1.3B(epoch-0),Wan 2.2 以及 5B/14B 多尺度底座、以及超越靜態重訪的動態評測,仍列在路線圖上等待補齊。對於研究世界模型長期一致性、做可控影片生成,或是想在 LoRA/記憶外掛(memory adapter)方向動手的人,這個項目提供了一個難得的可重現基準;對一般讀者來說,它也示範了當鏡頭「回家」時,AI 為何會迷路、又該怎麼讓它記路。

重點摘要:

  • 統一底座、只換記憶:以 Wan 2.1 1.3B 為共用骨幹,比較 Context、Compression、Spatial、State-Space 四種記憶家族。
  • 可控變因設計:所有模組共享寫入—讀取介面,差異集中在「存什麼、怎麼取回」。
  • 完整可重現資源:公開 30,000 步權重、SpatialVID 訓練池設定、雙語開發者指南與評測腳本。
  • 三種回訪探測:GT replay、in-domain 180 度折返、open-domain 編輯式回訪,分別檢驗重播與折返記憶。
  • 未來路線:Wan 2.2、5B/14B 多尺度底座與動態評測仍待補齊。

GitHub: https://github.com/Echo-Team-Joy-Future-Academy-JD/Echo-Memory

項目: https://echo-team-joy-future-academy-jd.github.io/Echo-Memory/

Categories: 開源, 香港大學, 香港科技大學, 北京大學, 清華大學, 框架

AffordanceVLA:為機械臂加入「先想再做」的能力

這項目把視覺、語言與動作三者之間的落差,透過三段式可供性預測串起來,讓機械臂在執行指令前先理解該碰哪裡、怎麼碰。

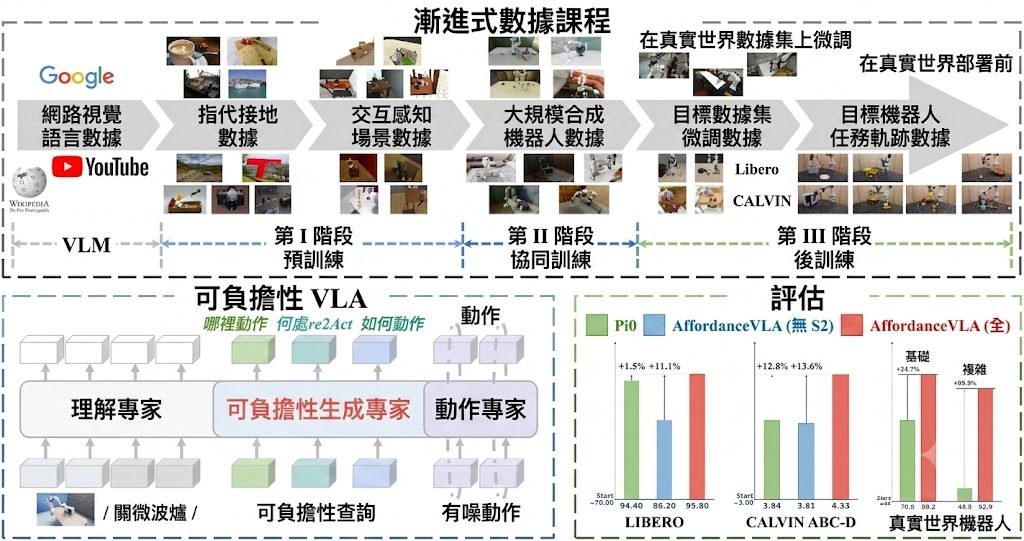
AffordanceVLA overview

機械臂聽到「把杯子拿起來」這類指令時,傳統的視覺語言動作模型(Vision-Language-Action Model, VLA)往往要直接把影像和文字翻譯成關節角度,中間欠缺一個「思考」步驟。AffordanceVLA 嘗試在這個鴻溝上架一道橋:先讓模型預測結構化的可供性(affordance),再據此生成動作。

整個框架由三個專家模型組成,按單向的 UAA 注意力串接。Understanding Expert(M_und)以 PaliGemma(SigLIP + Gemma)為骨幹,把畫面、指令與機械臂自身狀態融合成統一的語意表示。Affordance Generation Expert(M_gen)以 Gemma 搭配可學習查詢,把上述表示解碼為三種可供性標記:Which2Act 判斷要操作的物件、Where2Act 標出二維互動熱區、How2Act 則推估三維幾何資訊。最後 Action Expert(M_act)以 flow matching 方式輸出整段動作序列(action chunk)。這個設計呼應了論文「Affordances serve as a perfect bridge」的核心想法。

由於現成機器人數據集中缺乏密集的可供性標註,作者額外提供了一條自動化標註管線,並以三階段漸進式課程訓練 MoT 架構。訓練時須留意 model.chunk_size 與 data.chunk_size 保持一致,否則動作 attention mask 會錯位;Which2Act 的 Flux loss 預設為 MSE,可在 src/models/which2act_decoder.py 頂端切換。

這個項目適合研究 VLA、機器人操作策略,或對可供性表示有興趣的開發者。需要一支能跑 PaliGemma 與 flow matching 的 GPU 環境,並準備好仿真或實機評測流程。論文中的模擬與真機實驗橫跨多種操作場景,顯示加入可供性中間層能提升泛化與精確度,但具體數字仍以官方報告為準。

重點摘要

  • 以 Which2Act、Where2Act、How2Act 三段式可供性作為視覺、語言與動作之間的中間橋樑。
  • 採用 MoT 架構,串接 PaliGemma 為基礎的 Understanding、Gemma 為基礎的 Affordance 與 Action Expert。
  • 配套自動化可供性標註管線,緩解機器人數據標註不足的問題。
  • 訓練採三階段漸進式策略,flow matching 輸出整段動作序列。
  • 模型、訓練與標註腳本皆隨開源項目釋出,歡迎社群延伸。

GitHub: https://github.com/Skywalker-yqz/AffordanceVLA

Categories: 開源, 香港中文大學, 香港科技大學, 北京大學, 模型, 多模態模型, 模型訓練

LoomVideo:阿里巴巴 5B 模型挑戰統一影片生成

北京大學與阿里合作推出的 LoomVideo 以 5B 參數的輕量架構,解決統一影片生成成本過高的痛點,並帶來顯著的速度提升。

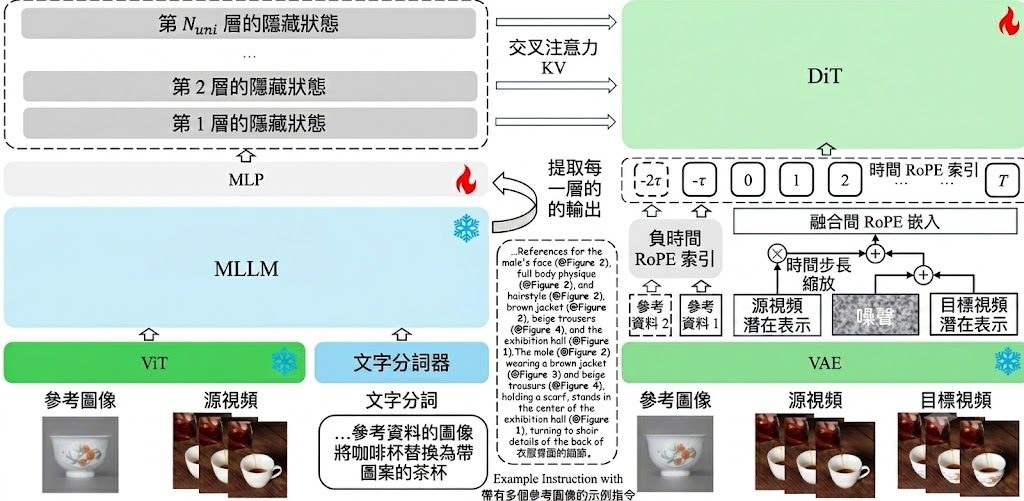
architecture

LoomVideo 由北京大學與阿里巴巴聯合發布,主打「統一多模態輸入的影片生成與編輯」,把文字、影片、圖片等多種輸入整合到同一個模型。傳統的統一影片模型動輒超過 13B 參數,且為了加入來源影片條件,往往要把所有 token 接在一起,導致序列長度翻倍、self-attention 成本暴增四倍。LoomVideo 的核心定位,就是用更小、更快的設計,達到同等甚至更好的效果。

這個項目基於 MLLM(多模態大語言模型)加 DiT(Diffusion Transformer)的組合,並提出三個關鍵設計:Deepstack Injection 從 MLLM 每一層抽取特徵,再透過 cross-attention 注入對應的 DiT 層;Scale-and-Add Conditioning 把乾淨的來源影片潛在變數按時間步長縮放後直接加到雜訊目標上,免去 token 拼接的額外負擔;Negative Temporal RoPE 為參考圖片指定負的時間索引,讓多圖片條件可以無縫整合。

LoomVideo 目前支援四種任務:文生影片、純文字指令編輯、影片加圖片加文字的指令編輯,以及多張參考圖的條件生成,全部由同一個 5B 模型處理。論文報告在多項基準上取得領先或具競爭力的表現,並宣稱比同級模型快至少 5.41 倍。對於電子商務與時尚場景的影片生成,論文也展示了針對性的優勢。

這個項目適合關注影片生成效率的研究者、影像創作工具開發者,以及需要快速生成短影片內容的團隊。目前模型權重已公開在 Hugging Face 的 MSALab/LoomVideo,程式碼亦同步釋出,有興趣的讀者可以直接到 GitHub 與 Hugging Face 取得資源並測試。

重點摘要:

  • 5B 參數的統一影片生成與編輯模型,定位比 13B+ 同類更輕量。
  • 以 MLLM + DiT 架構為基礎,並提出 Deepstack Injection、Scale-and-Add Conditioning 與 Negative Temporal RoPE 三大設計。
  • 支援文生影片、文字指令編輯、影片加圖片文字編輯,以及多圖片條件生成四種任務。
  • 論文聲稱比同級模型快至少 5.41 倍,並在電商與時尚場景表現突出。
  • 模型與程式碼已公開,方便研究者與開發者快速試用與改進。

GitHub: https://github.com/MSALab-PKU/LoomVideo

項目: https://msalab-pku.github.io/projects/LoomVideo/index.html

Categories: 開源, 北京大學, 阿里巴巴, 數字人, 模型, 視覺模型, 視頻模型, 影像處理

WLA:整合世界、語言與動作模型

上海交大 DENG 實驗室發佈的 WLA 模型,把世界建模、語言推理與動作生成三項能力整合於一身,是統一型多模態 AI 的一次新嘗試。

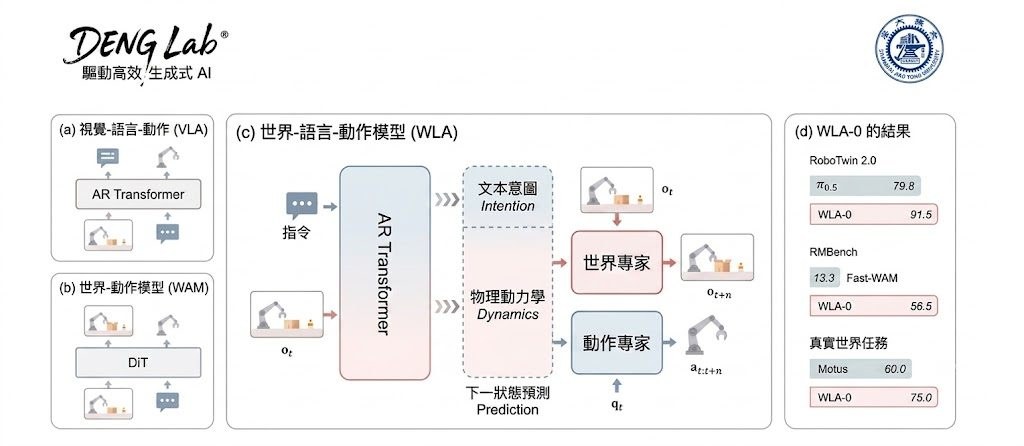
Repository image for SJTU-DENG-Lab/WLA

WLA(World-Language-Action Model)由上海交通大學 DENG 實驗室推出,定位為一個統一世界建模、語言推理與動作合成的官方實現項目。簡單來說,研究團隊嘗試讓同一個 AI 系統同時處理「理解世界」、「理解語言」以及「產生動作」三種任務,而不再需要三個獨立模型分工合作。這對於機器人、遊戲 AI 以及需要即時決策的互動系統來說,是一條值得關注的技術路徑。

目前這個項目仍處於預告階段,程式碼與模型權重計劃在 6 月 18 日之前開源釋出,官方提供了展示影片展示其運作效果。在動手實作方面,潛在使用者短期內只能先關注儲存庫的更新,等待權重釋出後再評估本地部署或 API 整合的可能性,項目本身亦未透露具體支援的模型清單。

這個項目的創新方向,是把感知層、認知層與執行層的概念放在同一個訓練框架下學習,減少傳統流水線中模組之間的介面損耗。對於機器人研究團隊、強化學習開發者,以及探索通用代理人(General-purpose Agent)架構的工程師而言,WLA 提供了一個可參考的新設計樣板。效能數據與基準測試結果,則有待官方釋出後再做比較。

以下整理幾個重點供參考:

  • 統一框架:把世界模型、語言模型與動作模型合而為一,降低多模態系統的整合成本。
  • 學術背景:來自上海交大 DENG 實驗室,屬於官方實作項目。
  • 適用場景:機器人控制、互動式代理人、強化學習等需要即時決策的應用。
  • 目前狀態:程式碼與權重即將於 6 月中前公開,尚未有完整基準評估。
  • 使用建議:在權重釋出前,讀者可先研究展示影片與後續論文,掌握其訓練思路再決定是否整合。

若你正在尋找一個把感知與行動串起來的新框架,WLA 值得加入觀察清單。

GitHub: https://github.com/SJTU-DENG-Lab/WLA

Categories: 開源, 視覺模型, Robotic, 中國

OVO-S-Bench:考驗多模態模型的串流空間智能

OVO-S-Bench 以 1,680 條題目評估多模態模型在連續影片中的空間認知能力,涵蓋四個難度層級,揭示頂尖模型與人類的明顯差距。

OVO-S-Bench overview

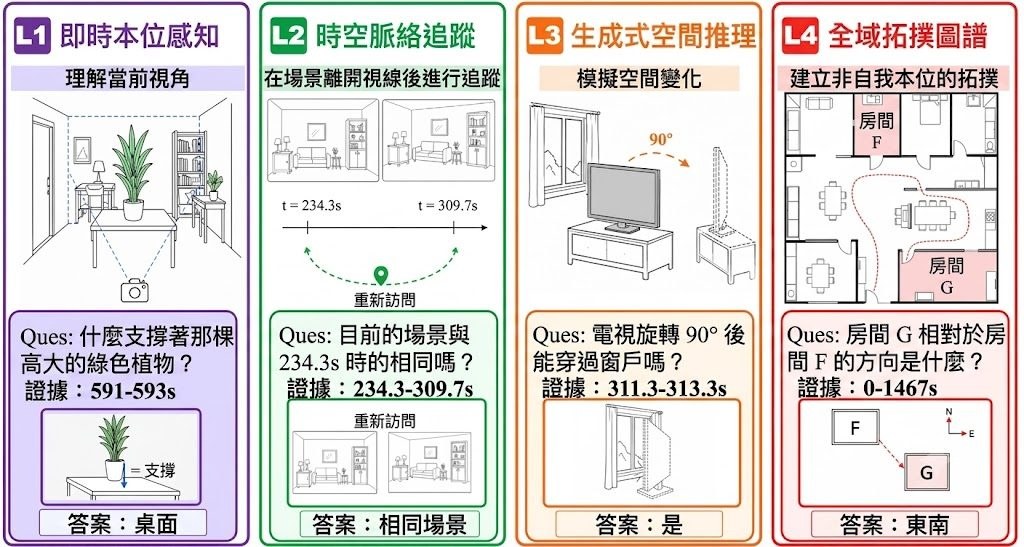
由清華大學、上海 AI 實驗室及北京航空航天大學共同推出的 OVO-S-Bench,是一套專門測試多模態大型語言模型 (Multimodal Large Language Models, MLLMs) 在連續影片中空間理解能力的基準。它針對機械人、AR 眼鏡和自動駕駛等需要「邊看邊想」的真實場景,要求模型根據問題時間點之前看到的畫面片段,推理出地點與佈局的變化,而非讀取整段影片。

題目來源相當多元,涵蓋室內導覽、第一視角活動、戶外場景、駕駛影片及帶有 3D 註解的環境,共 348 段影片。12 位具備 3D 視覺背景的標註員耗時約 804 小時撰寫及反覆核對每條題目,並透過「文字探針」和盲測覆核機制,剔除可憑題幹文字或常識直接答對的題目,確保難度真正來自空間理解。

題目分為四個難度層級,由當下畫面的瞬時感知 (Instantaneous Egocentric Perception)、追蹤離開視野的空間脈絡 (Spatiotemporal Context Tracking)、推測空間變化的生成式推理 (Generative Spatial Reasoning),到建構全局拓樸地圖 (Global Topological Mapping)。在 38 個開源及商用模型的評估中,即使是表現最佳的 Gemini-3.1-Pro,分數仍比人類專家低 27 分 (59.2 比 86.6),全局拓樸層級是最大的樽頸。

更值得留意的是,部分聲稱針對串流或空間任務微調的模型,表現反而不如其底層基座模型;而無根據的思維鏈 (chain-of-thought) 推理,往往會放大空間錯誤。這套基準為下一代串流空間模型提供了清晰且嚴謹的試金石。

重點摘要:

  • 涵蓋 1,680 條人工撰寫題目及 348 段影片,總標註工時約 804 小時
  • 設有問題時間點及證據區間,評估時模型只看到查詢前的影片片段
  • 分為四個遞進難度層級,由瞬時感知到全局拓樸建圖
  • 38 款 MLLM 中,Gemini-3.1-Pro 取得 59.2 分,人類專家為 86.6 分
  • 串流及空間微調模型表現可能反遜於原底座模型

GitHub: https://github.com/InternLM/OVO-S-Bench

項目: https://internlm.github.io/OVO-S-Bench/

Categories: 開源, 清華大學, 上海人工智慧實驗室, 框架

PaddleOCR 把圖片和 PDF 變成 LLM 吃得到的結構化資料

百度開源的 PaddleOCR 已累積逾 7 萬顆星,1.6 版輕量模型在 OmniDocBench 取得 96.33% 分數,為 RAG 與 Agent 應用提供高效率的文檔解析基礎。

Star-history

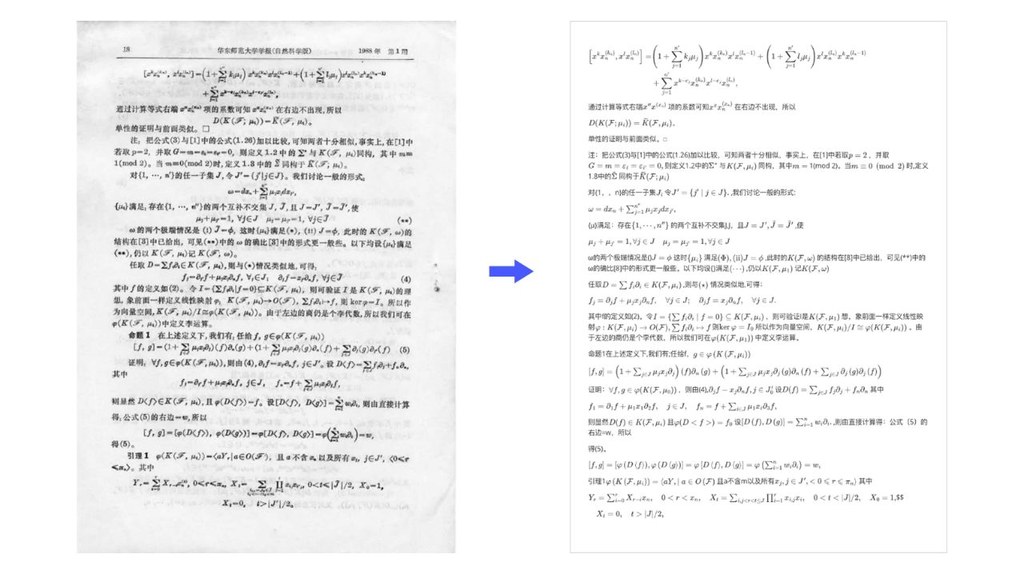
處理 PDF 和圖片一直是企業導入 LLM 應用時最頭痛的關卡,傳統 OCR 工具只會吐出零散文字,遇到表格、公式或多語言混排就頻頻出錯。PaddleOCR 由百度 PaddlePaddle 團隊開源,目標是把雜亂的掃描檔和圖片整理成 LLM 友善的 JSON 或 Markdown,後續無論餵給 RAG 檢索還是 Agent 流程都更順暢。

這個項目以兩個核心模型撐起整套能力。PaddleOCR-VL-1.6 是一款 0.9B 參數的視覺語言模型,專注文件解析,在 OmniDocBench v1.6 取得 96.33% 分數,對古文、罕見字、印章及圖表也有顯著強化。PP-StructureV3 則補足了另一條路線,提供表格儲存格、文字等更細粒度的座標資訊,方便需要版面重建的場景。最新版 PP-OCRv5 支援 100 多種語言,準確度較前代提升約 13%,同時保持輕量部署特性,可在 CPU、GPU、NPU 等不同硬體運行。

目前的 LLM-RAG 開源生態中,Dify、RAGFlow、Cherry Studio 等知名項目都採用 PaddleOCR 作為文件解析層,社群也累積超過 6,000 個依賴它的下游項目。對需要批次處理合約、研究論文、政府公文或多語文件的人來說,這套工具兼具商用級準確度與邊緣裝置可用的效率,動手前只要準備好 Python 3.8 至 3.12 環境即可開始試跑。

重點摘要

  • PaddleOCR-VL-1.6 (0.9B) 在 OmniDocBench v1.6 達到 96.33%,輕量卻具競爭力。
  • PP-StructureV3 補足細粒度座標,適合需要表格與版面重建的應用。
  • PP-OCRv5 支援逾 100 種語言,準確度較前代提升約 13%,硬體需求低。
  • 已被 Dify、RAGFlow、Cherry Studio 等 LLM 應用項目整合採用。
  • GitHub 逾 7 萬顆星、6,000 多個依賴項目,社群驗證度高。

GitHub: https://github.com/PaddlePaddle/PaddleOCR

Paper: https://arxiv.org/pdf/2606.03264

Categories: 開源, 模型, 視覺模型, 中國, Dataset 數據集, 百度

Crafter:把科研圖表交給多智能體助手

Crafter 以多智能體協作方式生成並可後續編輯的學術圖表,搭配 CraftBench 評測集,覆蓋多種類型與輸入條件。

crafter architecture

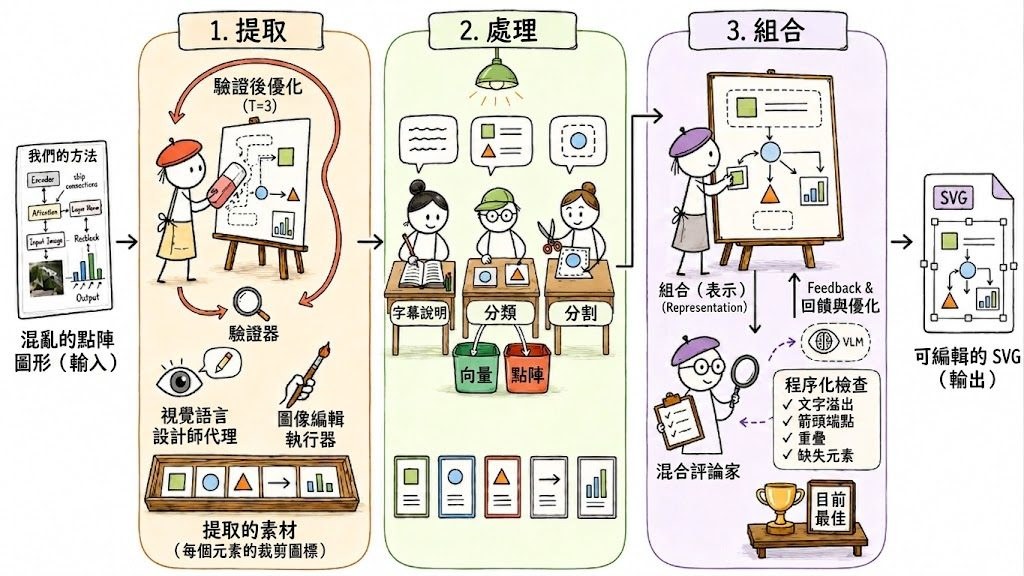
做研究的人都遇過這種困擾:論文裡的圖表要花好幾個小時排版、微調細節,市面上的 AI 生圖工具又常常「整體不錯、局部出錯」,改一個元素就把整張圖搞砸。Crafter 正是針對這個痛點而來,它不是把底層生成模型換得更強,而是在外面包了一層多智能體(multi-agent)協作框架,專門處理「結構化、由離散語意元件組成」的科研圖表。
這個項目分為兩個互補系統。Crafter 負責生成,覆蓋學術圖、海報、資訊圖三種類型,並支援文字生圖、遮罩補完、關鍵元素組合、草圖優化等四種輸入條件,不需要更動架構就能切換。CraftEditor 則把生成的點陣圖轉成「座標精準、可後續編輯」的 SVG 格式,研究者終於可以像在 Illustrator 裡那樣挑出單一元件修改。

為了評估效果,團隊同步釋出 CraftBench——一個 279 筆樣本的基準集,每個樣本都附有人工繪製的參考圖,跨越三種圖表類型與四種輸入條件。在 PaperBanana-Bench 與 CraftBench 上,Crafter 都明顯優於單一生成器與既有的 agentic 基線。CraftEditor 轉出的 SVG 在可編輯性上也勝過所有對照組。

生成部分只要設定 OpenAI 相容端點(例如 OpenRouter)即可跑範例;想啟用 CraftEditor 還需要額外架設一個 SAM3 語意分割伺服器。

重點摘要

  • 解決科研圖表「局部錯誤難修、難以再編輯」的問題
  • 採用多智能體協作框架,不需更換底層模型即可跨類型、跨輸入條件生成
  • 內建 Crafter 生成與 CraftEditor 點陣轉 SVG 兩套流程
  • 釋出 CraftBench 評測集,含 279 筆人工標註樣本
  • 適合需要大量產出與修改學術插圖的研究者、團隊與會議海報設計者

GitHub: https://github.com/HaozheZhao/Crafter

Paper: https://arxiv.org/pdf/2605.30611

Categories: 開源, 北京大學, 清華大學, 框架, 中國, Dataset 數據集

Lumos-Custom:DAMO 學院的影片生成套件

阿里巴巴達摩院(DAMO)開源的影片定制研究項目,涵蓋主體個性化生成、影像重新打光,以及推理驅動的統一影片生成框架。

ETV task prompt

Lumos-Custom 是阿里巴巴DAMO 學院的開源影片定制研究合集,把三個子項目整合在同一個儲存庫,方便研究者各自取用。三個子項目分別對應不同的影片生成難題:身份與屬性定制、打光控制,以及結合推理的統一生成。

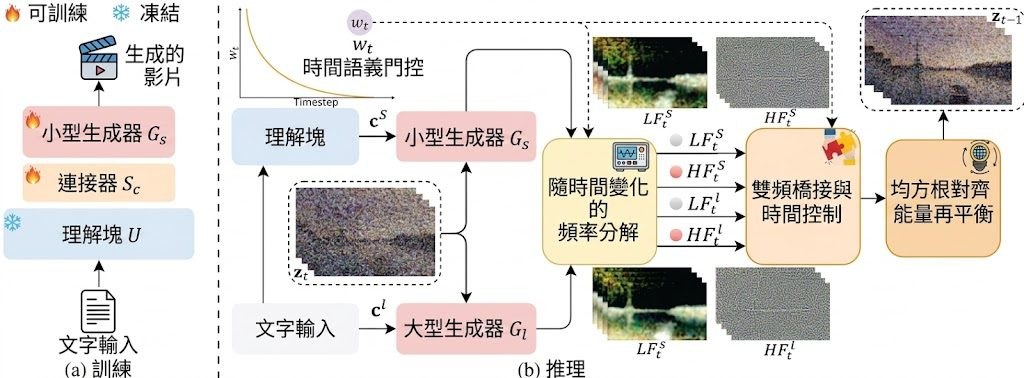
其中最受關注的是 Lumos-Nexus (arXiv 2605.31603)。它解決了一個長期痛點:把大型高保真生成器放進統一訓練迴圈成本太高,改為訓練一個輕量的連接器對齊理解模組,再用「Unified Progressive Frequency Bridging (UPFB)」在推論時把任務交接給預訓練的高容量生成器,既省訓練資源又保留視覺品質。為了補足推理類影片生成的評測空白,作者還發布了 VR-Bench。

第二個項目是 LumosX,已被 ICLR 2026 接收。它的切入點是「多主體個性化影片生成」:先用字幕與 MLLM 抽取的先驗建構關係結構,再透過 Relational Self-Attention 與 Relational Cross-Attention 編碼主體與屬性之間的依賴。評測資源集中在 LumosX/benchmark/,權重已上傳 Hugging Face。

第三個項目是 UniLumos(NeurIPS 2025),專注於圖像與影片的統一重新打光,採用 RGB 空間幾何回饋配合 flow-matching 主幹,適合需要控制光影的研究與應用場景。

總結要點:

  • ** DAMO 是 Discovery, Adventure, Momentum and Outlook
  • Lumos-Nexus:輕量訓練搭配 UPFB 頻率交接,兼顧推理品質與視覺保真度
  • LumosX:以關係式注意力處理多主體個性化生成,附 benchmark 與 Hugging Face 權重
  • UniLumos:統一圖片與影片重新打光,採用 flow-matching 與幾何回饋
  • VR-Bench:補上推理驅動影片生成的評測缺口
  • 子項目獨立部署:每個子項目都有獨立 README,支援單獨安裝與重現

這個項目適合研究影片生成、多模態統一模型與個性化生成的研究者與工程師。如果你想驗證 Lumos-Nexus 的推理影片效果,可進入 Lumos-Nexus/ 跟隨 README 取得 OmniVideo 權重並跑批次推論;想評測打光則可參考 UniLumos 提供的流程。

✧ Repository layout ✧

Lumos-Custom/
├── README.md                 # This file: umbrella overview
├── LumosX/                   # ICLR 2026 · personalized multi-subject video generation
│   └── README.md
├── UniLumos/                 # NeurIPS 2025 · unified relighting + LumosBench/
│   ├── README.md
│   └── LumosBench/
└── Lumos-Nexus/              # arXiv preprint · reasoning-driven unified video generation + VR-Bench
    ├── README.md
    └── vr_bench_eval/

GitHub: https://github.com/alibaba-damo-academy/Lumos-Custom

項目: https://jiazheng-xing.github.io/nexus-lumos-home/

Categories: 開源, 香港科技大學, 清華大學, 阿里巴巴, 視頻模型, 影像模型

Page 15 of 20
1 … 13 14 15 16 17 … 20